GPT-6 Astra или GPT-6.1 Sol: какую модель OpenAI выбрать
Обновлено
Обозреватель: модели и релизы
Содержание
За сентябрь OpenAI выпустила четыре модели нового поколения. Сначала, 3 сентября 2026 года, флагман GPT-6 Astra. Через две с половиной недели GPT-6 Sol и GPT-6 Luna, а ещё через неделю, 29 сентября, GPT-6.1 Sol, которую компания описывает как модель почти уровня Astra. Разобрались, чем они отличаются, с кем Astra на самом деле сравнивали в анонсе и когда флагман вообще нужен. Все четыре модели уже доступны в чате GPThub, так что проверить выводы можно на своей задаче.
Что вышло и в каком порядке
Астра появилась первой. В обзоре безопасности от 3 сентября OpenAI пишет, что развёртывание начинается для ограниченного числа организаций, а в ближайшие дни модель получат все пользователи ChatGPT Plus, Pro, Business и Enterprise. Для корпоративных аккаунтов Enterprise есть деталь: при запуске доступ к Astra там по умолчанию выключен, администратору нужно включить его самому.
Через API модель называется gpt-6-astra. Её также раздают через Microsoft Azure и Amazon Bedrock. На тарифах Pro, Business и Enterprise в ChatGPT есть ещё отдельная версия, GPT-6 Astra Pro.
22 сентября на той же странице появилась приписка: семейство расширяют, добавляя GPT-6 Sol и GPT-6 Luna. Назначение у них в документации короткое. Про Sol сказано, что она сделана для сложного кода и агентных сценариев. Luna OpenAI называет самой экономной моделью: узкие задачи, большой поток. И тут же оговорка: Astra остаётся лучшей моделью по всем параметрам.
А 29 сентября, на конференции DevDay, вышла GPT-6.1 Sol. Это обновление Sol, и формулировка у OpenAI смелая: модель «почти достигает уровня интеллекта GPT-6 Astra» в агентном программировании, управлении компьютером и профессиональных задачах. В документации короче: близко к Astra и дешевле.
Была ещё и GPT-6.1 Astra, точнее её не было. TechCrunch со ссылкой на The Wall Street Journal пишет, что выпуск отменили из-за опасений по безопасности. Сам материал WSJ мы не открывали, а OpenAI отмену официально не комментировала, так что это пока пересказ.
Где модели доступны у самой OpenAI, тоже по-разному. Sol, Luna и 6.1 Sol работают в разделе ChatGPT для работы и в Codex на тарифах Plus, Pro, Business, Enterprise и Edu. В обычном чате ChatGPT их, по словам компании, пока нет. Бесплатным пользователям и тарифу Go досталась Luna в приложении для компьютера.
Чем модели отличаются на бумаге
Цифры из документации OpenAI для разработчиков. Окно и длина ответа у всех одинаковые, различаются дата среза знаний и уровни рассуждения.
| Модель | Вышла | Знания до | Уровни рассуждения | Вход и ответ |
|---|---|---|---|---|
| GPT-6 Astra | 3 сентября 2026 | 30 апреля 2026 | от low до max | текст и картинки → текст |
| GPT-6 Sol | 22 сентября 2026 | 20 апреля 2026 | от none до max | текст и картинки → текст |
| GPT-6 Luna | 22 сентября 2026 | 18 мая 2026 | от none до max | текст и картинки → текст |
| GPT-6.1 Sol | 29 сентября 2026 | 30 апреля 2026 | от low до max | текст и картинки → текст |
Про уровни стоит сказать отдельно. У Sol и Luna есть режим none, когда модель отвечает сразу, без рассуждения. У Astra и у новой 6.1 Sol такого режима нет: даже на самом низком уровне модель сначала думает. Для коротких вопросов это лишние секунды ожидания, для сложной задачи разница не видна.
Слушать и смотреть видео не умеет ни одна из четырёх, рисовать тоже. На вход текст и картинки, на выход только текст. Для картинок в GPT есть отдельные модели, к этому семейству они не относятся.
Окно в 1 050 000 токенов звучит как миллион с хвостиком, но целиком на запрос его не отдают. Вход ограничен 922 000 токенов, остальное оставлено под ответ. Для обычной работы это ничего не меняет: договор, курсовая или переписка за пару месяцев помещаются с огромным запасом.
С кем Astra сравнивали в анонсе
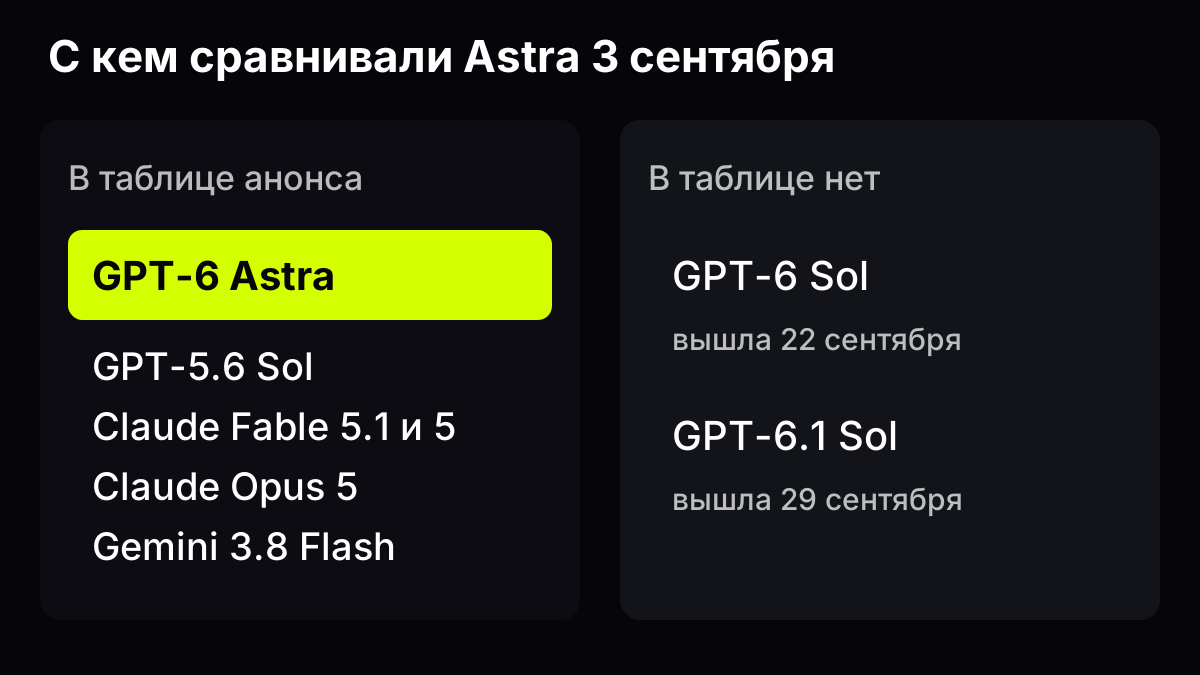
Это главное, что стоит знать про таблицы. В анонсе Astra шесть колонок: сама Astra, GPT-5.6 Sol, Claude Fable 5.1, Claude Fable 5, Claude Opus 5 и Gemini 3.8 Flash. GPT-6 Sol там нет. Её ещё не выпустили, когда вышла Astra.
Поэтому цифры вроде «72,6% против 65,7%» в работе с компьютером означают отрыв от прошлого поколения. Внутри семейства GPT-6 картина другая, и её OpenAI показала уже в анонсе Sol, на других графиках.
Плюс OpenAI указывает в таблице лучший результат каждой модели среди всех уровней рассуждения. То есть рядом стоят максимумы, а не одинаковые настройки.
Пример, где это важно, — тест на научные задачи в командной строке, Terminal-Bench Science. В таблице у Astra 64,6%, у GPT-5.6 Sol 22,4%. Разрыв почти в три раза, и именно эту пару чаще всего цитируют. Но в тексте анонса сама OpenAI сравнивает по-другому: 64,6% у Astra против 52,6% у Claude Fable 5.1, а против 22,4% у GPT-5.6 Sol ставит 61,1%, это Astra в более дешёвой настройке. Ещё через месяц, на странице GPT-6.1 Sol, у Astra в этом же тесте уже 68,1%. Откуда новая цифра, компания не объясняет.
Похожие расхождения есть и между компаниями. OpenAI и Anthropic приводят разные числа для одних и тех же моделей. GPT-5.6 Sol на тесте рабочих сценариев AutomationBench у OpenAI набирает 18,1%, у Anthropic 28,8%. Claude Opus 5 на тесте кода FrontierCode Main у OpenAI 53,4%, у Anthropic 48,0%. Для сравнения моделей это значит одно: цифры из разных таблиц лучше не складывать.
Источник: анонс GPT-6 Astra, 3 сентября 2026, иллюстрация GPThub
Где Astra впереди
Если смотреть только на таблицу OpenAI, у Astra три сильные зоны: работа с компьютером, наука и длинные документы.
- Работа с компьютером. На OSWorld 2.0 (офлайн-набор, частичный балл) у Astra 72,6% против 65,7% у GPT-5.6 Sol. По словам OpenAI, при этом на задачу уходит около 40 минут вместо 75, то есть примерно на 47% меньше времени. Claude Opus 5 в том же тесте — 70,2%.
- Рабочие сценарии. AutomationBench: 41,4% у Astra, 31,4% у Claude Fable 5.1, 26,9% у Opus 5, 18,1% у GPT-5.6 Sol.
- Математика. FrontierMath, самый сложный, четвёртый уровень: 97,6% против 87,8% у Fable 5.1 и 83,0% у GPT-5.6 Sol.
- Длинный контекст. На поиске восьми фрагментов в тексте от 512 тысяч до миллиона токенов (MRCR v2) у Astra 96,3%, у GPT-5.6 Sol 73,8%.
- Ошибки в фактах. Доля ответов с галлюцинациями — 4,2% против 12,2% у прошлого поколения.
Отдельно стоит ARC-AGI-3: 99,9% у Astra против 7,8% у GPT-5.6 Sol и 30,2% у Opus 5. Цифра настолько выбивается из остальных, что мы бы подождали независимой проверки. Пока это только таблица самой OpenAI.
Есть в таблице и более приземлённые строки. Поиск по вебу, BrowseComp: 91,5% у Astra, 90,8% у Opus 5, 90,4% у GPT-5.6 Sol, разница почти нулевая. Научные вопросы GPQA Diamond: 96,0% у Astra и 95,3% у Gemini 3.8 Flash, то есть быстрая модель Google почти догнала флагман. Медицинский HealthBench Professional: 63,4% против 60,5% у прошлого поколения. Отрыв есть, но скромный.
Скорость OpenAI тоже меряет. На тесте с задачами в браузере Mind2Web Astra справлялась в 1,9 раза быстрее GPT-5.6 Sol. В API у неё есть быстрый режим, по словам компании до двух раз быстрее обычного. Для длинной задачи агента это заметно, в обычном чате почти нет.
Для обычного пользователя из этого списка важнее всего пункты про длинный контекст и ошибки в фактах. Длинный файл модель читает внимательнее, и выдумывает реже. Работа с компьютером и научные тесты нужны тем, кто строит агентов, в чате их почти не видно.
Где впереди другие
Флагман выигрывает не везде, и в таблице самой OpenAI это видно. Тест с экзаменационными вопросами HLE (с инструментами): у Astra 57,2%, у Claude Fable 5.1 65,0%, у Claude Fable 5 63,8%, у Opus 5 63,6%. Здесь Astra последняя среди тех, у кого есть результат.
На коде разница маленькая. DeepSWE v1.1: 74,1% у Astra, 73,8% у Gemini 3.8 Flash, 73,7% у Opus 5, 72,7% у GPT-5.6 Sol. Полтора пункта между флагманом и прошлым поколением — это почти ничего. На FrontierCode Main Claude Fable 5 даже обходит Astra: 53,5% против 53,3%. В сводном индексе агентного кода от Artificial Analysis у Opus 5 68,1, у Astra 67,0.
Потом вышел Claude Opus 5.5, 22 сентября, и Anthropic опубликовала свою таблицу. Числа для моделей OpenAI там, по её словам, взяты у самой OpenAI. Сравнение такое:
| Тест | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0, командная строка | 66,4% | 57,9% |
| HLE с инструментами | 67,7% | 57,2% |
| AutomationBench, рабочие сценарии | 40,0% | 41,4% |
| Terminal-Bench Science | 58,7% | 64,6% |
Получается так: в командной строке и на экзаменационных вопросах Opus 5.5 заметно сильнее, на рабочих сценариях модели почти рядом, научные задачи в терминале остаются за Astra. Наш разбор модели Anthropic — в статье про Claude Opus 5.5.
Модель для «всего сразу» в этой паре выбрать нельзя. Под конкретную задачу можно.
Sol и Luna на фоне соседей
В анонсе 22 сентября OpenAI сравнивала Sol уже с другими моделями: с Claude Opus 5, Claude Fable 5.1, прошлой GPT-5.6 Sol и с Astra на низком уровне рассуждения. Полной таблицы там нет, часть чисел дана только на графиках, поэтому берём то, что написано текстом.
- Рабочие сценарии. AutomationBench: GPT-6 Sol на очень высоком уровне — 33,2%. Astra на низком — 30,3%, Claude Fable 5.1 — 31,4%, Opus 5 на максимуме — 26,9%. То есть хорошо настроенная Sol обходит Astra на минимальной настройке.
- Работа с компьютером. OSWorld 2.0: Sol — 60,5%, Opus 5 на среднем уровне — 60,3%. Почти ничья.
- Код. DeepSWE v1.1: Sol — 68,8%, Claude Fable 5 — 69,9%, Luna на максимуме — 66,6%.
- Экзамен для агентов. Agents' Last Exam: Sol на максимуме — 56,4%, это выше лучшего результата Opus 5.
- Факты. По словам OpenAI, ошибок в фактах у Sol примерно вдвое меньше, чем у прошлого поколения.
Про Luna цифр меньше. На AutomationBench на высоком уровне она прибавила 5,4 пункта к своей предшественнице, на OSWorld обошла GPT-5.6 Sol на среднем уровне. Для самой лёгкой модели семейства неплохо. Рядом с Sol она всё же слабее.
Важная деталь: сравнивать Sol с Astra напрямую по этим числам нельзя. Astra в таблице своего анонса стоит на лучшем уровне рассуждения, в анонсе Sol — на низком. Сопоставимую картину OpenAI показала только через неделю, на странице 6.1 Sol.
GPT-6.1 Sol: почти Astra
Через неделю после Sol вышла 6.1, и для выбора она интереснее самой Astra. Что OpenAI пишет на её странице:
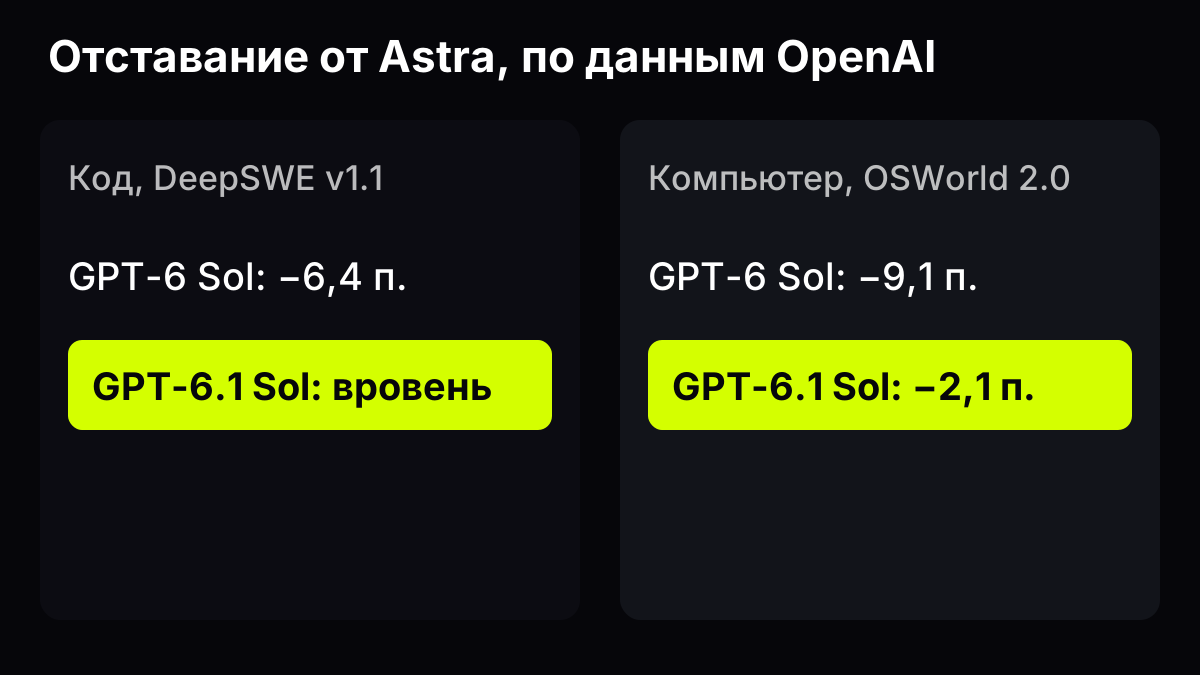
- Код. На DeepSWE v1.1 модель вышла на уровень Astra и на 6,4 пункта обошла лучший результат GPT-6 Sol.
- Работа с компьютером. OSWorld 2.0: плюс 7 пунктов к GPT-6 Sol, до Astra не хватает 2,1 пункта.
- Рабочие сценарии. AutomationBench: на 4,8 пункта выше GPT-6 Sol при той же настройке и на 2,2 пункта выше Claude Opus 5.5.
- Наука в терминале. Результат GPT-6 Sol вырос больше чем вдвое, но лидером OpenAI по-прежнему называет Astra.
- Ошибки в фактах. На низком уровне рассуждения доля ответов с фактическими ошибками упала с 11,4% до 7,7%, примерно на 32%. От Astra это отличается на 1,9 пункта.
Есть и любопытная мелочь из той же страницы. OpenAI проверяла, сообщает ли модель, что поиск сломался, или молча отвечает по памяти. Молчала GPT-6.1 Sol в 2,1% случаев, GPT-6 Sol в 4,9%, Astra в 1,5%. Luna — в 28,7%. Так что для вопросов, где важна свежая информация, Luna подходит хуже всех из семейства.
Для нас 6.1 Sol важна ещё и потому, что она почти догоняет флагман, а отвечает быстрее. О выборе ниже.
Источник: анонс GPT-6.1 Sol, OpenAI, 29 сентября 2026, иллюстрация GPThub
Почему Astra отказывает в части задач
Astra — первая модель OpenAI, которая по внутренней шкале компании (Preparedness Framework) достигла критического уровня в кибербезопасности. По биологии и химии у неё высокий уровень, по самоулучшению ИИ порог «высокий» она не достигла.
Откуда такая оценка, видно по тестам на взлом. На ExploitBench модель проверяли без защит, которые работают в продукте, и она набрала 100% против 78,5% у GPT-5.6 Sol. В системной карточке OpenAI сама оговаривает, что результат может быть завышен: часть задач могла попасть в обучающие данные, в одной модель вспомнила известную уязвимость. На свежей версии теста, собранной из уязвимостей июня–августа 2026 года, у Astra 39,0%, у GPT-5.6 Sol 5,5%.
Поэтому в ChatGPT и Codex модель ограничили. Писать рабочие эксплойты к уязвимостям Astra откажется. Проверить код на безопасность и предложить исправление — пожалуйста. Для проверенных специалистов по защите OpenAI запустила программу Daybreak: там обещают доступ к более мощным инструментам с меньшим числом ограничений.
Есть и обратная сторона. По словам OpenAI, Astra безопаснее обрабатывает опасные запросы и при этом реже отказывает в безвредных. Но в обзоре безопасности есть честная строчка: следить за рассуждениями Astra стало сложнее, чем за рассуждениями GPT-5.6 Sol.
Ещё несколько цифр из системной карточки, которые объясняют, почему модель выпустили. Устойчивость к подсказкам-ловушкам, спрятанным в тексте страницы или файла, выросла с 96,23% до 99,79%. На открытом конкурсе таких атак Gray Swan (1 810 попыток) атаки сработали на Astra в 8,5% случаев, на GPT-5.6 Sol в 27,0%. В симуляции работы в Codex на 54 000 с лишним задач серьёзных ошибок у Astra было 34, у прошлой модели 73.
Отдельная строка про работу с компьютером. Доля опасных действий в таком режиме у Astra 2,4%, у GPT-5.6 Sol 22,0%, у Claude Opus 5 11,5%. С автоматической проверкой действий у Astra остаётся 1,8%. Для агента, которому дают доступ к почте или файлам, это важнее любого рекорда в тестах.
Для обычной работы всё это почти незаметно. Отказ можно встретить если спрашивать про взлом чужих систем, и это ожидаемо.
Что открыть в GPThub
В чате GPThub доступно всё новое семейство OpenAI:
- GPT-6 Astra — флагман. Берите его, когда задача тяжёлая и Sol с ней не справилась с первого раза.
- GPT-6 Sol и GPT-6.1 Sol — код, длинные документы, работа в несколько шагов.
- GPT-6 Luna — короткие вопросы, пересказ, перевод.
Без регистрации, гостем, можно писать Gemini 3.8 Flash.
Что брать для чего. Начинать мы советуем с GPT-6.1 Sol: по тестам OpenAI она ближе всех к Astra. Если ответ не устроил, тот же запрос можно отдать Astra и сравнить. Для короткого вопроса, пересказа или перевода хватит Luna, она для этого и сделана. Только помните про цифру из прошлого раздела: если ответ зависит от свежих данных, Luna чаще других молча отвечает по памяти, так что дату и цифры проверяйте сами.
Если OpenAI вам не принципиальна, для кода есть ещё Claude Sonnet 5 и Kimi K3, а для черновиков — DeepSeek V4 Flash. Как выбрать модель под задачу, разобрано в гайде какая модель для кода, а как сравнить две модели на своём примере — в гайде сравнение моделей на практике.
Как сравнить модели на своей задаче
Таблицы показывают средний результат на чужих задачах. Ваша может оказаться исключением, поэтому перед тем как менять модель или тариф, лучше потратить десять минут на проверку. Мы делаем так.
- Возьмите задачу, которую реально решаете каждую неделю: кусок кода с ошибкой, длинный договор, письмо клиенту. Придуманный пример для теста не годится, на нём все модели выглядят одинаково хорошо.
- Напишите один запрос и не меняйте его между моделями. Если поправить формулировку на ходу, сравнивать будет уже нечего.
- Откройте две вкладки чата и отправьте этот запрос GPT-6.1 Sol и, например, Claude Sonnet 5 или Luna. Смотрите на три вещи: решена ли задача, сколько пришлось исправлять руками и не появилось ли в ответе фактов, которых не было в исходнике.
- Повторите на второй задаче другого типа. Одной попытки мало, модели ошибаются по-разному и иногда просто неудачно отвечают с первого раза.
Если разница не видна, берите ту модель что отвечает быстрее. Если видна, значит, вы нашли свою, и никакая таблица этого вывода уже не отменит. Подробнее о том, как устроить такое сравнение, мы писали в гайде про сравнение моделей.
Одна оговорка про длинные файлы. Окно у всех моделей семейства одинаковое, но внимательность к середине длинного текста у них разная, и это видно только на ваших документах. Поэтому для длинного файла задайте вопрос про деталь из середины, ответ на который вы знаете заранее. Сразу станет ясно, дочитала модель или пересказывает по первым страницам.
Кому какая модель
Пишете код или разбираете длинный файл. GPT-6.1 Sol. Разница с Astra в коде по тестам OpenAI почти исчезла.
Нужен быстрый короткий ответ. GPT-6 Luna. Для свежих фактов лучше Sol или проверка вручную.
Строите агента, который работает в браузере и программах. Здесь Astra впереди всех в таблице OpenAI, с неё и начинайте. Для агентов это пока лучший выбор в семействе.
Экзаменационные вопросы и командная строка. По таблице Anthropic сильнее Claude Opus 5.5. Прежде чем платить за флагман, сравните обе на своём вопросе. Как развести задачи между семьями, разобрано в статье ChatGPT или Claude.
Безопасность и проверка уязвимостей. Astra умеет многое, но в продукте ограничена. Для такой работы OpenAI предлагает отдельный путь через Daybreak.
Ждать GPT-6.1 Astra, похоже, не стоит: если пересказ TechCrunch верен, её отменили. Следующую модель старшего уровня OpenAI пока не анонсировала.
Вопросы и ответы
Чем GPT-6 Astra отличается от GPT-6 Sol?
Astra — старшая модель семейства, OpenAI называет её лучшей по всем параметрам. Sol сделана для сложного кода и агентов. Окно одно, 1 050 000 токенов. У Sol есть режим без рассуждения, у Astra нет.
Что такое GPT-6.1 Sol?
Обновление GPT-6 Sol, вышло 29 сентября 2026 года. По тестам OpenAI оно догнало Astra на DeepSWE v1.1 и отстаёт на 2,1 пункта в работе с компьютером. В чате GPThub GPT-6.1 Sol уже доступна.
Есть ли GPT-6 Astra в чате GPThub?
Да, GPT-6 Astra уже доступна в чате GPThub. Рядом с ней GPT-6 Sol, GPT-6.1 Sol и GPT-6 Luna.
Правда, что Astra решила 100% задач на взлом?
На ExploitBench без защит продукта — да, 100%. Но OpenAI сама пишет, что результат может быть завышен из-за попадания задач в обучение. На свежей версии теста у Astra 39,0%.
Что лучше для кода: Astra или Claude Opus 5.5?
По таблице Anthropic в командной строке сильнее Opus 5.5: 66,4% против 57,9%. На рабочих сценариях модели почти рядом. Проверить лучше на своей задаче.
Связанные модели


Связанные гайды
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Похожие статьи
- Claude Opus 5.5
Claude Opus 5.5 вышла 22 сентября 2026: окно в миллион токенов, уровень Fable 5.1 на большинстве задач. Что показывают тесты и когда её брать.
- Обзор Claude Sonnet 5.5
Sonnet 5.5 вышел 28 сентября 2026 для ясной задачи. Открытое суждение остаётся у Opus 5.5. В чате 6 октября открыт Sonnet 5.
- DeepSeek или ChatGPT
DeepSeek или ChatGPT в ноябре 2026: открытые веса против закрытого приложения. Разница по задаче, не по лозунгу «кто умнее».
- ChatGPT или Claude
ChatGPT или Claude в ноябре 2026: какую модель взять под текст, код и длинный документ.
- Российские нейросети
"Российские нейросети ноября 2026: Алиса, YandexGPT, GigaChat и Kandinsky. Чем отличаются текст, картинки и короткое видео."
- Китайские нейросети
Какие китайские нейросети открыть в ноябре 2026: DeepSeek, Qwen, Kimi и GLM. Карта лабораторий и выбор под задачу.
Источники
- OpenAI: GPT-6 Astra, 3 сентября 2026
- OpenAI: обзор безопасности GPT-6 Astra, 3 сентября 2026
- OpenAI: системная карточка GPT-6 Astra
- OpenAI: документация модели GPT-6 Astra
- OpenAI: GPT-6 Sol и GPT-6 Luna, 22 сентября 2026
- OpenAI: GPT-6.1 Sol, 29 сентября 2026
- OpenAI: Daybreak
- Anthropic: Claude Opus 5.5, 22 сентября 2026
- TechCrunch, 29 сентября 2026: выход GPT-6.1 Sol
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Открыть GPT-6.1 Sol в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.