
Gemini 3.8 Flash — рабочая лошадка Google: где догоняет топ и кому подходит
Обновлено
Обозреватель: модели и релизы
Содержание
2 сентября 2026 года Google DeepMind выпустила Gemini 3.8 Flash. Это заметный шаг в линейке Gemini 3, а не косметическая правка. В model card Google прямо пишет: модель точнее и надёжнее, но на сложных задачах может тратить больше токенов, особенно на высоком уровне усилия (effort). Если вы строите агентные пайплайны на Flash-бюджете, это меняет расчёты сильнее, чем любой процент на бенчмарках. С 8 октября 2026 Gemini 3.8 Flash есть и в GPThub: это модель гостя и тарифа «Бесплатный», подробности — на странице модели. В обзоре — всё, что известно о модели на конец сентября 2026. Спецификации, уровни размышлений (thinking), разбор бенчмарков с оговорками. Отдельно — расхождение в цифрах Terminal-bench 2.1 между model card DeepMind и Cloud developer guide. Для сравнения с Flash-классом смотрите DeepSeek V4 Flash и GPT-5.6 Luna в каталоге.
Зачем читать этот обзор
Короткий ответ: решение «переезжать с 3.7 Flash на 3.8 или нет» сейчас нетривиально. Обычно вендор выпускает новую модель и говорит «она лучше во всём, мигрируйте». Здесь иначе. В Cloud developer guide прямо сказано: если для вас приоритет — эффективность и экономия токенов, понизьте уровень усилия или оставайтесь на 3.7 Flash. Старая модель остаётся поддерживаемой.
Честный тест перед переездом — гонять одну и ту же выборку задач на обеих моделях. 50–100 задач достаточно, чтобы увидеть разницу в доле решённых с первого раза и в среднем числе токенов на задачу. Дальше решение о миграции становится арифметикой, а не верой в таблицы.
Второй повод — политика цен Google. Intro-тарифы действуют до 31 декабря 2026 года, с 1 января 2027-го list price удваивается. При этом 3.8 Flash на высоких уровнях усилия потребляет больше токенов, чем 3.7. Сложите эти два фактора — и окно «дешёвой силы» у вас ровно до Нового года. Дальше экономика пайплайна меняется. Конкретные ставки — только у вашего провайдера Gemini API.
Третий повод — бенчмарки. Цифры у модели действительно хорошие местами, но между таблицей DeepMind model card и Cloud developer guide есть расхождения. Terminal-bench 2.1: model card — 89,4%, Cloud guide — 90,8%. Для 3.7 расхождение ещё интереснее: 85,8% против 81,6%. Это не опечатка — это разные harness-ы (наборы тестов и условий прогона). Ниже объясню, почему это важно для ваших ожиданий.
Четвёртое: если вы работаете с API Gemini 3 семейства, у 3.8 Flash есть конкретные API-особенности. Deprecated sampling-параметры молча игнорируются, отсутствует поддержка MINIMAL thinking-уровня, миграция с thinking_budget на строковый enum. Поймать это в продакшене неприятно — лучше узнать заранее.
Что такое Gemini 3.8 Flash и где она стоит в семье
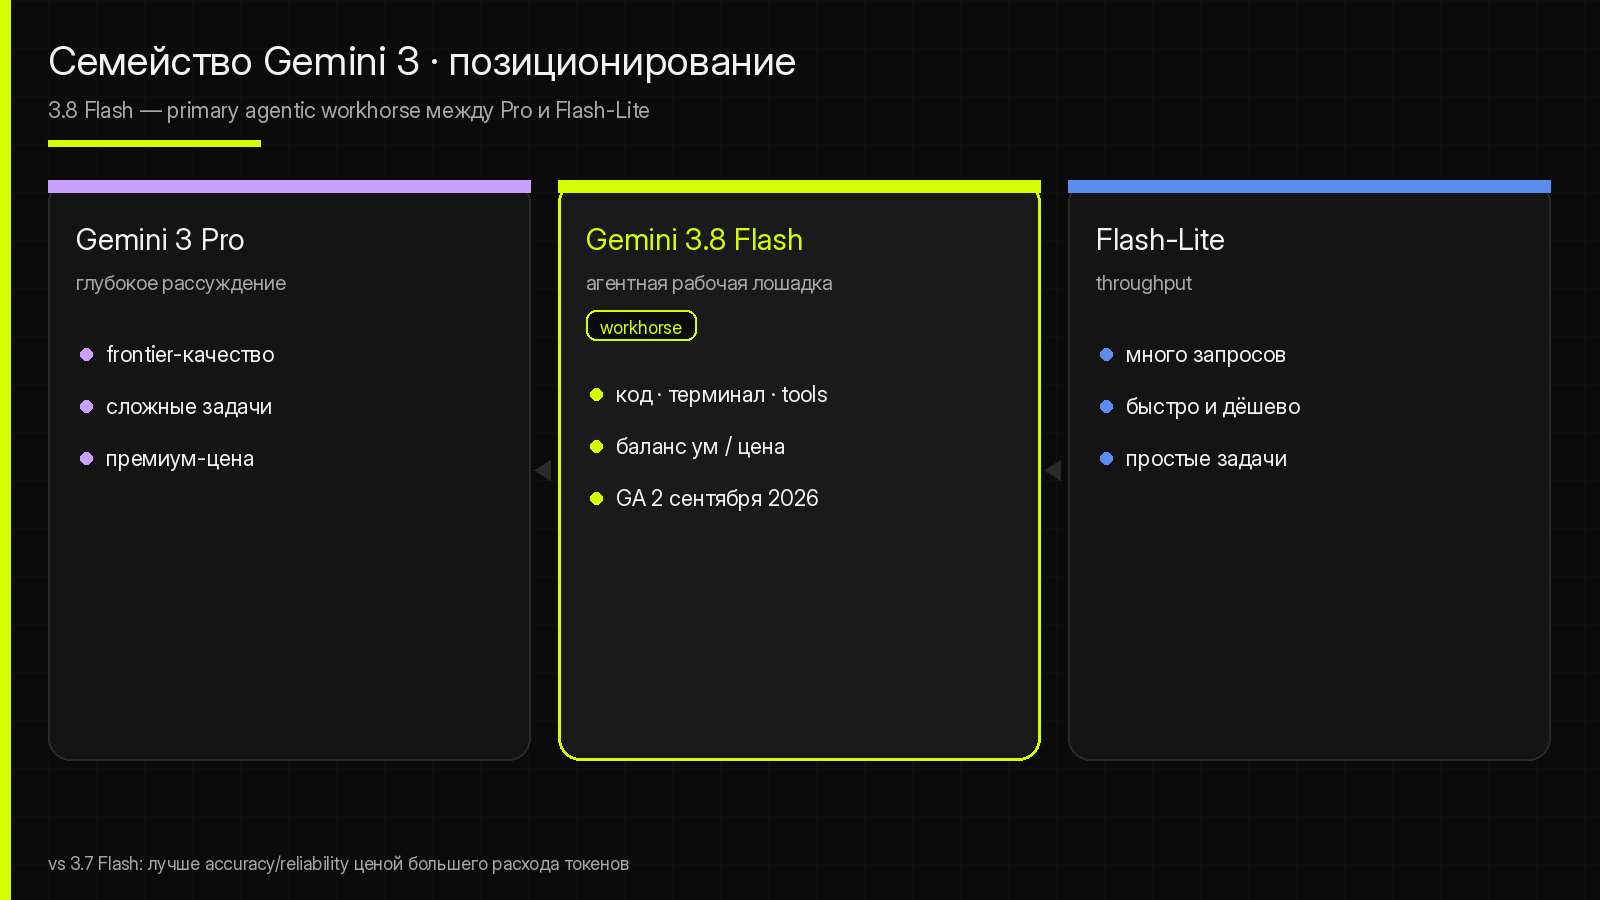
Gemini 3.8 Flash — по формулировке Google, основная агентная рабочая лошадка линейки Gemini 3. Это модель, на которой Google ожидает, что вы будете строить основную массу агентных задач — код, терминал, инструменты, многошаговые сценарии. Не премиум-рассуждения, не экстремальный throughput, а «рабочая лошадка» в прямом смысле.
Семейство Gemini 3 устроено как три ступени:
- Gemini 3 Pro — глубокое рассуждение, сложные задачи, соответствующая стоимость. Когда задача требует качества класса топ-моделей и бюджет позволяет.
- Gemini 3.8 Flash — баланс. Достаточно умная для агентной работы, достаточно доступная для запуска в масштабе. Именно сюда Google рекомендует «переезжать» для основной нагрузки.
- Flash-Lite — throughput. Когда нужно обработать много запросов быстро и дёшево, и сложность задач это позволяет.
Позиционирование против 3.7 Flash — самое важное в этом релизе. Google не убивает 3.7 (он остаётся supported), но описывает разницу так: 3.8 даёт лучшую accuracy и reliability ценой более высокого потребления токенов. Механика простая: на сложных задачах модель работает усерднее — больше шагов рассуждения, больше итеративных вызовов инструментов. В Known Limitations model card это сформулировано так: «At times, the model might use more tokens to maximize performance, especially at higher effort levels».
Это осознанный trade-off, а не побочный эффект. За дополнительные шаги рассуждения вы платите токенами.
Отдельно упомяну сиблинга — Gemini 3.8 Flash Cyber. Это специализированная версия для кибербезопасности, которая доступна только «trusted defenders» через Fairwind Program — то есть не публичная, не через общий API, и не то, что вы поставите в свой пайплайн завтра. Она не ядро этого обзора, но пару слов о ней скажу в разделе про safety — там есть нюанс, который стоит понимать.
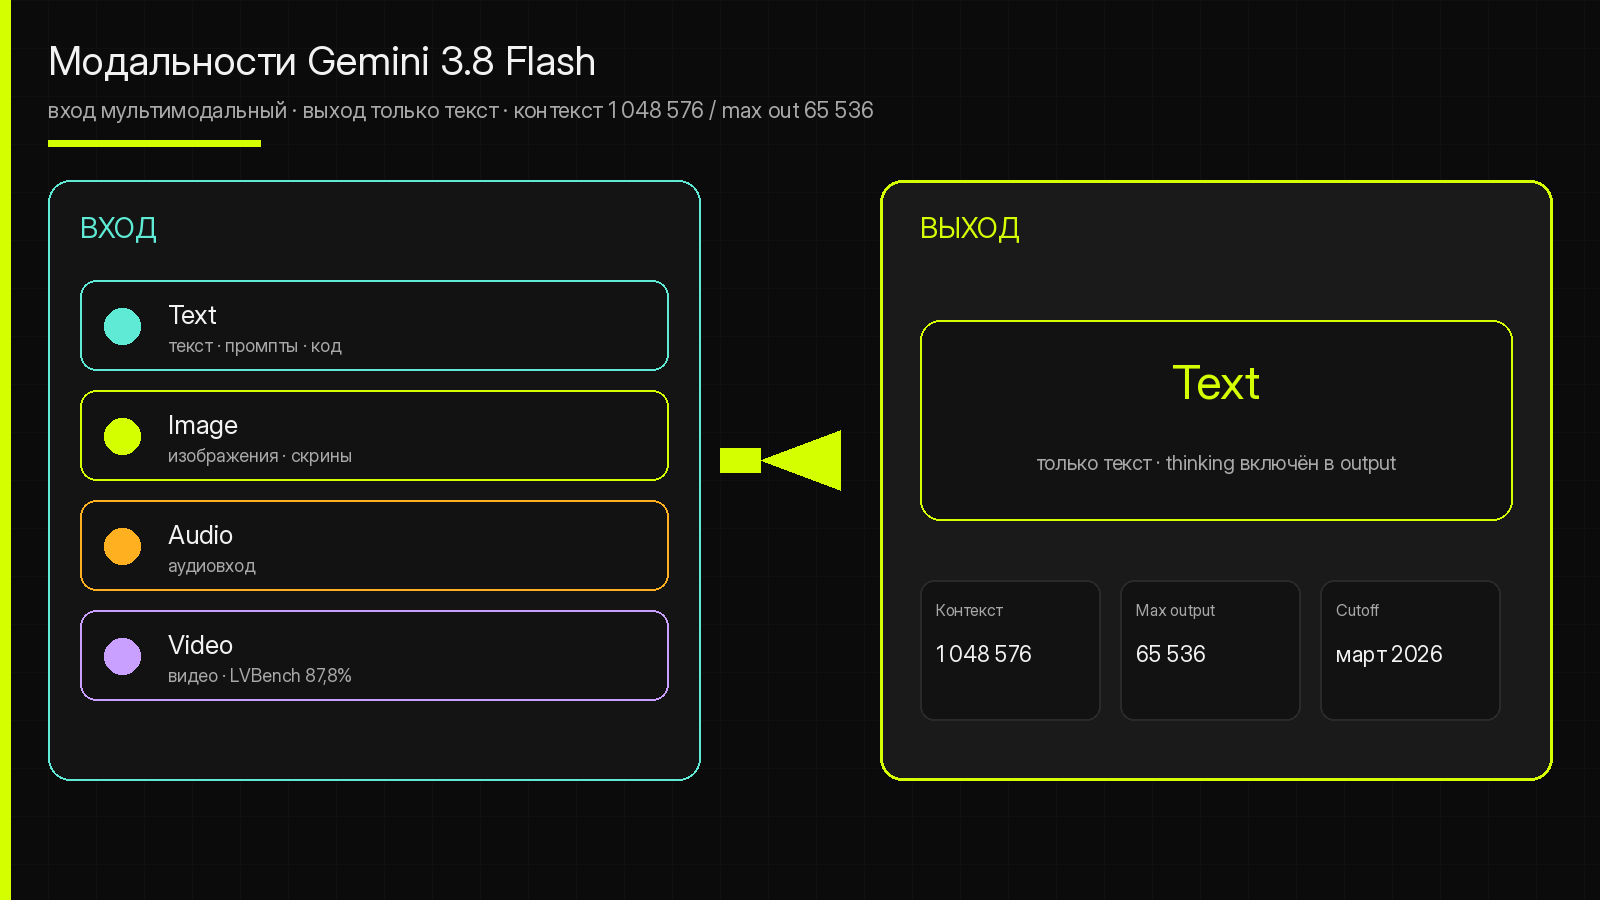
Контекст — 1 048 576 токенов на вход, максимум 65 536 токенов на выход (в model card это названо «64K»). Вход мультимодальный: текст, изображения, аудио, видео; выход — только текст. Knowledge cutoff — март 2026, но с оговоркой: у части доменов знания слабее вплоть до примерно января 2025 года. Это особенность всей семьи Gemini 3, не конкретно 3.8. Практический вывод: если ваш агент опирается на свежие события или узкие домены, проверяйте фактичность на своих данных. Не надейтесь на cutoff-дату как на гарантию.
Спецификации и thinking-уровни
Сводка ключевых параметров:
| Параметр | Значение |
|---|---|
| API ID | gemini-3.8-flash |
| Контекст | 1 048 576 токенов |
| Макс. выход | 65 536 токенов |
| Thinking | LOW / MEDIUM (по умолчанию) / HIGH |
| MINIMAL | не поддерживается — API validation error |
| Knowledge cutoff | март 2026 (часть доменов слабее до ~января 2025) |
| Вход | Text, Image, Audio, Video |
| Выход | Text |
| GA (общая доступность) | 2 сентября 2026 |
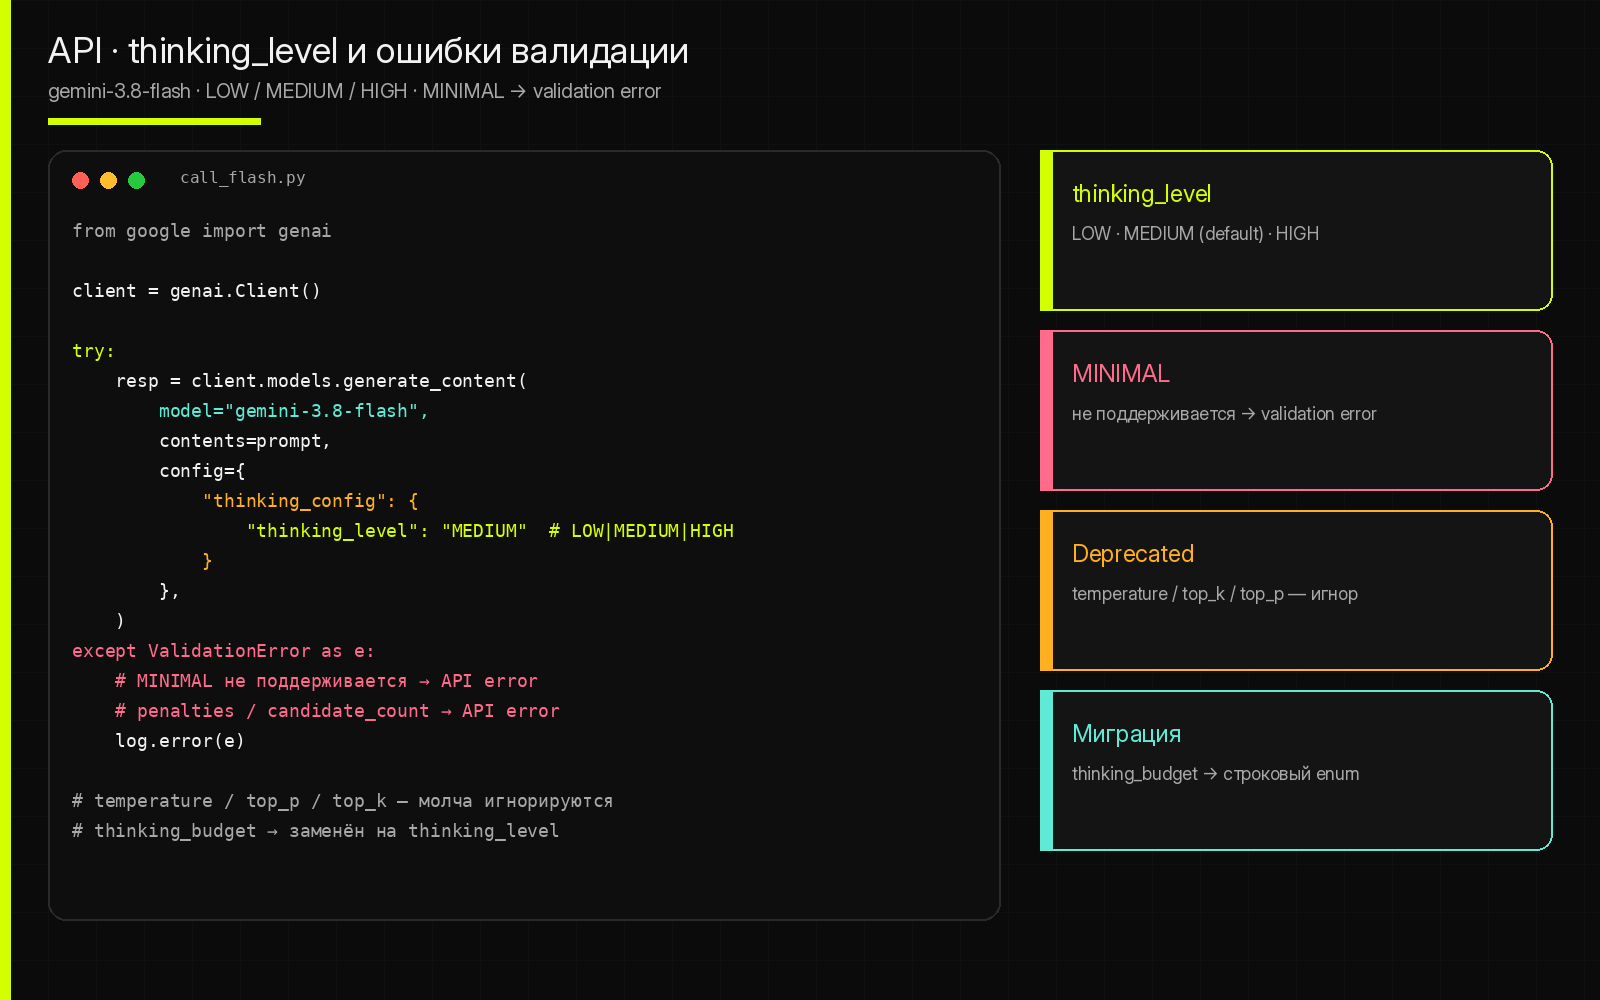
Теперь про thinking — это сердце работы с моделью. У Gemini 3.8 Flash три уровня размышлений: LOW, MEDIUM (по умолчанию) и HIGH. Уровень определяет, сколько внутренних шагов рассуждения модель тратит на задачу, и напрямую влияет на качество и на счёт за токены.
Критический нюанс: MINIMAL не поддерживается. Если вы попытаетесь его передать — получите не молчаливое игнорирование, а честный API validation error. Это важно для тех, кто мигрирует с других моделей Gemini или пишет абстракции над несколькими провайдерами. Ваш код, который перебирает уровни thinking, должен знать: для 3.8 Flash нижняя граница — LOW.
Дальше — API conventions всей семьи Gemini 3, и вот тут есть грабли, на которые уже натыкались те, кто мигрировал раньше:
- Deprecated sampling-параметры — temperature, top_k, top_p — игнорируются. Молча. Никакой ошибки, просто никакого эффекта. Если ваш пайплайн «настраивает креативность» через temperature на Gemini 3.8 Flash, он настраивает воздух.
- Unsupported параметры жёстко ругаются: penalties и candidate_count вызывают API error. Не игнор, а ошибка. То есть старый код, который работал с предыдущими поколениями, может упасть на ровном месте.
- Strict function calling — семантика вызова инструментов строже, чем раньше. Для агентных систем это скорее плюс (меньше кривых вызовов), но требует аккуратности при миграции.
- Ограничения на историю чата: history не может заканчиваться на роль
model; prefilled model turns не поддерживаются; пустые turns отбрасываются или дают ошибку. Это ломает часть шаблонов «дописать ответ модели». - Миграция thinking_budget → thinking_level: числовой бюджет размышлений заменён на строковый enum. Если у вас где-то в коде остался thinking_budget — это место, которое нужно переписать.
Суммируя: Gemini 3.8 Flash — это API, которое сознательно ломает обратную совместимость там, где Google считает старые паттерны вредными. Для нового кода это чисто и предсказуемо. Для старого — закладывайте время на миграцию и на ловлю молчаливых игноров, которые хуже ошибок, потому что их не видно в логах.
Политика цен и расход токенов
Google держит intro-тарифы для Gemini 3.8 Flash до 31 декабря 2026 года; с 1 января 2027-го list price удваивается. Это касается и входных, и выходных токенов, включая thinking-токены — они входят в выходную строку счёта, а не тарифицируются отдельно. На HIGH-уровне усилия модель может генерировать заметно больше thinking-токенов, чем 3.7 Flash на тех же задачах.
Важная деталь для планирования: intro-тариф — list price вендора, а не пакет посредника. Фактический счёт зависит от того, идёте ли вы через Gemini API, Agent Platform или consumer-подписку Google AI Pro/Ultra. Для сравнения Flash-моделей в нашем сервисе смотрите тарифы — там DeepSeek V4 Flash, GPT-5.6 Luna и другие варианты без прямого доступа к Gemini API.
Есть режимы Batch/Flex (пакетная обработка, вдвое дешевле стандарта по list price), Priority (приоритетная очередь) и Non-global регионы (+10%). Grounding с Search/Maps тарифицируется отдельно от токенов. Flash Cyber — отдельная сетка без intro-периода, доступ только через Fairwind Program.
Если вы уже заложили бюджет на Flash до конца года, имеет смысл прогнать пилот именно на 3.8 с MEDIUM, параллельно оставив 3.7 на контрольной ветке. Так вы увидите не абстрактный «+8 п.п. на DeepSWE», а разницу в числе успешных задач и в среднем числе токенов на задачу. Без этого пилота решение «мигрировать всем» — лотерея.
Effort HIGH против 3.7: сколько токенов сжигает усердие
Это, на мой взгляд, самый недооценённый раздел всей темы. Google в документации не даёт точных цифр расхода токенов, но формулирует прямо: на сложных задачах 3.8 Flash работает усерднее через дополнительные шаги рассуждения и итеративные вызовы инструментов, и на HIGH-уровне может сжигать больше токенов, чем 3.7 Flash. «Может» — это вежливая формулировка; на практике для агентных задач со сложным контекстом закладывайтесь на то, что будет.
Публичных цифр overhead HIGH vs MEDIUM vs 3.7 на реальных агентных задачах у Google нет — только качественные формулировки. Поэтому любой «плюс N процентов токенов» в обзоре был бы выдумкой. Выходные токены (включая thinking) обычно дороже входных в тарифной сетке Gemini, а 3.8 на HIGH как раз склонна жечь именно выход. Реальная экономика выглядит иначе: если 3.7 не справился и вы делаете retry или fallback на более дорогую модель, то «попытка, которая сработала с первого раза» часто дешевле «дешёвой попытки, которая не сработала». Без своего замера tok/task это остаётся гипотезой, не vendor-цифрой.
Отсюда практические рекомендации:
- Не ставьте HIGH по умолчанию. MEDIUM — дефолт не случайно: он балансирует качество и расход. HIGH оставьте для задач, где цена ошибки выше цены токенов.
- Мерьте расход по задачам, а не по среднему. «Усердие» модели распределено неравномерно: простые задачи она решает дёшево, сложные — дорого. Средняя цифра скроет хвост тяжёлых задач, который и определяет счёт.
- Если efficiency-first — у вас два легальных пути. Первый: понизить effort-уровень на 3.8. Второй: остаться на 3.7 Flash, который поддерживается. Google сама предлагает оба варианта, и это не признак слабости 3.8, а признак того, что trade-off реален.
- Кэшируйте вход. Чтение из кэша (cache read) в разы дешевле полного входа по list price Google. Для агентных пайплайнов с длинным системным промптом и повторяющимся контекстом это не оптимизация, а гигиена — проверьте долю кэшируемого префикса за первую неделю.
И ещё раз, потому что это стоит повторить: цена выхода включает thinking-токены. В моделях, где thinking тарифицируется отдельно или не тарифицируется вовсе, привычки расчёта другие. Здесь — считайте всё, что модель сгенерировала, включая то, что она «наговорила себе» в процессе размышления.
Бенчмарки: что говорят цифры — и где им не верить
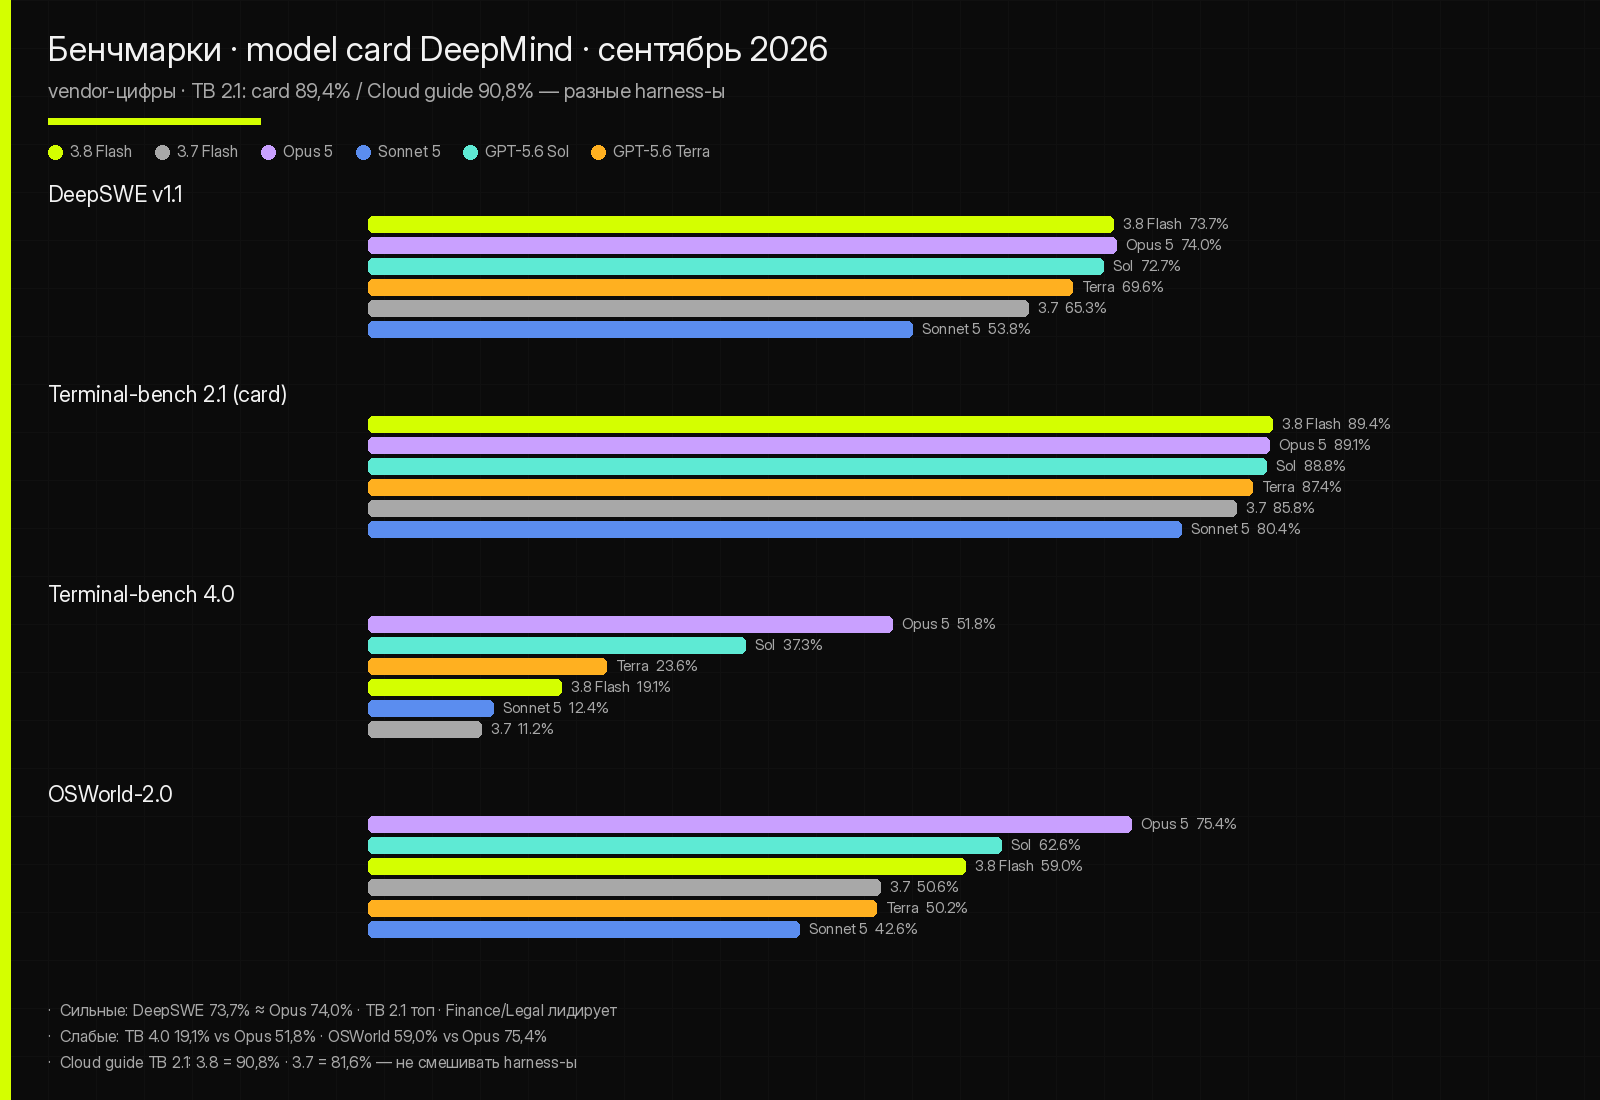
Сначала методологическая оговорка: все основные таблицы ниже — vendor-бенчмарки, то есть цифры, которые Google DeepMind опубликовала в model card (сентябрь 2026) и в Cloud developer guide. Это данные вендора, не независимый замер. Вендорские таблицы дают сравнение моделей в одном harness-е, что честнее, чем сравнивать цифры из разных источников. Но они не заменяют замеры на ваших задачах.
Расхождение Terminal-bench 2.1, которое нельзя замалчивать:
- DeepMind model card: Gemini 3.8 Flash — 89,4%, Gemini 3.7 Flash — 85,8%
- Cloud developer guide (другой harness): Gemini 3.8 Flash — 90,8%, Gemini 3.7 Flash — 81,6%
Оба источника — первичные, оба от Google, и они не сходятся. Для 3.8 разница небольшая (89,4 против 90,8 — в пределах вариации harness-а), но для 3.7 она существенная: 85,8% против 81,6% — четыре с лишним процентных пункта.
Обратите внимание, что это меняет и величину скачка между поколениями. По model card 3.8 лучше 3.7 на 3,6 п.п., по Cloud guide — на 9,2 п.п. Я не буду выбирать «правильную» цифру за вас — привожу обе с явной маркировкой источника. Рекомендую при принятии решений опираться на собственные замеры, а не на vendor-таблицу.
Похожая история с HLE (Humanity's Last Exam — экспертный мультидисциплинарный бенчмарк), и тут важно не сливать две разные метки:
- HLE-Verified (model card): 3.8 Flash — 54,9%, 3.7 Flash — 53,6%, Claude Opus 5 — 54,4%, Claude Sonnet 5 — 31,0%, GPT-5.6 Sol — 54,5%, GPT-5.6 Terra — 51,1%
- HLE (Cloud guide, без Verified-подмножества): 3.8 Flash — 45,4%, 3.7 Flash — 45,7%
Это не «модель на Cloud хуже» — это разные метки: HLE-Verified и общий HLE. На общем HLE 3.8 (45,4%) ниже 3.7 (45,7%), а на HLE-Verified 3.8 (54,9%) выше 3.7 (53,6%). «HLE» без уточнения метки — число, которое ничего не значит само по себе.
Оговорка по подозрительным цифрам. Claude Sonnet 5 на 31,0% в HLE-Verified выглядит аномально низко относительно соседних моделей (~54%). Это не опечатка обзора — так в model card DeepMind, сентябрь 2026. Claude Opus 5 показывает 75,4% и на LVBench (понимание длинного видео), и на OSWorld-2.0 (агентное управление компьютером) — совпадение значений в одной vendor-таблице, не ошибка копирования. CharXiv Reasoning (no tools) 86,2% в model card и CharXiv Multimodal 86,2% в Cloud guide — разные подбенчмарки с совпавшим результатом у 3.8 Flash, не дубль одной строки.
Теперь основная таблица model card (vendor, сентябрь 2026):
| Бенчмарк | 3.8 Flash | 3.7 Flash | Claude Opus 5 | Claude Sonnet 5 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 (длинный код) | 73,7% | 65,3% | 74,0% | 53,8% | 72,7% | 69,6% |
| GDPVal-AA v2 (Elo) | 1545 | 1482 | 1824 | 1584 | 1710 | 1528 |
| Vals Finance Agent v2 | 61,4% | 59,0% | 58,6% | 53,9% | 53,8% | 54,4% |
| Harvey Legal Agent (all pass) | 10,0% | 8,8% | 6,7% | 5,0% | 2,5% | 0,8% |
| Terminal-bench 2.1 | 89,4% | 85,8% | 89,1% | 80,4% | 88,8% | 87,4% |
| Terminal-bench 4.0 | 19,1% | 11,2% | 51,8% | 12,4% | 37,3% | 23,6% |
| GDP.PDF (all pass) | 35,0% | 34,0% | 37,0% | 28,0% | 40,0% | 29,0% |
| CharXiv Reasoning (no tools) | 86,2% | 84,5% | 83,7% | 70,1% | 85,8% | 85,9% |
| LVBench (agentic / static) | 87,8% / 87,1% | 85,4% | 75,4% | 68,5% | 82,1% | 78,9% |
| HLE-Verified | 54,9% | 53,6% | 54,4% | 31,0% | 54,5% | 51,1% |
| OSWorld-2.0 | 59,0% | 50,6% | 75,4% | 42,6% | 62,6% | 50,2% |
| BioMysteryBench (Human Solvable) | 88,8% | 87,1% | 90,1% | 87,5% | 79,5% | 83,8% |
| BioMysteryBench (Human Difficult) | 56,5% | 43,5% | 49,4% | 34,1% | 44,7% | 49,4% |
| LABBench2 | 86,2% | 82,1% | 84,2% | 80,1% | 82,1% | 81,2% |
Источник: Google DeepMind model card Gemini 3.8 Flash, сентябрь 2026.
И дополнительные цифры из Cloud developer guide (другой harness, сравнение только с 3.7):
- Terminal-bench 2.1: 90,8% у 3.8 Flash против 81,6% у 3.7
- SWE-Bench Pro: 61,6% против 60,4%
- SWE-Atlas: 51,9% против 48,0%
- τ³-bench Banking: 38,1% против 30,9%
- CharXiv Multimodal: 86,2% против 84,5%
- GDP.pdf: 35,0% против 34,0%
- HLE (не Verified): 45,4% против 45,7%
Источник: Google Cloud developer guide Gemini 3.8 Flash, сентябрь 2026.
Сильные места. DeepSWE v1.1 — 73,7% против 65,3% у 3.7 — большой скачок для одного поколения Flash, и 3.8 практически догоняет Claude Opus 5 (74,0%). Terminal-bench 2.1 (по любой из двух таблиц) — топ-уровень, наравне с Opus 5 и GPT-5.6 Sol. Vals Finance Agent и Harvey Legal Agent — 3.8 Flash обходит всех в таблице, включая топ-модели. BioMysteryBench Human Difficult — 56,5% против 43,5% у 3.7, огромный прирост. LVBench — видеопонимание на 87,8% agentic, выше всех в таблице.
Слабые места. Terminal-bench 4.0 — 19,1% против 51,8% у Claude Opus 5 и 37,3% у GPT-5.6 Sol. Разрыв с Opus — почти 33 процентных пункта. На TB 4.0 3.8 Flash не претендует на класс топ-моделей. OSWorld-2.0 — 59,0% против 75,4% у Opus и 62,6% у Sol: компьютерное использование — не её сильная сторона. GDPVal-AA v2 Elo 1545 — ниже mid-моделей вроде Claude Sonnet 5 (1584) и топ-модели (Opus 1824, Sol 1710): общая агентная полезность по этой метрике — середина.
Картина: 3.8 Flash — модель с очень неровным профилем. В коде (DeepSWE, TB 2.1), финансах, праве и мультимодальном понимании она бьёт выше своей весовой категории. В сложных терминальных задачах TB 4.0 и компьютерном использовании — заметно ниже топ-моделей. Это не «универсально вторая после Pro», это «специалист по агентному коду с бонусами».
Мультимодальность, availability и Antigravity
Мультимодальный вход — текст, изображения, аудио, видео — с выходом только в текст. Для Flash-класса это ожидаемо, но видеовход с LVBench на 87,8% (agentic) — не формальная галочка в спеках, а реально сильная сторона: модели, которые понимают видео на таком уровне, полезны далеко за пределами «опиши, что происходит в ролике» — это анализ UI-записей, видеоинструкций, потоков данных.
CharXiv Reasoning без инструментов — 86,2%, выше всех в таблице, включая Opus 5 (83,7%). CharXiv Multimodal из Cloud guide — те же 86,2% против 84,5% у 3.7. Понимание научных графиков и диаграмм — сильная сторона, что логично для модели, которую Google позиционирует как рабочую для агентного анализа документов.
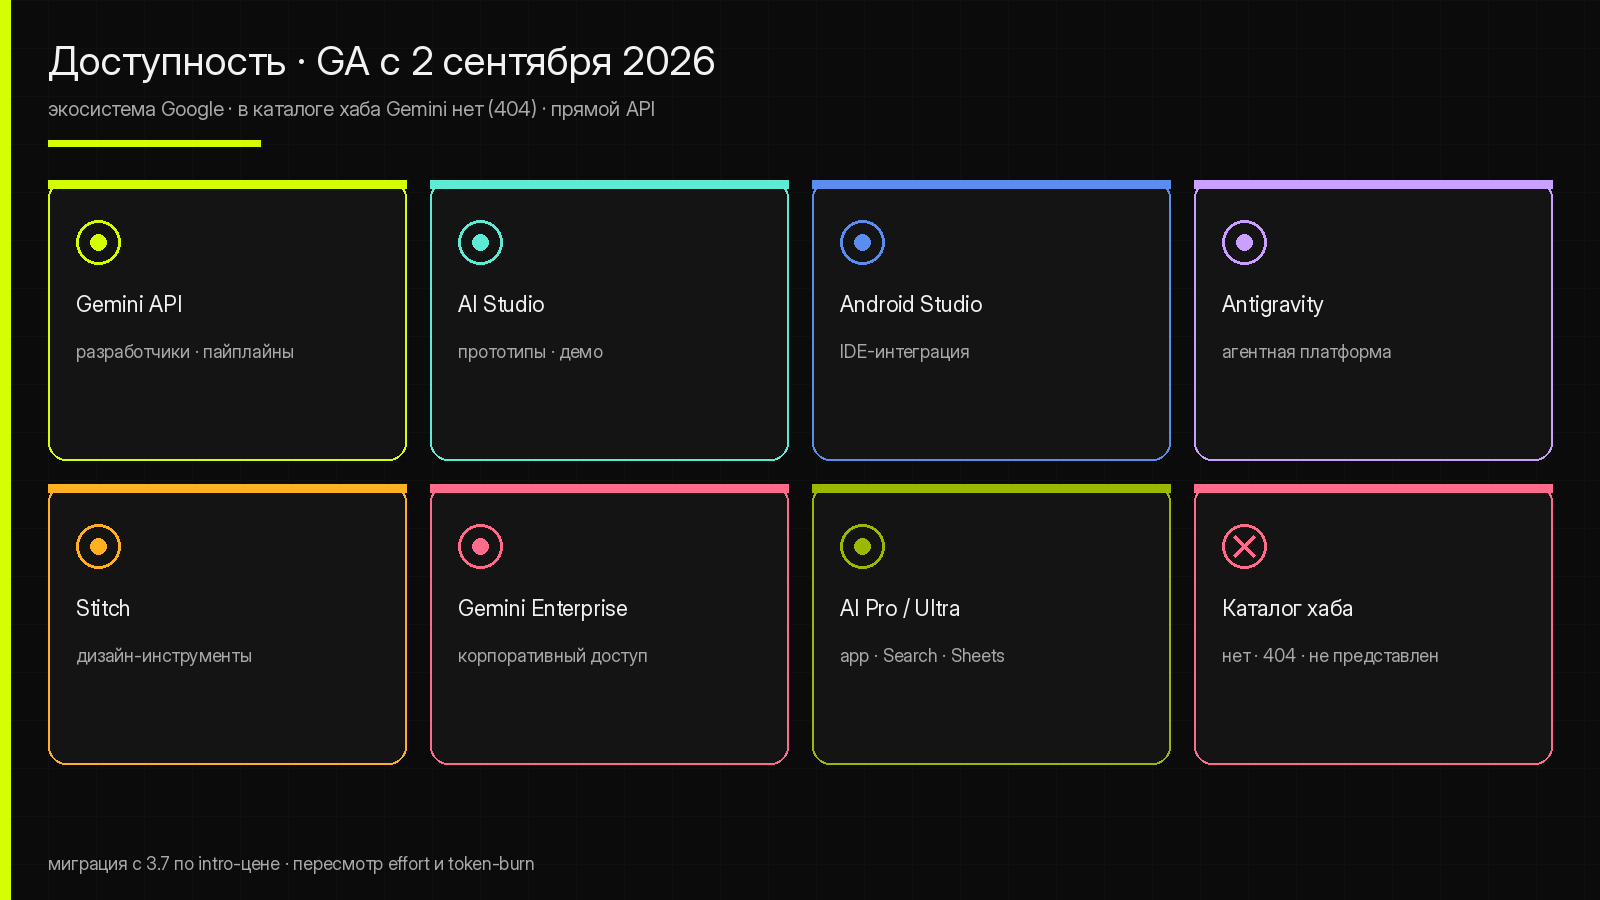
По доступности — картина широкая, GA с 2 сентября 2026:
- Gemini API и Google AI Studio — стандартные точки входа для разработчиков
- Android Studio — интеграция в среду разработки
- Antigravity — агентная платформа Google
- Stitch — дизайн-инструменты
- Gemini Enterprise — корпоративный доступ
- Google AI Pro / Ultra — приложение Gemini, AI Mode в Поиске, интеграция в Sheets
Antigravity и AI Studio в анонсе сопровождаются демо вроде 3D-игр и визуальных teardown — это маркетинговые демонстрации, не бенчмарки. Для практики важнее другое: модель день-один доступна в тех же каналах, где уже живут ваши Gemini-пайплайны. Миграция с 3.7 не требует пересмотра контракта — требует пересмотра effort и ожиданий по расходу токенов.
То есть модель доступна и через API для ваших пайплайнов, и внутри экосистемы Google для end-user сценариев. Для Enterprise есть Global и Non-global регионы.
Попробовать 3.8 Flash без своего ключа можно в чате GPThub: модель открыта гостю и на тарифе «Бесплатный». Для своих пайплайнов, кэширования и выбора effort нужен прямой Gemini API. Рядом в каталоге — DeepSeek V4 Flash и Grok 4.5; для mid-полки — GPT-5.6 Luna.
Safety и Flash Cyber
Коротко, но по делу. Gemini 3.8 Flash Cyber — это отдельная модель, не «режим» обычного Flash. Доступ — только для trusted defenders через Fairwind Program, то есть для организаций, занимающихся защитой, прошедших отбор Google. Цены у Cyber — сразу по regular list price, без intro-периода. Если вы не участник Fairwind — этой модели для вас не существует, и любые «обходные пути» — не про официальный доступ.
Практический вывод для обычных пользователей: не путайте. Когда где-то пишут «Gemini 3.8 Flash для кибербезопасности» — речь о модели, которую вы не сможете вызвать через публичный API. Обычный 3.8 Flash — общедоступная модель со стандартными safety-фильтрами Gemini, и для offensive-сценариев она не предназначена — а тем, кому нужны кибер-возможности в защитных целях, дорога в Fairwind Program.
Отдельно про честность позиционирования: Google не пытается продать Cyber как фичу широкой аудитории, и это правильно. Разделение на публичную рабочую модель и специализированную defensive-модель через программу доступа — разумная архитектура выбора, и в обзоре я сознательно не раздуваю тему Cyber: для большинства читателей она релевантна только как «вот что существует, но не для вас».
Итоги для выбора
Сначала — кому Gemini 3.8 Flash однозначно стоит попробовать через Gemini API.
Да, если:
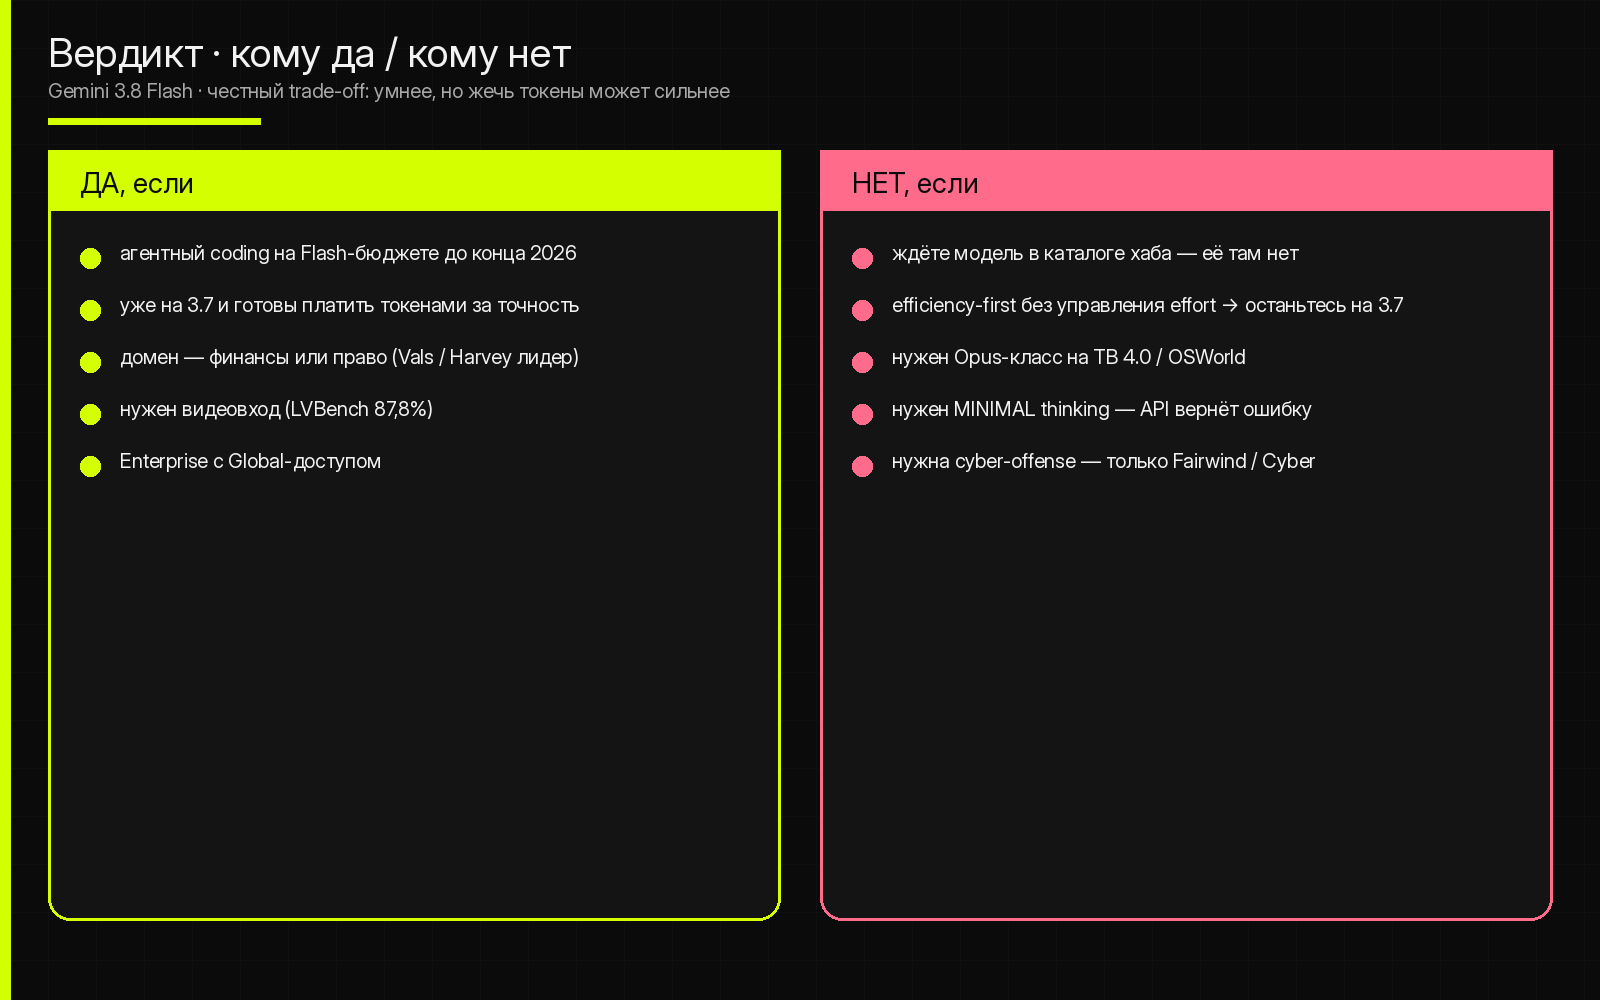
- Вы строите агентные сценарии на коде до конца 2026 года. Это ядро целевой аудитории. DeepSWE 73,7% и TB 2.1 на уровне топ-моделей в vendor-таблице — сильное соотношение качества и Flash-класса в intro-окне Google. С 1 января экономика станет жёстче.
- Вы уже на 3.7 Flash и готовы платить токенами за точность. Скачок на DeepSWE (+8,4 п.п.), TB 2.1 (+3,6 п.п. по card, +9,2 п.п. по Cloud guide), BioMysteryBench Difficult (+13 п.п.) — рост, который в агентных пайплайнах конвертируется в меньше retry, меньше fallback, меньше ручных правок.
- Ваш домен — финансы или право. Vals Finance Agent 61,4% и Harvey Legal Agent 10,0% all-pass — 3.8 Flash впереди всей таблицы, включая модели дороже по list price Google.
- Вам нужен видеовход. LVBench 87,8% и CharXiv 86,2% — мультимодальное понимание на уровне, где Flash обходит топ-конкурентов.
- Вы Enterprise с Global-доступом. Широкая availability, региональные опции, кэширование — инфраструктурная история зрелая.
Нет, если:
- Вам нужен свой effort-уровень в нашем чате. В GPThub Gemini 3.8 Flash работает как обычный диалог, отдельной настройки усилия там нет. Выбирать LOW/MEDIUM/HIGH можно только через Gemini API.
- Вы efficiency-first и не хотите управлять effort-уровнями. Если вы не готовы мониторить расход токенов и осознанно выбирать между LOW/MEDIUM/HIGH, усердие 3.8 будет кусаться. Оставайтесь на 3.7 Flash — Google явно оставила его supported именно для вас.
- Вам нужен Opus-класс на TB 4.0 или OSWorld. 19,1% на TB 4.0 против 51,8% у Opus 5, 59,0% на OSWorld против 75,4% — если ваш workload — сложное компьютерное использование или терминальные задачи TB 4.0, 3.8 Flash не дотягивает, и никакой effort-уровень это не исправит.
- Вам нужен MINIMAL thinking. Его нет, API вернёт ошибку. Если ваш пайплайн опирается на минимальный уровень размышлений — это блокер.
- Вам нужна cyber-offense. Не сюда. Defenders — в Fairwind Program за Flash Cyber, все остальные — мимо.
Отдельно про соседние модели из каталога GPThub, если нужен второй взгляд на ту же задачу. GPT-5.6 Luna и GPT-5.6 Terra закрывают mid/топ полку OpenAI; Grok 4.5 — топ xAI; DeepSeek V4 Flash — Flash-класс для длинного текста на «Плюс». Это не «замены один-в-один», а ориентиры, куда смотреть в каталоге.
Общий итог: Gemini 3.8 Flash — сильный релиз с честно задокументированным trade-off. Google сделала модель умнее, признала, что она дороже в токенах, и оставила предыдущее поколение для тех, кому важнее экономия. Главное — не попасть в ловушку intro-цен: считайте экономику пайплайна по regular-тарифам с 2027 года, потому что 31 декабря ближе, чем кажется, а модель на HIGH способна устроить неприятный сюрприз в счёте.
Вопросы и ответы
Gemini 3.8 Flash доступна в GPThub?
Да, с 8 октября 2026: гостю с дневным лимитом сообщений и на тарифе «Бесплатный», без карты. В чате нет отдельной настройки усилия. Свои пайплайны и effort-уровни — через Gemini API и Google AI Studio. Подробности — на странице модели.
Что меняется в ценах Google с 1 января 2027 года?
Intro-тарифы действуют до 31 декабря 2026 года, с 1 января list price удваивается для входных и выходных токенов (thinking-токены включены в выход). Конкретные цифры — у вашего провайдера Gemini API. В GPThub модели нет — смотрите тарифы GPThub.
Почему цифры Terminal-bench 2.1 разные в разных документах Google?
Потому что это разные harness-ы. Model card DeepMind даёт 89,4% для 3.8 Flash (и 85,8% для 3.7), Cloud developer guide — 90,8% (и 81,6% для 3.7). Мы приводим обе цифры с маркировкой источника и рекомендуем не выбирать «удобную» — а проверять на своих задачах.
Стоит ли переезжать с 3.7 Flash на 3.8?
Если ваш workload — агентный код, финансы, право или мультимодальный анализ — да, прирост на бенчмарках существенный. Если приоритет — минимальный расход токенов и вы не хотите управлять effort-уровнями — Google официально рекомендует остаться на 3.7 Flash (он поддерживается) или понизить effort на 3.8.
Какие нюансы у thinking-уровней?
Поддерживаются LOW, MEDIUM (дефолт) и HIGH. MINIMAL не поддерживается и возвращает API validation error. Также при миграции учтите: thinking_budget заменён на строковый thinking_level, temperature/top_k/top_p игнорируются молча, а penalties и candidate_count вызывают ошибку.
Gemini 3.8 Flash Cyber — это то же самое, что обычный Flash?
Нет. Это отдельная модель для кибербезопасности, доступная только trusted defenders через Fairwind Program, по regular-ценам без intro-периода. Через публичный API её вызвать нельзя.
Связанные модели


Связанные гайды
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash на бесплатном, «Плюс» (DeepSeek, Nano, Luna, GLM, Kimi) или «Про» (Claude, Terra, Grok 4.5).
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
- Как выбрать модель
Какую модель взять: текст или картинки, бесплатный тариф, «Плюс» или «Про». Короткая схема выбора и примеры под код, письма и разбор.
Источники
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Смотреть доступные модели
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.