
"Seedance: что это за модель генерации видео"
Обозреватель: модели и релизы
Содержание
Seedance нейросеть делает короткий ролик со звуком по тексту, картинке и чужому фрагменту. Её выпускает команда ByteDance Seed. Линейка дошла до версии 2.5: один проход до 30 секунд, опора на десятки кадров и правка по времени. В чате GPThub на 1 ноября 2026 открываются две линии второй версии: Seedance 2 Fast и Seedance 2 Omni Pro. Обе собирают ролик от 4 до 15 секунд. Ниже собрали то, что команда сама написала в постах, и то, что видно в чате. Свежее 2.5 на 1 ноября 2026 у ByteDance Seed ничего нет: в списке моделей на сайте команды стоит именно она.
Seedance нейросеть: чья она и что отдаёт
Имя часто пишут как «сиданс». Это та же модель. За ней стоит ByteDance, та же компания, что выпускает TikTok и линейку картинок Seedream. Видео ведёт отдельная группа Seed. Публичные посты подписаны ByteDance Seed Team.
Задача узкая. На входе описание сцены, иногда готовый кадр, чужой ролик или звук. На выходе файл с движением и дорожкой. Текстовый ответ, код и длинный разбор документа сюда не входят. Если нужен текст, это другая модель. Как выбирать между текстом, картинкой и видео, уже разобрано в гайде по выбору модели.
Звук здесь не накладывают потом отдельной программой. С версии 1.5 pro картинка и звук рождаются вместе. Команда называет это совместной генерацией. На практике это значит одно: речь, шум и музыка пытаются попасть в то же движение, которое вы видите. Попадание не гарантировано. В посте про 2.0 прямо сказано, что искажения звука ещё встречаются.
Ролик короткий. У 2.0 потолок одного прохода 15 секунд. У 2.5 потолок 30 секунд. Дальше длина растёт продлением: модель дописывает следующий кусок, держа героя и место. Это всё ещё склейка кусков, а не полнометражный фильм за один запрос.
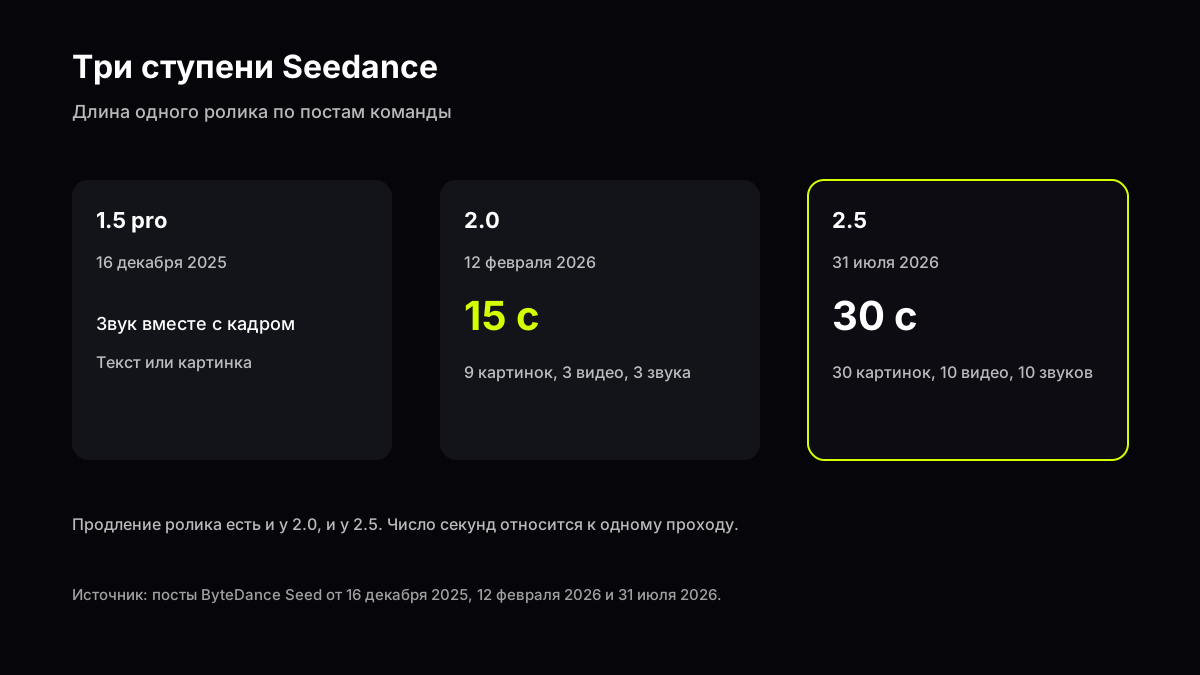
Источник: посты ByteDance Seed, 16 декабря 2025, 12 февраля 2026 и 31 июля 2026
Что изменилось от 1.5 к версии 2.0
16 декабря 2025 вышла Seedance 1.5 pro. До неё, в линейке 1.0, команда в первую очередь чинила устойчивость движения. 1.5 pro добавила звук и более смелую картинку. Вход тогда был проще: текст или картинка, которая ведёт ролик. Техническое описание лежит в открытой карточке на arXiv от 15 декабря 2025. Там архитектура с двумя ветками, одна для видео и одна для звука, и ускорение вывода больше чем в 10 раз относительно их же прежней схемы. Это замер авторов модели.
12 февраля 2026 вышла Seedance 2.0. Пост сравнивает её с 1.5 и перечисляет четыре сдвига.
- Сложные сцены с несколькими людьми и трудным движением чаще доходят до пригодного ролика. Пример, который команда показывает сама: парное фигурное катание, прыжок, вращение, посадка на лёд.
- В один запрос можно положить до 9 картинок, до 3 видео и до 3 звуков плюс текст. Модель смотрит на композицию, жест, ход камеры, эффект и тембр.
- Появились продление и правка. Можно попросить продолжить сцену или заменить действие, героя, кусок сюжета.
- Один ролик до 15 секунд может содержать несколько планов. Звук двухканальный: музыка, фон и реплика идут параллельно и должны попадать в ритм кадра.
Команда называет свой внутренний набор SeedVideoBench-2.0 и ставит 2.0 впереди по устойчивости движения, следованию инструкции и виду картинки. Цифр в тексте поста нет, графики нарисованы картинкой. Мы эти столбцы в таблицу не переносим. Это их замер, не чужой экзамен.
Там же команда честно оставляет хвост. Мелкие детали всё ещё плывут. Сверхреализм и «живость» движения не добраны. Несколько героев сразу держатся хуже одного. Текст внутри кадра промахивается. Сложный монтаж ломается. Звук иногда искажается. Если ролик нужен как черновик раскадровки, этого часто хватает. Если нужен кадр с читаемой вывеской и тремя лицами в одном плане, закладывайте повтор.
Отдельная строка в конце поста 2.0 про лица. Демонстрационные ролики сняты на сгенерированных или лицензированных людях. Чужой портрет как образец внешности требует проверки личности или заранее полученного разрешения. Это правило площадки разработчика. Юридическую консультацию текст не заменяет. Для своего ролика спокойнее опереться на рисунок, манекен или на персонажа, которого вы сами сгенерировали и на которого у вас есть права.
Seedance 2.5: тридцать секунд и плотная опора
31 июля 2026 команда выпустила Seedance 2.5. Повод они формулируют сами: люди перестали просить «просто клип» и стали просить законченный кусок истории. Архитектура та же, совместная генерация звука и видео. Сдвинулись длина, число опор и точность правки.
Один проход вырос с 15 до 30 секунд. Внутри этих 30 секунд модель должна разложить связанные планы: завязка, развитие, поворот, финал. В посте есть пример одним проходом камеры. Певица поправляет наушник в гримёрке, идёт по коридору, встречает танцоров и выходит на сцену. Это рекламный показ команды, не обещание, что ваш запрос повторит ту же дугу с первого раза.
Продление осталось и стало многократным. В примере из поста мальчик с мячом бежит по вагону, выскакивает на улицу, взрослый его догоняет. Второй кусок на 30 секунд держит тех же людей, ту же картинку и те же шумы. Команда пишет, что так собирают ролик на несколько минут. Стык между кусками всё равно стоит смотреть глазами: лицо, одежда, сторона света в кадре.
Опора стала гуще. За один проход: до 30 картинок, до 10 видео и до 10 звуков. Пост ByteDance Seed от 31 июля 2026 даёт именно эту тройку чисел. Позже, 6 августа 2026, BytePlus в заметке про API пишет «до 50 смешанных опор». Это их способ сложить те же корзины, а не новый потолок сверх поста Seed. В тексте держимся поста команды Seed.
Отдельно названы три приёма опоры.
- Белая модель без фактуры. Вы задаёте объёмы, кто где стоит и как едет камера. Модель натягивает на этот каркас свет, материал и цвет с другой картинки. В посте так собирают и сказку, и сборку автомобиля.
- Опора на движение. Жест и темп берутся из чужого ролика, внешность берётся из картинки.
- Опора на образец стиля. Композиция, костюм, реквизит и место приходят из разных кадров, текст говорит, что с чем соединить.
Правка стала точнее по времени. Можно сказать, что происходит с нулевой по четвёртую секунду, и что камера делает с четвёртой по седьмую. После генерации можно поменять действие в куске и оставить остальное. Есть замена фона за человеком, как на зелёном экране: одежда, волосы и шаг должны подстроиться под новый свет. Есть отдельная правка только хода камеры, без смены героя.
Слабое место команда снова называет сама. Физика сложного движения всё ещё проседает. Сцена, где несколько людей взаимодействуют, держится хуже одиночного плана. Это фраза из заключения поста 2.5, не наша догадка.
Дальше в том же посте перечислены отрасли: школьный ролик, синтетические данные для робота, редкие дорожные ситуации для проверки машины. Это список намерений. Отдельного публичного экзамена по этим задачам в посте нет, поэтому оценивать «подходит для завода» по одному абзацу рано.
Что открыто в чате на 1 ноября 2026
В чате GPThub стоят две строки второй версии: Seedance 2 Fast и Seedance 2 Omni Pro. Проверка каталога чата от 1 ноября 2026. У обеих длина от 4 до 15 секунд, шаг в одну секунду. Кадр горизонтальный 16:9 или вертикальный 9:16. Если длину и кадр не трогать, ролик пойдёт на 4 секунды и 16:9.
Имена Fast и Omni Pro в постах ByteDance Seed не расшифрованы. Мы не приписываем им разный потолок секунд: в чате он общий. Разницу имеет смысл ловить на одной и той же сцене, а не по слову в названии.
Версию 2.5 в этом обзоре описываем по посту от 31 июля 2026. В чате на дату проверки называем Fast и Omni Pro. Ждать, что 30 секунд и 30 картинок приедут сами, не стоит: смотрите на поля длины и кадра в окне ролика.
Рядом в том же чате есть и другие генераторы видео. Общий разбор, чем они отличаются по задаче, лежит в статье нейросети для видео. Здесь не сводим таблицу «кто победил». Для Seedance важен свой контур: звук в том же проходе, короткая длина, опора на картинку. Соседей по задаче мы разобрали отдельно: Kling, Veo и Sora. Если хочется понять, почему у всех них плывут пальцы и буквы, начните со статьи о том, как нейросеть делает видео.
Картинка на входе часто решает больше текста. Как собрать удачный неподвижный кадр до того, как оживлять его, разобрано в гайде по работе с картинками. Сравнение ответов разных моделей на одну задачу, без гонки за местом в рейтинге, есть в гайде про сравнение на практике.
| Что спросить у окна | Seedance 2 в чате, 1 ноября 2026 | Seedance 2.5 по посту команды |
|---|---|---|
| Длина одного прохода | от 4 до 15 секунд | до 30 секунд |
| Кадр | 16:9 и 9:16 | в посте примеры в основном широкие |
| Опора | картинка к ролику, текст | до 30 картинок, 10 видео, 10 звуков |
| Продление | в посте 2.0 есть, в чате смотрите поля | несколько кругов, куски по 30 секунд |
Какой запрос вообще имеет смысл
Пошаговую инструкцию с кнопками сюда не кладём. Ниже три типа задач, которые посты 2.0 и 2.5 показывают как родные, и что в ответе проверять. Готовый текст запроса каждый раз собирайте под свою сцену.
Первый тип: одна сцена, один герой, понятное действие. В посте 2.0 девушка вешает бельё и встряхивает следующую вещь. Движение простое, физика ткани видна, лиц мало. Для такого ролика хватает короткого описания и, если есть, одного кадра. Смотрите четыре вещи. Руки не меняют число пальцев на полуслове. Ткань падает вниз, а не вбок. Лицо не плывёт между началом и концом. Звук ткани не превращается в музыку, если вы просили шорох.
Второй тип: продолжение. Вы уже получили кусок и просите следующий, с тем же человеком и тем же местом. В примере 2.5 взрослый догоняет мальчика после вагона. Проверяйте стык. Одежда, причёска, сторона, с которой свет. Предмет в руке не должен смениться на другой без просьбы. Если стык врёт, короче попросить один новый план, чем три раза продлевать кривой.
Третий тип: опора на несколько картинок. Герой с одного кадра, комната с другого, вещь с третьего. Пост 2.0 ограничивает это девяткой картинок. Пост 2.5 поднимает планку до тридцати, но путать число с качеством не стоит. Лишняя картинка, которая спорит с первой по свету, чаще ломает ролик, чем помогает. Оставьте один кадр лица, один кадр костюма, один кадр места. В ответе сверьте три якоря: лицо, цвет одежды, геометрия комнаты. Текст на одежде и на стене считайте ненадёжным, пока не увидите его своими глазами. Команда 2.0 сама пишет, что буквы в кадре промахиваются.
Камера. Имеет смысл назвать крупность и один ход: «средний план, камера медленно обходит». Длинная раскадровка на 15 секунд с пятью сменами плана часто разваливается на третьем склее. Пример с посекундным планом в посте 2.5 относится к правке уже снятого ролика, а не к первому черновику из пустого поля.
Звук лучше описывать предметом, а не настроением. «Шорох ткани и один удар каблука» модель понимает ближе к делу, чем «кинематографичная атмосфера». В посте 2.0 отдельное демо построено на бытовых звуках: матовое стекло, плюш, акрил, пупырчатая плёнка, зубья расчёски. Там нет музыки специально. Если вам нужен такой же сухой звук, напишите, что музыки нет. Иначе дорожка легко заполнится мелодией, потому что двухканальная схема 2.0 как раз умеет класть музыку рядом с шумом.
Речь держите короткой. Одна фраза на весь ролик проверяется легче, чем диалог. В посте 1.5 pro команда хвалит попадание губ в разные языки и диалекты. Это их заявление из карточки модели. На своём ролике всё равно дослушайте концовку: пост 2.0 предупреждает про искажения. Если слово поплыло, короче убрать реплику и оставить шум, чем спорить с дорожкой в монтаже.
Длина в чате выбирается до запуска. Четыре секунды хороши для предмета на столе. Восемь и десять секунд уже тянут один поворот камеры. Пятнадцать секунд имеют смысл, только если внутри есть два понятных такта: пришёл и сделал. Пустой запас секунд модель заполняет сама, обычно лишним жестом или шагом камеры в сторону. Это чаще портит дубль, чем спасает.
Чего лучше не ждать от одного прохода. Читаемая вывеска. Три человека, которые говорят по очереди и не меняются лицами. Точный танец с касанием рук. Длинный текст песни, спетый в такт. Посты как раз хвастают такими демо, и там же признают, что сложное взаимодействие ещё слабое. Для черновика сцены это годится. Для финала рекламы закладывайте несколько дублей и отбор.
Где модель сильна, где нет
Сильная сторона, если верить собственным постам и не дорисовывать за них, собрана вокруг короткого зрелищного куска.
- Движение одного или двух тел с понятной физикой: шаг, поворот, ткань, предмет в руке.
- Звук, который должен совпасть с действием: шаг, удар, шорох, короткая реплика. Двухканальная схема 2.0 как раз про музыку, фон и голос сразу.
- Продолжение уже удачного куска, а не новая вселенная каждые 15 секунд.
- Сборка сцены из отдельных картинок: лицо, костюм, место. Это прямой сюжет постов 2.0 и 2.5.
- Вертикальный кадр 9:16 в чате, если ролик пойдёт в сторис. Горизонтальный 16:9, если кадр для сайта и для широкого экрана.
Слабая сторона названа теми же постами.
- Много людей в одном плане. Согласованность падает.
- Мелкий текст, логотип, этикетка, субтитр. Буквы в кадре не договор.
- Сложный монтаж и точная склейка по секундам с первого раза.
- Физика столкновений, парного спорта, быстрых рук. Демо катания в посте 2.0 красивое, оговорка про физику в посте 2.5 остаётся.
- Звук иногда искажается. Реплику на нужном языке стоит прослушать до конца, а не судить по первой секунде.
- Длина. Даже 2.5 с продлением собирает минуты из кусков по 30 секунд. Полный сюжет на десять минут одним запросом пост не обещает.
Отсюда простое правило отбора. Если сцена помещается в 5 или 8 секунд, в ней один герой и звук можно описать одним словом, Seedance 2 в чате попадает в задачу. Если нужна смена пяти мест и толпа, сначала режьте историю на планы сами. Модель доклеит план. Режиссёра она не заменяет, хотя пост 2.0 любит слово «режиссёрский контроль».
Один и тот же сюжет полезно прогнать дважды, не меняя текст, и положить ролики рядом. Расхождение покажет, что модель додумала сама. Типичные додумки по оговоркам постов: лишний человек на фоне, буква на стене, скачок света между планами, предмет, который меняет форму в руке. Если оба дубля врут в одном и том же месте, виноват запрос. Уберите половину деталей и оставьте героя, действие и место. Если врёт только один дубль, оставляйте второй. Гонка за третьим и четвёртым прогоном без правки текста редко лечит физику.
Вертикальный и горизонтальный кадр не взаимозаменяемы. 9:16 режет бока. Группа людей, которая в 16:9 стояла в ряд, в вертикали начнёт налезать друг на друга или выпадать из кадра. Для сторис оставьте одного человека и крупный предмет. 16:9 наоборот плохо переносит высокий объект вроде полного роста в узкой комнате: макушка и пол спорят за место. Кадр выбирайте до текста, а не кройте потом.
Пост 2.5 предлагает белую модель как каркас для камеры. В бытовом виде это можно заменить очень простой схемой: три фразы по времени, без картинки-объёма. «С 0 до 4 секунд человек берёт чашку. С 4 до 8 секунд подносит её к лицу. С 8 до 12 секунд ставит обратно». Такой каркас ближе к правке по меткам времени, которую команда описывает для 2.5. На строках чата с потолком 15 секунд третья фраза ещё помещается. Четвёртая уже спорит с длиной. Если окно не даёт выбрать 12 секунд и оставляет 4, каркас из трёх тактов бессмысленен: модель сожмёт всё в один жест. Сначала длина, потом такты.
Кому она нужна, а кому хватит картинки
Креаторам коротких роликов модель попадает в работу чаще всего. Заставка, петля настроения, предмет, который поворачивается, человек, который делает одно действие. Вертикальный кадр уже заложен в чате. Звук экономит отдельный шаг, если шорох и короткий удар устраивают с первого дубля.
Рекламе короткого продукта сцена тоже близкая: предмет, рука, стол, один свет. Пост 2.0 показывает ролик с бутылкой, где персонаж высовывается из картины. Это демонстрация управляемости, не шаблон для чужого бренда. Чужой логотип и чужая упаковка остаются чужими. Текст на этикетке, как уже сказано, лучше не поручать модели.
Учебный ролик команда 2.5 приводит как отдельный сюжет: улица эпохи, опыт, схема в движении. Здесь полезен приём белой модели: сначала расстановка, потом картинка. Для точной схемы эксперимента ролик всё равно стоит сверить с учебником. Модель не источник факта. Она источник движения.
Кому рано открывать видео. Если задача в том, чтобы получить один сильный неподвижный кадр, видео только потратит попытку. Сначала картинка, потом оживление. Если нужен длинный диалог двух людей с устойчивыми лицами, посты сами ставят это в список недожатого. Если нужен документ, таблица или код, Seedance тут ни при чём.
Проверка перед тем, как оставить дубль:
- Лицо и одежда те же в первой и в последней секунде.
- Предмет в руке не подменён.
- Свет падает с одной стороны, тень ему не противоречит.
- Звук относится к действию в кадре.
- В кадре нет чужого читаемого бренда, которого вы не просили.
- Длина та, что вы задали: 4 секунды по умолчанию легко принять за «модель сама решила коротко».
Дата этой сверки: 1 ноября 2026. Посты, на которые опирается текст: 16 декабря 2025, 12 февраля 2026, 31 июля 2026. Если в окне чата длина или список имён изменится, смотрите на поля ролика, а не на абзац выше.
Вопросы и ответы
Что такое Seedance нейросеть?
Это модель генерации видео от команды ByteDance Seed. Она собирает короткий ролик и звук в одном проходе. Актуальные публичные ступени на ноябрь 2026: 2.0 от 12 февраля и 2.5 от 31 июля.
Чем Seedance 2.0 отличается от Seedance 2.5?
У 2.0 один проход до 15 секунд и опора до 9 картинок, 3 видео и 3 звуков. У 2.5 один проход до 30 секунд, опора до 30 картинок, 10 видео и 10 звуков, плюс правка по меткам времени. Обе версии умеют продлевать ролик. Цифры взяты из постов команды, не из чужого прайса.
Чья нейросеть Seedance?
Её выпустила команда ByteDance Seed. Посты о 1.5 pro, 2.0 и 2.5 подписаны этой командой и лежат на seed.bytedance.com.
Есть ли нейросеть Seedance для генерации видео длиннее минуты?
Один проход у 2.5 ограничен 30 секундами. Минуты команда собирает несколькими продлениями, держа героя и место. Цельный фильм одним запросом пост не описывает.
Seedance 2 и Seedance 2.0 это одно и то же?
В постах ByteDance имя версии пишется как Seedance 2.0. В чате на 1 ноября 2026 строки называются Seedance 2 Fast и Seedance 2 Omni Pro. Это линии второй версии с длиной до 15 секунд. Версия 2.5 вышла отдельным запуском 31 июля 2026.
Что проверять, если ролик «почти хороший»?
Стык лица, предмет в руке, сторону света и попадание звука в действие. Буквы в кадре перечитайте по буквам. Если врёт одна из этих четырёх вещей, дешевле новый дубль с более короткой сценой, чем правка в редакторе по кадру.
Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
Ещё по теме
Источники
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Открыть видео в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.