
Как нейросеть делает видео из текста и из картинки

Обозреватель: как устроен ИИ
Содержание
15 февраля 2024 года инженеры OpenAI выложили технический отчёт о модели Sora без кода и без весов, но с подробной схемой. Там подробно и простым языком связали три идеи: нарезку кадров на куски во времени и пространстве, обучение сети убирать шум из сжатого представления и текстовую подсказку, какую сцену нужно получить. С тех пор линейки сменились, появился звук в одном проходе с картинкой, а у Google к осени 2026 года обновились названия моделей в документации для разработчиков. Механика при этом осталась узнаваемой. Как нейросеть создаёт видео, если коротко: она собирает правдоподобное движение в сжатом пространстве, шаг за шагом очищая его от шума. С монтажом уже снятого материала это имеет мало общего.
Почему «оживить картинку» — неверная картинка в голове
Часто представляют так, будто есть файл снимка, и нейросеть «двигает пиксели», как в простой анимации слайдов. На деле генератор не хранит ваш файл и не сдвигает его слои. Он заново рисует последовательность кадров, опираясь на сжатое описание сцены. Статичная картинка на входе лишь жёстко фиксирует начало: цвет неба, положение героя, ракурс. Дальше сеть достраивает траектории, и здесь начинаются типичные ошибки, если описание движения расплывчато.
Тот же принцип для текста. Описание «кошка на подоконнике» не означает, что где‑то лежит готовый ролик с котом. Модель выбирает правдоподобное продолжение из того, на чём её учили: миллионы пар «описание — видео» с разметкой. Чем точнее вы задаёте свет, масштаб и действие, тем уже этот выбор. Даже одно лишнее прилагательное иногда тянет сцену в сторону: «старый деревянный стол» может дать другую фактуру, чем «стол у окна», хотя в обоих случаях кот остаётся на подоконнике.
Как нейросеть создаёт видео по тексту
Схема в двух фразах такая. Видео сжимают, в сжатом виде добавляют шум, сеть учится шум убирать, а на выходе декодер разворачивает результат в пиксели. Всё остальное — подробности о том, как сеть обращается с тремя осями: время, высота и ширина.
Кадр — одна картинка. Клип — упорядоченная последовательность кадров. Сжатое представление — компактный код кадра или короткого фрагмента, где остаются контуры и цвет, мелкий шум отброшен. Патч — маленький кусок кадра или кусок «кадр плюс соседний кадр», который модель обрабатывает как один токен.
OpenAI в отчёте от 15 февраля 2024 года описывает цепочку так. Сначала отдельная сеть сжимает исходное видео по пространству и времени. Затем из сжатого объёма нарезают патчи во времени и пространстве и подают их в трансформер. На обучении в патчи добавляют шум, а диффузионная модель учится предсказывать исходный «чистый» патч. На генерации порядок обратный. Стартуют со случайного шума и за серию шагов получают согласованную сцену. Текстовое описание на каждом шаге подсказывает, какой шум убирать.
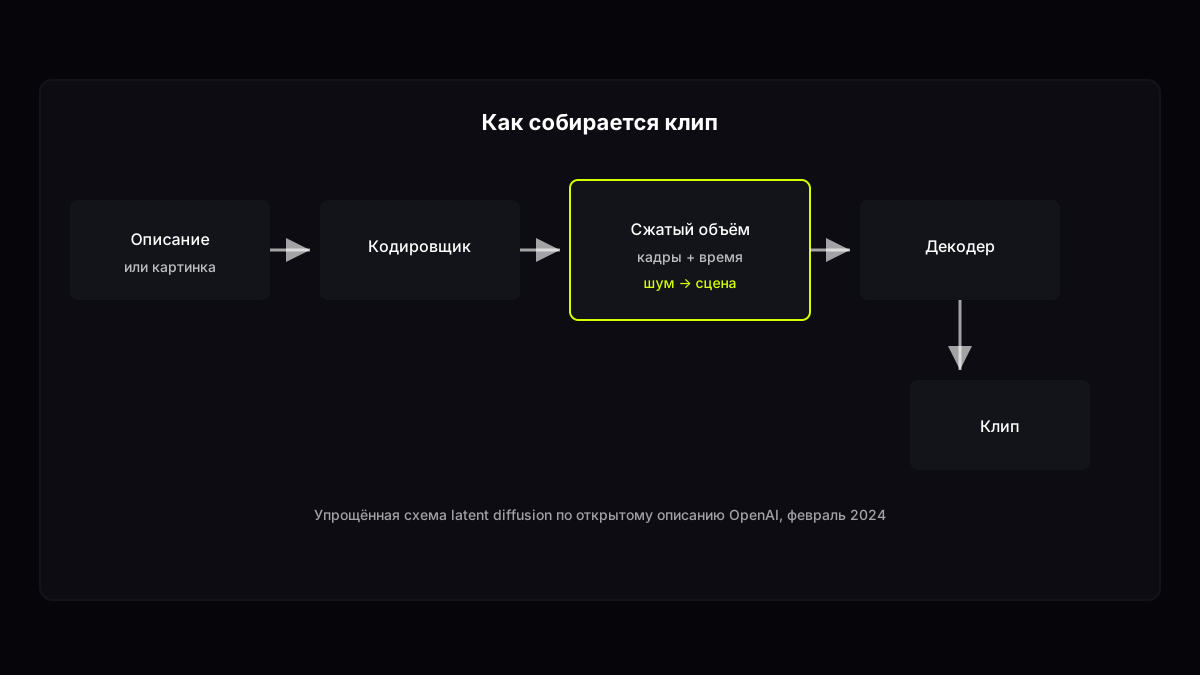
Источник: упрощение по открытому отчёту OpenAI, февраль 2024
MIT Technology Review в разборе от 12 сентября 2025 года сравнивает диффузию в сжатом пространстве с потоковым видео в интернете. Сервер отправляет ролик в сжатом виде, чтобы он быстрее дошёл, а ваше устройство разворачивает его обратно в картинку. В генераторе так же: вся работа идёт над сжатым кодом, и только в конце декодер превращает его в пиксели. Сжатие экономит вычисления, но, по оценке того же издания, видео всё равно требует во много раз больше энергии, чем текст или картинка.
Чем ролик отличается от одной картинки
Генератор картинок решает задачу на одном временном слое. Видеогенератор добавляет ось времени, и каждый новый кадр должен согласоваться с предыдущим. Поэтому видеомодель больше, дольше учится и дольше считает на запуск. OpenAI в том же отчёте 2024 года показывает, что одна архитектура может выдавать и картинку, и ролик. Картинка получается, если временная глубина сжатого блока равна одному кадру.
Для автора это означает простую вещь. Удачный кадр из генератора изображений можно подать на вход видеомодели, но движение всё равно придумает видеосеть. Если на статичном кадре уже искажены буквы или руки, анимация эти ошибки размножит по времени.
Откуда модель «знает» физику движения
На обучении модель видит миллионы реальных роликов с подписями. Она не получает явных формул, зато подстраивает веса так, чтобы следующий кадр был похож на то, что обычно следует за предыдущим в данных. OpenAI описывает отдельные эффекты, которые проявляются на больших масштабах обучения: согласованное движение камеры, сохранение объекта за преградой, след кисти на холсте. Это побочный продукт масштаба, без отдельного модуля «законы физики».
Впрочем, те же авторы честно перечисляют провалы. Стекло разбивается неправильно, еда при «поедании» меняет форму странно. Для бытового ролика надёжнее простые действия и короткие клипы, чем обещания «кинематографичной физики» из рекламы.
Зачем отдельно думать про время
У картинки две оси. У видео третья — время, и она упорядочена: кадр 40 должен совпадать с кадром 39 по положению героя, иначе зритель видит дёрганье. Архитектуры решают это по‑разному: где‑то внимание считают сначала внутри кадра, потом между кадрами; где‑то строят полное пространственно‑временное внимание, но только на сильно сжатых данных. OpenAI пишет, что у Sora на больших масштабах проявляются эффекты наподобие «постоянства объекта»: человек может выйти из кадра и вернуться узнаваемым, хотя это не гарантия.
Практический вывод для автора ролика: короткое действие модель держит лучше, чем длинный сюжет с поворотами. Если нужна минута сюжета, её обычно собирают из нескольких сгенерированных кусков в монтаже. Это уже другая дисциплина, и она разобрана в сравнении генерации и монтажа. Между кусками монтажёр следит, чтобы цвет, резкость и направление движения не менялись скачком, иначе зритель заметит шов раньше, чем успеет понять сюжет.
Как нейросеть делает видео из картинки
Режим «картинка → видео» использует тот же процесс удаления шума, но граничные условия другие. Первый кадр жёстко привязан к вашему файлу. Модель не должна перерисовать небо или лицо в нулевой момент времени. Дальше она рисует следующие моменты так, чтобы движение выглядело непрерывным.
На странице DeepMind для Veo 3.1 перечислены режимы с опорой на картинки: заданы первый и последний кадр, несколько референсов для одной сцены, вставка и удаление объекта, управление камерой. В сносках к сравнениям октября 2025 года уточняют длительность клипов Veo: 8 секунд почти во всех режимах, 6 секунд при вставке объекта. Для других сервисов цифры свои, но порядок тот же. Один запуск даёт короткий фрагмент, полнометражки из него не выйдет.
Для статичных объектов — упаковка, архитектура, пейзаж — генерация из снимка часто выглядит убедительно, потому что движение камеры или лёгкий ветер не ломают идентичность предмета. Для текста на упаковке и мелких деталей рук лучше сразу планировать крупный план в монтаже. Надежда на один удачный дубль обычно не оправдывается.
Подготовка исходника — отдельная глава. Обрезка, свет, резкость и соотношение сторон влияют на результат не меньше, чем пара предложений описания. Практические приёмы для статичных изображений собраны в гайде «Работа с картинками». Если исходник сильно сжат или в нём артефакты, видеомодель часто унаследует их и усилит на движении каждого кадра.
Что добавляет текст и как его готовят
Текстовый запрос модель не «читает» как человек. Его кодируют в длинный числовой вектор, который на каждом шаге удаления шума смещает картину к нужным объектам и свету. OpenAI в отчёте 2024 года описывает приём автоматических подписей. Сначала обучают модель, которая пишет подробные описания к роликам из обучающей выборки, затем эти тексты используют для обучения генератора. Для короткого запроса пользователя в продуктах часто делают так же: короткую фразу расширяют в длинное описание автоматически, и уже его видит видеосеть.
Отсюда правило для автора: одно предложение «красивый закат» превращается в чужой длинный текст, и вы не контролируете каждое слово. Надёжнее сразу писать конкретно: «закат над морем, камера статична, силуэты двух людей на переднем плане, без текста в кадре». Так вы уменьшаете пространство для догадок.
Таблица ниже — что проверять в ответе на типичный запрос. Рейтингом моделей она не является.
| Что вы описали | Что смотреть в первом дубле | Частая ошибка |
|---|---|---|
| Движение камеры влево | Горизонт и линии зданий едут согласованно | «Плывущие» вертикали, рябь на фасаде |
| Человек идёт | Колени, ступни, тень на земле | лишние пальцы, смена лица |
| Речь в кадре | Губы, паузы, фоновый шум | несинхрон, «каша» в слогах |
| Текст на вывеске | Буквы стабильны 2–3 секунды | иероглифы вместо слов |
| Петля «конец = начало» | Последний кадр близок к первому | скачок яркости на стыке |
Примеры формулировок для проверки идеи, не для слепого копирования:
- «Средний план, бариста наливает молоко в белую чашку, пар поднимается, камера не движется, тёплый свет, без текста на стаканах». Смотрите на руки и пар.
- «Крупный план часов на запястье, секундная стрелка идёт ровно, фон размыт, без брендов». Смотрите на циферблат и движение стрелки.
- «Полёт над полем подсолнухов, низкое солнце, камера медленно едет вперёд, без людей». Смотрите на перспективу и повторяющийся узор.
Если три разных описания на одну сцену дают три разных провала, проблема чаще в запросе, чем в «сломанной» модели. Сузьте действие до одного глагола.
Один запуск изнутри
Снаружи вы нажимаете «сгенерировать» и ждёте минуты. Внутри сервер отправляет описание и, при необходимости, ссылку на картинку в модель, которая уже доступна в чате. Дальше идёт серия шагов удаления шума в сжатом объёме; их число зависит от семейства модели и настроек провайдера. Затем декодер разворачивает результат в кадры, кодирует файл и отдаёт ссылку. Промежуточные кадры вы не видите, только финальный клип, поэтому отбор делают перезапуском с уточнённым текстом. Править пиксели вручную здесь некуда.
Если сравнить с генерацией одной картинки, разница в объёме данных на выходе. Пятисекундный ролик в 24 кадрах в секунду даёт 120 кадров, и каждый должен быть согласован с соседним. MIT Technology Review в сентябре 2025 года подчёркивает, что именно поэтому видео «тяжелее» для вычислений, чем текст или статичное изображение, даже когда используется сжатое представление. Для автора это вполне практично: длинное описание и сложная сцена увеличивают время ожидания и число неудачных дублей.
Перезапуск с тем же текстом даёт другой результат, потому что стартовый шум случаен. Две генерации «закат над морем» не будут покадрово одинаковыми. Если вам нужен конкретный ракурс, его фиксируют словами или исходной картинкой. На удачный случайный старт полагаться не стоит. В монтаже это плюс: можно выбрать лучший из трёх дублей. В рекламном ролике с жёстким брендбуком это минус, пока не появится утверждённый референс‑кадр.
Как описание превращают в движение
Текст влияет не только на объекты, но и на траекторию камеры. Фраза «камера облетает дом» задаёт другую геометрию, чем «камера стоит на месте, облака плывут». Модель не строит настоящую трёхмерную модель здания, но подбирает последовательность кадров, похожую на те, что видела при обучении. OpenAI в примерах к Sora показывает интерполяцию между двумя разными сценами: генератор достраивает промежуточные состояния, как морфинг, только в сжатом пространстве.
Отсюда совет для коротких рекламных вставок. Опишите одно действие и одно движение камеры. «Банка с газировкой на столе, конденсат стекает, камера медленно наезжает» работает чаще, чем абзац с сюжетом, диалогом и сменой локаций. Диалог лучше оставить на этап, где звук можно заменить, если модель исказит слова.
Звук, длина и физика
В отчёте OpenAI 2024 года о звуке речи нет, ролики там немые. DeepMind для Veo 3.1 заявляет совместную генерацию: эффекты, фон, диалоги в одном проходе с видео. MIT Technology Review объясняет, как это устроено у Veo 3: диффузионная модель выдаёт звук и картинку вместе, синхронно, шаг в шаг. На странице DeepMind в разделе об ограничениях при этом прямо пишут, что естественная речь, особенно в коротких фразах, ещё в работе.
Для сюжета, где важны точные слова, проще считать сгенерированный голос черновиком и заменить его студийной озвучкой в монтаже. Для амбиента — шум улицы, кофемашина, шаги — встроенный звук часто экономит время.
DeepMind для Veo 3.1 отдельно рекламирует правдоподобную физику в маркетинговых блоках и в пользовательских сравнениях на наборе MovieGenBench, который выпустила Meta. Для бытовых задач это всё равно повод для осторожности: стекло может разбиться не так, как в реальности, жидкость в стакане может не качаться правдоподобно. Сцены с ударом, разливом, сложной механикой лучше снимать или собирать из коротких, простых действий.
Разрешение у Veo на сайте DeepMind указано до 1080p и 4K. Это верхний предел выхода, без обещания, что каждый дубль сразу готов к эфиру. На практике сначала проверяют идею в меньшем размере, затем перегенерируют финал — логика та же, что при работе с картинками высокого разрешения.
Видеомодели уже доступны в чате GPThub во вкладке «Видео». Перед съёмкой сценария имеет смысл прогнать там черновик, чтобы увидеть типичные ошибки именно вашей сцены.
Что видно снаружи
Снаружи цепочка выглядит просто. Вы открываете вкладку «Видео», пишете описание или прикрепляете картинку, ждёте, получаете файл. Список моделей и допустимых длительностей задаёт каталог; разные семейства отличаются и по звуку, и по тому, принимают ли они снимок на вход. Публичного единого стандарта на все разработчиков нет, поэтому перед важным проектом сверяйте возможности в день работы. Скриншот из старой статьи тут плохой помощник.
Перед первым серьёзным проектом имеет смысл сделать три коротких теста: только текст, только картинка без текста, картинка плюс одно предложение движения. Так вы увидите, где модель сильнее в вашей предметной области. Общие критерии выбора модели под задачу в гайде «Как выбрать модель». Если нужен разбор, чем генерация отличается от монтажа уже снятого, загляните в материал про нейросети для видео: там конкретные модели и их возможности.
Где ломается согласованность
Три места, на которых стоит остановиться, если вы хотите понять, почему ролик «почти хороший», но его стыдно показать клиенту.
Первое — пространство внутри кадра. Руки, зубы, мелкий текст, узор на ткани требуют, чтобы модель на каждом шаге согласовывала сотни патчей. Ошибка на одном кадре может исчезнуть на следующем, а может размножиться. Поэтому крупный план ладони в генерации проверяют кадр за кадром, хотя на превью всё выглядело ровно.
Второе — переход во времени. Камера поворачивается, и тень должна сместиться согласованно с источником света. Если описание света расплывчато, модель подменяет освещение без объяснений. Помогает зафиксировать одну фразу про свет и не менять её между перезапусками, пока не устроит композиция.
Третье — стык с вашим материалом. Вы вставляете сгенерированный фрагмент в снятый ролик. Даже при верной физике внутри клипа цветовая температура может не совпасть со съёмкой на телефон. Это уже задача монтажа, но её стоит закладывать до генерации: снимите референс света или опишите его теми же словами, что и в запросе к нейросети.
OpenAI в отчёте 2024 года отдельно пишет про длинные ролики: на большой длительности накапливаются мелкие несостыковки, объект может «забыться» или сменить черты. Отсюда практическое правило монтажа: один сгенерированный кусок решает одну задачу в кадре, длинный сюжет режут на несколько генераций с общим описанием стиля.
Отдельная беда — текст в кадре и логотипы. Буквы в генерации плывут от кадра к кадру, и надпись, читаемая в первой секунде, к третьей превращается в узор. Если нужна читаемая надпись, её кладут в монтаже поверх клипа. Просить нейросеть нарисовать буквы в сцене — лотерея.
Наконец, звук. Даже когда видеоряд убедителен, короткая фраза может звучать так, будто её склеили из кусочков. DeepMind на странице Veo 3.1 прямо предупреждает про речь. Для рекламного ролика с обязательным текстом путь обычно такой: видеоряд из генератора, голос из студии, музыка отдельным треком.
Разбор одного запроса и типичные ошибки
Возьмём черновик, который часто пишут с первого раза: «Красивое кафе, люди пьют кофе, официант приносит торт, за окном идёт снег, кинематографично». В нём пять задач сразу. Сеть должна удержать несколько лиц, руки с чашками, движение официанта, падающий снег и стекло между ними. Каждая из этих деталей по отдельности — известная зона ошибок, а вместе они почти гарантируют, что хотя бы одна поплывёт.
Исправленный вариант выглядит скромнее: «Средний план, столик у окна кафе, на столе чашка кофе и кусок торта, за окном медленно падает снег, камера неподвижна, мягкий дневной свет, без людей и без надписей». Главное действие одно — снег. Камера зафиксирована, свет назван, люди и текст исключены. Если сцена удалась, людей добавляют следующим дублем, по одному.
Типичные ошибки повторяются у всех, кто только начинает:
- Несколько действий в одном запросе. Модель делит внимание, и ни одно не выходит чисто.
- Нет слова о камере. Сеть сама решает, двигаться ли, и часто выбирает плавный наезд, который ломает композицию.
- Свет описан оценкой («красиво», «атмосферно») вместо источника и времени суток.
- Картинка на входе противоречит тексту: на снимке ночь, в описании «яркое утро».
- Надежда на буквы в кадре. Надпись лучше положить в монтаже.
- Смена формулировки целиком после неудачного дубля. Меняйте одну деталь за раз, иначе не поймёте, что именно помогло.
Последний пункт важнее остальных. Генерация случайна, и без порядка в правках легко принять удачу за найденное правило.
Безопасность и метки
DeepMind пишет, что ролики Veo помечаются встроенной меткой SynthID, которую ищут их же инструменты. Зритель не всегда видит метку, зато площадки и редакторы всё чаще спрашивают про происхождение кадра. Для учебных и новостных материалов лучше явно подписывать, что фрагмент сгенерирован, даже если качество кажется «как съёмка».
Куда смотреть дальше
Исследовательские группы продолжают спорить, стоит ли вообще строить «симулятор мира» или достаточно хорошего иллюзиониста для коротких клипов. OpenAI в конце отчёта 2024 года называет масштабирование видеомоделей перспективным путём к симуляторам физического и цифрового мира, но в том же тексте перечисляет провалы на стекле и еде. Google 22 октября 2026 года отключил предварительную версию Veo 3.1 в Gemini API и советует разработчикам Gemini Omni Flash — модель, которая генерирует ролик по тексту и картинкам и правит его в диалоге: заменить предмет, сменить ракурс. Имена меняются быстрее, чем успевают обновляться статьи.
Если вы читаете новость «нейросеть научилась…», полезно открыть первичный пост компании и посмотреть, что именно показали: длина клипа, есть ли звук, был ли исходный кадр. Без этих трёх деталей сравнивать с вашей задачей бессмысленно. Для черновика короткой сцены можно сразу открыть чат и вкладку «Видео». Это быстрее, чем ждать, пока пересказ в соцсетях дойдёт до вашей темы.
Тем, кто привык работать с фото‑нейросетями, стоит заранее принять другую привычку проверки. Картинку оценивают один раз, ролик смотрят дважды: без звука, чтобы увидеть движение и рывки, и со звуком, если он был в запросе. На втором просмотре часто всплывает рассинхрон или странная интонация, которую первый просмотр маскирует динамикой. Сохраняйте удачные клипы вместе с текстом запроса: через месяц вы не восстановите формулировку по памяти, а повторить удачный дубль без неё почти невозможно.
Вопросы и ответы
Как нейросеть создаёт видео по описанию?
Описание кодируют в числа и на каждом шаге генерации подсказывают сети, какой шум убирать из сжатого объёма кадров. Сеть стартует со случайного шума и за несколько итераций получает согласованную сцену, затем декодер разворачивает её в пиксели. Готового файла в базе нет. Каждый раз строится новый клип.
Как нейросеть создаёт видео по тексту без картинки?
Тот же процесс удаления шума, но без жёсткой привязки к первому кадру. Композиция, цвет и объекты целиком следуют из текста, поэтому формулировка должна быть конкретной: масштаб, свет, одно главное действие. Короткий запрос система может автоматически расширить в длинное описание, и вы увидите не все слова.
Как ИИ делает видео из фотографии?
Фото задаёт начальное состояние сцены в сжатом представлении; модель достраивает следующие моменты времени так, чтобы движение выглядело непрерывным. Некоторые режимы позволяют задать и последний кадр, тогда сеть заполняет промежуток. Качество падает, если описанное движение не согласуется с исходником.
Как нейросеть генерирует видео со звуком?
В новых линейках, таких как Veo 3.1, звук выводят вместе с картинкой одной моделью: фон, эффекты, речь. Синхрон губ и короткие фразы остаются слабым местом; для точного текста лучше отдельная озвучка.
Что такое «описание видео нейросетью» с точки зрения машины?
Для машины это набор числовых условий, которые на каждом шаге смещают удаление шума к нужной сцене. Предложение, которое вы пишете в интерфейсе, — только вход. Внутри работают числа и связи внимания между патчами кадров.
Сколько длится один запуск?
Зависит от модели и режима. В сравнениях DeepMind октября 2025 года клипы Veo длятся 6–8 секунд. Длинный сюжет собирают из нескольких фрагментов или продлевают сцену отдельными функциями, если они есть в выбранной модели. В интерфейсе чата длительность обычно выбирают из списка, который предлагает конкретная видеомодель.
Связанные модели

Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Сгенерировать короткий клип
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.