
DeepSeek: что это за нейросеть и чем она отличается от обычного чата
Обозреватель: как устроен ИИ
Содержание
27 января 2025 года первое место среди бесплатных приложений американского App Store занимал чат малоизвестной китайской компании DeepSeek, и ChatGPT оказался ниже. В тот же день акции Nvidia упали на 18%. Рынок решил, что сильную модель можно сделать без горы самых дорогих видеокарт, и на мой взгляд, решил слишком поспешно, но об этом ниже. За полтора года страсти улеглись, а компания продолжила выпускать модели. В апреле 2026 года вышло четвёртое поколение, и одна из этих моделей, DeepSeek V4 Flash, открыта в чате GPThub с тарифа «Плюс».
Откуда взялся DeepSeek?
Компанию основал Лян Вэньфэн, в 2015 году он же создал хедж-фонд High-Flyer. Фонд торговал на бирже алгоритмами и, по сообщениям, ещё до американских ограничений на экспорт чипов купил около 10 тысяч видеокарт Nvidia A100. В апреле 2023 года, через несколько месяцев после выхода ChatGPT, при фонде открыли лабораторию общего ИИ, а 17 июля её выделили в отдельную компанию. Денег у венчурных фондов DeepSeek не брала, её до сих пор финансирует High-Flyer.
Модели первого года заметили в основном специалисты. DeepSeek-V2 в мае 2024 года была уже смесью экспертов со сжатым вниманием, в декабре вышла V3, 20 января 2025 года — рассуждающая R1. Именно R1 и попала в новости.
Почему январь 2025 года так напугал рынок?
Совпали три вещи. R1 вышла под лицензией MIT: скачать её и запустить у себя мог кто угодно, без подписки и без разрешения. В техническом отчёте V3 была цифра 2,788 миллиона часов работы видеокарт H800 на полное обучение модели (H800 — урезанная экспортная версия H100, которую тогда разрешали продавать в Китай). И, наконец, приложение: к 27 января чат DeepSeek поднялся на первое место среди бесплатных приложений App Store в США.
Цифру из отчёта быстро пересчитали в доллары и стали сравнивать с бюджетами американских лабораторий, хотя сама компания такого сравнения не делала. В отчёте речь шла только о финальном обучении, без предыдущих экспериментов и без цены самого железа, но эта оговорка до заголовков доходила редко. 27 января 2025 года акции Nvidia упали на 18%.
На мой взгляд, рынок реагировал на пересказ отчёта, а не на сам отчёт. Спрос на вычисления после января не упал, и сама DeepSeek в следующих версиях занималась тем же, чем все: экономила память и вычисления на том железе, которое уже было. Смесь экспертов, разреженное внимание и сжатые форматы весов, которые компания применяла одной из первых, потом появились у других разработчиков. Открытых моделей из Китая после января тоже стало заметно больше, MIT Technology Review в феврале 2026 года посвятил этому большой разбор.
Как R1 научилась рассуждать?
Обычную модель учат в два этапа. Сначала она читает огромный массив текста и учится угадывать следующее слово, потом её дообучают на примерах, которые написали и разметили люди: вопрос, ход решения, ответ. Пошаговых решений, записанных вручную, мало, писать их долго и дорого.
В DeepSeek второй этап для части задач убрали. В математике и в задачах по программированию правильность проверяется автоматически: число сошлось или нет, программа прошла тесты или упала. Модель пробовала решить задачу, а награду получала только за верный итог, и как думать, ей никто не показывал. В описании работы это сформулировано так: способность рассуждать можно стимулировать чистым обучением с подкреплением, без размеченных людьми цепочек рассуждений.
Первую такую модель назвали R1-Zero. Это была V3-Base, которую учили только с подкреплением по алгоритму GRPO, а награды выдавались по простым правилам: верен ли ответ и записано ли рассуждение между нужными тегами. На олимпиадных задачах AIME 2024 доля решённых с первой попытки выросла за время обучения с 15,6 до 71,0%, а при голосовании большинства из 64 попыток — до 86,7%.
В черновиках R1-Zero исследователи нашли то, чего туда не закладывали. Модель перепроверяла промежуточный результат, возвращалась и меняла способ решения, если первый не работал, и со временем сама стала тратить на трудную задачу больше рассуждений. В статье есть пример, где посреди решения модель пишет по-английски «Wait, wait. Wait. That's an aha moment I can flag here» — что-то вроде «стоп, стоп, кажется, тут озарение» — и пересчитывает заново. Авторы так и назвали этот эффект «моментом озарения».
Читать R1-Zero было тяжело. В статье прямо сказано, что у неё плохая читаемость и что она смешивает языки: начинает рассуждать на одном, продолжает на другом, ответ не выделяет. Для исследования это было терпимо, для продукта — нет.
Из-за этого обычную R1 учили уже в четыре этапа. Сначала её дообучили на нескольких тысячах аккуратно оформленных примеров, которые в статье называют «холодным стартом». Затем шло то же обучение с подкреплением, но с дополнительной наградой за то, что рассуждение ведётся на одном языке; авторы пишут, что результат на тестах от этого немного падает, зато текст читается. На третьем этапе модель сама нагенерировала около 600 тысяч рассуждающих и около 200 тысяч обычных примеров, и на этих 800 тысячах базовую модель переобучили за две эпохи. Последний этап — ещё одно обучение с подкреплением, на этот раз на полезность и безвредность. На AIME 2024 итоговая R1 решала с первой попытки 79,8%, у OpenAI o1-1217 в той же таблице 79,2%.
На тех же 800 тысячах примеров DeepSeek доучила шесть чужих открытых моделей поменьше: четыре Qwen2.5 размером от 1,5 до 32 миллиардов параметров и две Llama, на 8 и 70 миллиардов. Обучения с подкреплением у них не было, только примеры из черновиков R1. Возможно, поэтому рассуждающие модели в 2025 году так быстро появились у разработчиков без собственных вычислительных центров.
Что было после R1?
Весной 2025 года у DeepSeek оставалось две линейки, V и R, и 28 мая вышло ещё обновление R1-0528. Пользователю приходилось самому решать, какую модель звать: рассуждающая на простой вопрос думала долго, обычная на многошаговой задаче отвечала наспех. 21 августа 2025 года вышла V3.1, которая умела и то и другое, отвечать сразу или сначала думать, и новых моделей с буквой R компания больше не выпускала.
Дальше компания занималась длинными текстами. 29 сентября 2025 года вышла экспериментальная V3.2-Exp с разреженным вниманием, 1 декабря — обычная V3.2 и отдельная V3.2-Speciale. Каждая из промежуточных версий проверяла один приём, который потом вошёл в V4, поэтому V4 в апреле 2026 года внезапной не выглядела. Удивил разве что размер V4-Pro — 1,6 триллиона параметров.
Разработчики много месяцев обращались к моделям DeepSeek по двум старым именам, deepseek-chat и deepseek-reasoner, и за ними раз за разом оказывались новые версии. С выходом V4 оба имени стали вести на V4-Flash, а после 24 июля 2026 года их отключили.
Как устроена модель?
Параметр — одно число внутри модели, которое подстроили при обучении. Токен — кусок текста, который модель обрабатывает за один шаг. Окно контекста — сколько токенов модель учитывает одновременно: вопрос, вложенный файл и уже написанный ответ.
Схема, по которой построены модели DeepSeek, называется «смесь экспертов» (mixture of experts, MoE). Её часто описывают как совет специалистов, которые голосуют за ответ, но это неточно: никто не голосует, и эксперты не делятся по темам на физиков и лириков. Модель состоит из множества блоков, и на каждый токен небольшая отдельная сеть, маршрутизатор, включает только несколько из них. Остальные в этот момент не считают.
Поэтому у каждой модели DeepSeek два размера. Общий — все блоки вместе, активный — те, что работают на один токен. У V3 общий размер 671 миллиард параметров, активный 37 миллиардов. У Flash — 284 и 13 миллиардов, у Pro — 1,6 триллиона и 49 миллиардов. Хранит модель столько же, сколько большая, а считает на каждое слово как маленькая.
Маршрутизатор нужно научить распределять нагрузку ровно: если он раз за разом выбирает одни и те же блоки, остальные почти не обучаются. Над этим балансом DeepSeek работала с V2, а в V3, по словам самой компании, архитектура осталась по сути той же, изменились масштаб и обучение. В Flash сэкономили ещё и на точности чисел: параметры экспертов хранятся в четырёхбитном формате FP4, остальные в восьмибитном FP8.
С длинными текстами другая трудность. Каждое новое слово модель сверяет со всеми предыдущими, и чем длиннее окно, тем больше уходит памяти и времени. Промежуточные результаты этой сверки хранятся в так называемом KV-кэше, и на длинном документе именно он съедает память видеокарты быстрее всего. В V3.2-Exp внимание сделали разреженным: модель сверяется с отобранными кусками текста, а не со всеми подряд.
Внимание в V4 гибридное, из двух видов сжатого: Compressed Sparse Attention и Heavily Compressed Attention. На миллионе токенов Pro тратит 27% вычислений на один токен и 10% памяти KV-кэша от того, что тратила V3.2. Девять десятых памяти на длинном документе — это много, на мой взгляд, именно из-за этой экономии миллион токенов и стал окном по умолчанию во всех сервисах компании.
Обучали V4 на более чем 32 триллионах токенов, оптимизатор взяли Muon, ради более быстрой и стабильной сходимости. Дообучали в два приёма: сначала отдельные модели-специалисты по разным областям, каждая со своим обучением с подкреплением, потом их свели в одну модель дистилляцией. Тот самый приём, которым год назад доучивали маленькие Qwen и Llama на черновиках R1, только теперь учитель и ученик оба свои, и учителей несколько. Насколько это лучше одной большой модели, обученной сразу на всём, по открытым данным судить трудно, сравнения в лоб компания не публикует.
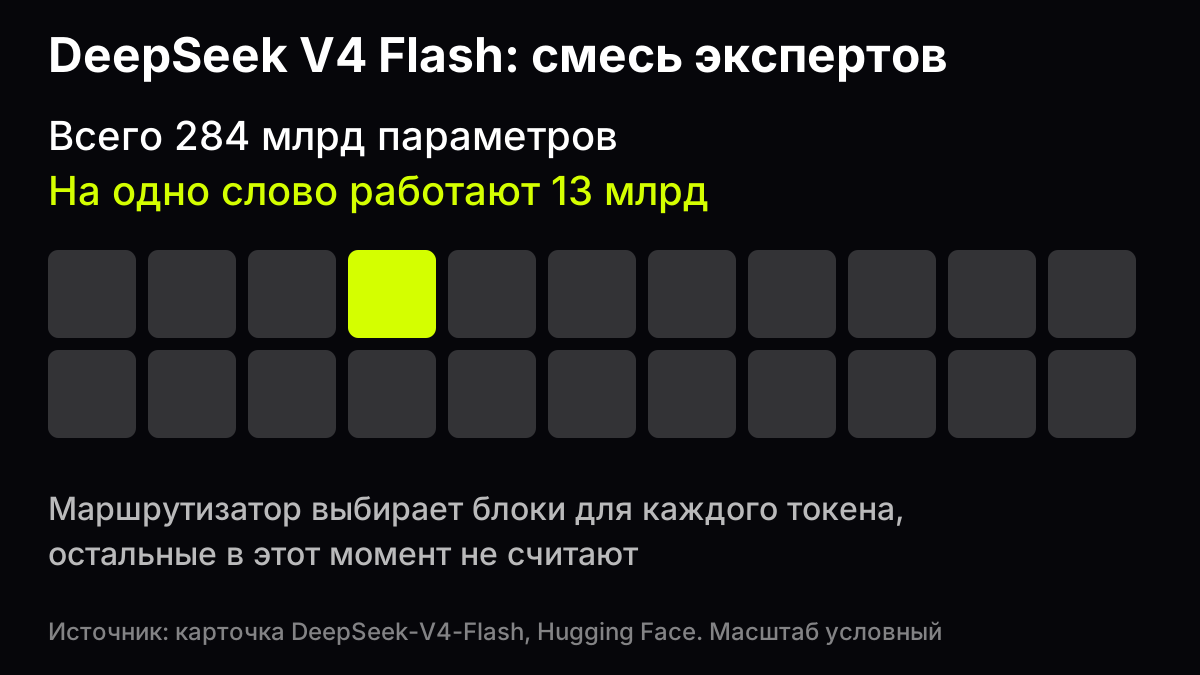
Схема смеси экспертов, иллюстрация GPThub по описанию модели DeepSeek-Flash
Чем DeepSeek отличается от обычного чата?
Под «обычным чатом» чаще всего имеют в виду ChatGPT. ChatGPT — закрытый продукт, модель работает на серверах OpenAI, и веса её не публикуются. Веса DeepSeek лежат на Hugging Face под лицензией MIT, скачать и запустить их у себя может любая компания. Для Flash с 284 миллиардами параметров нужен мощный сервер, хотя и не суперкомпьютер.
Веса — это и есть все параметры модели, записанные в файлы. Открытые веса дают три вещи, которых у закрытой модели нет. Модель можно запустить на своём сервере и не отправлять текст никуда наружу, что для банков и больниц бывает обязательным условием. Её можно дообучить на своих данных, например на внутренней документации компании. И её может предложить любой другой сервис, поэтому одна и та же DeepSeek встречается во многих сторонних сервисах, в том числе в GPThub, и ограничения и скорость ответа у них разные. Обратная сторона тоже есть: если модель запущена у постороннего сервиса, отвечает за неё уже он, и правила хранения запросов определяет тоже он.
Данные, на которых модель учили, DeepSeek не раскрывает, как и почти все разработчики. Как устроена модель, известно в подробностях, а что именно она читала — нет.
У V4 три режима рассуждения: быстрый ответ без раздумий, обычное рассуждение и максимальное. В максимальном модель долго пишет черновик перед ответом, и сам черновик занимает место в окне; для этого режима компания советует оставлять окно не меньше 384 тысяч токенов. По словам DeepSeek, Flash с большим запасом на раздумья приближается по рассуждениям к Pro, и таблица в карточке это отчасти подтверждает. В максимальном режиме на задачах по программированию LiveCodeBench у Flash 91,6, у Pro 93,5, на научных вопросах GPQA Diamond — 88,1 и 90,1. Зато на вопросах на знание фактов SimpleQA-Verified разрыв большой: 34,1 у Flash и 57,9 у Pro. В командной строке (Terminal Bench 2.0) — 56,9 и 67,9. Всё это замеры самого разработчика. Похоже, маленький активный размер Flash меньше мешает рассуждать, чем помнить.
LiveCodeBench собирает задачи с соревнований по программированию, которые вышли уже после обучения модели, чтобы готового решения в её памяти быть не могло. GPQA Diamond состоит из вопросов по физике, химии и биологии, составленных специалистами так, чтобы ответ нельзя было быстро нагуглить. SimpleQA-Verified это короткие вопросы на знание факта с одним проверяемым ответом, вроде даты или имени. Как раз тут у Flash и провал, причём заметный даже на фоне остальной таблицы.
Для повседневной работы из этого следует довольно приземлённая вещь. Пересказать присланный документ, разобрать код или задачу с условием Flash может почти так же, как Pro, потому что всё нужное уже лежит в окне. А вот на вопрос «кто и когда» без документа под рукой быстрая модель ошибается заметно чаще, и проверять её ответ по источнику приходится чаще.
Программный доступ к V4 совместим с форматами запросов OpenAI и Anthropic, а сама модель работает в программах для кода вроде Claude Code и OpenCode. В анонсе компания сравнивает Pro с закрытыми моделями и пишет, что в знаниях о мире та уступает только Gemini 3.1 Pro. Это оценка самой DeepSeek, независимого замера к анонсу не прилагалось.
Есть и политическая сторона. В США закон о бюджете Министерства обороны на 2026 финансовый год требует убрать DeepSeek с устройств военных и разведки, в Австралии 4 февраля 2025 года запретили ставить продукты DeepSeek на государственные компьютеры. На частных пользователей эти запреты не распространяются.
Как менялись версии?
Буква V — основная линейка, R — рассуждающие модели, которые с V3.1 слились с основной.
| Версия | Когда | Что нового |
|---|---|---|
| V2 | май 2024 | смесь экспертов и сжатое внимание |
| V3 | декабрь 2024 | 671 млрд параметров, 37 млрд активных |
| R1 | 20 января 2025 | рассуждение, лицензия MIT |
| V3.1 | 21 августа 2025 | «думать» и «не думать» в одной модели |
| V3.2-Exp | 29 сентября 2025 | разреженное внимание для длинных текстов |
| V3.2 | 1 декабря 2025 | обычная версия и V3.2-Speciale |
| V4 Preview | 24 апреля 2026 | V4-Pro и V4-Flash, окно 1 млн токенов |
| V4.1-Flash | 10 сентября 2026 | обновление быстрой модели |
Смесь экспертов пришла в V2 и с тех пор осталась, рассуждение из R1 переехало в V3.1, разреженное внимание из V3.2-Exp легло в основу длинного окна V4. Если выйдет V5, я бы поставила бы на то, что в её описании найдутся те же три приёма.
Статьи о DeepSeek из-за этого устаревают быстро. Текст годичной давности почти наверняка описывает другую модель, другие режимы и другие названия, и совет выбрать отдельную рассуждающую R1 относится ко временам до V3.1.
Понимает ли DeepSeek русский?
«Дипсик на русском» — один из самых частых запросов про эту модель. Отдельного списка языков в карточке Flash нет. Есть результаты многоязычных тестов: в MMMLU, наборе вопросов по школьным и университетским предметам на разных языках, базовая модель набирает 88,8. Русский в этом наборе есть, но отдельной строки для него в карточке нет.
Модель отвечает на том языке, на котором её спросили. Короткий пересказ и переписка на русском обычно получаются ровными, длинный текст со специальной терминологией стоит перечитать. Так же ведут себя почти все модели, которые учили в основном на английском и китайском. Названия моделей, термины и имена собственные в русском ответе модель обычно оставляет латиницей или переводит по-разному в соседних абзацах, и в длинном тексте эту разнобойность приходится выправлять вручную.
Проверить это проще всего на своём же материале. Возьмите абзац, который хорошо знаете, например из своей курсовой или рабочего отчёта, и попросите модель его пересказать, потом перевести на английский и обратно. Где она путает термины или сглаживает смысл, видно сразу, и такая проверка, в общем, говорит о модели больше, чем любой общий рейтинг.
Прямой связи между страной разработчика и качеством русского нет. Важно, сколько русских текстов было в обучении и как модель проверяли, а долю русского в своих данных не раскрывают ни DeepSeek, ни большинство других компаний.
Где открыть DeepSeek в GPThub?
В чате GPThub DeepSeek V4 Flash открыт с тарифа «Плюс». Модель текстовая, картинки она не читает, документ на миллион токенов помещается в окно целиком. Pro в нашем наборе нет.
Гостю и на бесплатном тарифе отвечает Gemini 3.8 Flash, она читает и снимки. Flash в чате хорош на длинном договоре, расшифровке лекции, куске кода — в общем, на всём, что можно положить прямо в запрос. С вопросами по памяти хуже: на тесте фактов Flash набирает 34,1 против 57,9 у Pro, так что имя или дату, которые она назвала без документа, я бы перепроверила. Как выбирать между моделями под задачу, разобрано в гайде как выбрать модель.
Что будет с DeepSeek дальше?
Между V3 в декабре 2024 года и предварительной V4 в апреле 2026 года прошло меньше полутора лет, и за это время вышли R1, V3.1, V3.2 и несколько промежуточных обновлений. После официального выпуска Flash в июле и Pro в августе 2026 года уже в сентябре появилась V4.1-Flash. При таком темпе крупная версия выходит примерно раз в год, а быстрая модель обновляется раз в несколько месяцев.
Почти каждое поколение DeepSeek было про эффективность: меньше активных параметров на слово, дешевле длинное окно, меньше памяти на веса. Даже в анонсе V4 рядом со сравнением с закрытыми моделями описано, как компания сократила вычисления на длинном окне.
США и Австралия уже убрали DeepSeek с государственных устройств, и, вероятно, к ним присоединятся другие ведомства, которые работают с чувствительными данными. Приложение самой компании отправляет запросы на её серверы, а модель, открытая в чужом сервисе, работает по правилам этого сервиса. Скачанные открытые веса связи с DeepSeek не требуют вообще.
Новости о моделях компания публикует на api-docs.deepseek.com, и большинство заголовков вроде «DeepSeek снова обвалил рынок» проще всего сверить там: новая модель, обновление старой или чужой пересказ.
Вопросы и ответы
DeepSeek — это что?
Китайская компания из Ханчжоу, основанная 17 июля 2023 года, и её семейство языковых моделей. Текущее поколение — V4: V4-Pro и V4-Flash. Веса моделей открыты под лицензией MIT.
Чем DeepSeek V4 Flash отличается от V4 Pro?
Размером. У Flash 284 миллиарда параметров, на одно слово работают 13 миллиардов. У Pro — 1,6 триллиона и 49 миллиардов. Окно у обеих — миллион токенов. Flash быстрее, Pro сильнее в сложных задачах.
DeepSeek бесплатный?
В GPThub DeepSeek V4 Flash открыт с тарифа «Плюс». Бесплатно и без регистрации в чате доступна Gemini 3.8 Flash.
Можно ли скачать DeepSeek себе?
Веса выложены на Hugging Face под лицензией MIT. Но даже быстрой V4-Flash нужен серьёзный сервер: 284 миллиарда параметров не помещаются в обычный компьютер.
Почему DeepSeek обвалил акции Nvidia?
27 января 2025 года приложение DeepSeek возглавило бесплатный топ App Store в США, а акции Nvidia упали на 18%. Рынок испугался, что сильные модели можно обучать на меньшем числе дорогих видеокарт: DeepSeek сообщила, что финальное обучение V3 заняло 2,788 миллиона часов работы H800.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, бесплатный тариф, «Плюс» или «Про». Короткая схема выбора и примеры под код, письма и разбор.
- Нейросеть для учёбы
Как готовиться с GPThub: конспект, объяснение темы, проверка себя. Честные правила — не сдавать чужой текст за свой. Модели для старта и скринов.
Ещё по теме
Источники
- DeepSeek, 24 апреля 2026: анонс V4 Preview
- Карточка DeepSeek-V4-Flash на Hugging Face
- Технический отчёт DeepSeek-V3, декабрь 2024
- Карточка DeepSeek-V3.1 на Hugging Face
- Wikipedia: DeepSeek, история компании и версий
- The New York Times, 27 января 2025
- Исследовательская служба Конгресса США: ограничения DeepSeek
- MIT Technology Review, 12 февраля 2026: открытые модели из Китая
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.