Grok 4.7 и вся линейка от 4.3: что изменилось и какую версию выбрать
Обновлено
Обозреватель: модели и релизы
Содержание
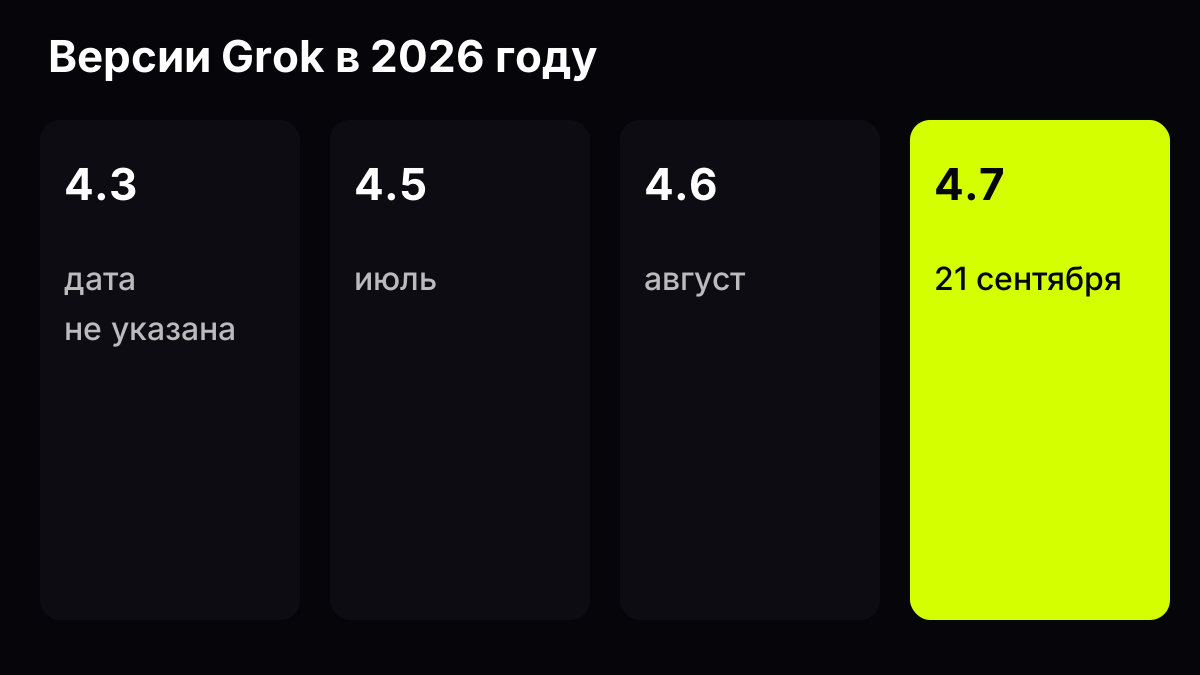
21 сентября 2026 года xAI выпустила Grok 4.7. За год это уже четвёртая заметная версия: до неё были 4.3, летняя 4.5 и августовская 4.6. Номера идут плотно, и разобраться, чем одна отличается от другой, без таблицы сложно. Собрали всё в одном месте: что изменилось в 4.7, как она выглядит в тестах самой xAI и в независимых замерах, и какую версию брать под задачу. Grok 4.7 уже доступна в чате GPThub, рядом с ней Grok 4.3 и Grok 4.5.
Что вышло и когда
Начнём с хронологии, потому что тут проще всего запутаться. Точных дат у xAI для старших версий нет, в заметках к выпускам указан только месяц.
- Grok 4.3. Точной даты выхода нет ни на странице модели, ни в заметках к выпускам. xAI описывает её как быструю надёжную модель, которая хорошо вызывает инструменты и следует инструкциям.
- Grok 4.5. Июль 2026 года. Модель для кода и рабочих задач, которую xAI обучала в своих дата-центрах в Мемфисе.
- Grok 4.6. Август 2026 года. Первая из линейки, которую компания назвала «передовой» для кода, агентов и работы с документами.
- Grok 4.7. 21 сентября 2026 года. Продолжение 4.6, в карточке модели xAI пишет, что это её самая способная модель на сегодня.
С названием компании тоже неразбериха. В карточке модели сказано, что SpaceXAI — торговое имя юрлица XAI LLC, и xAI и SpaceXAI можно использовать как синонимы. На сайте и в документации встречается ещё вариант SpaceXSI, а SiliconANGLE пишет, что модель представила SpaceX. Мы дальше пишем просто xAI. Для читателя разницы нет, модели те же, документация та же, меняется только вывеска. Тем более что в самой карточке оба имени разрешено использовать как синонимы.
Источник: заметки к выпускам и анонс Grok 4.7, xAI, иллюстрация GPThub
Чем версии отличаются на бумаге
Данные из документации xAI для разработчиков. Там, где у компании цифры нет, мы её не подставляем.
| Модель | Вышла | Окно | Уровни рассуждения | Вход и ответ |
|---|---|---|---|---|
| Grok 4.3 | дата не указана | 1 000 000 токенов | от none до xhigh, по умолчанию low | текст и картинки → текст |
| Grok 4.5 | июль 2026 | 500 000 токенов | от low до xhigh, по умолчанию high | текст и картинки → текст |
| Grok 4.6 | август 2026 | 500 000 токенов | от low до xhigh, по умолчанию high | текст и картинки → текст |
| Grok 4.7 | 21 сентября 2026 | 500 000 токенов | от low до xhigh, по умолчанию high | текст и картинки → текст |
Здесь видно главное отличие 4.3 от остальных. Окно у неё вдвое больше, и есть режим none, когда модель отвечает сразу, без рассуждения. По умолчанию она думает на низком уровне. Старшие версии по умолчанию рассуждают на высоком, отключить это нельзя.
С 4.5 есть мелкая нестыковка. В заметках к выпуску у неё три уровня рассуждения, low, medium и high, а на странице модели уже четыре, с xhigh. Скорее всего, верхний уровень добавили позже, но сама xAI это не поясняет.
Ограничения на длину ответа у 4.6 и 4.7 нет, так написано в документации. Для 4.3 и 4.5 цифру компания не публикует. На практике это значит, что длинный отчёт или большой кусок кода 4.7 может выдать за один раз, не обрывая на середине. Но длинный ответ — это и длинное ожидание, и заметный расход пакета, так что просить «напиши всё целиком» стоит только тогда, когда это действительно нужно. Чаще удобнее попросить план, а потом раскрыть по частям.
Дата среза знаний у 4.7 тоже указана в двух вариантах. В руководстве по модели — май 2026 года. В карточке — июнь 2026 года для основного обучения и данные до августа для дополнительного. Мы бы ориентировались на карточку: она подробнее.
Что нового в Grok 4.7
По анонсу xAI изменений пять.
- Новая базовая модель. Компания пишет, что 4.7 построена на новой, более крупной базе, чем 4.6.
- Долгое дообучение. Обучение с подкреплением шло дольше и на более сложном наборе задач, с упором на работу, которая занимает часы.
- Самопроверка и длинный контекст. По словам xAI, модель лучше проверяет собственную работу и аккуратнее держит длинный контекст.
- Работа в связке агентов. 4.7 обучали понимать Grok Bot, обвязку xAI, в которой большую задачу делят между несколькими агентами.
- Документы и презентации. Компания отдельно пишет, что модель стала лучше их собирать.
В карточке есть ещё одна деталь. Модель дополнительно обучали на обезличенных данных о работе в редакторе кода Cursor, который, по данным SiliconANGLE, теперь принадлежит SpaceX. Отсюда, видимо, и упор на код в анонсе: данные о том, как люди правят код в редакторе, для такой модели ценнее любых учебных задач.
Цену xAI не меняла. В анонсе прямо сказано, что 4.7 стоит столько же, сколько 4.6, и работает с той же скоростью. Есть ещё быстрый вариант, вдвое быстрее и вдвое дороже, но только в Cursor и Grok Build, через открытый API его не получить.
Что показывают тесты xAI
Таблицу xAI опубликовала в анонсе. Grok 4.7 там на уровне xhigh, Grok 4.6 на high, соперники на максимальном уровне. Ценовые строки мы убрали.
| Тест | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0, код в редакторе | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1, код | 71,0% | 65,2% | 72,7% | 70,0% |
| EEBench | 64,0% | 53,0% | 39,4% | 56,4% |
| Terminal-Bench 4.0, командная строка | 37,6% | 20,3% | 37,3% | 57,9% |
| Harvey Legal Agent, юридические задачи | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional, медицина | 56,7% | 48,5% | 60,5% | 62,1% |
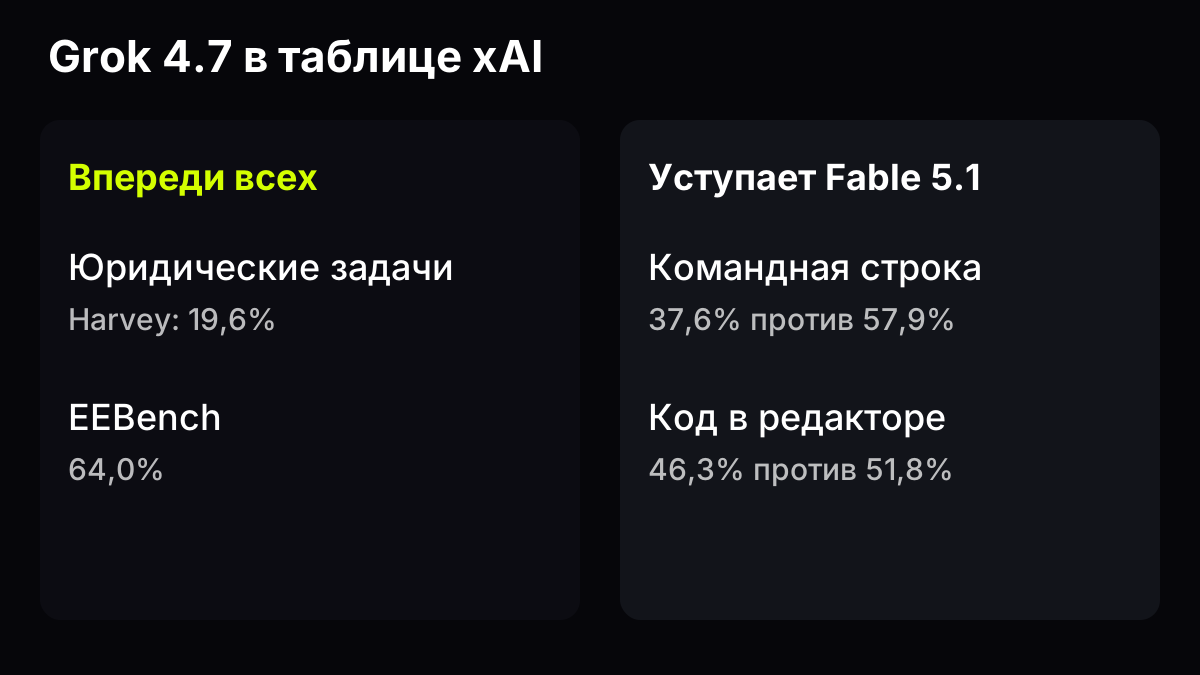
От 4.6 новая версия ушла заметно. На командной строке прирост почти вдвое: 37,6% против 20,3%. На юридических задачах Harvey 4.7 впереди всех в таблице, в том числе Claude Fable 5.1. На EEBench тоже первая.
Но и проигрышей хватает. На командной строке Fable 5.1 сильнее больше чем на 20 пунктов. В редакторе кода CursorBench Fable снова впереди, 51,8% против 46,3%. В медицинском тесте 4.7 последняя из четырёх. На DeepSWE её обходит GPT-5.6 Sol, а это уже прошлое поколение OpenAI.
Есть ещё сводный рейтинг GDPval, где модели сравнивают попарно на рабочих задачах. По данным xAI: Claude Fable 5.1 — 1735, Grok 4.7 — 1695, Grok 4.6 — 1605, GPT-6 Astra — 1542. Тут 4.7 вторая и заметно выше флагмана OpenAI.
Обратите внимание, что в основной таблице нет GPT-6 Astra и Claude Opus 5.5, только прошлые соперники. SiliconANGLE пишет, что на EEBench 4.7 уступила Astra, но в таблице xAI колонки Astra нет, и проверить это мы не смогли.
Источник: анонс Grok 4.7, xAI, 21 сентября 2026, иллюстрация GPThub
Как читать эти цифры
С таблицей xAI есть несколько тонкостей, без которых легко сделать неверный вывод.
Первая — уровни рассуждения. Grok 4.7 в таблице стоит на xhigh, а Grok 4.6 на high, то есть на ступень ниже. Часть прироста может объясняться именно этим: модель, которой дали думать дольше, обычно отвечает лучше. Отдельной строки «4.6 на xhigh» xAI не приводит, поэтому честного сравнения на одинаковом уровне в анонсе нет.
Вторая — соперники. В колонках GPT-5.6 Sol и Claude Fable 5.1, а это модели, вышедшие раньше. К 21 сентября у OpenAI уже была GPT-6 Astra, а на следующий день вышел Claude Opus 5.5. Получается, 4.7 сравнивают с тем, что было на рынке летом.
Третья — сами тесты. EEBench и Harvey Legal Agent менее известны, чем тесты на код, и по ним мало сторонних результатов. Высокий балл 4.7 там интересен, но перепроверить его пока не на чем.
Это не значит, что таблица неверна. Просто это таблица компании, которая выпускает модель, и читать её стоит как первое приближение, а не как окончательный рейтинг. Независимый замер, о котором ниже, даёт картину сдержаннее.
Что показал независимый замер
Artificial Analysis прогнала 4.7 в день выхода, на уровне xhigh. В сводном индексе у модели 46 баллов. По оценке компании, это выводит xAI в четвёрку сильнейших лабораторий, а связка Grok 4.7 и Grok Build в программировании четвёртая после Claude Fable 5.1, GPT-6 Astra и Claude Opus 5.
Скорость — около 188 токенов в секунду на длинных запросах, примерно 7 минут на одну задачу индекса.
А вот с расходом токенов история интереснее. В карточке модели xAI пишет, что 4.7 приходит к результату за меньшее число шагов и с меньшим числом токенов ответа, чем другие передовые модели. Замер Artificial Analysis показывает другое: около 81 тысячи токенов ответа на задачу. У 4.6 на уровне high было 36 тысяч, на xhigh — 38 тысяч. То есть новая версия тратит больше чем вдвое.
Как одно сочетается с другим, xAI не объясняет. Возможно, компания сравнивала с чужими моделями, а не с собственной 4.6. Но для практики вывод простой: одинаковая цена за токен у 4.6 и 4.7 ещё не значит одинаковую цену за задачу. Длинная задача на 4.7 может обойтись заметно дороже, просто потому что модель дольше думает.
Для чата это значит одно: пакет токенов на 4.7 расходуется быстрее, особенно на сложных вопросах. Короткий вопрос разницы почти не даст, длинная задача с рассуждением даст.
Отсюда простое правило. Простую задачу не отдавайте самой сильной модели только потому, что она самая новая. Письмо, пересказ, перевод абзаца Grok 4.3 или 4.5 сделают не хуже, а пакет потратят меньше. Свежую версию стоит держать для задач, где лишние минуты рассуждения окупаются: запутанный код, длинный договор, отчёт из нескольких источников.
Есть и обратная сторона длинного рассуждения. Ответ на сложный вопрос приходит дольше, иногда это минуты. Если вы привыкли к почти мгновенным ответам 4.3, первое время это может раздражать. Ничего не сломалось, модель просто думает.
Безопасность
Стек защит у 4.7, по словам xAI, полностью новый. В карточке модели много цифр, вот самые понятные.
- Опасные запросы про взлом. На HackerBench доля ответов на вредные запросы — 3,31% на уровне high и 4,02% на xhigh. У 4.6 было 5,93%, у 4.5 — 7,8%. В анонсе фигурирует цифра 3,3%, это как раз уровень high.
- Обход ограничений. Стандартный набор попыток сработал в 0,01% случаев, у 4.6 было 0,04%.
- Нечестность. На тесте MASK, где модель пытаются заставить солгать, у 4.7 — 0,00%, у 4.6 было 1,90%.
- Биология. xAI пишет, что результаты ниже её порогов опасности и прироста опасных возможностей по сравнению с 4.6 нет. На отказах в опасных биологических запросах (BioSecBench Refusal) у 4.7 62,4%, у GPT-6 Astra 25,5%.
Есть и строчка не в пользу новой версии. Доля ответов на запросы о самоповреждении выросла: 1,05% против 0,84% у 4.6. xAI сама пишет, что этот показатель стал выше.
Ещё несколько строк из той же карточки. На длинных многоходовых попытках обойти ограничения доля успешных у 4.7 — 0,65%, у 4.6 было 1,0%. Угодничество, когда модель соглашается с пользователем вопреки фактам, держится на уровне сотых долей процента у всех трёх версий. На отказах в опасных биологических запросах второго набора (BioUseBench) 4.7 набрала 91,4% против 90,7% у 4.6 и 83,3% у 4.5. Красные команды из партнёров по кибербезопасности получают доступ к более широким возможностям модели только по приглашению.
И важная оговорка из карточки. Модель не предназначена для самостоятельных решений с высокой ценой ошибки в медицине, праве и финансах без контроля человека. Учитывая её первое место в юридическом тесте Harvey, это стоит помнить.
Где модель доступна у xAI
У самой xAI 4.7 раздают так:
- через API в консоли xAI;
- в Grok Build, где 4.7 стала моделью по умолчанию;
- в редакторе Cursor на всех тарифах;
- в надстройках Grok для Word, PowerPoint и Excel;
- через сторонние сервисы-посредники, которые раздают модели разработчикам.
В приложении Grok и в Grok внутри X модели пока нет. В карточке сказано, что её добавят туда позже, но срока xAI не называет.
Получается любопытная картина. Самую сильную модель компания первым делом отдала разработчикам и офисным программам, а не своему же приложению для всех. Логика понятна: 4.7 делали под код и документы, и именно там её проще всего показать. Обычному пользователю Grok придётся подождать, а пока проще открыть модель там, где она уже есть.
Grok Build и Grok Bot: о чём речь
В анонсе два названия встречаются постоянно, и без пояснения непонятно, что это.
Grok Build — программа для программистов, которая работает в терминале. В неё пишут задачу словами, а она сама читает файлы проекта, правит код и запускает проверки. С выходом 4.7 именно она стала моделью по умолчанию в Grok Build.
Grok Bot — обвязка, в которой одну большую задачу делят между несколькими агентами. Один разбирает условие, другой пишет код, третий проверяет. По словам xAI, 4.7 специально учили понимать эту обвязку, поэтому длинные задачи она ведёт увереннее.
Для чата обе вещи почти не видны. Там модель отвечает на одно сообщение, без терминала и без команды агентов. Но то, чему её научили для Grok Build, никуда не девается: проверять свою работу и держать длинное условие модель умеет и в обычном диалоге.
Какую версию Grok брать
Теперь к практике. В чате доступны три версии, и у каждой своя задача.
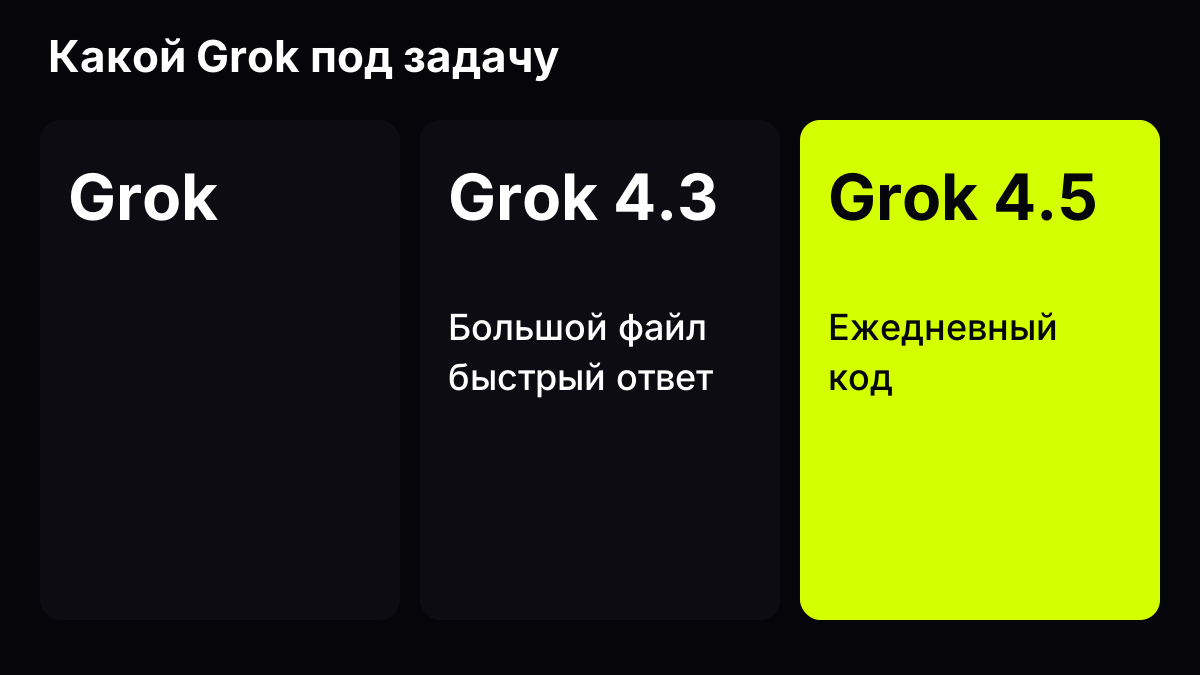
Grok 4.3 — когда нужен большой файл или быстрый ответ. Окно в миллион токенов, вдвое больше, чем у старших версий. Плюс режим без рассуждения: короткий вопрос, пересказ, перевод она отдаёт сразу. Если задача простая, но текста много, это лучший выбор из трёх.
Grok 4.5 — код и рабочие задачи без лишнего расхода. xAI делала её как модель для программирования. Окно 500 тысяч токенов, по умолчанию рассуждает на высоком уровне. Для ежедневного кода и разбора документов её хватает.
Разница между 4.5 и 4.6 в чате не так важна, как может показаться по номерам. Обе с окном в 500 тысяч токенов и одинаковыми уровнями рассуждения, 4.6 по тестам xAI чуть сильнее. Для большинства задач в чате хватает 4.5.
Grok 4.7 — сложные задачи, где важна самопроверка. Код на несколько файлов, длинные документы, юридические и рабочие задачи, где важно не потерять условие. По тестам xAI она заметно сильнее 4.6 на командной строке и в юридических задачах. Но помните про расход: на длинной задаче токенов уйдёт больше.
Есть ещё несколько типовых случаев.
Учёба. Пересказ лекции, вопросы к семинару, разбор задачи — Grok 4.3 или 4.5. Длинный конспект за семестр лучше отдавать 4.3 из-за окна в миллион токенов.
Работа с документами. Сравнить две версии договора, найти условие в длинном регламенте, собрать выжимку из отчёта — Grok 4.7. Здесь как раз пригодится самопроверка, о которой пишет xAI. Но решение по договору всё равно принимает человек, об этом прямо сказано в карточке модели.
Тексты и письма. Обычное письмо или пост 4.7 не нужна. Подойдёт любая из трёх, и быстрее всего ответит 4.3 в режиме без рассуждения. Где ровный черновик стирает авторский голос, отдельно разобрано в материале нейросеть для писателя.
Если Grok вам не принципиален, для кода есть ещё Claude Sonnet 5: по таблице xAI модели Anthropic на командной строке пока сильнее. Как выбрать модель под задачу, разобрано в гайде какая модель для кода.
Источник: документация xAI и анонс Grok 4.7, иллюстрация GPThub
Что пока неизвестно
Часть вопросов xAI оставила открытыми, и честнее их перечислить.
- Точные даты старших версий. Для 4.3 даты нет вообще, для 4.5 и 4.6 известен только месяц.
- Срез знаний 4.7. Руководство и карточка расходятся на месяц, май или июнь 2026 года.
- Сравнение с GPT-6 Astra и Claude Opus 5.5. В основной таблице xAI их нет, есть только в рейтинге GDPval.
- Расход токенов. Заявление про экономность и замер Artificial Analysis противоречат друг другу, и xAI это пока не прокомментировала.
- Приложение Grok. Когда 4.7 появится там, компания не говорит.
Если xAI что-то уточнит, мы допишем статью.
Как проверить на своей задаче
Таблицы показывают средний результат на чужих задачах. Чтобы понять, нужна ли вам 4.7, лучше потратить десять минут.
- Возьмите задачу, которую решаете каждую неделю: код с ошибкой, договор, отчёт. Придуманный пример не годится, на нём все версии выглядят хорошо.
- Отправьте один и тот же запрос Grok 4.5 и Grok 4.7 в соседних вкладках. Формулировку между ними не меняйте.
- Смотрите, решена ли задача, сколько пришлось исправлять и не появилось ли в ответе того, чего не было в исходнике.
- Обратите внимание на время ответа. 4.7 думает дольше, и если разница в качестве не видна, 4.5 выйдет экономнее.
Если результат одинаковый, оставайтесь на 4.5. Если 4.7 заметно лучше, значит, ваша задача из тех, ради которых её и делали. Подробнее о таком сравнении — в гайде сравнение моделей на практике.
Что поменялось для обычного пользователя
Если отложить таблицы и замеры, у выхода 4.7 для человека в чате три следствия.
Первое — длинные задачи стали надёжнее. Модель, которая проверяет собственную работу, реже теряет условие из начала запроса и реже выдаёт уверенный, но неверный ответ. Это видно не на коротком вопросе, а на задаче в несколько шагов: расчёт, разбор договора, план проекта.
Второе — ответ приходит дольше. Модель по умолчанию рассуждает на высоком уровне и тратит на это больше токенов, чем 4.6. На сложном вопросе это может быть минута и больше. Для быстрых вопросов удобнее 4.3.
Третье — выбор стал шире. Раньше в линейке Grok было понятно: младшая для простого, старшая для сложного. Теперь между ними три ступени, и разумно держать в голове простую схему: 4.3 для большого файла и быстрых ответов, 4.5 для повседневного кода, 4.7 для задач, где цена ошибки высокая.
Вопросы и ответы
Чем Grok 4.7 отличается от Grok 4.6?
По словам xAI, у 4.7 новая, более крупная базовая модель, более долгое дообучение на сложных задачах и новая система защит. Цена и скорость те же. На командной строке результат вырос с 20,3% до 37,6%.
Какое окно у Grok 4.7?
500 тысяч токенов, ограничения на длину ответа нет. У Grok 4.3 окно в миллион токенов.
Grok 4.7 экономнее Grok 4.6?
За токен цена та же. Но по замеру Artificial Analysis 4.7 тратит на задачу около 81 тысячи токенов ответа против 36–38 тысяч у 4.6, так что длинная задача выходит дороже.
Можно ли открыть Grok 4.7 в чате GPThub?
Да, Grok 4.7 уже доступна в чате. Рядом Grok 4.3 и Grok 4.5.
Какую версию Grok выбрать для кода?
Для ежедневного кода хватает Grok 4.5. Для сложного кода на несколько файлов и задач в несколько шагов — Grok 4.7. Для большого файла без сложных рассуждений — Grok 4.3 с окном в миллион токенов.
Связанные модели


Связанные гайды
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Похожие статьи
- GPT-6 Astra и GPT-6.1 Sol
GPT-6 Astra вышла 3 сентября 2026, GPT-6.1 Sol 29 сентября. Чем отличаются модели семейства, где Astra впереди по тестам и что выбрать в чате GPThub.
- Claude Opus 5.5
Claude Opus 5.5 вышла 22 сентября 2026: окно в миллион токенов, уровень Fable 5.1 на большинстве задач. Что показывают тесты и когда её брать.
- DeepSeek или ChatGPT
DeepSeek или ChatGPT в ноябре 2026: открытые веса против закрытого приложения. Разница по задаче, не по лозунгу «кто умнее».
- ChatGPT или Claude
ChatGPT или Claude в ноябре 2026: какую модель взять под текст, код и длинный документ.
- Российские нейросети
"Российские нейросети ноября 2026: Алиса, YandexGPT, GigaChat и Kandinsky. Чем отличаются текст, картинки и короткое видео."
- Китайские нейросети
Какие китайские нейросети открыть в ноябре 2026: DeepSeek, Qwen, Kimi и GLM. Карта лабораторий и выбор под задачу.
Источники
- xAI: Grok 4.7, 21 сентября 2026
- xAI: руководство по Grok 4.7
- xAI: документация модели Grok 4.7
- xAI: документация модели Grok 4.6
- xAI: документация модели Grok 4.5
- xAI: документация модели Grok 4.3
- xAI: заметки к выпускам
- xAI: карточка модели Grok 4.7, 21 сентября 2026
- Artificial Analysis: замер Grok 4.7, 21 сентября 2026
- SiliconANGLE, 21 сентября 2026: выход Grok 4.7
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Открыть Grok 4.7 в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.