Лучшие нейросети 2026: какая для какой задачи
Обозреватель: модели и релизы
Содержание
Запрос «лучшие нейросети» обещает один список победителей. На 6 ноября 2026 года такого списка нет: у текста, кода, документов, картинок, роликов и поиска фактов свои открытые таблицы, и первые места в них занимают разные модели. Мы собрали рейтинг по шести задачам, и у каждой позиции есть таблица или карточка разработчика с датой. Кто какие линейки выпускает, уже разложено в карте нейросетей 2026. Здесь только один вопрос: что взять под конкретную работу.
Почему лучшие нейросети 2026 года считают по задачам
Человек из поиска хочет короткий ответ: взять X и не ошибиться. Открытые рейтинги устроены иначе, и у каждого свой вопрос.
Первый тип — арены. Arena (до января 2026 года называлась LMArena) показывает человеку два анонимных ответа на один запрос и просит выбрать лучший. Из голосов складывается балл Эло. На 27 октября 2026 года в текстовой таблице было 9 003 272 голоса по 418 моделям. Арена отвечает на вопрос «чей ответ людям нравится больше». Правильность ответа она не проверяет.
Второй тип — наборы задач с проверкой. Artificial Analysis прогоняет модели по фиксированным заданиям, где решение либо засчитано, либо нет. Индекс версии 5 от 27 октября 2026 года собран из девяти проверок в четырёх равных частях: работа со знаниями, код, наука и общие вопросы. Это ответ на вопрос «кто справился с заданием».
Третий тип — карточки разработчиков. В них компания сравнивает модель с соседями и сама выбирает условия прогона. Цифры полезны, но читать их нужно как заявление компании.
Поэтому первые места расходятся. Gemini 4 Carbon стоит первой в текстовой Arena, а в заметке Artificial Analysis от 28 октября сказано прямо: в коде и в работе со знаниями она не лидирует. Подробно о том, как устроены такие таблицы и почему одно первое место ничего не значит, мы писали в разборе бенчмарков. Здесь берём только выводы.
Ещё одна ловушка — путать «лучший искусственный интеллект» с «лучшим чатом». Чат — это окно, в котором меняют модель. Рейтинг ниже про модели.
Как мы собирали рейтинг
Правила простые и жёсткие.
- Только открытые таблицы и карточки с датой: Arena (текст, поиск, картинки, видео), индекс Artificial Analysis v5 и его видеотаблица, карточки OpenAI, Anthropic, Google DeepMind и пост xAI о Grok 4.7.
- Место переносим вместе с именем таблицы и датой. Проценты из разных таблиц не складываем и не сравниваем между собой.
- Пометку «предварительно» сохраняем: у такой строки мало голосов, и она ещё сдвинется.
- Модель без публичной цифры в рейтинг не попадает, даже если о ней много пишут.
- Своих прогонов нет. Проверка на вашей задаче остаётся за вами, порядок есть в гайде про сравнение моделей на практике.
Узкие задачи вроде распознавания речи и музыки за рамками: запросы про лучшие нейросети почти всегда о тексте, коде и визуале. Ссылки и цифры мы сверили 6 ноября 2026 года. Таблицы обновляются каждую неделю, так что через месяц часть строк сдвинется.
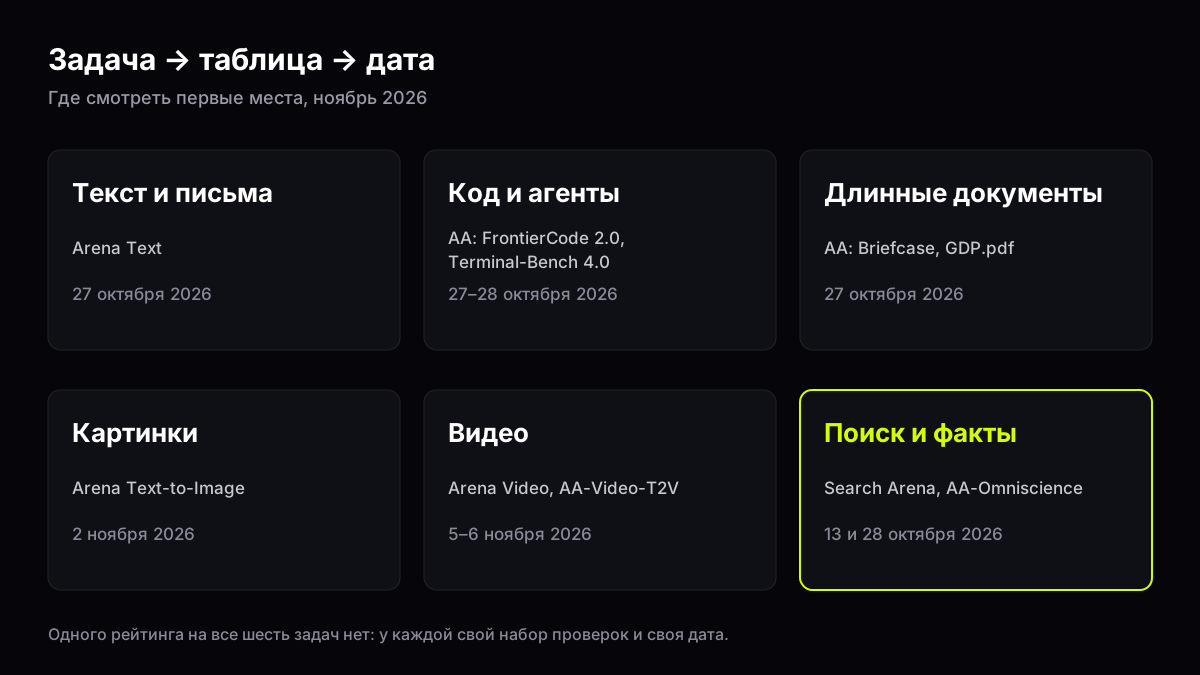
Схема редакции по открытым таблицам на 6 ноября 2026
Текст, письма и черновики
Для писем, постов и правки формулировок важны связность и тон. Здесь лучше всего подходит арена: люди голосуют за ответ, который им удобнее читать.
Текстовая Arena на 27 октября 2026 года:
- Gemini 4 Carbon (High), Google — 1528 ± 9, предварительно, 4403 голоса.
- Gemini 4 Argon (High), Google — 1520 ± 6.
- Claude Opus 5.5 (High), Anthropic — 1509 ± 7.
- Muse Wonder (Max), Meta — 1507 ± 7.
Разница между вторым и четвёртым местом 13 пунктов при погрешности 6–7 пунктов у каждого. Это почти ничья. Берите любую из четырёх, если текст важный и пойдёт заказчику.
Быстрые модели в той же таблице заметно ниже, кроме одной. Gemini 3.8 Flash (High) стоит десятой с 1496 ± 4. Для потока однотипных писем это самый сильный вариант среди быстрых.
GPT-6 Luna OpenAI в документации называет своей самой экономной моделью для узких задач большого объёма. В Arena она 97-я с 1441, зато по ней 86 478 голосов, и цифра устойчивая. Claude Haiku 5.5 вышла 7 октября 2026 года, Anthropic отдаёт её под классификацию, извлечение данных и маршрутизацию запросов, в своей таблице помечает как самую быструю. В Arena у неё 1425, 125-е место.
DeepSeek V4 Flash вышла 24 апреля 2026 года: 284 миллиарда параметров, 13 миллиардов активных на токен, окно в миллион токенов, веса открыты. В Arena базовая V4-Flash стоит на 104-м месте с 1436. Подробнее о семействе есть в статье про DeepSeek.
Позиция простая. Письмо коллеге и правка абзаца — быстрая модель. Текст, который читают люди со стороны, — модель из верхней четвёрки.
Пример запроса: «Сократи письмо до пяти предложений, сохрани вежливый тон, убери повторы. Даты и суммы не трогай».
Что проверить в ответе: не пропали ли даты и суммы, не появились ли обещания, которых не было в исходнике.
Типичная ошибка: просить «сделай лучше» без критерия. Модель перепишет всё подряд, и вы потеряете время на сверку.
Что значат «±» и «предварительно»
Балл арены — оценка с погрешностью. Запись 1520 ± 6 значит, что настоящее значение лежит где-то между 1514 и 1526. Если интервалы двух моделей пересекаются, разница между ними не доказана.
Пометка «предварительно» стоит у строк с малым числом голосов. У Gemini 4 Carbon их 4403, у Gemini 3.8 Flash 47 803, у GPT-6 Luna 86 478. Первое место Carbon пока держится на самой короткой выборке из тройки, и через неделю оно может уйти.
Отсюда правило чтения. Модели, которые стоят в пределах 10–15 пунктов друг от друга, считайте равными. Выбирайте между ними по скорости, окну и удобству, а не по месту в строке.
Код, репозитории и агенты
С кодом арена помогает меньше: красивый ответ ещё не значит, что тесты пройдут. Здесь смотрим на наборы задач, где решение проверяют запуском.
Индекс Artificial Analysis v5 от 27 октября 2026 года:
- FrontierCode 2.0, 15% веса индекса: первый Claude Opus 5.5 на максимальной тщательности, 46%.
- Terminal-Bench 4.0, работа в терминале, 10% веса: первая Kimi K3.1 Pro, 67%.
Заметка лаборатории от 28 октября добавляет индекс кодовых агентов. Связка Claude Code и Claude Opus 5.5 (max) набрала 62, связка Antigravity CLI и Gemini 4 Carbon (high) — 59. Carbon здесь второй, и это тот же день, когда он стал первым в общем индексе.
Свои цифры есть в посте xAI о Grok 4.7 от 21 сентября 2026 года. Terminal-Bench 4.0: Claude Fable 5.1 Max — 57,9%, Grok 4.7 xHigh — 37,6%, GPT-5.6 Sol Max — 37,3%. DeepSWE v1.1, правки в больших репозиториях: GPT-5.6 Sol — 72,7%, Grok 4.7 на высокой тщательности — 71,0%, Claude Fable 5.1 — 70,0%. CursorBench 4.0, длинные задачи в редакторе: Fable 5.1 — 51,8%, Grok 4.7 — 46,3%.
Обратите внимание: Terminal-Bench 4.0 у xAI и у Artificial Analysis дал разных лидеров. Прогоны шли в разные даты, с разной обвязкой и разным списком моделей. Цифры из двух таблиц мы не склеиваем.
Разработчики называют сценарии прямо. Anthropic пишет, что Claude Opus 5.5 (22 сентября 2026) построена для долгой агентной работы с кодом: многочасовые автономные агенты, крупный рефакторинг, сложная системная инженерия. OpenAI описывает GPT-6 Sol как модель для сложного кода и агентных цепочек, а более новую GPT-6.1 Sol — как почти уровень Astra для сложной работы.
Из моделей с открытыми весами стоит держать в списке Kimi K3. Moonshot выпустила её 16 июля 2026 года, Fortune назвал её крупнейшей открытой моделью на тот момент, 2,7 триллиона параметров. Сравнение с Claude Fable 5 в том материале — заявление самой компании. GLM-5.3 от Z.ai под лицензией MIT стоит в текстовой Arena 28-й с 1481.
Разборы моделей — в обзоре Claude Opus 5.5 и обзоре Grok 4.7. Как выбирать под свой стек, разобрано в гайде «Какая модель для кода».
Пример запроса: «В файле test_user.py падает assert на строке 42. Найди причину и предложи минимальный патч, без новых зависимостей».
Что проверить: проходят ли тесты после патча, не появились ли лишние библиотеки, не тронула ли модель соседние функции.
Типичная ошибка: просить «перепиши весь проект» без критерия готовности. Агент утонет в полурешениях.
Две оси кода: патч и марафон
У задач с кодом два разных режима. Первый — точечная правка: один баг, известный файл, понятный тест. Ближе всего к нему DeepSWE и FrontierCode. Здесь разница между первыми местами небольшая, и модель уровня GPT-6.1 Sol или Kimi K3 закрывает такую задачу не хуже флагмана.
Второй режим — марафон: агент часами ходит по дереву проекта, запускает команды, читает логи. Это Terminal-Bench и индекс кодовых агентов. Здесь разрыв между моделями большой: у xAI 57,9% против 37,6% на одном и том же наборе.
Практический вывод. Для одного бага берите быструю рабочую модель и проверяйте патч тестом. Для многочасовой сессии смотрите на Terminal-Bench и на индекс агентов, а потом прогоните две модели из верхней строки на своём репозитории.
Длинные документы и таблицы
Когда в запросе PDF на сотни страниц или архив таблиц, решают окно контекста и умение не потерять деталь на сороковой странице.
У Artificial Analysis этому отведена четверть индекса v5 — работа со знаниями. Лидеры на 27 октября 2026 года:
- AA-Briefcase, 15% веса, рабочие задачи со знаниями: Claude Sonnet 5.5, 1812 Эло.
- GDP.pdf, 5% веса, задачи по длинным PDF: Muse Wonder Full, всего 33% задач пройдены целиком.
- AutomationBench-AA, 5% веса, автоматизация рабочих действий: Gemini 4 Argon, 78%.
Цифра 33% у лидера важнее места. Даже лучшая модель в этой проверке без ошибок закрывает только треть задач по длинным документам. Ответ по большому PDF всегда нужно сверять.
Окна у флагманов на ноябрь 2026 года:
- GPT-6 Astra: 1 050 000 токенов, на вход до 922 000, ответ до 128 000. В документации OpenAI она описана для сложных рассуждений, кода, исследований и создания документов, в API есть поиск по файлам.
- Claude Opus 5.5: окно 1 миллион, ответ до 128 тысяч. Claude Sonnet 5.5 с тем же окном Anthropic помечает как быструю.
- Gemini 4 Argon: Google представила её 13 октября 2026 года, в API общий лимит на вход и ответ — миллион токенов. В посте отдельно названо глубокое мультимодальное понимание документов. В демонстрации модель свела около 50 ГБ данных воздушной лазерной съёмки, планов и чертежей в трёхмерную реконструкцию каньона Чако.
Разборы — в статьях про GPT-6 Astra и Gemini 4 Argon.
Пример запроса: «По приложенному отчёту: три риска для заказчика, на каждый цитата не длиннее 20 слов и номер страницы».
Что проверить: совпадает ли номер страницы с PDF, не подменила ли модель цитату пересказом.
Типичная ошибка: просить «выводы по всему архиву» одним сообщением и не сказать, что делать, если файл не открылся. Модель достроит пропуск сама.
Как не утонуть в PDF
Длинный файл лучше резать на логические куски и называть их в запросе: «глава 3 — только риски, глава 5 — только цифры выручки». Окно в миллион токенов не отменяет сжатия: ответ всегда короче исходника, и детали уходят первыми.
Таблицы из PDF часто превращаются в гладкий текст с округлёнными числами. Сверьте хотя бы три случайные ячейки с оригиналом. Если расхождение повторяется, попросите выгрузку списком «строка, значение, страница».
Скан без текстового слоя — отдельная история. Модель, которая видит картинки, прочитает страницу, но может спутать «8» и «3» в мелкой сноске. Для таких файлов сначала распознайте текст, потом просите анализ.
Картинки и правка фото
Языковые модели из первых разделов картинок сами не рисуют. У GPT-6 Astra в документации на выходе только текст, для изображений нужна отдельная модель генерации.
Арена картинок, Text-to-Image, на 2 ноября 2026 года собрала 6 961 993 голоса по 84 моделям:
- Первые пять строк заняли модели OpenAI. Лучшая — GPT-Image-2.5 Sunburst, 1427 ± 5, предварительно.
- GPT-Image-2.5 Flare — третья, 1399, предварительно. GPT-Image-2 (Medium) — пятая, 1382.
- Nano Banana 2.1 от Google — седьмая, 1325 ± 9, предварительно.
- Muse Image от Meta — одиннадцатая, 1268.
У Nano Banana 2.1 есть сильная сторона, которую общий балл не показывает. В карточке DeepMind от 6 октября 2026 года режим с рассуждением даёт 1050 ± 14 в общей оценке против 990 ± 7 у прошлой Nano Banana 2. Отдельно меряют точность подписей на инфографике: 0,521 против 0,179 у прошлой версии. Это про то, насколько верно модель пишет цифры и слова на схемах.
О моделях подробнее — в статьях про Nano Banana 2.1 и GPT Image. Чем генерация отличается от фильтра, разобрано в материале про нейросети для картинок, а практика запросов — в гайде «Работа с картинками».
Пример запроса: «Плакат A4: заголовок на русском из пяти слов, ниже блок из трёх пунктов, без мелкого текста по углам».
Что проверить: читается ли заголовок, нет ли лишних букв, не поплыли ли пропорции.
Типичная ошибка: просить страницу мелкого текста. В карточке DeepMind прямо сказано, что мелкий текст, длинные абзацы и объём в страницу остаются слабым местом.
Правка и серия кадров
Для правки готовой картинки в той же карточке есть отдельная строка. Nano Banana 2.1 с рассуждением набирает 1026 ± 12 против 938 ± 11 у Nano Banana 2. Для запроса «убери объект слева, свет оставь» это и есть нужная цифра.
Серия кадров с одними и теми же героями — ещё одна строка, согласованность нескольких персонажей: 1106 ± 14 у новой модели против 978 ± 10 у прошлой. Если нужен один герой в четырёх позах, проверяйте глаза, причёску и одежду между кадрами, а не только первый.
Без рассуждения новая модель набирает 1015 в общей оценке. Это выше прошлой версии с её 990, но ниже режима с рассуждением с его 1050. Если на картинке текст или сложная сцена, режим с рассуждением стоит лишних секунд.
Видео и анимация
Лучшие нейросети для генерации роликов в поиске — почти всегда про создание клипа с нуля, монтаж снятого тут ни при чём. Здесь две открытые таблицы, и порядок в них разный.
Видеоарена Arena, Text-to-Video, на 5 ноября 2026 года, 887 494 голоса по 50 моделям:
- Gemini Omni 1.2 Flash, Google — 1541 ± 15, предварительно.
- Gemini Omni 1.1 Flash — 1514.
- Seedance 2.0 (720p) от Bytedance — шестая, 1481. Seedance 2.5 — седьмая, 1480.
- Wan 3.0 от Alibaba — восьмая, 1477.
- Veo 3.1 со звуком — 14-я, 1363.
Видеотаблица Artificial Analysis AA-Video-T2V v2.1, по состоянию на 6 ноября 2026 года: первая Wan 3.0 с 1172 ± 14, второе и третье места отстают в пределах погрешности. Seedance 2.5 здесь пятая, Seedance 2.0 девятая, Gemini Omni Flash 1.1 десятая, Veo 3.1 22-я с 961.
Вывод: в обе десятки попали Wan 3.0, Seedance 2.0 и 2.5 и Gemini Omni 1.1 Flash. С них и начинайте.
Veo 3.1 в обеих таблицах в середине, но у неё есть то, что баллы не видят. На странице DeepMind заявлены звук в одном проходе с видео (шумы, фон, реплики), выход в 1080p и 4K и продление клипа от последней секунды. Чем генерация отличается от монтажа, разобрано в статье про нейросети для видео.
Пример запроса: «8 секунд: чашка на столе, пар поднимается, камера медленно наезжает, фоновый шум кафе».
Что проверить: не плывёт ли текст на вывесках, совпадает ли длина клипа с заказанной, не меняется ли предмет между кадрами.
Типичная ошибка: ждать точную реплику по длинному сценарию. DeepMind сама пишет, что естественная речь, особенно в коротких фразах, ещё в работе.
Звук и первый кадр
Звук вместе с картинкой экономит этап для рекламного клипа без закадрового текста. Для точного совпадения слов дубль всё равно слушают: интонация меняется от запуска к запуску.
Режим «картинка на вход» задаёт первый кадр. Если продукт должен остаться узнаваемым, прикрепите фото упаковки и просите движение камеры, а не новый дизайн. Видеоарены меряют в основном ролики из текста, так что для этого режима сравните две модели сами.
Поиск фактов и свежие события
Здесь важно два умения: вызвать поиск и не выдумать ссылку. Для каждого есть своя таблица.
Search Arena, где люди голосуют за ответы с поиском в сети, на 13 октября 2026 года, 1 437 508 голосов по 42 моделям:
- GPT-5.6 Sol (xHigh), OpenAI — 1261 ± 6.
- Qwen3.8-Max, Alibaba — 1261 ± 13, но у неё 1870 голосов против 60 437 у лидера.
- GPT-6 Astra (Max) — седьмая, 1234. GPT-6.1 Sol (Max) — восьмая, 1233.
Вторая таблица — AA-Omniscience v1.1 у Artificial Analysis. Она проверяет точность знаний и отдельно штрафует выдуманные ответы. На 28 октября 2026 года: Gemini 4 Carbon — 54, Claude Opus 5.5 (max) — 48, Gemini 4 Argon — 46. Разбор Carbon есть в отдельной статье.
У моделей OpenAI поиск в сети встроен в API, это видно в документации GPT-6 Luna, GPT-6 Astra и GPT-6.1 Sol. Без поиска модель знает мир только до даты среза.
Пример запроса: «Какие изменения в правилах сервиса X объявлены после 1 октября 2026 года? Нужна ссылка на официальную страницу».
Что проверить: открывается ли адрес, совпадает ли дата на странице с ответом.
Типичная ошибка: принять уверенный абзац без ссылки. Модель может смешать старые правила и черновик анонса.
Срез знаний и поиск — разные инструменты
Срез знаний — дата, до которой модель видела данные при обучении. По документации на ноябрь 2026 года: GPT-6 Astra и GPT-6.1 Sol — 30 апреля 2026, GPT-6 Luna — 18 мая 2026, Claude Opus 5.5 и Claude Haiku 5.5 — июнь 2026.
Всё, что случилось позже, модель без поиска угадывает. Выборы, правила сервисов, новые релизы моделей требуют включённого поиска или вашей ссылки в запросе.
Если модель вернула ссылку, откройте её сами. Битый адрес или переход на главную — сигнал переспросить с условием «только официальный сайт разработчика».
Сводная таблица по задачам
Цифры из одной таблицы не переносим в соседнюю строку. Это ориентир по источникам, единого балла у него нет.
| Задача | Кто впереди | Таблица и дата | Кого ещё взять |
|---|---|---|---|
| Текст и письма | Gemini 4 Carbon, Gemini 4 Argon, Claude Opus 5.5 | Arena Text, 27.10.2026 | Gemini 3.8 Flash, GPT-6 Luna, Claude Haiku 5.5 для потока |
| Код | Claude Opus 5.5 | AA FrontierCode 2.0 и индекс агентов, 27–28.10.2026 | Kimi K3.1 Pro, Gemini 4 Carbon, GPT-6.1 Sol, Kimi K3 |
| Документы | Claude Sonnet 5.5, Muse Wonder, Gemini 4 Argon | AA-Briefcase, GDP.pdf, AutomationBench-AA, 27.10.2026 | GPT-6 Astra с окном 1 050 000 |
| Картинки | GPT-Image-2.5 Sunburst | Arena Text-to-Image, 02.11.2026 | Nano Banana 2.1 для правки и текста на схемах |
| Видео | Gemini Omni 1.2 Flash, Wan 3.0 | Arena Video 05.11.2026, AA-Video-T2V v2.1 на 06.11.2026 | Seedance 2.0 и 2.5, Veo 3.1 со звуком |
| Поиск и факты | GPT-5.6 Sol, Gemini 4 Carbon | Search Arena 13.10.2026, AA-Omniscience 28.10.2026 | GPT-6 Astra, GPT-6.1 Sol |
Какую нейросеть выбрать на практике
Алгоритм без магии.
Назовите задачу одним предложением и один критерий успеха: «конспект на две страницы», «патч проходит pytest», «плакат с читаемым заголовком».
Откройте две модели из нужной строки таблицы. Один и тот же запрос, одинаковые вложения. Сравните по заранее названному критерию. Длина ответа критерием не считается.
Меняйте только модель. Если в каждом прогоне другая формулировка, вы сравниваете запросы, а не нейросети.
Запишите итог в две строки: что сработало, что нет. Через месяц повторите тот же запрос: таблицы к этому времени сдвинутся, а ваши заметки покажут, изменилось ли качество на вашей задаче.
Если быстрая модель не тянет, поднимайтесь на ступень выше у того же разработчика. Прыгать между десятью брендами дольше. Общий порядок — в гайде «Как выбрать модель».
Полный список моделей, которые можно открыть в чате GPThub, — на странице моделей: там же видно, какая из них сильнее в тексте, картинках или видео. Переключать модели можно в одном окне, не уходя из разговора, а картинки и ролики делаются там же, во вкладках генерации.
Таблица разработчика не заменит специалиста. Юридический текст, медицинские решения и отчётность перед регулятором требуют живого человека, нейросеть здесь даёт только черновик.
С учёбой так же. Модель может решить задачу и оформить ответ, но преподаватели узнают шаблонные обороты и выдуманные источники. Для тренировки мысли модель полезна, сдавать её текст без правки рискованно.
Вопросы и ответы
Какие есть нейросети в 2026 году?
Три большие группы: языковые модели для текста и кода, генераторы картинок и генераторы видео. У языковых моделей есть ступени от быстрой до флагманской. Кто какие модели выпускает, собрано в карте нейросетей 2026.
Какая нейросеть лучше всего?
Одной нет. На 27 октября 2026 года в текстовой Arena первая Gemini 4 Carbon, в общем индексе Artificial Analysis на 28 октября тоже она, с 59 баллами. В коде у той же лаборатории впереди Claude Opus 5.5, в картинках на Arena — GPT-Image-2.5 Sunburst.
Какой искусственный интеллект лучше для кода?
По индексу Artificial Analysis v5 — Claude Opus 5.5: 46% в FrontierCode 2.0 и 62 балла в индексе кодовых агентов. В Terminal-Bench 4.0 у той же лаборатории первая Kimi K3.1 Pro с 67%. Для одного бага в известном файле хватит рабочей модели вроде GPT-6.1 Sol, подробнее в гайде по коду.
Лучшие нейросети для генерации картинок и видео?
Картинки: на Arena 2 ноября 2026 года первая GPT-Image-2.5 Sunburst, для правки и текста на схемах сильна Nano Banana 2.1. Видео: на Arena 5 ноября первая Gemini Omni 1.2 Flash, у Artificial Analysis первая Wan 3.0, Seedance 2.0 и 2.5 в десятке обеих таблиц.
Какую нейросеть лучше использовать, если времени мало?
Начните с быстрой модели: Gemini 3.8 Flash стоит в первой десятке текстовой Arena. Если ответ слабый, один раз поднимитесь на GPT-6.1 Sol или на модель из верхней четвёрки, не перебирая десять имён.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
Похожие статьи
- Карта нейросетей 2026
Кто делает лучшие нейросети в 2026 году, чем отличаются модели OpenAI, Anthropic, Google, xAI и китайских лабораторий и какую выбрать под задачу.
- Как читать бенчмарки
Первое место в таблице нейросетей живёт сутки. Как устроен бенчмарк и что смотреть рядом с цифрой.
- Gemini 4 Carbon
28 октября 2026 Google анонсировала Gemini 4 Carbon для долгих задач и киберзащиты. Тесты, порядок доступа и сравнение с Argon и Opus 5.5.
- Claude Opus 5.5
Claude Opus 5.5 вышла 22 сентября 2026: окно в миллион токенов, уровень Fable 5.1 на большинстве задач. Что показывают тесты и когда её брать.
- Nano Banana 2.1
Nano Banana 2.1 — новая модель Google для картинок, вышла 6 октября 2026. Чем отличается от Nano Banana 2 и Pro и где её открыть.
- Генерация против монтажа
Генерация делает ролик из текста или картинки, монтаж собирает уже снятое. Разбираем, что умеют модели на октябрь 2026 и когда нужен каждый подход.
Источники
- Arena: текстовая таблица, 27 октября 2026
- Arena: Search, 13 октября 2026
- Arena: Text-to-Image, 2 ноября 2026
- Arena: Text-to-Video, 5 ноября 2026
- Artificial Analysis: Intelligence Index v5, 27 октября 2026
- Artificial Analysis: Gemini 4 Carbon, 28 октября 2026
- Artificial Analysis: AA-Video-T2V v2.1
- OpenAI: GPT-6 Astra
- OpenAI: GPT-6.1 Sol
- OpenAI: GPT-6 Luna
- Anthropic: Claude Opus 5.5, 22 сентября 2026
- Anthropic: Claude Haiku 5.5, 7 октября 2026
- Google: Gemini 4 Argon, 13 октября 2026
- Google DeepMind: Nano Banana 2.1, 6 октября 2026
- Google DeepMind: Veo 3.1
- xAI: Grok 4.7, 21 сентября 2026
- DeepSeek: V4, 24 апреля 2026
- Fortune: Kimi K3, 16 июля 2026
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Подобрать модель в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.