
Как читать сравнения нейросетей и почему одно первое место ничего не значит
Обозреватель: как устроен ИИ
Содержание
27 октября 2026 года лаборатория Artificial Analysis выложила новую сводную таблицу, и на максимальном уровне тщательности Claude Opus 5.5 стоял первым с баллом 58. На следующий день, 28 октября, первое место забрал Gemini 4 Carbon от Google, уже с баллом 59. Сутки, и одно и то же имя таблицы, другая строка сверху. Человеку, который ищет, как сравнивают нейросети, этой пары дат хватает, чтобы перестать читать место как приговор. Бенчмарк нейросетей — заранее собранный набор задач с правилом, когда ответ считать удачным, и цифра сверху — среднее по этому набору, иногда ещё и среднее от средних, и она отвечает на узкий вопрос и молчит про соседний набор задач.
Откуда берётся одно число
Школьный экзамен кажется близкой картинкой, и все писали одну контрольную, у кого выше балл, тот сильнее. Картинка врёт сразу в трёх местах, и первое из них такое — у нейросетей нет общей контрольной. Есть десятки наборов, и каждый автор набора сам решает, что считать умением. Во-вторых, вопросы часто лежат в открытом доступе годами, и модель могла видеть и вопрос, и ответ ещё на этапе обучения, так что высокий процент говорит о памяти, а не о новой задаче. В-третьих, в зачёт идёт целая связка программ вокруг модели. Другая связка на той же модели даёт другую цифру. Имя в строке таблицы — ещё и имя обвязки.
Сборка всё же короткая — берут задачи. Задают правило зачёта, и гоняют модели в одних и тех же условиях. Потом усредняют, и дальше пути расходятся, и расходятся они сильнее, чем кажется по слову «бенчмарк» в заголовке новости.
Три семьи наборов живут рядом, и путать их дороже всего.
Закрытые вопросы, и ответ короткий, его можно сверить с ключом. Сюда относятся школьные и вузовские тесты вроде MMLU и экспертные вопросы вроде Humanity's Last Exam. Плюс понятный, и минус тоже. Умение угадать букву слабо связано с умением довести дело.
Задачи с программой, и модель должна поменять код или довести опыт в терминале так, чтобы автоматические проверки сказали «да». SWE-bench и свежие наборы вроде FrontierCode смотрят сюда. Здесь видно, чинит ли модель чужой проект, и здесь плохо видно, понятно ли она объясняет.
Живые голоса, и человек видит два ответа, имена спрятаны, и выбирает, какой приятнее или полезнее. Площадка Arena считает рейтинг из таких пар, и это вкус толпы на тех запросах, которые толпа сама принесла. Вкус толпы и зачёт тестов — разные оси.
Пока новость говорит «модель обошла всех по бенчмаркам», в ней обычно смешаны две оси, а то и три, и имеет смысл спросить, какая из трёх осей спрятана в заголовке.
Как сравнивают нейросети на публичной таблице
Вопрос из поиска звучит просто: как сравнивают нейросети. На практике сравнивают прогоны, а не нейросети целиком. Прогон — это модель плюс уровень тщательности плюс программа, которая задаёт ей вопросы и ставит оценку.
Сводный индекс Artificial Analysis версии 5, объявленный 27 октября 2026, как раз показывает эту кухню без стеснения. В нём четыре равные четверти: работа со знаниями, код, наука и общие вопросы, и внутри четвертей лежат девять отдельных проверок, и веса у них разные.
На работу со знаниями отдали четверть веса, то есть 25%. Из них 15% — набор AA-Briefcase, 5% — AutomationBench-AA, ещё 5% — GDP.pdf, задачи по длинным документам. На код тоже 25%, и из них 15% — FrontierCode 2.0 и 10% — Terminal-Bench 4.0. На науку 25%, и из них 15% — Terminal-Bench-Science, семьдесят задач в терминале, и 10% — жёсткий кусок CritPt v2, сорок закрытых вопросов по физике. Общая четверть делится так. 15% у AA-Omniscience v1.1, причём 10 пунктов из этих 15 — за точность, а 5 — за долю ответов без выдуманных фактов. Последние 10% — HLE-Diamond, тысяча вопросов, поровну на рассуждение и на знания.
Уже по списку весов видно, почему одно первое место ничего не значит. Половина внимания индекса сидит в коде и в науке внутри терминала, и модель, которая блестяще отвечает на вопросы из учебника и теряется в командной строке, общий балл не возьмёт. Обратный случай тоже возможен, и сильный агент для репозитория может просесть на знаниях, и сводка это спрячет внутрь среднего.
Авторы индекса прямо написали, что 60% веса теперь сидит на закрытых наборах или на ответах, которые не отдают в открытую. Причина бытовая, и если вопросы годами лежат в сети, их вытаскивают в обучающую выборку. В таком случае таблица меряет знакомство с ключом, а не новую работу. Закрытый набор эту лазейку заметно сужает, хотя и не закрывает навсегда. Он же мешает постороннему повторить цифру у себя на кухне, и доверие тут держится на имени лаборатории и на описании правил, а не на кнопке «прогнать самому».
Ещё одна деталь, которую заголовок «номер один» съедает. Уровень тщательности. Claude Opus 5.5 на низком уровне набрал в этом индексе 35, на максимальном — 58. Тот же ярлык модели, разница в 23 пункта. У Claude Sonnet 5.5 размах от низкого до максимального — 29 пунктов. Строка без пометки уровня сравнивает разные режимы так, будто это разные спортсмены под одной фамилией, и в новости режим часто остаётся в сноске.
Объём ответа тоже вырос, и медиана токенов, которые модель пишет на одну задачу индекса, поднялась с 35 тысяч в прошлой редакции до 59 тысяч, и длинный ответ здесь оказывается частью самого измерения, а не украшением. Короткая модель на таких задачах просто не успевает дойти до зачёта.
Сводку версий между собой авторы сопоставлять не предлагают, и состав проверок меняется, старый балл и новый балл живут на разных линейках. Для длинной истории у них отдельная шкала, Progress Index, с октября 2026, и она оценивает способность модели и трудность задачи вместе, по теории ответов на задания. Индекс для «кто сильнее сейчас» и шкала для «как росла способность с 2022 года» — соседи, но соседи с разной рулеткой.
Почему первое место пустое
27 октября лидер общего балла не был лидером каждой строки, и Claude Opus 5.5 вёл FrontierCode 2.0 с 46%, HLE-Diamond с 68% и AA-Omniscience с 48 баллами. GPT-6 Astra вёл науку в терминале с 63% и жёсткую физику CritPt с 72%. Claude Sonnet 5.5 вёл набор AA-Briefcase с отдельным рейтингом пар. Kimi K3.1 Pro вёл Terminal-Bench 4.0 с 67%. Gemini 4 Argon вёл AutomationBench-AA с 78%, и Muse Wonder Full вёл задачи по длинным PDF, и там полный зачёт был всего 33%. Шесть разных имён разошлись по девяти проверкам, и ни одно не собрало все строки. Общий балл 58 у Opus получился как взвешенная смесь, а не как победа во всём.
На следующий день эта смесь уже переехала к другому имени, и Gemini 4 Carbon набрал 59 и стал первым в индексе. По заметке лаборатории он лидирует в четырёх проверках из девяти, и среди них трудный экзамен, наука в терминале, проверка на выдумки и автоматизация рабочих действий. В коде и в работе с документами лидером его там не назвали. Рядом, уже на другой таблице, индексе агентов для кода, тот же Carbon на высоком уровне набрал 59 и отстал на три пункта от Opus 5.5, который в связке Claude Code набрал 62. Первое место в «уме» и второе место в «кодовом агенте» вышли в один день у одной модели.
Отсюда практическое правило, и место читают только вместе с подписью столбца. «Первый в индексе v5 на 28 октября 2026, уровень высокий, балл 59» — осмысленная фраза. «Лучшая нейросеть» — пустая, и между ними пропали имя набора, дата, уровень и то, какие строки эта модель проиграла.
Открытые веса в той же таблице стоят заметно ниже, и 27 октября лучший ещё не выложенный открытый вариант, Kimi K3.1 Pro, имел 46, на 12 пунктов позади лидера. Среди уже выложенных весов DeepSeek V4.1 Flash 1017 и GLM-5.3 набирали по 32. Claude Haiku 5.5 на максимальном уровне, модель поменьше из закрытой линейки, имел 36 и обходил эти открытые веса. Разрыв сам по себе никого не записывает в «плохие». Он показывает, что слово «открытая» не заменяет прогон, и что маленькая закрытая модель на этой линейке обгоняет крупные файлы, которые можно скачать.
Про сами модели, если нужно устройство, а не таблица, есть отдельные разборы. Claude Opus 5.5, GPT-6 Astra и Gemini 4 Carbon, и здесь они нужны как подписи строк, не как совет «берите верхнюю».
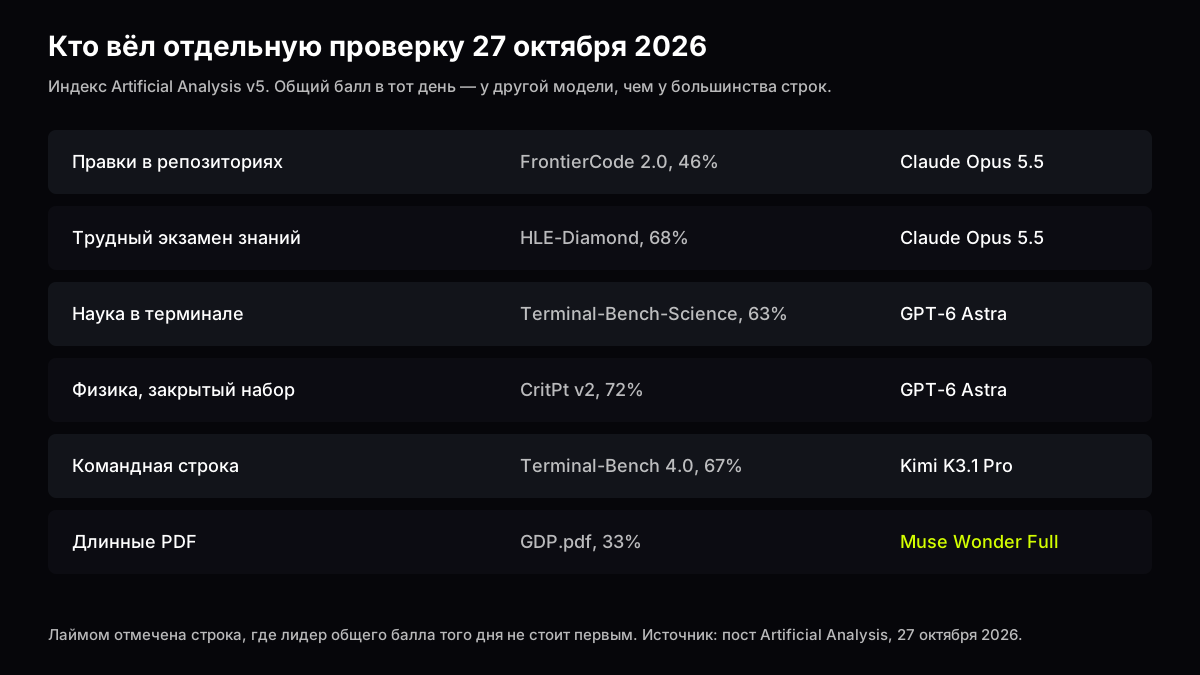
Источник: пост Artificial Analysis об индексе v5, 27 октября 2026. На схеме нет общего балла, только отдельные проверки.
Старый экзамен, который все выучили
MMLU собрали Дэн Хендрикс и соавторы. Работа вышла на arXiv в 2020 году и прошла конференцию ICLR в 2021. В наборе 57 предметов, от школьной математики до права и медицины, всего 15908 вопросов. Пять вопросов на предмет оставили, чтобы показать модели примеры. 1540 вопросов ушли на подбор настроек и в зачёт не входили. Зачётный кусок — 14079 вопросов, и неспециалисты, которых наняли через Mechanical Turk, набирали 34,5%. В аннотации сказано прямо, и большинство тогдашних моделей сидело около случайного угадывания, а самая большая GPT-3 поднималась над случайным почти на 20 пунктов. До эксперта по каждому из 57 предметов было далеко, и авторы прямо писали, что даже лучшей модели того года не хватает на всём списке сразу.
Дальше случилось то, что со школьными тестами случается всегда. Их проходят, и вопросы лежали открыто, и каждое новое поколение моделей видело и формулировки, и обсуждения. Когда сильные модели начинают упираться в потолок, таблица перестаёт их различать. Разница в один пункт тонет в шуме. Новость «мы набрали 89 против 88» на таком наборе уже мало что говорит о новой способности.
Humanity's Last Exam собирали как ответ на этот потолок. В статье Nature (идентификатор s41586-025-09962-4) описан набор из 2500 вопросов больше чем по ста предметам. Почти тысяча людей из более чем 500 организаций и полусотни стран присылала задачи. Правило отбора жёсткое, и если сильные модели вопрос уже решали, вопрос выкидывали. Авторы насчитали больше 70 тысяч попыток моделей и около 13 тысяч вопросов, которые модели не брали и которые ушли людям с учёной степенью по предмету. Смысл набора в том, чтобы снова отодвинуть потолок. Смысл не в том, чтобы навсегда остаться «последним экзаменом». Имя красивое, и любой открытый набор со временем начинает протекать в обучение.
Поэтому в индексе октября 2026 на месте полного экзамена стоит урезанная и вычищенная версия, HLE-Diamond. Тысяча вопросов, половина на рассуждение, половина на знания, и старое имя в заголовке новости и новое имя в методике — частая путаница. Цифры между полным экзаменом и этой выжимкой сравнивать нельзя, и это разные работы, даже если корень названия один.
Тот же сюжет, только на репозиториях, повторяется у кода. SWE-bench вырос из статьи 2024 года на ICLR, и берут настоящие задачи с GitHub, модель предлагает правку, правку накладывают на репозиторий и смотрят, позеленели ли тесты. В полном наборе 2294 задачи, в коротком Lite — 300, в Verified — 500. Verified люди вместе с OpenAI перечитали руками, и условие должно быть ясным, тесты верными, а задача решаемой по тому, что написано в условии. Иначе модель штрафуют за кривое описание, а не за слабый код.
Даже внутри Verified таблица на самом деле двойная. Полный список смешивает системы, и простой цикл, поиск по коду, несколько попыток с выбором лучшей. Рядом живёт отдельный режим «только командная строка», и там все модели гоняют в одной программе, mini-SWE-agent, с одной настройкой. Авторы сайта прямо пишут, что выпуски 1.x и 2.x этой программы сравнивать лоб в лоб нельзя. Во втором поколении действие вызывается как инструмент. В первом его вычитывают из текста ответа. Температуру в первом ставят в ноль, если параметр вообще есть. Во втором поколении обвязки температуру не задают вовсе. Две цифры «процент закрытых задач» с разных выпусков обвязки — это два эксперимента. Новость часто печатает их в соседних клетках.
Загрязнение набора — отдельная болезнь именно открытых задач, которые годами лежат в сети. Если правка, которая считается правильной, уже гуляет по форумам, модель может принести её по памяти. Закрытые наборы вроде FrontierCode 2.0 держат задачи при себе именно поэтому. 132 правки в живых открытых репозиториях, зачёт такой. Сопровождающий принял бы изменение, и провал любой блокирующей проверки обнуляет попытку целиком, без частичного балла. Каждый прогон повторяют трижды, и повторы нужны, потому что агент по пути бросает монету. Один удачный заход из трёх и три удачных — разная устойчивость, а в короткую новость уходит среднее.
Что делает с таблицей человеческий вкус
Площадка Arena, её раньше знали как LMSYS Chatbot Arena, устроена иначе. Человек пишет запрос, и две модели отвечают, имена скрыты до выбора. Голос уходит в статистическую модель Брэдли–Терри, старую схему для парных сравнений. Её часто путают с шахматным рейтингом Эло. Родство есть, тождество нет, и чтобы числа выглядели знакомо, коэффициенты домножают на 400 и прибавляют 1000. Это линейка на шкале, как перевод футов в метры. Порядок соперников такая перерисовка шкалы не переставляет. Фраза «рейтинг 1400» без даты среза и без имени категории мало что держит. Голоса капают каждый день, состав моделей меняется, и вчерашний сосед по таблице сегодня может отсутствовать.
Слепая пара защищает от любимого логотипа и не защищает от манеры письма. 29 августа 2024 года команда площадки разобрала, как на голос влияют длина ответа, число заголовков, число жирных кусков и число списков. Страницу с этим разбором потом обновляли 13 июня 2025 года. После того как эти четыре вещи вычли, порядок моделей сдвинулся. Длина ответа оказалась главным из этих четырёх факторов. Остальная разметка слабее, и авторы честно написали границу метода и не прятали её в сноску. Разбор наблюдательный, и длинный ответ бывает длинным просто из-за воды, без новой мысли. Длинный ответ бывает длинным, потому что модель показала шаги решения, и шаги как раз и нужны. Вычесть длину до конца нельзя, пока длину не назначают жребием в отдельном опыте.
Для чтения ежедневной новости вывод получается тихий, и «Победила в слепом голосовании» значит, что людям на тех запросах, которые они сами принесли, ответ понравился больше. Среди причин симпатии есть и правда, и аккуратная вёрстка, и простор объяснения. Если нужна проверка факта или зелёный тест, голосование — слабый свидетель. Если нужна манера для переписки, свидетель как раз сильный. Оси разные, и склеивать эти оси в один общий пьедестал незачем.
Категории внутри той же площадки тоже разведены, и там отдельно лежат жёсткие запросы, код, математика и обычная болтовня. Модель может вести общую колонку и проседать в коде. Или наоборот, и скриншот «общего рейтинга» без названия колонки — тот же приём, что сводный балл без списка весов.
Что проверить в строке, прежде чем верить месту
Короткая памятка, без которой таблица читается как турнирная таблица чемпионата.
Имя набора, а не слово «бенчмарк» в одиночестве, и MMLU, HLE-Diamond, SWE-bench Verified и индекс v5 — четыре разные работы, и перенос места из одной в другую — ошибка перевода.
Дата среза, и для индекса v5 разница между 27 и 28 октября 2026 уже меняет первую строку, и для Arena дата важна ещё сильнее, потому что голоса не останавливаются.
Кто гонял, и цифра разработчика модели и цифра посторонней лаборатории живут в разных интересах. Обе бывают честными. Обе же бывают оптимизированы под красивый заголовок. Рядом полезно видеть, совпали ли они хотя бы по порядку, не обязательно по десятым.
Дальше смотрят уровень тщательности и программу вокруг модели, и «Opus 5.5» без пометки уровня в индексе v5 — это вилка от 35 до 58, и «Процент на SWE-bench» без номера обвязки — вилка между поколениями mini-SWE-agent.
Открытый набор или закрытый, и открытый набор можно пересчитать у себя и можно подглядеть заранее. Закрытый набор труднее подглядеть и труднее пересчитать без автора, и зрелый текст новости называет, какой из двух случаев перед читателем.
Потолок, и если лучшие стоят на 2–3 пункта друг от друга, а шум прогона сопоставим с этой щелью, «обошла» — слишком громкий глагол. У GDP.pdf полный зачёт лидера был 33%, и там есть куда расти, и разрыв ещё о чём-то говорит. У старого MMLU щель сверху часто уже ни о чём.
Чего в строке нет, и картинки, речь, длинный диалог на русском, умение держать стиль автора, цена ожидания. Индекс v5 про текст и про агентные задачи в терминале и в файлах. Голос, ролик и вёрстка страницы в эти 59 баллов не вписаны, и модель, которая слабее в таблице и удобнее в вашей переписке, таблицу не опровергает. Такая модель отвечает на другой вопрос, и таблица этого вопроса не задавала.
Своя задача вместо чужого пьедестала
Таблица отвечает, как модель вела себя на чужих задачах в чужих правилах, и своя задача устроена короче, и для неё хватает одного признака удачи, названного заранее.
Для кода признак такой, и есть фрагмент, который падает, и есть имя проверки, которая должна стать зелёной. Хороший ответ называет файл, называет проверку и не выдумывает библиотеку, которой в фрагменте нет. Плохой ответ гладко объясняет «в чём идея» и не трогает падение. Бенчмарк вроде SWE-bench как раз ловит второй тип. На своём куске это видно без таблицы, и достаточно одного и того же фрагмента двум моделям.
Для факта признак другой, и в ответе есть дата, имя документа и оговорка, если источник молчит. Гладкий абзац без даты — как раз то, за что в AA-Omniscience снимают отдельные 5% веса. Попросите модель сказать, кто лидировал в индексе v5 27 октября и кто 28-го. Верный след — Opus 5.5 с баллом 58, затем Carbon с баллом 59, со ссылкой на посты лаборатории, и выдуманный след — один вечный чемпион и круглая цифра без дня.
Для вкуса признак третий, и два слепых абзаца на ваш текст, без имени модели на полях. Нравится тот, который можно отдать дальше без правки, а не тот, у которого больше заголовков. Площадка Arena занята ровно этим сравнением вкуса, и дома для того же признака хватает пары абзацев на ваш текст.
Это уже сравнение на практике, и пошаговый разбор живёт в гайде сравнение моделей на практике. Как сузить выбор до двух-трёх имён под задачу, разобрано в гайде как выбрать модель. Для такого домашнего прогона Claude Sonnet 5 и Grok 4.5 уже доступны в чате GPThub. Они не обязаны совпасть с верхней строкой чужого индекса, и совпасть они должны с признаком удачи, который вы назвали до прогона.
Типичная ошибка чтения — перенести место из кода на переписку или из переписки на код, и вторая ошибка — сравнить максимальный уровень одной модели с низким уровнем другой и назвать это свойством архитектуры. Третья — взять цифру годовой давности и поставить её рядом со свежей, как будто линейка та же. Четвёртая — поверить названию «последний экзамен» или «проверенный набор» без абзаца, сколько там задач и кто их отбирал. Пятьсот задач Verified и две тысячи задач полного SWE-bench дают разную строгость уже на входе.
Если в новости одна строка «обошла всех», рядом должны лежать хотя бы три вещи. Имя набора, и день прогона, и кто ещё вёл соседние проверки. Нет этих трёх — новость про место, а не про умение. Место, как показал конец октября 2026, живёт примерно сутки, и на следующее утро в той же таблице уже может стоять другая лаборатория с другим баллом и с другим набором выигранных строк.
Вопросы и ответы
Как сравнивают нейросети, если коротко?
Берут общий набор задач, фиксируют правило зачёта и гоняют модели в одной обвязке. Потом усредняют, и голоса людей считают отдельно, парами, со скрытыми именами, и сводный балл — смесь нескольких таких прогонов с опубликованными весами.
Что такое бенчмарк нейросетей?
Это именованный набор задач плюс правило, какой ответ засчитан. У набора есть автор, размер и дата, и MMLU — 14079 зачётных вопросов по 57 предметам, работа 2020–2021 годов. SWE-bench Verified — 500 задач с GitHub, отобранных людьми, и без имени и размера слово «бенчмарк» не отличается от слова «тест».
Бенчмарк ИИ моделей и бенчмарк нейросетей — это разное?
В поиске так пишут оба запроса, а имеют в виду одно. Речь про сравнение больших языковых моделей на общем наборе, и отдельно существуют прогоны картинок, речи и роликов, и их цифры в текстовый индекс не подмешивают, даже если имя модели совпало.
Есть ли топ ИИ по бенчмаркам на 2026 год?
Есть срезы на конкретный день, и 27 октября 2026 в индексе v5 первым был Claude Opus 5.5 с баллом 58. 28 октября первым стал Gemini 4 Carbon с баллом 59, и топ без даты устаревает быстрее, чем его успевают перепечатать.
Почему бенчмарки ИИ моделей расходятся между собой?
Они меряют разное и с разными весами, и в одном индексе лидер науки в терминале и лидер длинных PDF — разные модели. Слепое голосование добавляет вкус к длине и к разметке, и открытый старый набор модели уже видели, закрытый новый — ещё нет. Четыре причины дают четыре порядка, и все четыре могут быть посчитаны честно.
Что смотреть вместо одного первого места?
Имя набора, день, уровень тщательности, открыт ли набор, и кто выиграл соседние строки, и потом один прогон на своей задаче с признаком удачи, названным заранее, и чужое первое место этого прогона не заменяет.
Связанные модели


Связанные гайды
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- Artificial Analysis, индекс интеллекта v5, 27 октября 2026
- Gemini 4 Carbon становится первым в том же индексе, 28 октября 2026
- Карточка Gemini 4 Carbon у Artificial Analysis
- Методика Progress Index
- SWE-bench Verified
- Вопросы и ответы SWE-bench, размеры наборов
- Статья SWE-bench, arXiv:2310.06770
- MMLU, arXiv:2009.03300
- Humanity's Last Exam, препринт статьи Nature
- Arena, как устроены голоса
- Arena, шкала рейтинга
- Arena, контроль стиля, 29 августа 2024
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Сравнить модели на своей задаче
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.