Эффективные действия в работе с нейросетью: что это значит на практике
Обозреватель: как устроен ИИ
Содержание
14 июля 2023 года в журнале Science вышла работа двух экономистов Массачусетского технологического института с невзрачным названием «Экспериментальные данные о влиянии генеративного искусственного интеллекта на производительность». Опыт внутри был простой: 453 специалиста с высшим образованием писали рабочие тексты, половине выдали ChatGPT. Группа с нейросетью справлялась на 40% быстрее, и качество её текстов оценщики ставили на 18% выше. Причём разница между теми, кто действовал с нейросетью умело, и теми, кто просто вставил вопрос и забрал первый ответ, оказалась заметнее, чем разница между моделями. Какие именно действия дают такой отрыв — вопрос, по которому написаны уже три руководства самих разработчиков, и в них, что удобно, советы повторяются.
Откуда вообще известно, что эффективно
Слова «эффективные действия» звучат как лозунг со стенда, и тем интереснее, что за ними стоят измеримые вещи. Два главных эксперимента устроены похоже. Берут профессионалов, делят случайным образом, одной половине дают нейросеть и смотрят на числа.
Про опыт из Science выше уже сказано, стоит добавить деталей. Задачи там были профильные для каждого участника. Пресс-релизы, короткие отчёты, аналитические записки, деликатные письма — то, что эти люди пишут на работе за деньги. Оплата зависела от качества, которое оценивали другие профессионалы из тех же областей. И ещё одно следствие, о котором реже вспоминают: разрыв между сильными и слабыми участниками с нейросетью сократился. Инструмент подтянул середину сильнее, чем вершину, и это следствие авторы отдельно подчёркивают. Участники, попробовавшие ChatGPT в эксперименте, через две недели вдвое чаще пользовались им в реальной работе — привычка закрепилась с одного касания.
Второй эксперимент провели в сентябре 2023 года с консультантами Boston Consulting Group — 758 человек, реальные консультантские задания. Участников разделили на три группы. Первая работала без нейросети, вторая с GPT-4, третья с GPT-4 и коротким курсом о том, как составлять запросы. Внутри круга задач, которые модели по силам, обе группы с нейросетью обошли коллег — на 12,2% больше выполненных заданий, на 25,1% быстрее, качество решений выше. Авторы назвали этот круг «рваной границей» — задачи по одну сторону модель тянет, соседние, внешне такие же по сложности, уже заваливает. Про это будет отдельный раздел.
Третий источник — руководства самих разработчиков. OpenAI, Google и Anthropic публикуют инструкции по составлению запросов для своих моделей. Написаны они для программистов, но советы внутри совпадают до смешного. Все трое повторяют одни и те же пять действий. Совпадение неслучайное — устройство у моделей общее, и слабости общие.
Термины, которые понадобятся дальше. Запрос — текст, который вы отправляете модели; в руководствах его называют промптом, подробный разбор слова есть в отдельной статье. Контекст — всё, что модель видит в момент ответа, от вашего запроса и приложенного материала до предыдущих реплик. Диалог — цепочка сообщений в одном чате; модель перечитывает её целиком перед каждым новым ответом.
Действие первое: задача с границами
Общий принцип прост. Модель продолжает текст, и чем точнее задан угол, тем меньше ей приходится достраивать за вас. Привычное сравнение с поисковиком здесь подводит. Поисковик по двум словам находит готовые страницы, написанные людьми, а нейросеть по двум словам порождает текст сама, и пустоту в формулировке она заполнит самым статистически вероятным содержимым. Запрос «расскажи про налоги» вернёт реферат ни о чём. Запрос «объясни, какие налоги платит репетитор-самозанятый в России и какие у него лимиты дохода» даёт уже рабочий ответ.
Google в руководстве по стратегиям запросов советует отдельно проговаривать ограничения. Чего в ответе быть не должно, какой длины ответ нужен, для кого он пишется. Фраза «уложись в три абзаца, без вводных слов, для читателя без экономического образования» отсекает сразу три типовые беды. OpenAI рекомендует начинать служебную часть запроса с роли и цели — кому модель отвечает и зачем. Anthropic первым пунктом своего справочника ставит раздел «Будьте ясны и прямы».
В том же руководстве Google есть полезная самопроверка. Представьте, что ваш запрос получил толковый новый сотрудник, который ничего не знает о вашей ситуации. Хватит ли ему написанного, чтобы сделать работу без встречных вопросов? Если нет, то и модели не хватит. Только сотрудник переспросит, а модель, скорее всего, молча додумает.
Звучит банально. В общем, так и есть, поразительно другое. По замерам Google именно расплывчатая постановка остаётся самой частой причиной слабых ответов, а стоит она пользователю ровно ноль усилий сверх привычки.
Действие второе: материал вместо памяти
У модели два источника знаний. Первый — то, что осело в ней при обучении. Второй — то, что вы ей показали. Первый источник застыл на дате отсечки и размывается на редких темах. Второй — целиком под вашим контролем.
Отсюда действие. Всё, от чего зависит ответ, надо дать в запросе. Текст договора, таблицу с цифрами, описание ситуации, переписку — приложить, вставить, пересказать. Google формулирует жёстко: вместо предположения, что модель всё нужное знает, передайте ей нужное сами. Про то, что случается, когда модель отвечает из «памяти» о редких вещах, мы писали в разборе почему нейросети выдумывают факты — заполнять пробел правдоподобной выдумкой для них штатный режим.
Пример из руководства Google будничный до смешного — настройка домашнего роутера. Спросите без контекста, и получите обобщённую инструкцию по «роутерам вообще», где половина пунктов не совпадает с вашим меню, а кнопка из шага три отсутствует в природе. В руководстве предлагают вложить в запрос инструкцию конкретной модели роутера, и тогда ответ идёт по вашим реальным пунктам меню. Сама нейросеть за эти две попытки, понятно, умнее не стала.
С длинным материалом есть тонкость, о которой руководства говорят хором: инструкцию ставят после материала. Сначала документ на десять страниц, потом вопрос к нему — у OpenAI это сформулировано как «контекст ближе к концу запроса», у Google как совет заканчивать длинный блок связкой «опираясь на материал выше». Вопрос, похороненный перед простынёй текста, модели удерживать труднее.
Действие третье: пример ответа
Самый недооценённый приём. Вместо описания желаемого результата показывают один-два образца. Вот входные данные, вот каким должен быть ответ. Модель подхватывает закономерность из пары примеров, как подхватывает и стиль, и структуру, и степень подробности, причём подхватывает надёжнее, чем из словесного описания той же структуры.
Google в руководстве называет запросы без примеров «скорее всего менее эффективными» и советует включать примеры всегда. У OpenAI примеры — третья секция рекомендованной структуры запроса, после роли и инструкций. У Anthropic им посвящён отдельный раздел справочника.
Работает это и в быту. Нужен ответ на отзыв клиента в вашем тоне — покажите два своих старых ответа, которые вам нравятся, и попросите третий в том же духе. Нужно переписать десять заголовков — перепишите первый сами и отдайте модели остальные девять с этим образцом. Описывать словами «дружелюбно, но без фамильярности» дольше и ненадёжнее.
Есть и предел. Примеров бывает слишком много. Google предупреждает, что на длинном ряду однотипных образцов модель переобучается на форму и начинает копировать случайные мелочи вроде длины предложений, упуская суть. Два-три разнообразных примера работают лучше десяти одинаковых.
Действие четвёртое: формат ответа
Если результат нужен таблицей, так и пишут. Таблицей, колонки такие-то. Если списком коротких пунктов, если письмом, если кодом — всё это проговаривается заранее. Приём выглядит мелочью, однако он экономит целый круг переделки: без указания формата модель выбирает его сама, и выбирает под среднестатистический запрос, а переформатировать готовый ответ — это ещё одно сообщение, ещё одно ожидание и ещё один шанс, что при пересборке что-нибудь потеряется.
У Google описан и трюк для упрямых случаев — начать ответ за модель. Запрос заканчивается первой строкой желаемого результата, шапкой таблицы или первым пунктом списка. Модели остаётся продолжить начатый рисунок, а продолжать заданный образец ей ощутимо проще, чем выдумывать оформление с нуля.
Сюда же относится явный запрет лишнего. «Без предисловий», «без оговорок о том, что ты языковая модель», «только список, без пояснений» — ограничения, которые Google советует писать прямым текстом. Модель охотно выполняет и их.
Действие пятое: проверка
Действие, которое чаще всего пропускают, и единственное, без которого остальные четыре теряют смысл в серьёзной работе. Уверенный тон ответа ничего не говорит о его точности. Формулировки «согласно исследованию» и конкретные числа модель строит одинаково гладко и там, где опирается на данные, и там, где достраивает. Дата, фамилия, номер закона, строка кода, арифметика. Всё, что имеет цену ошибки, сверяется с источником вне чата.
Здесь полезно помнить вторую половину эксперимента с консультантами: в задаче за пределами возможностей модели группа с нейросетью ошибалась на 19% чаще группы без неё. Инструмент, который обычно помогает, в неудачной точке приложения активно вредил — люди доверяли гладкому ответу и несли его в решение. Какие вопросы стоит задавать, чтобы вскрыть слабые места ответа, мы разбирали в статье как задать вопрос нейросети.
Проверку можно отчасти встроить в сам запрос. Попросите модель отвечать только по приложенному материалу и помечать места, где материала не хватило. Попросите к каждому факту указать, откуда он взят. Полной гарантии эти оговорки не дают, зато выдумки в ответе становятся заметнее. Фраза «в приложенном документе этого нет» куда честнее уверенной цифры из ниоткуда.
| Действие | Почему работает | Где описано |
|---|---|---|
| Задача с границами | Модель достраивает недосказанное; границы сужают поле для достройки | Руководства Google и OpenAI, раздел Anthropic «Be clear and direct» |
| Материал в запросе | Ответ опирается на показанное, а память модели размыта и устаревает | Руководство Google, раздел про контекст |
| Пример ответа | Закономерность из образца модель воспроизводит точнее, чем из описания | Google: «запросы без примеров менее эффективны»; OpenAI: секция Examples |
| Явный формат | Снимает круг переделки; модель выполняет формальные ограничения охотно | Руководства Google и OpenAI |
| Проверка фактов | Уверенность тона не связана с точностью; за пределами «границы» ошибок на 19% больше | Dell'Acqua et al., сентябрь 2023 |
Сложное — по частям
Шестое действие в руководствах стоит отдельной главой. Большую задачу не грузят в один запрос. Google описывает три способа разбиения. Первый — разложить инструкции. Вместо одного запроса «прочитай отчёт, выдели риски, предложи план и напиши письмо руководству» получаются четыре запроса подряд. Второй — цепочка, где результат первого шага вставляется в запрос второго. Выжимка отчёта становится материалом для плана. Третий — параллель. Три варианта заголовка тремя отдельными запросами, потом четвёртым запросом сравнить.
Причина не в лени модели. В длинном составном задании части конкурируют за её внимание, и обычно страдает середина. Риски выделены блестяще, план уже скомкан, письмо написано по плану, которого толком нет. По шагам каждая часть получает весь контекст целиком — и, что не менее ценно, между шагами встаёт человек. Слабую выжимку вы поймаете уже на первом шаге, до всякого письма.
Побочное следствие для тех, кто считает себя обязанным составить идеальный запрос с первого раза: не выйдет, и это нормально. Google прямо пишет, что составление запроса — дело нескольких попыток, и советует при неудаче не только дописывать детали, но и пробовать другую формулировку той же задачи или другой порядок частей. OpenAI называет работу с запросами смесью искусства и науки. Для инженеров это повод строить тесты; для обычного пользователя — повод не винить себя за второй и третий заход.
Почему уточняющий запрос лучше нового
Вопрос из тестов по ИИ-грамотности, и редкий случай, когда у тестового вопроса есть честный технический ответ.
Перед каждым ответом модель перечитывает весь диалог. Ваша задача, приложенный материал, первая версия ответа, ваши поправки — всё это лежит в контексте и работает на следующую реплику. Уточнение «сократи вдвое и убери канцелярит» опирается на целую проделанную работу. Модель видит, что сокращать и какой текст чистить.
Новый чат обнуляет это всё. Контекст пуст, задачу придётся пересказывать заново, материал прикладывать заново. Первая попытка, в которой модель уже угадала половину нужного, исчезает без следа. По сути вы увольняете исполнителя, который принёс черновик, и нанимаете нового, пересказывая ему задание по памяти — с шансом пересказать хуже, чем в первый раз.
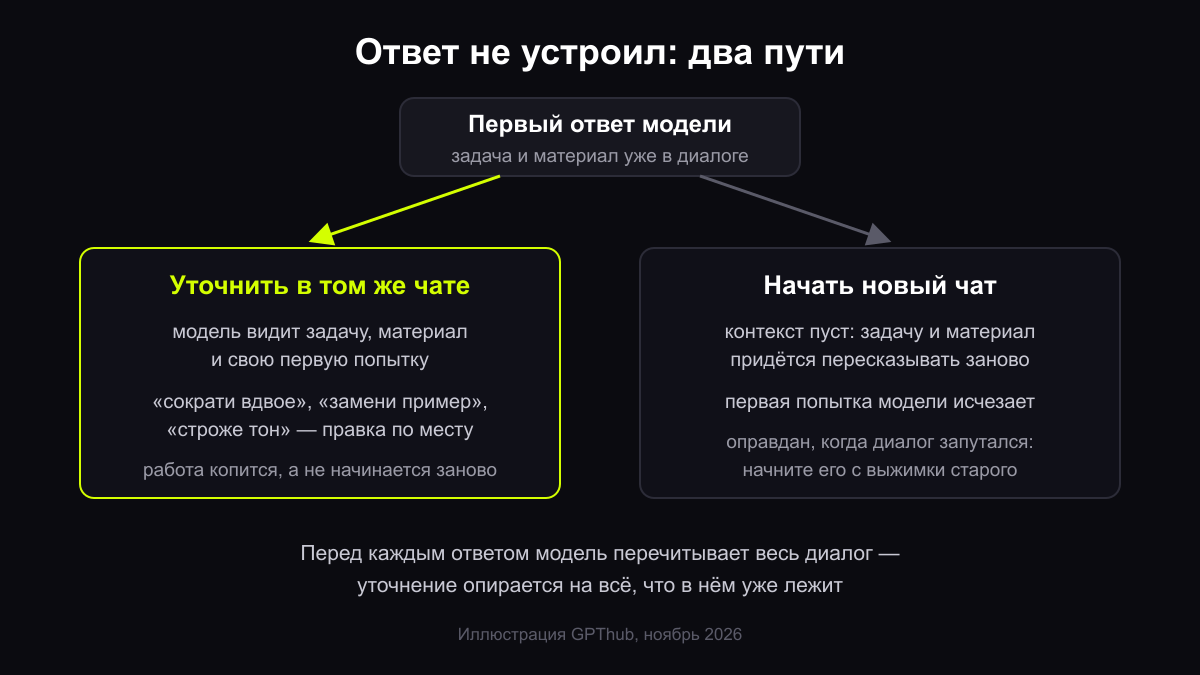
Схема двух путей после неудачного ответа, иллюстрация GPThub
Из того же устройства следует и граница приёма. Длинный диалог, где тему меняли трижды, а правки противоречат друг другу, тянет модель во все стороны разом — старые реплики продолжают влиять на новые ответы. Признак такого состояния — ответы начали смешивать требования из разных частей разговора. Вот тогда новый чат действительно выручает, причём начать его стоит с выжимки — короткого пересказа задачи и последней рабочей версии, перенесённых из старого диалога руками.
Уточнять тоже лучше конкретно. «Перепиши получше» оставляет модели гадать, что именно вас не устроило, и часто она меняет не то. «Второй абзац длинный, сократи его вдвое, пример с роутером оставь» — правка, которую модель выполнит с первого раза. Чем точнее названо место и направление, тем меньше шансов, что вместе с неудачным куском перепишется удачный.
Отдельный случай — модель ответила вовсе не на тот вопрос. Прежде чем пробовать заново, перечитайте собственный запрос. Чаще всего в нём живёт второе прочтение, и модель выбрала его. Дальше работает то же уточнение с названным местом расхождения: «вопрос был про самозанятых, про юридические лица отвечать не нужно». Если после двух-трёх таких поправок ответы продолжают уезжать в сторону — вот это уже признак запутавшегося диалога из предыдущего абзаца.
Что любопытно, эксперимент с консультантами косвенно измерил и цену неумения уточнять: группе, получившей перед работой краткий курс по составлению запросов, он добавил результата сверх простого доступа к модели.
Где правильные действия не спасают
Авторы эксперимента с BCG ввели термин, который стоит знать каждому, кто работает с нейросетями: рваная граница. Возможности модели очерчены не ровной линией «простое может, сложное нет», а зубчатой кривой. Написать стратегию выхода продукта на рынок — внутри границы, модель справляется блестяще. Разобрать таблицу с подвохом, где правильный вывод противоречит первому впечатлению, — уже снаружи, и именно там группа с нейросетью проиграла группе без неё.
Для проверки обратной стороны авторы заложили в эксперимент одну управленческую задачу за пределами границы. На ней группы поменялись местами. Консультанты, работавшие по старинке, чаще докапывались до правильного ответа, пусть и медленнее. У тех, кто спросил модель, на руках оказывался развёрнутый и неверный разбор, и большинство его приняло. Те самые минус 19% правильных решений из начала статьи взялись отсюда.
Неприятность в том, что с места пользователя граница не видна. Задачи по обе стороны выглядят одинаково, ответы модели по обе стороны звучат одинаково уверенно. Никакое из пяти действий границу не сдвигает — они улучшают результат внутри неё. Единственная защита снаружи — та самая проверка, пятое действие, которое пропускают чаще всего.
Арифметика — классический зубец этой границы. Модель, уверенно рассуждающая о налоговой оптимизации, способна промахнуться в умножении двух трёхзначных чисел, потому что считает она тем же механизмом, каким подбирает слова. Для счёта есть калькулятор, у части моделей — встроенное выполнение кода.
Граница ещё и у каждой модели своя. Быстрая компактная модель и большая рассуждающая по-разному тянут длинные документы, код и многошаговые задачи, поэтому действие «выбрать модель под задачу» в руководствах стоит раньше всех советов про запросы — разбор того, чем модели различаются, есть в гайде по выбору модели.
Мелкие приёмы, которые упоминают все три руководства
За пределами пяти больших действий в руководствах повторяются приёмы помельче. Роль. Фраза «ты редактор научно-популярного журнала» в начале запроса смещает и лексику, и строгость ответа; у Anthropic этому посвящён раздел «Give Claude a role», у OpenAI роль открывает рекомендованную структуру запроса. Просьба рассуждать по шагам. На задачах с логикой и подсчётами ответ, где модель сначала выписывает рассуждение и только потом вывод, выходит точнее, чем мгновенный вердикт. Разметка. Длинный запрос с подзаголовками или помеченными блоками «материал», «задача», «формат» модель разбирает надёжнее, чем сплошную простыню; Anthropic советует размечать блоки тегами, Google одобряет и обычные заголовки.
Отдельная строка — про то, чего делать не нужно. Просить модель «быть точнее» или «не ошибаться» бесполезно. Точность складывается из контекста и границы возможностей, уговоры на неё не действуют. Угрожать и обещать чаевые — популярный фольклор, в руководствах разработчиков таких советов нет. И прежде чем править ответ, перечитайте собственный запрос. По замерам Google причина слабого ответа чаще живёт именно там.
Если вопрос попался в тесте
Формулировка «какие действия эффективны в работе с нейросетью» кочует по тестам ИИ-грамотности — школьным, вузовским и корпоративным. Единого банка заданий у них нет, поэтому точный список вариантов ответа в каждом тесте свой. Ядро правильного ответа везде совпадает с разобранными выше пунктами: чёткая постановка задачи, передача контекста, разбиение сложного на шаги, уточнение вместо пересоздания, проверка результата.
Типовые ловушки в вариантах ответа устроены зеркально. «Принимать первый ответ как готовый», «задавать вопрос как можно короче», «не тратить время на проверку, модель обучена на проверенных данных». Каждая ловушка — отрицание одного из пяти действий, так что выученный принцип надёжнее выученного списка.
Встречается в тестах и парный вопрос — «почему уточняющий запрос лучше нового». Правильный ответ там обычно звучит как «диалог сохраняет контекст предыдущих сообщений», и, как видно из раздела выше, это буквальное описание механики. Модель перечитывает диалог перед каждым ответом.
Для практики всё это доступно без регистрации. Гостевой чат GPThub отвечает моделью GPT-6 Luna, на платных тарифах к ней добавляются DeepSeek V4 Flash, Gemini 3.8 Flash и другие модели каталога — проверено по каталогу 16 ноября 2026 года. Готовые формулировки под разные задачи собраны в гайде по составлению промптов; ответы моделей в этой статье мы не приводим, свежего прогона под неё не было.
Вопросы и ответы
Какое действие в работе с нейросетью самое эффективное?
Если выбирать одно — передача контекста: материала, на который модель должна опереться. Расплывчатый запрос она переспросить может, а вот восстановить документ, которого не видела, никак. Но по-настоящему пять действий работают вместе: задача, материал, пример, формат, проверка.
Почему уточняющий запрос лучше нового?
Диалог сохраняет контекст: задачу, приложенный материал и предыдущие версии ответа. Уточнение опирается на всё это, новый чат начинает с нуля и теряет проделанную работу. Исключение — длинный запутавшийся диалог со сменой темы: его выгоднее закрыть и начать заново с короткой выжимкой.
Нужно ли вежливо обращаться к нейросети, чтобы она лучше отвечала?
«Пожалуйста» и «спасибо» на качество ответа заметно не влияют — в руководствах OpenAI, Google и Anthropic такого совета нет. Работают содержательные вещи: границы задачи, материал, примеры, формат. Вежливость остаётся делом привычки, вреда от неё тоже нет.
Можно ли доверять ответу, если нейросеть отвечает уверенно?
Уверенный тон — свойство текста, который модель строит, и с точностью он не связан. В эксперименте с 758 консультантами в задаче за пределами возможностей модели группа с нейросетью ошибалась на 19% чаще. Факты с ценой ошибки проверяют по источникам вне чата.
Сколько примеров класть в запрос?
Два-три разнообразных. Один пример уже заметно помогает, а длинный ряд однотипных образцов вреден: модель начинает копировать случайные мелочи формы вроде длины предложений. Примеры должны различаться содержанием при одинаковой структуре.
Где потренироваться составлять запросы?
В любом чате с современной моделью. Без регистрации это делается в гостевом режиме GPThub; разбор типовых формулировок — в гайде по промптам, а что такое промпт и чем он отличается от обычного вопроса — в отдельной статье.
Связанные модели


Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Похожие статьи
- Точный вопрос нейросети
Как задать вопрос нейросети, чтобы ответ был точным: контекст, источник фактов, право на «не знаю», когда включать поиск и как проверить ответ.
- Что такое промпт
Что такое промпт простыми словами: из чего состоит запрос к нейросети, что такое системный и текстовый промпт и почему он не равен вопросу.
- Галлюцинации нейросети
Что такое галлюцинации нейросети, почему чат пишет правдоподобную ложь и как проверять даты, имена и ссылки перед сдачей работы.
- DeepSeek не работает
Почему DeepSeek пишет «сервер занят» или не отвечает: перегрузка, лимиты, сбои. Как проверить статус сервиса и что делать, когда ответ нужен сейчас.
- Нейросеть для ответов
Как нейросеть отвечает на вопросы, откуда берёт факты, когда ей нужен поиск по сети и как понять, что ответ выдуман. Числа из проверок 2025–2026 годов.
- 50 промптов для нейросети
50 готовых промптов для нейросети: учёба, работа, тексты, картинки, поздравления. Что подставить в каждый шаблон и как понять, что ответ получился.
Источники
- Noy, Zhang. Experimental evidence on the productivity effects of generative artificial intelligence — Science, 14.07.2023
- Dell'Acqua et al. Navigating the Jagged Technological Frontier — SSRN, 18.09.2023
- Google: Prompt design strategies — руководство, открыто 16.11.2026
- OpenAI: Prompt engineering — руководство, открыто 16.11.2026
- Anthropic: Prompting best practices — справочник, открыт 16.11.2026
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Проверить эти приёмы в чате GPThub
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.