Нейросеть для поиска ответов на вопросы: когда ей можно верить
Обозреватель: как устроен ИИ
Содержание
22 октября 2025 года на ассамблее Европейского вещательного союза в Неаполе представили исследование с сухим названием «News Integrity in AI Assistants». 22 общественные вещательные компании из 18 стран, работая на 14 языках, задали четырём популярным ИИ-ассистентам больше трёх тысяч вопросов о новостях и проверили ответы силами собственных редакций. Итог: в 45% ответов нашлась хотя бы одна серьёзная проблема. Речь про перепутанный факт, выдуманную ссылку или устаревшее событие, поданное как свежее, то есть всерьёз. При этом те же инструменты миллионы людей каждый день используют именно для поиска ответов. Разберёмся, откуда нейросеть берёт ответ, почему ошибается и, главное, в каких случаях ей всё-таки можно верить.
Откуда нейросеть берёт ответ
Несколько терминов, без которых дальше никак. Обучение — этап, на котором модель пропускает через себя огромный корпус текстов и запоминает статистические связи между словами; после него знания модели застывают. Дата отсечки — день, до которого собирался этот корпус. Всё, что случилось позже, для модели не существует. Веб-поиск — режим, в котором модель сначала получает свежие страницы из обычного поисковика и отвечает уже по ним. Галлюцинация — уверенный ответ без опоры на память и найденное. Модель достраивает правдоподобный текст там, где фактов у неё нет.
Из этих четырёх слов складывается вся механика. Вопрос «что такое фотосинтез» модель закрывает памятью: учебников в корпусе тысячи, связи устойчивые, ошибиться трудно. Вопрос «что случилось вчера» память закрыть не может в принципе, нужных текстов в корпусе нет. Если поиск включён, модель прочитает свежие страницы и перескажет их. Если выключен, она либо честно скажет про отсечку, либо, что хуже, сочинит ответ по образцу похожих старых событий.
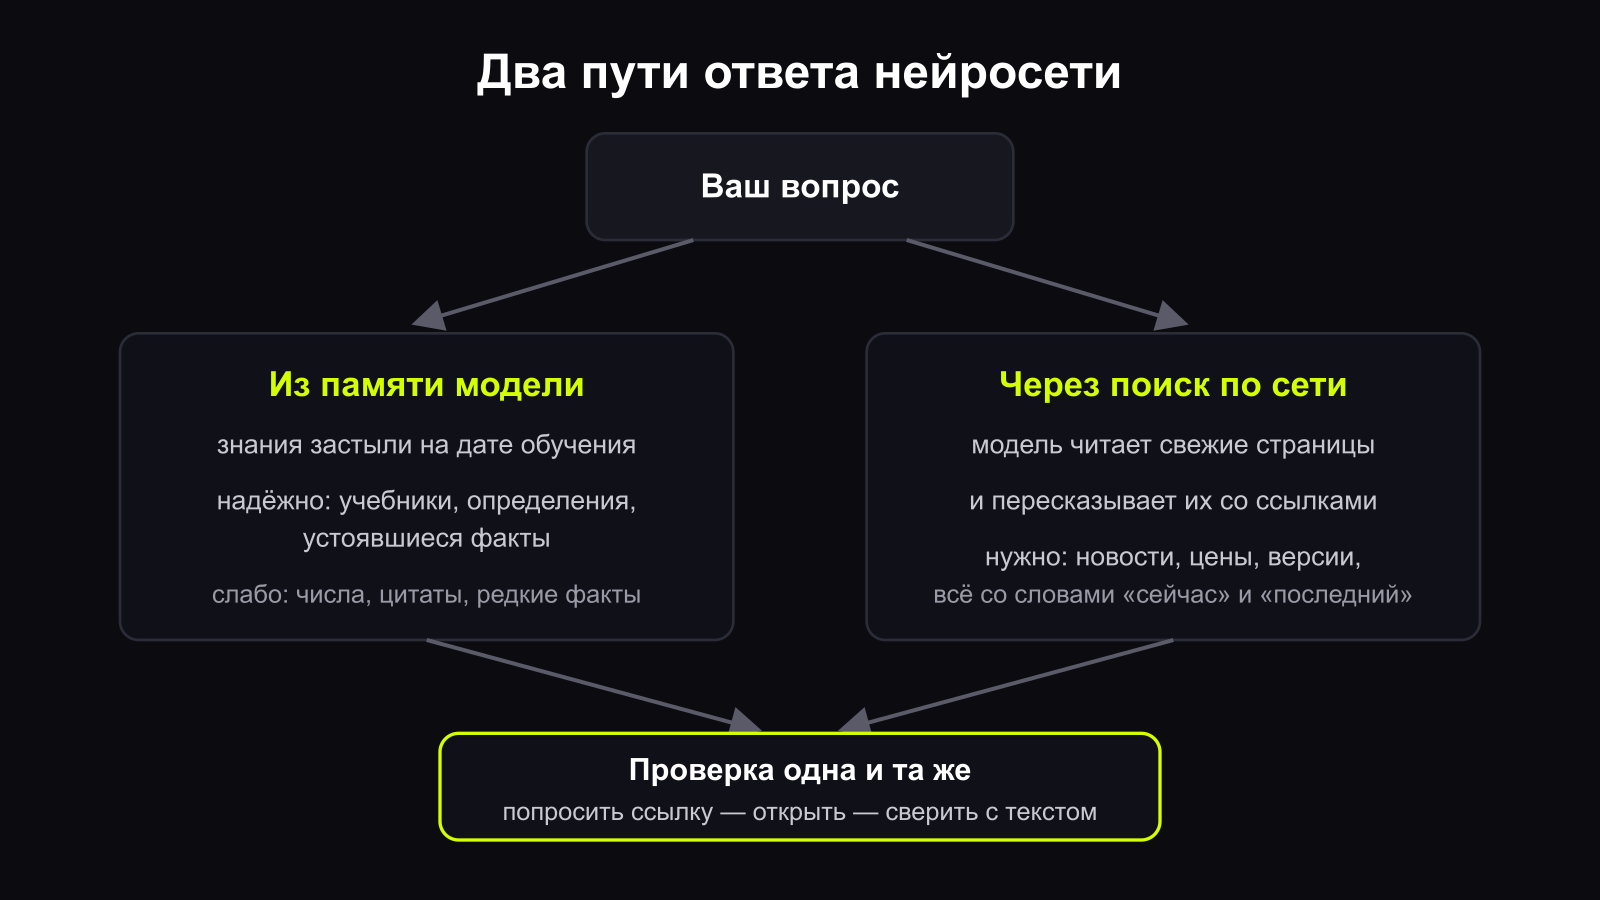
Схема путей ответа, иллюстрация GPThub
Промежуточный случай — вопрос про устоявшееся, но редкое знание. Дата битвы при Молодях в корпусе встречается сильно реже даты Бородина, связи слабее, и именно на таких вопросах память начинает подводить незаметно: ответ выглядит столь же уверенно, как про Бородино, а проверить тянет меньше.
Как устроен ответ с поиском изнутри
Режим поиска кажется волшебной кнопкой «теперь без ошибок», и полезно понимать, почему это не совсем так. Внутри происходит вполне приземлённая цепочка. Сначала ваша фраза превращается в один или несколько поисковых запросов. Формулирует их сама модель, и уже тут возможен промах. Спросили про «ставку на сегодня», а модель поискала без даты — в контекст поедут прошлогодние страницы. Потом обычный поисковый механизм возвращает страницы, и несколько верхних попадают модели в рабочий контекст — целиком или кусками. Наконец модель пишет ответ, опираясь на эти куски, и расставляет ссылки.
Сбои возможны на каждом шаге. Поисковый запрос сформулирован мимо, и в контекст попали страницы про другое. Страница устарела или сама ошибается, а модель не проверяет её репутацию так, как это делал бы придирчивый читатель. Кусков несколько, они противоречат друг другу, и модель склеивает их в гладкий текст, не заметив противоречия. Наконец, ссылка в ответе иногда расставляется небрежно: число взято с одной страницы, а сослалась модель на соседнюю. Исследователи EBU именно это и увидели: проблемы с атрибуцией оказались заметно чаще прямых выдумок.
Что любопытно, сам факт «материал перед глазами» всё равно резко улучшает дело. Замер Vectara, о котором ниже, показывает: когда документ выдан модели прямо в руки, лучшие из них искажают его лишь в паре процентов пересказов. Поэтому практический вывод из устройства поиска простой: проверять по ссылке. Самый ненадёжный участок цепочки, склейка и атрибуция, этой проверкой закрывается.
Чем это отличается от поисковика
Привычная аналогия такая: «нейросеть, которая ищет ответы» представляется поисковиком, только умнее. Та же строка запроса, то же мгновение ожидания, только вместо десяти синих ссылок сразу готовый текст. Аналогия удобная и неверная в главном. Поисковик находит чужие страницы и показывает их как есть, с адресами и авторами; за достоверность отвечает страница, и её видно. Нейросеть же составляет новый текст. Даже в режиме поиска она пересказывает найденное своими словами, и между источником и вами появляется пересказчик, который может понять неточно, склеить два источника в один или потерять оговорку.
Точнее сравнивать с человеком, который прочитал очень много и отвечает по памяти. Отвечает сразу, связно, охотно. Где прочитал — помнит смутно, признаваться в незнании не любит, причём не из вредности, просто так устроен. Живого рассказчика с такими привычками слушатели быстро начинают переспрашивать: откуда сведения, какого года. Нейросеть с теми же привычками переспрашивают почему-то редко. Текст на экране оформлен как справка, и спорить со справкой неловко. Чем чат вообще отличается от поиска, разобрано в статье ИИ-чат онлайн. Здесь достаточно одного отличия: у поисковика источник виден до клика, у нейросети источник нужно просить отдельной репликой, и даёт она его не всегда.
Есть и второе следствие, менее очевидное. Поисковик на один запрос показывает всем примерно одно и то же, и ошибку страницы из выдачи рано или поздно заметят тысячи читателей. Ответ нейросети собирается заново под каждый вопрос: ваша формулировка, ваш контекст, ваш случайный вариант генерации. Ошибку в таком ответе, кроме вас, не увидит никто, и опровержение в комментариях написать некому. Весь контроль качества, который в старом интернете был распределён по читателям, здесь достаётся одному читателю. Вам.
Что показали проверки
Проверок, где ответы нейросетей разбирали систематически и на объёме, к концу 2026 года накопилось достаточно, чтобы увидеть картину, а не отдельные казусы. Делали их разные команды в разное время, по разным методикам и на разном материале, что для нас и ценно. Три самых показательных — в таблице.
| Проверка | Кого проверяли | Что спрашивали | Главное число |
|---|---|---|---|
| EBU и BBC, октябрь 2025 | ChatGPT, Copilot, Gemini, Perplexity | >3000 вопросов о новостях на 14 языках | 45% ответов — с серьёзной проблемой |
| Tow Center (CJR), март 2025 | 8 поисковых ИИ | 1600 запросов: найти источник отрывка статьи | >60% ответов неверны |
| Vectara HHEM, снимок октября 2026 | десятки моделей | пересказать выданный документ без отсебятины | лучшие — 1,8–4% ошибок, худшие в таблице — до 24% |
Самое интересное у исследования EBU и BBC лежит глубже общего процента, в структуре ошибок. Чаще всего подводили источники: в 31% ответов ссылки не было, она вела не туда или приписывала утверждение не тому, кто его делал. Ошибки собственно точности, выдуманное и устаревшее, нашлись в 20% ответов. Разброс между ассистентами огромный: у худшего в этом замере, Gemini, серьёзные проблемы нашлись в 76% ответов, вдвое с лишним чаще, чем у остальных, и почти целиком из-за атрибуции. Замер сделан осенью 2025 года, ассистенты с тех пор обновлялись, но сама структура, «ссылки хуже фактов», за год повторилась во всех независимых проверках.
Центр Tow задавал вопрос попроще и получил ответ пожёстче. Восьми поисковым ИИ показывали отрывок реальной статьи и просили назвать заголовок, издание, дату и адрес. Отрывки подбирали так, чтобы обычный поиск находил оригинал в первых трёх результатах. С такой задачей справился бы студент на практике. Больше 60% из 1600 ответов оказались неверными. Причём ошибались инструменты уверенно: ChatGPT из 200 ответов неверно определил 134 статьи, а неуверенность обозначил лишь 15 раз. Больше половины ссылок Gemini и Grok 3 вели на несуществующие страницы; у Grok 3 из 200 процитированных адресов 154 открывались ошибкой.
Уверенный тон — пожалуй, главная практическая находка обеих проверок. Человек, который не помнит, говорит «кажется» и «не поручусь»; модель, у которой нет ответа, пишет тем же ровным тоном, что и при стопроцентном знании. Интонация ответа не несёт информации о его надёжности, и это стоит вынести из таблиц в первую очередь.
Замер Vectara устроен иначе, и его число — про другое. Модели дают готовый документ и просят пересказать без добавлений; специальная проверочная модель ищет в пересказе утверждения, которых в документе не было. Лучшие модели в снимке от 22 октября 2026 года держатся в полосе 1,8–4% ошибок, худшие из таблицы уходят за 20%. Вывод для практики: когда материал у модели перед глазами, выдумки падают на порядок. Это тот же эффект, что и с веб-поиском, — модель с источником в руках надёжнее модели, вспоминающей наизусть.
Оговорка к любой таблице такого рода: все три замера — моментальные снимки. EBU проверяла ассистентов в конце 2025 года, Tow Center — в начале, лидерборд Vectara обновляется, и строки в нём меняются местами. Числа выше показывают масштаб явления, и читать их как приговор конкретным продуктам смысла нет. Ошибки в ответах держатся устойчивым процентом, который у разных инструментов колеблется от единиц до десятков.
Где нейросеть отвечает лучше поисковика
Справедливости ради, у начитанного знакомого есть области, где он честно выигрывает у стопки ссылок.
Первая — вопросы на понимание. «Почему зимой холоднее, если Земля в январе ближе к Солнцу», «чем вирус отличается от бактерии», «что значит эта строка в договоре». Поисковик на такое отвечает десятью страницами, написанными для разных читателей, и собирать объяснение приходится самому. Модель собирает его сразу под ваш уровень, а уточнить можно следующей репликой, не переформулируя запрос с нуля. Для понимания это, пожалуй, самый выгодный обмен из всех возможных.
Вторая — вопросы к вашему собственному материалу. Конспект, договор, статья, таблица: вставили текст и спрашиваете по нему. Поисковик здесь вообще ничем помочь не может. Числа Vectara показывают, что это самый надёжный режим из всех. Пересказ выданного документа у сильных моделей расходится с оригиналом в единицах процентов.
Третья — вопросы, которые стыдно или неудобно задавать людям. Простые, «глупые», десятый раз об одном и том же. Модель не устаёт, не оценивает и объясняет заново другими словами, пока не станет понятно. Для учёбы это свойство недооценено, страх глупого вопроса тормозит сильнее нехватки учебников.
Четвёртая — перебор формулировок. Когда вы не знаете, как называется то, что ищете («фильм, где человек проживает один день по кругу», «как называется боязнь длинных слов»), модель угадывает по описанию. Классический поиск по ключевым словам на такой задаче буксует, ему нужны сами слова, а слов-то у вас и нет. Угаданное название дальше проверяется обычным способом, и круг замыкается за полминуты.
У всех четырёх областей общая черта — цена ошибки либо мала, либо ошибку видно сразу. Непонятое объяснение переспрашивается тут же, неверно угаданный фильм отбрасывается после первой проверки, и потерянная минута остаётся единственным убытком. Осторожность нужна там, где ответ уходит в реферат, решение или спор дальше без проверки.
Когда хватит памяти, а когда нужен поиск
Общий принцип прост: чем старше и устойчивее знание, тем надёжнее память, а чем свежее и конкретнее, тем нужнее поиск. Но самое интересное, как всегда, в деталях.
Память уверенно закрывает школьную и университетскую классику: законы физики, исторические даты из учебников, грамматику языков, устройство организма, базовые определения из любой дисциплины. Здесь нейросеть похожа на очень терпеливого преподавателя, и спрашивать её выгоднее, чем листать поисковую выдачу: ответ сразу подстроен под ваш уровень и ваш вопрос. Приёмы такой учёбы собраны в гайде нейросеть для учёбы.
Поиск обязателен для всего, что меняется: цены, курсы, расписания, версии программ, составы команд, действующие правила и законы, вчерашние события. Признак, что пора включать поиск, — в вопросе есть «сейчас», «в этом году», «последний» или название чего-то, вышедшего недавно. В чате GPThub веб-поиск включается прямо в окне диалога, и модель отвечает по свежим страницам со ссылками на них.
Хуже всего даётся середина между этими полюсами — знание, которое выглядит вечным, но менялось. Плутон в 2006 году перевели из планет в карликовые планеты. Решение принимал съезд Международного астрономического союза в Праге, голосованием, и с тех пор планет восемь. А тексты, где планет девять, из обучающих корпусов никуда не делись, их там тысячи, и модель вполне может пересказать именно их. С рекомендациями по первой помощи то же самое, их пересматривают каждые несколько лет, старые версии продолжают лежать в корпусах рядом с новыми. Уверенный тон при этом одинаковый: что про восемь планет, что про девять.
Отдельная зона — числа и цитаты. Даже в устоявшемся знании точное число модель может «вспомнить» с ошибкой, потому что статистические связи хранят порядок величины надёжнее последней цифры. Дословные цитаты хуже всего. Модель восстанавливает их по смыслу, и получается пересказ, выданный за дословность. Что в ответе стоит перепроверять в первую очередь и почему модель вообще выдумывает, разобрано в статье почему нейросеть выдумывает.
И про учебные задачи. Решение задачи по фото или условию устроено по-другому, чем поиск ответа. Это вычисление, и ловушки у него свои: модель может верно объяснить ход и ошибиться в арифметике. Этому посвящена отдельная статья — нейросеть для решения задач.
Как проверить ответ за минуту
Процедура короткая, и она одна на все случаи, хоть для новости, хоть для даты из реферата.
Первое: попросить источник, и попросить конкретно. «Дай ссылку на страницу, откуда это, и процитируй место». Переспрос «ты уверена?» почти бесполезен, модель с равной готовностью подтверждает и верное, и выдуманное. Требование ссылки полезно вдвойне: с включённым поиском вы получаете адрес для проверки, без поиска модель чаще честно признаёт, что отвечала по памяти.
Второе: открыть ссылку. Это звучит смешно, пока не вспомнить числа Tow, где битые и выдуманные адреса оказались массовым явлением, у отдельных инструментов больше половины. Открылась страница — убедитесь, что утверждение там действительно есть, а не что-то похожее. Исследование EBU показало, что приписанная не тому ссылка встречается чаще выдуманного факта.
Третье: для важного найти второй источник, не зависящий от первого. Решение о деньгах, здоровье, учёбе или документах по ответу одной нейросети не принимается; это не юридическая и не медицинская консультация, у специалистов её никто не отменял. Независимость здесь ключевое слово: два пересказа одного и того же пресс-релиза — это один источник, как бы по-разному они ни звучали. Второй источник — это документ, замер или свидетельство, которое могло бы и разойтись с первым, но не разошлось.
Есть и встречный приём: сузить вопрос заранее. Чем конкретнее спрошено — с датами, контекстом и просьбой отвечать только по проверяемому, — тем меньше модели остаётся места для достраивания. Как формулировать такие вопросы, разобрано в статье как задать вопрос нейросети.
Как спросить, чтобы ответ было легко проверить
Проверяемость ответа закладывается в сам вопрос, и разница между формулировками видна невооружённым глазом.
«Расскажи про витамин D» даёт ответ, в котором проверить нечего: гладкий текст без единого проверяемого утверждения. «Какая суточная норма витамина D для взрослого по действующим рекомендациям, с ссылкой на документ и год» даёт ответ, который проверяется за минуту: есть число, есть документ, есть год. Та же тема, та же модель, а цена ответа разная.
Рабочих приёмов три. Просить ссылку прямо в вопросе, ещё до ответа, и тогда модель с включённым поиском сразу строит ответ вокруг источников. Просить разделять: «пометь отдельно, что из этого установленный факт и что твоё предположение». Модели справляются с такой разметкой небезупречно, но заметно лучше, чем принято думать, а главное, сама просьба сбивает тон всезнайки. И просить признавать незнание («если данных нет или они противоречивы, напиши это прямо»). Формулировка снижает долю уверенных выдумок, хотя и не обнуляет её.
Для спорных тем есть отдельный приём — спросить дважды с противоположных сторон. «Какие аргументы за X» и следом «какие аргументы против X». Если во втором ответе модель спокойно разбирает то, что в первом подавала как бесспорное, вы увидели границу её уверенности. С поисковиком такой трюк тоже работает, но требует больше времени.
И общее правило, которое следует из устройства: один вопрос, одна проверяемая вещь. В вопросе «когда построили Эйфелеву башню, сколько она весит и почему её хотели снести» три факта, и ошибка в одном из них прячется за верностью двух других. По отдельности каждый проверяется мгновенно.
Что это значит для учёбы и работы
По данным Reuters Institute, которые приводит EBU, к 2025 году ИИ-ассистентами для новостей пользовались 7% онлайн-читателей, а среди людей младше 25 лет — 15%. Молодая аудитория приходит к нейросетям за ответами первой, привычки у неё ещё не застыли, и ровно сейчас решается, какие из них закрепятся. Для студента из этих цифр следует практическая развилка.
Конспект, объяснение темы, разбор ошибки в решении — задачи, где нейросеть на своём поле: материал либо устоявшийся, либо вы даёте его сами. Реферат с датами, числами и цитатами стоит на минном поле. Каждое число из ответа по памяти нужно сверить, каждую цитату найти в оригинале. Доклад о свежем событии без включённого веб-поиска не стоит и начинать.
На работе развилка та же, только цена другая. Черновик письма, сводка документа, план встречи — зона уверенного да: материал ваш, ошибку видно при чтении. Справка «как сейчас регулируется X» для решения, которое завтра уйдёт руководителю, требует обязательной проверки, потому что регулирование меняется, а модель может пересказывать прошлогоднее состояние с сегодняшней уверенностью. Юридические и медицинские вопросы стоят особняком. Ответ нейросети не является консультацией, и по важному решению он годится только как подготовка к разговору со специалистом, список вопросов к нему.
Впрочем, у всей этой осторожности есть и обратная сторона, о которой проверки говорят реже. Та же машинерия, что в 45% новостных ответов даёт сбой, в оставшихся 55% отвечает верно, мгновенно и на любом из 14 языков, а на вопросах из учебника доля верного несравнимо выше. Инструмент не обязан быть безошибочным, чтобы быть полезным; он обязан быть проверяемым. Ссылка, которая открывается, и источник, который совпадает с пересказом, и есть вся нужная проверка. У нейросети она занимает минуту, у начитанного знакомого дольше.
Вопросы и ответы
Какая нейросеть лучше отвечает на вопросы?
Единого победителя нет. В проверке EBU и BBC разрыв между худшим и остальными ассистентами был двукратным, но замеры быстро устаревают, модели обновляются. Надёжнее выбирать по задаче: для свежих фактов любая модель с включённым веб-поиском, для учёбы сильная универсальная модель. Сравнить модели на одних и тех же вопросах можно в чате GPThub, выбор под задачу разобран в гайде как выбрать модель.
Можно ли доверять ответам нейросети без проверки?
Устоявшимся знаниям из учебников в целом да. Числам, цитатам, ссылкам и всему, что случилось недавно, нет. По замеру Tow Center (март 2025) поисковые ИИ ошибались более чем в 60% ответов о происхождении текстов и почти не признавались в неуверенности.
Почему нейросеть выдумывает ответы?
Модель достраивает правдоподобный текст по статистическим связям и ни с какой базой фактов не сверяется. Там, где связи слабые (редкие факты, точные числа, свежие события), достроенное выглядит так же уверенно, как выученное. Подробный разбор механики — в статье почему нейросеть выдумывает.
Как заставить нейросеть искать ответ в интернете?
Включить режим веб-поиска, если он есть в чате, или прямо попросить искать по сети со ссылками на страницы. В чате GPThub поиск включается в окне диалога. Без поиска модель отвечает по памяти с датой отсечки, и про всё свежее честного ответа не будет.
Нейросеть заменяет поисковик?
Для части вопросов уже да: там, где раньше открывали три ссылки и собирали ответ сами, нейросеть собирает его за вас. Но поисковик показывает источники до того, как вы поверили тексту, а нейросеть только по требованию. Пока рефлекс «попроси ссылку, открой ссылку» не станет привычкой, поисковик остаётся страховкой.
Что делать, если нейросеть ответила неправильно?
Указать на ошибку в следующей реплике и дать верный источник. В рамках этого диалога модель обычно исправляется. На будущие ответы другим людям ваша поправка не влияет: модель не учится на переписке в реальном времени. Если ошибка повторяется, помогает тот же вопрос с включённым поиском или с вставленным в чат фрагментом надёжного источника.
Связанные модели


Связанные гайды
- Нейросеть для учёбы
Как готовиться с GPThub: конспект, объяснение темы, проверка себя. Честные правила — не сдавать чужой текст за свой. Модели для старта и скринов.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Похожие статьи
- ИИ-чат и поиск
Чем ИИ-чат отличается от поиска: где готовый ответ удобнее списка ссылок, где чат ошибается и когда включать веб-поиск в диалоге.
- Точный вопрос нейросети
Как задать вопрос нейросети, чтобы ответ был точным: контекст, источник фактов, право на «не знаю», когда включать поиск и как проверить ответ.
- Галлюцинации нейросети
Что такое галлюцинации нейросети, почему чат пишет правдоподобную ложь и как проверять даты, имена и ссылки перед сдачей работы.
- 50 промптов для нейросети
50 готовых промптов для нейросети: учёба, работа, тексты, картинки, поздравления. Что подставить в каждый шаблон и как понять, что ответ получился.
- Пост нейросетью
Как нейросеть пишет пост для соцсетей, что она делает по запросу и по теме, как поправить черновик и где проверить факты.
- Нейросеть для решения задач
Как нейросеть решает задачи по математике и физике, что она делает по фото условия, где ошибается в счёте и как проверить ответ до того, как сдать.
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Задать вопрос в чате GPThub
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.