
Claude Haiku 5.5: что это и чем отличается от Sonnet
Обновлено
Обозреватель: модели и релизы
Содержание
Anthropic закрыла осенний цикл обновлений: после Opus 5.5 и Sonnet 5.5 вышла младшая модель, Claude Haiku 5.5. Анонс — 7 октября 2026 года. Окно выросло до миллиона токенов, и у младшей линейки впервые появилась настройка тщательности. Собрали, что известно точно, что показывают тесты разработчика и что из этого можно открыть у нас прямо сейчас. Сразу скажем: Haiku 5.5 уже доступна в чате GPThub, рядом с ней старшие модели того же разработчика.
Что такое Claude Haiku 5.5?
Haiku — младшая модель в линейке Claude. Её берут там, где одну и ту же простую операцию нужно повторить много раз: пересказать абзац, сжать заметку до нескольких тезисов, разложить выписки по типам, достать строку из таблицы.
На вход модель принимает текст и картинки, отвечает текстом. Снимок страницы прочитает. Рисовать не умеет, в описании разработчика генерации картинок нет.
По скорости Anthropic ставит Haiku 5.5 первой в текущей линейке, если сравнивать обычный режим каждой модели. В быстром режиме (в документации — Fast Mode) её обгоняют модели Opus. Длинную работу с файлом разработчик по-прежнему отдаёт Opus 5.5, а Haiku предлагает ставить на узкий шаг внутри неё: вытащить цитату, сжать кусок, разложить пачку одинаковых записей. Наш разбор старшей модели — в статье про Claude Opus 5.5.
«Самая дешёвая, быстрая и сильная маленькая модель из тех, что мы выпускали.»
Надёжные знания у модели заканчиваются на июне 2026 года. Всё, что случилось позже, она может не знать. Окно тут не поможет: если нужного факта нет в запросе, модель его не вспомнит, а если абзац лекции уже лежит в запросе, память ей и не нужна.
Где модель доступна у самой Anthropic:
- на сайте Claude — без подписки и на платных тарифах Pro, Max, Team и Enterprise;
- в приложениях для iPhone и Android;
- в Claude API и в облаках Amazon, Google и Microsoft;
- в Claude Code.
Чем Haiku 5.5 отличается от Haiku 4.5?
Главное изменение — окно. Было 200 тысяч токенов, стало 1 миллион. Ответ может занимать до 128 тысяч токенов. Для пересказа одного абзаца разницы нет. Она появляется, когда в запрос кладут весь конспект курса или пачку документов, которые раньше просто не влезали.
Поменялась и нарезка текста на токены. Тот же абзац Haiku 5.5 режет примерно на 30% больше кусков, чем Haiku 4.5. На практике миллион новых токенов вмещает чуть меньше текста, чем можно подумать по цифре.
| Прошлая Haiku 4.5 | Claude Haiku 5.5 | |
|---|---|---|
| Окно | 200 тысяч токенов | 1 миллион токенов |
| Нарезка того же текста | как раньше | примерно на 30% больше токенов |
| Тщательность | в младшей линейке настройки не было | пять уровней, старт со среднего |
Почему окно в миллион токенов важно именно для младшей модели. Раньше короткие задачи упирались в объём: чтобы младшая модель разобрала большую выгрузку, её приходилось резать на куски, отправлять по очереди и потом склеивать ответы. На каждом стыке что-то терялось — запись, которая попала на границу двух кусков, или контекст из начала файла, которого уже нет в следующем запросе. С окном в миллион такие выгрузки чаще помещаются целиком, и резать их нужно реже.
При этом задача у модели остаётся короткой: найти, сжать, разложить. Попросить Haiku сделать по всей выгрузке выводы, где начало связано с концом, можно, но тут она, скорее всего, будет срезать углы, сложные многошаговые задачи Anthropic сама отдаёт Sonnet 5.5 и Opus 5.5. Я бы проверял так: если инструкцию к задаче можно записать одной фразой, Haiku хватит, а если нужен список из пяти пунктов, сразу берите модель постарше.
Ещё одна практическая деталь касается новой нарезки на токены. Если раньше вы прикидывали, сколько текста влезет в запрос к Haiku 4.5, для новой модели эту прикидку стоит уменьшить: тот же текст теперь занимает примерно на треть больше токенов. На больших файлах эта разница уже заметна.
Настройка тщательности появилась в младшей линейке впервые. Уровней пять: низкий, средний, высокий, повышенный (в документации xhigh) и максимальный (max). По умолчанию стоит средний. Ниже — ответ короче, выше — модель думает дольше и тратит больше ресурса на тот же вопрос. У Haiku 4.5 такой ручки не было вообще.
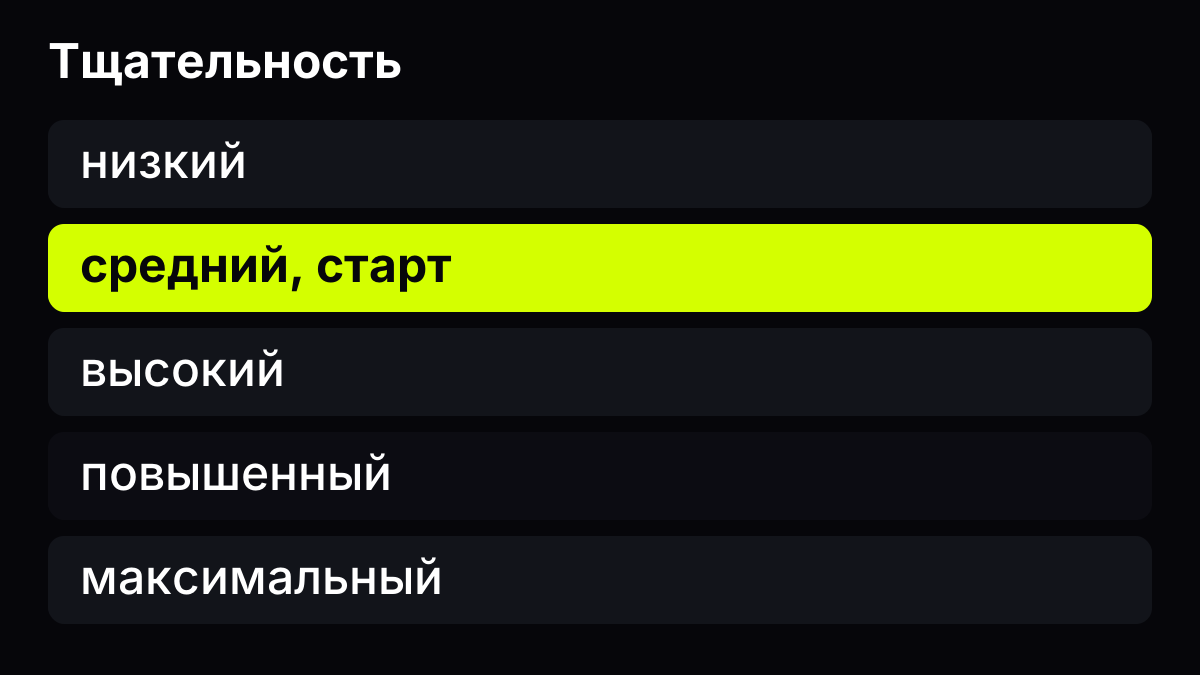
Источник: описание настройки тщательности Claude, страница открыта 7 октября 2026
Для пересказа хватает среднего уровня, и в большинстве повседневных задач менять его не придётся, если только модель не начала явно ошибаться на однотипных записях. Повышенный и максимальный стоит включать, когда ошибка дороже лишних секунд: перепутанная выписка к экзамену хуже медленного ответа. Старшей моделью максимальный уровень Haiku не делает, он просто дольше думает над задачей того же класса.
Что показывают тесты разработчика?
Таблицу собрала и опубликовала сама Anthropic. Колонка GPT-6 Luna стоит для сравнения, эта модель тоже доступна в нашем чате. Не путайте её с GPT-5.6 Luna: название похожее, модели разные.
Учтите, что в одной таблице смешаны баллы и проценты. GDPval-AA и AA-Briefcase — в баллах, остальное — в процентах. Сравнивать 1620 и 72,4% между собой бессмысленно.
| Задача | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| Профессиональные задачи, балл GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| Кейсы, балл AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| Окно компьютера OSWorld 2.1, частичный балл | 72,4% | 15,7% | 48,9% | 83,9% |
| Экзамен Humanity’s Last Exam без инструментов | 45,9% | 10,2% | — | 56,9% |
| Экзамен Humanity’s Last Exam с инструментами | 57,4% | 18,7% | — | 64,5% |
| Командная строка, Terminal-Bench 4.0 | 39,2% | 0,0% | 16,4% | 70,6% |
| Код, FrontierCode 1.1, основная шкала | 46,4% | — | 42,4% | 52,1% |
| Графики без инструментов, Chartography | 46,4% | 6,4% | 29,1% | 61,6% |
Что видно по таблице:
- Работа с компьютером. Модель сама ведёт программу и доводит задачу до конца. Для пересказа страницы эта строка мало что значит, а вот тем, кто сравнивает модели, стоит смотреть на строгие 37,1%, а не на частичные 72,4%.
- Графики. С инструментами Haiku 5.5 поднимается до 86,2%, у Haiku 4.5 в той же строке 8,8%, у Sonnet 5.5 — 90,2%. Без инструментов разрыв больше: 46,4% против 61,6%. Числа GPT-6 Luna для этой строки нет.
- Командная строка. Здесь видно, что младшая старшую не догнала: 39,2% у Haiku 5.5 против 70,6% у Sonnet 5.5. У прошлой Haiku — 0,0%, у GPT-6 Luna — 16,4%.
- Код. 46,4% у Haiku 5.5, 42,4% у GPT-6 Luna, 52,1% у Sonnet 5.5. Но у Sonnet в этой ячейке указан повышенный уровень тщательности, у Haiku уровень не назван, так что прямо сравнивать их нельзя.
В профессиональных задачах Sonnet 5.5 выше обеих: 1840 против 1620 у Haiku 5.5 и 1437 у Luna. Сложный многошаговый код Anthropic прямо оставляет за Sonnet 5.5 и Opus 5.5. The Verge и The Decoder в день выхода пересказали ту же таблицу, своих замеров у них не было.
Зачем Anthropic младшая модель рядом со старшими?
Логика у Anthropic простая: длинную работу ведёт старшая модель, а мелкие повторяющиеся шаги внутри неё она отдаёт младшей. В анонсе так и написано — Haiku 5.5 предлагают как помощника рядом с Opus 5.5 и Sonnet 5.5, а не как замену им.
Как это выглядит на практике. Допустим, Opus разбирает большую папку документов и пишет по ней отчёт. По ходу ему нужно двадцать раз сделать одно и то же: из каждого документа достать дату и сторону договора. Гонять на это старшую модель долго, а младшая сделает такой шаг быстрее, и результат вернёт старшей. Отчёт при этом всё равно собирает Opus.
Тот же подход Anthropic предлагает для запросов к базе и классификации. Разложить тысячу обращений в поддержку по темам Haiku сможет быстро. А вот почему обращений по одной теме вдруг стало вдвое больше и что с этим делать, пусть разбирает старшая модель.
Для обычного человека в чате эта схема почти незаметна, ведь модель там выбирают вручную. Но смысл тот же: если вопрос короткий и понятный, тяжёлая модель не нужна. Если вопрос длинный и с несколькими шагами, младшая будет срезать углы.
Кому хватит короткой модели?
Короткая модель хороша там, где шаг один и он повторяется:
- студенту — пересказ абзаца перед семинаром, сортировка выписок: к экзамену, к докладу, отложить;
- тому, кто разбирает длинный файл, — вытащить оттуда одну строку, пока старшая модель держит весь разбор;
- службе поддержки — короткий ответ, когда человек ждёт на линии.
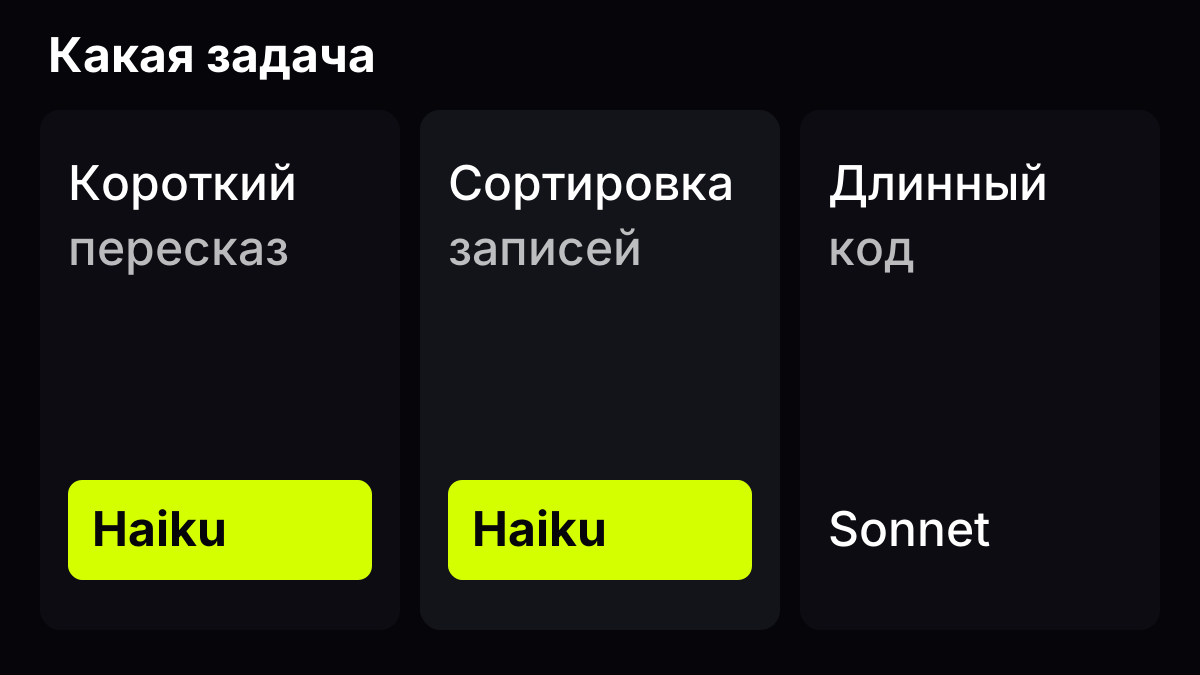
Источник: описание задач в анонсе Anthropic, 7 октября 2026
Длинный код с цепочкой шагов — задача для Sonnet. Ошибка в середине ломает всё, что дальше, и разрыв 39,2% против 70,6% в командной строке как раз про это. Связный ответ на экзаменационный билет тоже длинная работа, даже без кода: внутри спор двух авторов, оговорка и вывод.
Картинку на выходе Haiku не делает, на выходе у неё только текст. Схему в конспекте прочитает, а обложку, кадр или ролик нужно делать моделями картинок и видео.
Что открыть в чате сегодня?
Haiku 5.5 уже доступна в чате GPThub, как и Sonnet 5.5 и Opus 5.5. Рядом с ними прошлая Claude Sonnet 5.
| Что нужно | Куда открыть |
|---|---|
| Пересказ абзаца | Gemini 3.8 Flash, гость и бесплатный чат |
| Черновик подробнее | DeepSeek V4 Flash или GPT-5 Nano |
| Длинный код и большой файл | Claude Sonnet 5 или Sonnet 5.5 |
| Короткий повтор на скорость | Claude Haiku 5.5 |
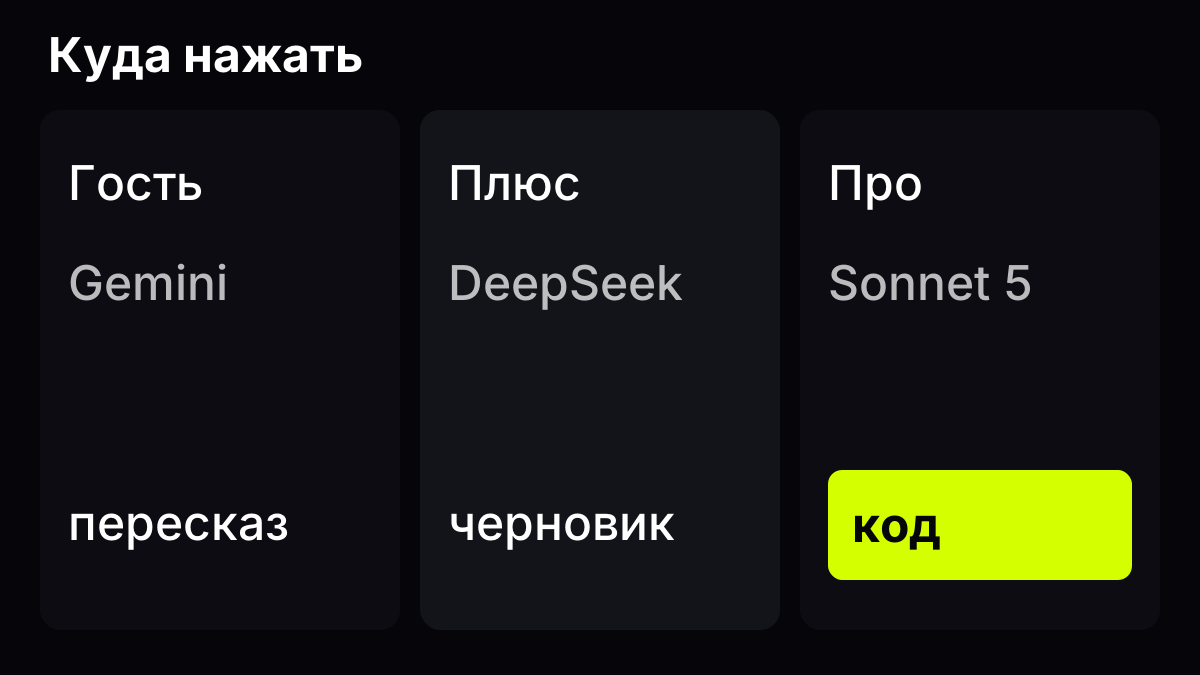
Источник: набор моделей чата GPThub, проверка 20 октября 2026
Пересказ без подписки, в том числе у гостя, делает Gemini 3.8 Flash, подробнее о ней — в отдельной статье. Для черновиков есть DeepSeek V4 Flash и GPT-5 Nano: первая берёт длинный текст без картинок, вторая читает скриншоты. Выбирайте по тому, есть ли в задаче изображение. Как выбрать модель, если задача ещё не сформулирована, — в гайде как выбрать модель, а чем Sonnet 5 выделяется в линейке Claude — в разборе Claude Sonnet 5.
Если выбирать между этими вариантами прямо сейчас, ориентируйтесь на задачу, а не на название модели. Пересказ статьи, ответ на письмо, разбор одной страницы конспекта — хватит Gemini 3.8 Flash. Длинный документ, где нужен подробный черновик, — DeepSeek V4 Flash, если картинок нет, или GPT-5 Nano, если нужно прочитать скриншот. Код на несколько файлов, разбор договора с оговорками, курсовая с проверкой каждого шага — это уже Claude Sonnet 5 или Sonnet 5.5.
На сайте Anthropic Haiku 5.5 можно выбрать отдельно, в том числе без подписки. В нашем чате она тоже уже есть, так что сравнить её с Gemini 3.8 Flash на одном пересказе можно в соседних вкладках.
Хватит ли Haiku для конспекта?
Прогон мы сделали 8 октября 2026 года на Claude Sonnet 5. Ответ Haiku не подставляли, это прогон старшей модели.
Задание было узкое: сжать в пять предложений, без вступления, две фразы лекции про круговорот воды. В лекции преподаватель трижды повторил, что испарение идёт и с суши, и с океана, и отдельно объяснил, чем конспект отличается от полной записи. Добавлять числа, даты и факты сверх этих двух фраз модели запретили.
Что получилось:
- суша и океан на месте, смысл сохранён, пять предложений;
- «трижды» модель заменила на «несколько раз»;
- от себя добавила, что преподаватель повторял фразу намеренно, чтобы студенты её запомнили;
- в конце дописала мораль, что такой подход помогает выделять главное.
Черновик опор брать можно, но рядом стоит держать исходные фразы лекции и вычёркивать всё, чего там не было: новый мотив, смягчённый повтор, готовую мораль. Для конспекта эти правки опаснее кривой фразы, ведь читатель примет их за слова преподавателя. Как такую сверку делать, мы разобрали в гайде нейросеть для учёбы, а модели для длинного кода — в гайде какая модель для кода.
Haiku 5.5 уже в чате, и то же задание можно прогнать на ней самому, на среднем и на максимальном уровне тщательности, и сравнить с ответом Sonnet 5 выше. Особенно интересно, сохранит ли младшая модель «трижды» и не начнёт ли так же дописывать мораль от себя.
Что пока неизвестно
Ряд вещей на момент выхода не проверить. Независимых замеров Haiku 5.5 в день анонса не было: The Verge и The Decoder пересказали таблицу Anthropic, а своих тестов не публиковали. Все цифры выше — данные разработчика, и сравнивать их с чужими таблицами нужно осторожно, условия запуска могут отличаться.
Не до конца понятно и то, как модель поведёт себя на русском. Отдельных результатов по русскому языку в анонсе нет, а наш прогон сделан на другой модели, на Sonnet 5. Раз Haiku 5.5 уже в чате, проще всего проверить самому: дайте ей абзац на русском и попросите пересказать его в трёх предложениях, а потом сравните с ответом Gemini 3.8 Flash.
И последнее. Про настройку тщательности известно, сколько уровней и какой стоит по умолчанию, но насколько каждый уровень замедляет ответ, в документации не расписано. Ждём первых независимых замеров, тогда и станет ясно, есть ли смысл держать Haiku на максимальном уровне или проще сразу перейти на Sonnet.
Вопросы и ответы
Что такое Claude Haiku?
Младшая модель Anthropic для короткого повтора: пересказ, сжатие, сортировка записей, один ответ по уже собранным данным. Версия 5.5 вышла 7 октября 2026. Она принимает текст и картинки и отвечает текстом. Рисование в описании модели не значится.
Чем Haiku 5.5 отличается от Sonnet?
Haiku 5.5 закрывает повторяющийся короткий шаг. В таблице разработчика от 7 октября 2026 на сложной командной строке она набирает 39,2%, Sonnet 5.5 — 70,6%. В нашем чате уже доступны обе, и Haiku 5.5, и Sonnet 5.5, так что разницу можно увидеть на своей задаче.
Есть ли Claude Haiku бесплатно?
На сайте Anthropic её можно выбрать и без платной подписки: так страница линейки говорит 7 октября 2026. В нашем чате она тоже уже доступна. Пересказ без подписки закрывает Gemini 3.8 Flash.
Можно ли вести конспект на Haiku?
Пересказ и сжатие входят в описание модели от 7 октября 2026. Наш прогон 8 октября шёл на Claude Sonnet 5, ответ Haiku мы не подменяли. Модель сохранила опору лекции и добавила мотив, которого в задании не было. Исходные фразы оставляют рядом с черновиком.
Какой уровень тщательности выбрать?
Для пересказа и сортировки хватает среднего, он стоит по умолчанию. Повышенный и максимальный имеют смысл, когда ошибка обходится дорого: например, если выписки к экзамену нельзя перепутать. Учтите, что выше уровень — дольше ответ.
Почему у одного теста два результата, 72,4% и 37,1%?
Это один и тот же тест на работу с компьютером, посчитанный двумя способами. Частичный балл засчитывает и неполный успех, строгий — только задачу, доведённую до конца. Для сравнения моделей честнее смотреть на строгий.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Нейросеть для учёбы
Как готовиться с GPThub: конспект, объяснение темы, проверка себя. Честные правила — не сдавать чужой текст за свой. Модели для старта и скринов.
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
Ещё по теме
Источники
- Anthropic, 7 октября 2026: анонс Claude Haiku 5.5
- Описание модели Haiku 5.5: окно, ответ, нарезка текста, срок знаний
- Документ с описанием модели: строгий проход и графики с инструментами
- Настройка тщательности: пять уровней и старт со среднего
- Страница линейки Haiku: где модель можно выбрать
- The Verge, 7 октября 2026: пересказ анонса
- The Decoder, 7 октября 2026: пересказ таблицы
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Открыть Claude Sonnet 5 в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.