Gemini 4 Hydrogen: что это за модель и чем она отличается от 3.8 Flash
Обозреватель: модели и релизы
Содержание
Google выкатила новую модель в середине недели и без долгих предисловий. 12 ноября 2026 года вышел Gemini 4 Hydrogen — быстрая ступень линейки, которая встаёт на место Gemini 3.8 Flash. Анонс подписал Корай Кавукчуоглу, старший вице-президент Google DeepMind. Главное в двух словах: Hydrogen дешевле флагманов Carbon и Argon, но на тестах обгоняет Argon на пару баллов и обходит собственную предшественницу по коду втрое. Разбираем, что показали, что из этого проверено снаружи и чего в анонсе не сказали.
Что Google показала 12 ноября
Пост короткий и технический. Hydrogen в нём подана как повседневная ступень: модели Carbon и Argon занимаются долгими рассуждениями на самых сложных задачах, а Hydrogen берёт всё остальное — обычный код, работу с документами, ответы в приложении.
Окно контекста — 1 млн токенов на входе и до 1 млн на выходе. Google подчёркивает, что цена одинакова по всему окну, без наценки за длинный запрос. Уровней тщательности четыре: низкий, средний, высокий и новый самый высокий. Высокий стоит по умолчанию.
Второй блок поста — скорость. Google пишет, что задачи на среднем и высоком уровне модель закрывает в 2,5 раза быстрее, чем Gemini 3.8 Flash. В партнёрских испытаниях на тяжёлых графах, SQL-запросах и рабочих сценариях с данными ускорение вышло от 2 до 2,8 раза, а расход токенов упал на 12–23%. Цифры вендорские, внешнего замера на них пока нет.
Третий блок — ошибки. Выдуманных утверждений, по словам Google, стало более чем в пять раз меньше. Когда вызов инструмента падает или поиск ничего не находит, модель, как сказано в посте, восстанавливается спокойнее. Проверить это можно только на своих задачах: у нас такой статистики нет.
Демонстрации в посте четыре. Витрина магазина с шейдером на WebGL2 и трёхмерной карточкой товара — одним запросом. Таблицы, превращённые в анимированный пиксельный холст. Колода слайдов, собранная из видео с конференции по готовому шаблону. Глобус с молниями в реальном времени из открытых данных о грозах, со звуком в браузере. Сколько попыток ушло на каждую из четырёх, в посте не сказано, а это первое, что хочется узнать: у таких демо обычно показывают лучший дубль из десятка.
Сколько Hydrogen набирает на тестах
Анонс приложил таблицу, где Hydrogen стоит рядом с Carbon и Argon. Часть цифр — из независимого индекса Artificial Analysis, часть — из собственных прогонов Google. Держим их раздельно.
| Тест | Hydrogen | Carbon | Argon |
|---|---|---|---|
| Индекс Artificial Analysis, самый высокий уровень | 54 | 59 | 50 |
| Индекс Artificial Analysis, высокий уровень | 51 | — | 50 |
| Terminal-Bench 4.1 | 57,0% | — | — |
| Terminal-Bench 4.0, замер Artificial Analysis | 54% | 65,2% | 57,1% |
| Terminal-Bench-Science 0.1, замер Google | 51,4% | — | — |
| Terminal-Bench-Science 0.1, замер Artificial Analysis | 50% | 64,8% | 52,9% |
| HLE-Diamond | 58,8% | — | — |
| Agents' Last Exam v1.1 | 71,6% | 77,4% | 69,0% |
| MKA, точность ответов | 53,4% | — | — |
| OSWorld-2.1, часть без сети | 77,6% | 81,5% | 74,7% |
| SWE-sweep | 13,5% | 9,6% | 4,3% |
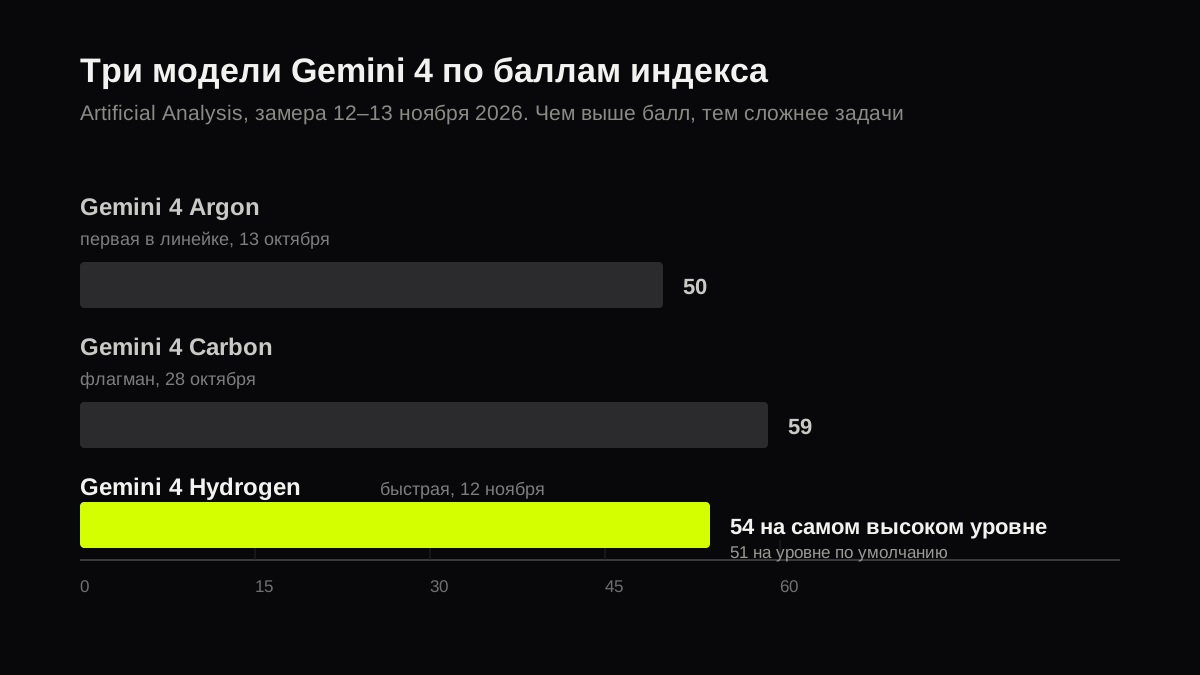
Схема GPThub по данным Artificial Analysis, 13 ноября 2026
Первое, что бросается в глаза: Hydrogen обгоняет Argon почти везде, хотя стоит ступенью ниже. На индексе Artificial Analysis разрыв небольшой — 54 против 50. На SWE-sweep разрыв уже втрое, 13,5% против 4,3%, и там же Hydrogen заметно впереди Carbon. Carbon выигрывает на длинных рассуждениях и части инженерных задач, но не на всём подряд.
Издание The Decoder прямо написало, что Argon «устарела меньше чем через четыре недели после выхода», и напомнило: двумя днями раньше Google советовала брать Argon для повседневного кода. Теперь этот совет неактуален, и Google его не повторяет.
Пятое место в Agent Arena — отдельная история. Арена оценивает открытые агентные задачи, где модель сама решает, что делать дальше. Пятое место на публичной арене для быстрой модели — хороший результат, но это голоса и задачи посетителей сервиса, а не экзамен с ключом.
Где модель проигрывает
Слабое место у Hydrogen одно и оно заметное — терминал. Artificial Analysis намерила 54% на Terminal-Bench 4.0 и 50% на Terminal-Bench-Science 0.1. У Claude Sonnet 5.5 на максимуме там 64% и 53%, у GPT-6.1 Sol — 56% и 58%. Разница не косметическая: это задачи, где модель сама ставит пакеты, правит файлы и доводит сборку до конца.
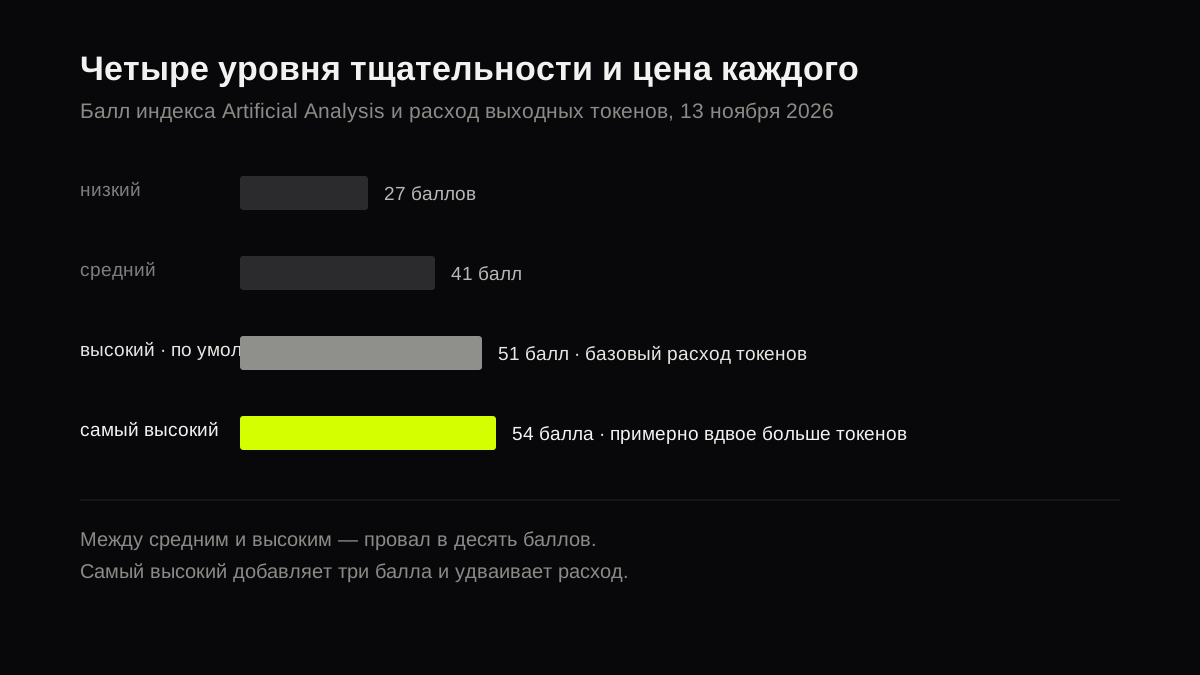
Схема GPThub по данным Artificial Analysis, 13 ноября 2026
Уровней четыре, и шкала выходит неровной. Самый высокий поднимает индекс с 51 до 54 — три балла, — но выходных токенов просит примерно вдвое больше. Средний роняет счёт до 41, низкий — до 27; медиана моделей того же класса, по Artificial Analysis, тоже 41. Между соседними ступенями обрыв в десять баллов, и почему он такой глубокий, в анонсе не объясняется.
Третье — скорость ответа. Первое слово ответа приходит через 44,9 секунды при медиане класса 14,2, скорость — 180 токенов в секунду, одна задача индекса занимает 14,3 минуты против медианных 12,9. По времени до первого ответа Hydrogen в своём классе среди самых медленных, хотя в анонсе речь шла о скорости закрытия задачи целиком.
Разница объясняется просто. Когда модель думает дольше, она выдаёт больше токенов и позже приходит к ответу. Google ставит высокий уровень по умолчанию, а он у Hydrogen забирает заметную долю времени. Отсюда и 45 секунд до первого слова ответа: на них модель уже рассуждает, а не печатает ответ.
Artificial Analysis считает ещё и многословность, и здесь картина обратная. У Hydrogen 78-е место из 79: на индекс она потратила 304 млн выходных токенов против медианы 77,3 млн, то есть пишет примерно вчетверо больше типичной модели. Замер сделан на самом высоком уровне, а он, по разбору The Decoder, требует почти вдвое больше выходных токенов, чем высокий.
На самом высоком уровне Hydrogen примерно наравне с Claude Sonnet 5.5 — 54 против 55. На высоком, том, что стоит по умолчанию, она уступает и GPT-6.1 Sol с 52 баллами на максимуме, и Claude Opus 5.5 с 52 на высоком. В таблице анонса этих моделей нет вовсе: Google сравнивает Hydrogen с собственной линейкой, и внешние числа сюда донесли только разборы Artificial Analysis.
Что изменилось в Поиске
Тем же вечером Google выложила второй пост — про Поиск. Его подписал Робби Стайн, вице-президент по продукту Search, и назвал обновление «крупнейшим обновлением модели в Поиске за всё время».
Формально Hydrogen в Поиске доступен всем пользователям во всех странах и на всех языках, которые поддерживает режим ИИ. Практически это значит, что человек, который вчера спрашивал у Поиска про ремонт стиральной машины, сегодня получает ответ от другой модели, ничего не нажимая.
Модель терпимее к длинному сбивчивому вопросу с опечатками, где человек спрашивает сразу о трёх вещах. В посте это называется «развёртыванием запроса»: вопрос режется на подтемы, по каждой идёт отдельный поиск, и наверх попадают страницы, которых в обычной выдаче не было. Картинок и сравнительных таблиц в ответах стало больше, иногда рядом появляется крошечный калькулятор под конкретную задачу — пересчёт валюты в поездке или калории в порции.
Пост про Поиск — самый потребительский из трёх. Ни одного числа в нём нет, кроме формулировки «крупнейшее обновление». Это обычная манера Google: цифры живут в техническом посте, а в продуктовом остаются обещания.
Побочный эффект от этого для чатов простой. Режим ИИ в Поиске теперь отвечает на то, с чем раньше шли в отдельное приложение: сравнить две стиральные машины, собрать план поездки, разобраться в курсе. Ответ приходит со ссылками и таблицей, и лишняя вкладка человеку не нужна. Hydrogen — быстрая модель Google, которая стоит в поисковой строке у всех пользователей, а не только у подписчиков.
Что с безопасностью агентов
Отдельная часть анонса посвящена поведению модели в агентных задачах, и здесь у Google самый плотный набор цифр.
- Перебор в агентных задачах, когда модель делает больше, чем просили, снизился до 81%.
- Недообслуживание, когда она делает меньше, — до 79%.
- Невыровненные действия и срезание углов в задачах с инструментами и кодом стали реже в 12 раз.
- На бенчмарке Gray Swan, где в страницу подсовывают скрытые инструкции, модель устойчивее в 2,3 раза.
- На внутреннем тесте честности агента — 94%. Читаемость цепочки рассуждений — 99,9%, и Google отдельно пишет про «ноль подделанных правок рассуждений на более чем 200 000 проверенных ходов».
- Ложных отказов на медицинском наборе HealthBench Pro меньше 0,4%.
Все эти числа — из внутренних тестов Google. Ни одна независимая лаборатория их пока не перепроверила, и на публичных аренах такого набора метрик нет. Читать их стоит как заявление о намерении: вендор показывает, что именно считает важным, а не то, что уже доказано.
Что любопытно, вместе с безопасностью Google чинит и обратную проблему — избыточные отказы. Модель, которая слишком часто говорит «не могу», раздражает сильнее, чем та, что иногда ошибается. Цифра в 0,4% как раз про это.
Сверить эти проценты не с чем. У Anthropic и OpenAI в анонсах другого набора агентных метрик, а на публичных аренах перебор и «срезание углов» вообще не меряют. Значит, перед нами внутренняя шкала Google: один и тот же набор тестов приложат к следующей модели, и тогда будет видно, сдвинулись ли 94% и 99,9% хоть на пункт. Пока это заявление о методике, а не о результате.
Чем Hydrogen отличается от Carbon и Argon
Линейка Gemini 4 выстроилась за месяц. Argon вышел 13 октября, Carbon — 28 октября, Hydrogen — 12 ноября. Три модели с разными задачами и разной ценой ступени.
- Argon — первая модель линейки, длинные рассуждения на сложных задачах. На индексе 50 баллов.
- Carbon — флагман для киберзащиты и самых тяжёлых инженерных задач, 59 баллов. Держит первенство там, где нужна глубина.
- Hydrogen — повседневная модель. 54 балла на максимуме, 51 на уровне по умолчанию, самая быстрая из трёх.
В Antigravity, среде Google для агентной разработки, появился оркестратор. Он переключает Carbon и Hydrogen посреди сессии: Carbon ведёт, Hydrogen работает исполнителем и проверяющим в параллельных окнах. По словам Google, такая связка почти повторяет Carbon на Terminal-Bench 4.0, тратя на 24% меньше квоты и на 19% меньше времени.
Схема понятная. Дорогую модель оставляют на планирование, дешёвую — на рутину. Примерно так же устроена работа человека с двумя помощниками: один думает, второй делает.
Про квоту. Запросы к Carbon у Google расходуются быстрее, чем к Hydrogen, — это и есть причина, по которой оркестратор вообще появился, но цену самой среды Google в посте не называет. 24% и 19% сняты на одном стенде, Terminal-Bench 4.0. Неделю обычной разработки с оркестратором и без неё Google не сравнивала, так что в реальной подписке экономия может оказаться и больше, и меньше.
Что это значит для тех, кто учится и делает картинки
Для человека с ноутбуком в России новость выглядит странно: модель вроде бы вышла, а доступа к ней напрямую нет. Тут важно разделить два вопроса. Первый — сам доступ к сервисам Google, он не изменился ни в худшую, ни в лучшую сторону. Второй — что модель умеет, и этот вопрос важнее, потому что сильная быстрая модель рано или поздно появится во всех соседних чатах.
Что меняется по сути, если смотреть на задачи. Длинное окно в 1 млн токенов означает, что в модель кладут целый учебник или большой отчёт, а не отдельный параграф. Раньше такие задачи решали модели подороже; Hydrogen переводит их в средний класс. Для студента это прежде всего работа с конспектом и с методичкой: загрузить весь семестр и спросить, где противоречие.
С картинками сложнее. Hydrogen — модель текстовая, генерация изображений остаётся на картиночных моделях вроде Nano Banana 2. Но для подготовки самой задачи под картинку, разбора референса и текста на изображении быстрая модель подходит хорошо: в анонсе отдельно отмечен рост на мультимодальном наборе MKA, 53,4%.
На HLE-Diamond, наборе сложных научных вопросов с коротким ответом, Hydrogen берёт 58,8% и лидирует в своём классе. На Chartography, где модель должна понимать графики, — 66,6%, у Carbon 72,5%, у Argon 71,6%. На SWE-sweep обратный счёт: 13,5% против 9,6% и 4,3%. Младшая модель обходит флагман на шесть баллов на одном тесте и отстаёт на шесть на другом, и общий балл индекса эту разницу прячет.
Таблица эта вендорская, и собрана она так, чтобы показать Hydrogen с лучшей стороны. Часть строк у Carbon и Argon просто пустая — там, где Hydrogen выигрывает, сравнения нет. Смотреть стоит на те строки, где числа стоят у всех трёх, и их меньше, чем кажется.
Кому это важно и что делать сейчас
Если вы пользуетесь Gemini в браузере и приложении, менять ничего не нужно: модель уже стоит в Поиске и в приложении. Бесплатные пользователи получают её через автоматический выбор модели, когда Google считает это уместным, — вручную переключить нельзя.
Если вы платите за Google AI Pro или Ultra, Hydrogen открыт в Antigravity, в Таблицах внутри Gemini и в API. Про цену ступени мы не пишем: условия у Google меняются, а тарифы сторонних API — не наша тема. Смотрите официальную страницу.
Если вам нужен Hydrogen для работы с кодом, держите в голове слабое место из раздела выше. Терминальные задачи у модели хуже, чем у Claude Sonnet 5.5 и GPT-6.1 Sol. Для правок в репозитории, тестов и сборки берите модель сильнее, для разбора документации и быстрых вопросов Hydrogen хватит с запасом.
В чате Gemini 4 Hydrogen уже доступна. Рядом открывается Gemini 3.8 Flash, которую новая модель заменяет, и Kimi K3 с DeepSeek V4 Flash — если нужна модель с длинным контекстом и другим характером ответов. Как выбрать между ними под свою задачу, разобрано в гайде как выбрать модель; про то, как Google шла к Hydrogen, — в разборах Gemini 4 Carbon и Gemini 4 Argon.
Вопросы и ответы
Чем Gemini 4 Hydrogen отличается от Gemini 3.8 Flash?
Это модель того же класса, что и 3.8 Flash, но заметно сильнее по коду и агентным задачам. На Terminal-Bench 4.1 результат вырос с 18,2% до 57%, выдуманных утверждений, по словам Google, стало более чем в пять раз меньше, а задачи на уровне по умолчанию модель закрывает в 2,5 раза быстрее. Окно контекста — 1 млн токенов на вход и до 1 млн на выход.
Hydrogen лучше Gemini 4 Argon?
На большинстве тестов — да, хотя стоит ступенью ниже. На индексе Artificial Analysis 54 балла против 50, на SWE-sweep 13,5% против 4,3%. Carbon при этом остаётся сильнее обеих на длинных рассуждениях и части инженерных задач.
Сколько уровней тщательности у модели?
Четыре: низкий, средний, высокий и самый высокий. Высокий стоит по умолчанию. Самый высокий добавляет три балла индекса, но требует примерно вдвое больше выходных токенов. Средний уровень роняет счёт до 41 балла, низкий — до 27.
Где Hydrogen слабее конкурентов?
На терминальных задачах. По замеру Artificial Analysis у неё 54% на Terminal-Bench 4.0 и 50% на Terminal-Bench-Science 0.1, у Claude Sonnet 5.5 на максимуме — 64% и 53%, у GPT-6.1 Sol — 56% и 58%.
Доступна ли Gemini 4 Hydrogen в России?
В Поиске Google модель работает у всех пользователей на всех поддерживаемых языках. В приложении бесплатные пользователи получают её автоматически, когда Google считает это уместным. Официально сервисы Google в России не работают с 2022 года, и обходить это мы не советуем.
Когда Hydrogen появится в остальных продуктах Google?
В день анонса модель открылась в Gemini API, AI Studio, Android Studio, Gemini for business и в приложении. Antigravity и Таблицы внутри Gemini — только для подписчиков Google AI Pro и Ultra. Дальнейшие сроки Google не называла.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
Похожие статьи
- Gemini 4 Carbon
28 октября 2026 Google анонсировала Gemini 4 Carbon для долгих задач и киберзащиты. Тесты, порядок доступа и сравнение с Argon и Opus 5.5.
- Что такое Gemini 4 Argon
Google открыла Gemini 4 Argon 13 октября 2026. Что подтверждено в посте и в документе модели, и чего в чате пока нет.
- Gemini 3.8 Flash
Gemini 3.8 Flash вышла 2 сентября 2026: окно в миллион токенов, картинки, звук и видео на входе. Что показывают тесты Google и независимые замеры.
- Claude Fable 5.2
9 ноября 2026 Anthropic выпустила Claude Fable 5.2 и Mythos 5.2. Цена токена ниже на 20%, а цена задачи зависит от уровня усилия. Что показали тесты.
- Claude и форма полиции
Anthropic рассказала, как Claude во внутреннем тесте отправил в полицию Филадельфии выдуманное сообщение. Что ещё было в отчёте и что поменялось.
- Что такое FLUX 3 Image Klein
Black Forest Labs 15 октября 2026 открыла веса FLUX 3 Image Klein. Размер, память видеокарты и условия лицензии.
Источники
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Открыть Gemini 4 Hydrogen в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.