
Claude Sonnet 5.5: чем отличается от Sonnet 5 и Opus 5.5
Обозреватель: модели и релизы
Содержание
28 сентября 2026 Anthropic выпустил Claude Sonnet 5.5, вторую модель семьи 5.5 после Opus 5.5 от 22 сентября. Для ясной задачи с понятной целью, правки, документа или аккуратного куска кода это их шаг вперёд относительно Sonnet 5, а открытое суждение без готового списка шагов они оставляют Opus. В прогонах Anthropic она быстрее больше чем на 30 процентов и на типичной задаче до 30 процентов дешевле, потому что ответ короче, а сетка цен у разработчика та же. В чате GPThub на 6 октября 2026 этой модели нет: открыт Claude Sonnet 5 на тарифах «Про» и «Ультра».
Что такое Claude Sonnet 5.5?
Claude Sonnet 5.5 — средняя ступень линейки Anthropic. Ниже неё по задумке должна сесть лёгкая Haiku, выше стоит Opus. Сама компания в анонсе от 28 сентября 2026 называет новинку ясным шагом вперёд относительно Claude Sonnet 5. Предыдущая ступень, Sonnet 5, вышла 30 июня 2026.
«Ясный шаг вперёд относительно Claude Sonnet 5.»
Смысл ступени проще, чем линейка имён. Sonnet берут, когда цель уже ясна: поправить ошибку, собрать документ, слайд или таблицу, довести черновик. Opus берут, когда цель ещё открытая и модели самой приходится решать, что здесь важно. Так написано на странице выпуска, и дальше в этом тексте развилка остаётся той же.
Окно контекста — это сколько текста модель ещё держит вместе, пока отвечает. Не память на семестр и не «она прочитала весь курс». Это размер одного разговора и вложенных файлов. У Sonnet 5.5 окно — 1 миллион токенов. Документация, открытая 6 октября 2026, переводит миллион примерно в 555 тысяч слов или в 2,5 миллиона знаков Юникода. Один ответ в обычном режиме ограничен 128 тысячами токенов. У Opus 5.5 в той же документации окно и предел ответа такие же. У Sonnet 5 окно, по независимому разбору Artificial Analysis от 28 сентября, тоже не менялось. Длина разговора модели не различает.
На вход она принимает текст и картинки, на выход отдаёт текст. Снимок схемы или страницы тетради приложить можно. Нарисовать картинку эта модель не умеет: документация прямо пишет, что результатом бывает только текст.
Надёжные знания обрываются на июне 2026. Событие после этой даты она может не помнить как факт обучения, даже если разговор длинный. Снимать модель с линии обещают не раньше 28 сентября 2027. На 6 октября 2026 в документации статус всё ещё действующий.
Уровень тщательности — это насколько долго модель думает, прежде чем ответить. В документации пять ступеней: низкий, средний, высокий, сверхвысокий и максимальный. Английские подписи там low, medium, high, xhigh и max. Дальше в тексте только русские имена. В приложениях Claude и в программе Claude Code по умолчанию стоит средний уровень. На платформе для разработчиков по умолчанию высокий. Чем выше ступень, тем обычно длиннее ответ и тем дороже одна задача. Выше не значит «всегда лучше балл»: на одном тесте кода максимальный уровень набрал меньше сверхвысокого. Это разобрано ниже, в разделе про цифры.
Защита описана узко, и это описание разработчика, не совет по безопасности или по биологии. Возможности в кибербезопасности Anthropic сравнивает с Opus 5 и впервые ставит на Sonnet такую же защиту, как на самые сильные свои модели. Обычную разработку это не перекрывает. Более рискованный запрос такого рода заметно переключается на Sonnet 5. По биологии защита та же, что была у Sonnet 5, и тоже узкая: учебный и клинический вопрос по их словам не цель, отдельный микробиологический запрос может попасть под флаг по ошибке.
На автоматической проверке поведения, около 1850 сценариев, Sonnet 5.5 на большинстве мер не хуже Sonnet 5. По всей проверке Opus 5.5 всё ещё чуть сильнее. Это их внутренний экзамен, не независимый.
Для разработчика, который уже вызывает Sonnet 5 из программы, в документации перечислены пять несовместимых изменений. Памятка лежит отдельно, и этот обзор её не пересказывает. Искать модель по имени claude-sonnet-5-5.
Скачивать здесь нечего. Это сервис с именем модели, не файл весов и не программа, которую ставят на ноутбук.
Чем Sonnet 5.5 отличается от Sonnet 5?
Короткий ответ: это не новое окно и не новая сетка цен. Это более короткие ответы, более быстрый отклик и заметно более высокий балл на ясных задачах, особенно когда правят программу. Sonnet 5 при этом никуда не делся. На части рискованных запросов ответ по-прежнему уходит именно к нему.
Скорость Anthropic оценивает так: Sonnet 5.5 пишет ответ больше чем на 30 процентов быстрее. Цена одной задачи в их прогонах до 30 процентов ниже. Причина названа прямо: токенов на ту же работу нужно меньше. Прайс за единицу текста они не меняли. Сколько это в долларах, в этот текст не входит. Для читателя важен знак: типичная задача у разработчика стала дешевле не из-за скидки в прайсе, а из-за того, что модель меньше пишет.
Lucas Ropek в TechCrunch в тот же день, 28 сентября 2026, пересказывает ту же пару: быстрее и токены сгорают медленнее. Средняя ступень, повседневный код и офисные документы. Отдельной даты для Haiku у него тоже нет. Его догадку, почему на одном тесте Sonnet обходит Opus, ниже не берём: страница Anthropic объясняет соседний провал иначе.
Что такое уровень тщательности?
Пять ступеней легко перепутать с «пятью разными моделями». Модель одна. Меняется, сколько она успевает проверить, прежде чем остановиться.
На низком и среднем уровне Anthropic пишет, что на нескольких тестах Sonnet 5.5 обгоняет лучший результат Sonnet 5, а задача обходится примерно в десять раз дешевле. На Terminal-Bench при среднем уровне, том самом, который стоит в приложениях и в Claude Code, формулировка жёстче: меньше чем десятая доля стоимости лучшего результата Sonnet 5. На CursorBench то же обещано уже для низкого уровня. На тесте длинной офисной работы AA-Briefcase при среднем уровне речь идёт примерно об одной девятой.
На высоком уровне, который стоит на платформе для разработчиков, сравнение другое. Тест FrontierCode смотрит, приняли бы правку кода без ручных доделок. При высоком уровне Sonnet 5.5 на 10 пунктов выше Sonnet 5 с той же настройкой, а стоимость задачи около одной пятнадцатой. Сами проценты высокого уровня в таблице анонса не напечатаны. Подставлять вместо них цифры максимального или сверхвысокого уровня нельзя: это другие точки.
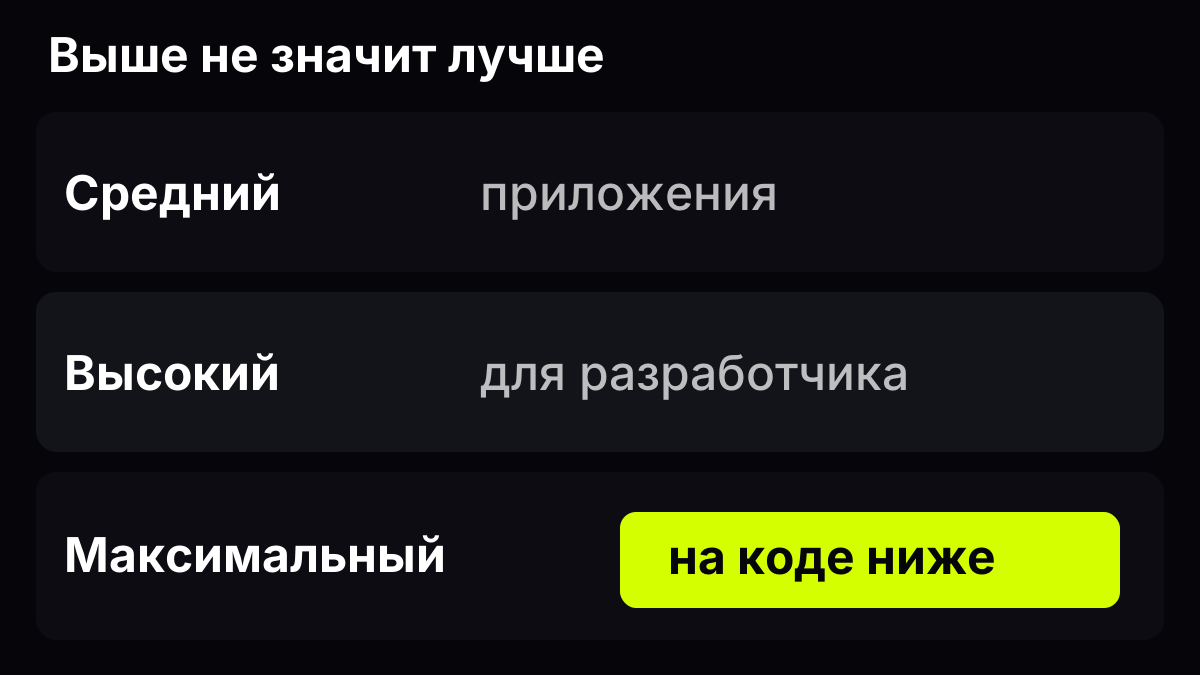
Источник: страница Anthropic о Claude Sonnet 5.5, 28 сентября 2026. На схеме нет процентов: абсолютный балл высокого уровня в таблице не опубликован
Практический вывод для человека, а не для счёта. Если задача бытовая и цель ясна, средний уровень у этой модели по словам разработчика уже обгоняет лучшее, что умел Sonnet 5. Гнать максимум «на всякий случай» на тесте кода как раз портит балл. Это разобрано в следующем разделе.
Отличие, которого нет. Окно в миллион токенов было и у Sonnet 5. Картинки на входе тоже не новость этого дня: документация Sonnet 5.5 просто подтверждает пару «текст и картинки на входе, текст на выходе». Новость в том, как модель тратит это окно, а не в том, что окно выросло.
Sonnet 5.5 или Opus 5.5?
Вопрос из подсказок поиска звучит как выбор победителя. Страница выпуска устроена иначе. Sonnet 5.5 там назван более быстрым и более дешёвым дополнением к Opus 5.5, не заменой.
Opus остаётся моделью сложной открытой работы, где нужно удерживать суждение. Sonnet сильнее всего там, где рамка уже задана: починить ошибку, собрать опрятный документ, слайд или таблицу. На своих тестах Anthropic прямо пишет, что даже когда баллы Sonnet 5.5 на максимальном уровне где-то сравнимы с Opus, в живой работе и у них, и у внешних проверяющих Opus яснее сильнее на открытой задаче.
| Что лежит на столе | Куда это относит Anthropic | Что было открыто 6 октября 2026 |
|---|---|---|
| Правка с понятной целью, документ, слайд, таблица | Sonnet 5.5 | в чате этой модели нет, рядом Sonnet 5 на «Про» и «Ультра» |
| Вопрос без списка шагов, где надо самому решить, что важно | Opus 5.5 | в чате этой модели нет |
| Короткий черновик, если приложения Anthropic под рукой нет | не их развилка этого дня | Sonnet 5 на «Про» и «Ультра» |
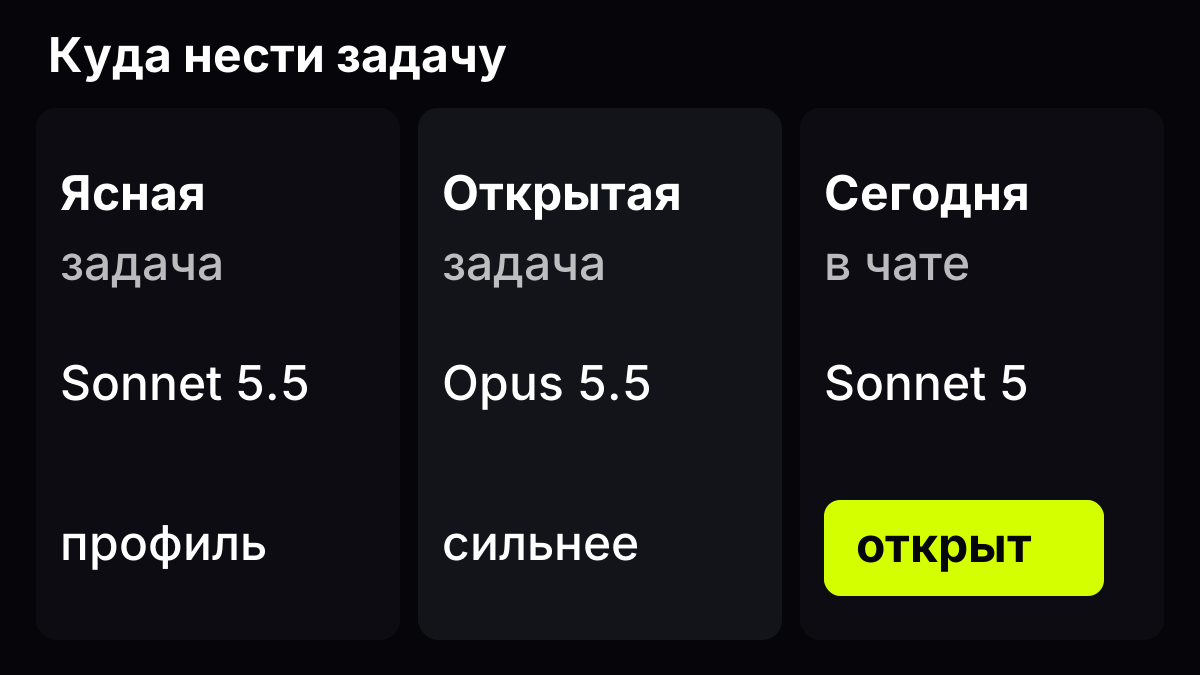
Источник: страница Anthropic о Claude Sonnet 5.5, 28 сентября 2026, и проверка набора чата 6 октября 2026
Цифры эту развилку не отменяют, но и не превращают в один рейтинг. На тесте офисной работы GDPval-AA, 44 профессии и девять отраслей, Sonnet 5.5 набрал 1844, Opus 5.5 — 1846, Sonnet 5 — 1449. До прошлой средней ступени 395 пунктов. До Opus два пункта. Страница анонса в прозе округляет 395 до «около 400» и сама называет отставание от Opus двумя пунктами. В таблице оставляем 1846 против 1844, без округления и без попытки объявить двойку ничьей.
На CursorBench, где задания взяты из настоящих сессий редактора кода, 55,5 процента против 57,8 у Opus и 34,1 у Sonnet 5. До Opus 2,3 пункта, до прошлой модели 21,4. На тесте компьютера OSWorld 2.1 с частичным зачётом 80,1 процента против 81,8 и 57,0: от Opus 1,7 пункта, от Sonnet 5 23,1. На узнавании графиков без инструментов, тесте Chartography, 61,6 процента против 64,4 и 15,6. Здесь скачок от старого Sonnet огромный, 46 пунктов, а до Opus остаётся 2,8.
Обратная сторона есть, и она про код, который ещё надо собрать целиком. SWE-Bench Pro в системной карте от 28 сентября: 81,3 процента у Sonnet 5.5, 63,2 у Sonnet 5 и 89,9 у Opus 5.5. От прошлой модели 18,1 пункта вверх. До Opus 8,6 пункта вниз. Если работа похожа на большой набор чужих задач по программированию, а не на одну ясную правку, таблица разработчика всё ещё смотрит в сторону Opus.
Terminal-Bench 4.0, тест длинных профессиональных задач в командной строке, выглядит наоборот: 70,6 процента у Sonnet 5.5, 10,3 у Sonnet 5 и 66,4 у Opus. Сноска к ячейке Opus говорит, что 66,4 сняты на сверхвысоком уровне и это лучший результат Opus на этом тесте. У ячейки 70,6 уровень не подписан. Разница с Opus 4,2 пункта, с Sonnet 5 60,3. Сравнивать их как одну и ту же ступень тщательности нельзя, пока у Sonnet подписи нет.
Как выбрать без формулы «одна лучше всех», разобрано в гайде «Как выбрать модель». Соседний разбор, где модели сравнивают на одной и той же работе, лежит в гайде сравнения на практике.
Что показывают публичные тесты?
Ниже одна таблица, и она целиком со страницы Anthropic от 28 сентября 2026. Колонку чужой модели, которую разработчик поставил рядом для своего анонса, сюда не переносим: вопрос читателя про три модели Claude. Проценты высокого уровня на FrontierCode в таблицу не входят, потому что их там нет. Есть обещание «на 10 пунктов выше при той же настройке» и есть две другие точки, максимальная и сверхвысокая.
| Тест | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% на сверхвысоком |
| FrontierCode 1.1, основной набор | 46,2% максимальный и 52,1% сверхвысокий | 42,4%, уровень не подписан | 54,4% |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 |
| Humanity's Last Exam, с инструментами | 64,5% | 54,9% | 67,7% |
| Humanity's Last Exam, без инструментов | 56,9% | 43,1% | 64,4% |
| OSWorld 2.1, частичный зачёт | 80,1% | 57,0% | 81,8% |
| Chartography, без инструментов | 61,6% | 15,6% | 64,4% |
| SWE-Bench Pro | 81,3% | 63,2% | 89,9% |
Где Sonnet 5.5 впереди, а где нет?
Впереди относительно Sonnet 5 модель почти везде в этой таблице. Самый тихий рост — FrontierCode, если смотреть только на максимальную точку 46,2 против неподписанных 42,4. Самый громкий — Terminal-Bench, 70,6 против 10,3, и Chartography, 61,6 против 15,6. Честная оговорка к Terminal-Bench уже сказана: уровень тщательности у 70,6 не подписан, а 66,4 у Opus сняты на сверхвысоком.
От Opus модель отстаёт чаще, чем обгоняет. Обгон в этой таблице по сути один, Terminal-Bench, и он с дыркой в подписи. На офисных баллах разрыв то два пункта, то одиннадцать: у AA-Briefcase 1811 против 1822. На экзамене Humanity's Last Exam с инструментами 64,5 против 67,7, разрыв 3,2 пункта. Без инструментов 56,9 против 64,4, разрыв уже 7,5. Прятать более слабую строку нельзя: без поиска и без исполнения кода отставание от Opus шире. SWE-Bench Pro добавляет к этому 8,6 пункта в пользу Opus.
Почему максимальный уровень набрал меньше?
На FrontierCode сверхвысокий уровень даёт 52,1 процента, максимальный — 46,2. Разница 5,9 пункта не в ту сторону, в которую ждёшь от слова «максимальный». Сноска Anthropic объясняет механику. Тест штрафует правку, которая вышла за рамку задачи, даже если правка сама по себе толковая. На максимальном уровне модель чаще запускала шаг рецензии кода и дробила его на много помощников. В двух случаях, которые разобрала компания Cognition, это кончилось обрывом по времени или лишней правкой мимо задания, и балл упал.
Отсюда бытовой вывод, без инструкции «поставьте такую-то галочку». Если работа измеряется как «приняли бы это без ручных доделок», самый верхний уровень у этой модели на опубликованном тесте слабее соседнего. Для открытого суждения разработчик всё равно зовёт Opus, а не максимальный Sonnet.
Две ячейки офисной работы, GDPval-AA и AA-Briefcase, Artificial Analysis снял ещё на версии до публичного выпуска. У той версии была ошибка структурированного ответа. Anthropic пишет, что ошибка могла занизить балл и что её уже починили. Значит 1844 и 1811 не стоит читать как потолок. Значит их не стоит и выкидывать: на дату статьи других опубликованных чисел этих двух тестов нет.
Что насчитал независимый разбор?
Artificial Analysis 28 сентября 2026 поставил Sonnet 5.5 на максимальном уровне на 56 баллов своего индекса. Это на 18 выше Sonnet 5 и на 2 ниже Opus 5.5, тоже на максимальном уровне. Живая таблица лидеров с тех пор могла сдвинуться, и 6 октября её заново не переснимали. Берётся дата их статьи.
Их Terminal-Bench 4.0 — 64 процента. Это на 50 пунктов выше Sonnet 5 на максимальном уровне и чуть выше 60 процентов у Opus 5.5. Рядом не стоит ячейка 70,6 из анонса. Другой стенд даёт другое число, даже если имя теста совпадает. Кто смешает 64 и 70,6 в одной колонке, получит аккуратную таблицу и неверный вывод.
Там же видна цена максимального уровня, и она спорит с фразой «до 30 процентов дешевле». На максимальном уровне Sonnet 5.5 тратит около 193 тысяч токенов ответа на одну задачу их индекса. Это примерно на 60 процентов больше, чем у Opus 5.5 или у Sonnet 5 на том же максимальном уровне. Стоимость одной такой задачи выходит примерно наполовину выше, чем у Sonnet 5, то есть около полутора раз. Доллар за задачу в текст не берём. Берём направление: на максимальном уровне независимый счёт дороже, на низком и среднем собственный счёт разработчика дешевле.
Оба утверждения могут быть правдой одновременно, потому что это не один и тот же прогон. «До 30 процентов дешевле» у Anthropic сказано про большинство работ и подкреплено графиками низкого и среднего уровня. «Наполовину дороже» у Artificial Analysis сказано про максимальный уровень, где модель пишет очень много. Выбирать уровень важнее, чем выбирать лозунг.
По фактам независимый разбор Sonnet тоже не равняет с Opus. В их тесте AA-Omniscience доля верных фактов 54 процента против 66 у Opus. Доля выдуманных ответов 47 процентов против 59. Здесь меньше значит лучше: Sonnet реже выдумывает и реже знает. На их замере Humanity's Last Exam и на научном коде SciCode Sonnet примерно на 6 пунктов ниже Opus. Эти 6 пунктов не равенство и не цифра 3,2 из таблицы с инструментами на странице Anthropic. Другой замер, другая подпись.
Запасная модель в их индексе сработала примерно на 0,1 процента задач, в основном на Terminal-Bench, и всегда это был откат к Sonnet 5. Системная карта даёт другое число на своём прогоне того же теста: 70,6 процента сняты с включённой защитой, на запасную модель ушло 1,2 процента запросов. 0,1 и 1,2 не усредняем. Это два разных знаменателя.
Ошибку версии до публичного выпуска Artificial Analysis тоже отмечает. Ждут, что на публичной сборке балл чуть вырастет или почти не изменится, и собираются переснять замер. Пока пересъёма в их статье нет.
Что ответил Sonnet 5 на учебной ошибке?
Sonnet 5.5 в чате 6 октября 2026 не открывалась, поэтому прогон сделан на Claude Sonnet 5, тарифе «Ультра», в тот же день. Это не замер новой модели. Это проверка того, что реально можно нажать, на одной учебной дыре.
Задача была короткая. Функция должна вернуть второе по величине различное число. На списке 4, 9, 9, 2 она возвращала 9, хотя верный ответ 4. Просили объяснить, почему так выходит, и не писать исправление.
Ответ Claude Sonnet 5:
Ошибка в условии
elif second is None or n > second: когда встречается число, равное текущемуbest(как вторая 9), оно не проходит первое условие (n > bestложно, т.к. равно), но проходитelif, потому чтоn > second, гдеsecondещёNone. В итоге дубликатbestзаписывается вsecond, хотя он не является отдельным (другим) значением. Нужно отдельно проверять, чтоn!=best, прежде чем присваивать его вsecond, иначе повторяющееся максимальное число принимается за «второе по величине».
Место поломки она назвала верно. Вторая девятка равна лучшему числу, в первое условие не проходит и проваливается в следующее, где её записывают как «вторую». Проверка «это не то же самое лучшее число» как раз не дала бы записать дубль.
Ход списка она описала неверно. После первой девятки второе место уже не пустое. Четвёрка успела побыть лучшим числом, а когда пришла девятка, четвёрка сдвинулась на ступень ниже. Вторая девятка больше этой четвёрки, поэтому условие «записать, если больше второго» её пускает. Пустым второе место было раньше, до первой девятки, а не в момент дубля. Уверенная фраза «где second ещё None» звучит как трассировка, но трассировкой не является.
Для учёбы это полезнее гладкого «модель нашла баг». Направление починки годное, рассказ о том, в какой момент переменная была пустой, нет. Такой ответ нельзя сдавать как свой разбор, пока список не пройден руками. Где текст модели помогает готовиться и где его нельзя выдавать за свою работу, написано в гайде «Нейросеть для учёбы». Как вообще выбирать модель под код, а не под общий разговор, разобрано в гайде «Какая модель для кода».
Предыдущая ступень, которую как раз можно открыть, разобрана отдельно в статье про Claude Sonnet 5. Старшая модель семьи, которой в чате в этот день тоже не было, разобрана в статье про Claude Opus 5.5.
Можно ли открыть Sonnet 5.5 в чате?
На 6 октября 2026 нет. В наборе чата нет ни Claude Sonnet 5.5, ни Claude Opus 5.5. Есть Claude Sonnet 5, и только на тарифах «Про» и «Ультра». У гостя, на бесплатном тарифе и на «Плюс» этой строки нет. Карточка, которая открывается, — Claude Sonnet 5.
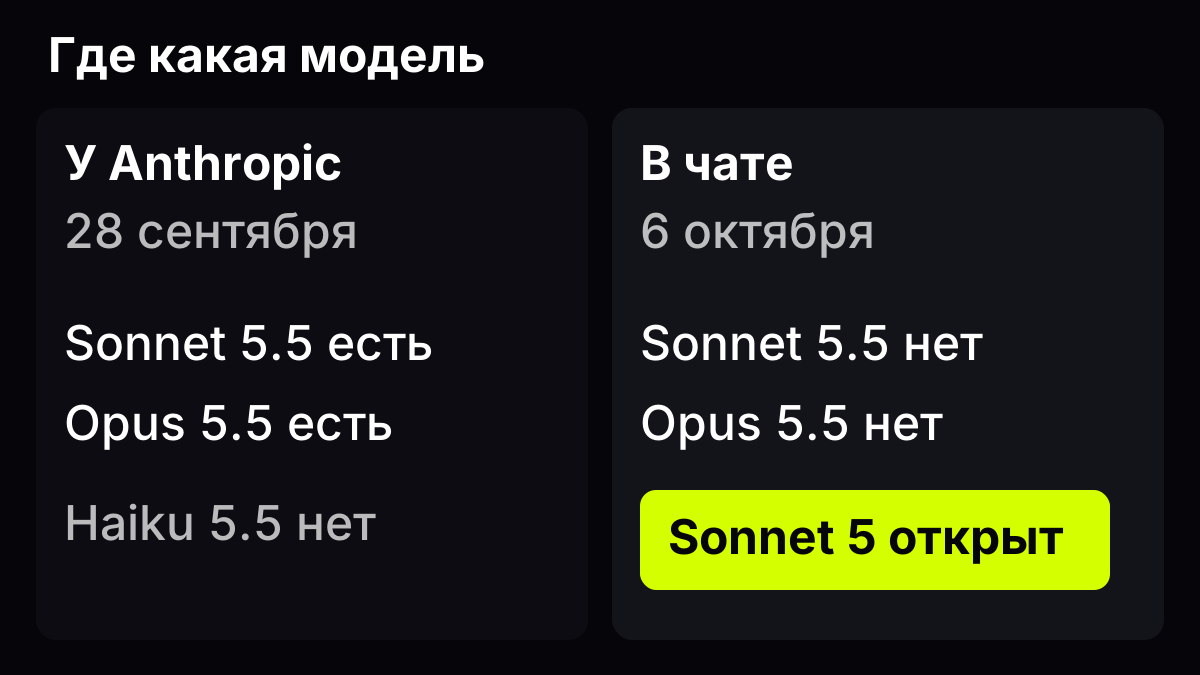
Источник: страница выпуска Anthropic, 28 сентября 2026, и проверка набора чата 6 октября 2026. Haiku 5.5 нет ни там, ни там
Проверка в этот день смотрела список моделей чата, а не только витрину карточек. Карточек меньше, чем моделей в чате, но здесь расхождения нет: новой модели нет и в кнопке чата. Писать, что она «появится на следующей неделе», было бы обещанием без даты. На странице Anthropic даты для чата нет.
Что делать с задачей, которая уже лежит на столе, собрано без инструкции и без готового запроса.
| Что нужно | Куда на 6 октября 2026 |
|---|---|
| Ясная правка или документ, и приложения Anthropic под рукой нет | Claude Sonnet 5 на «Про» и «Ультра» |
| Открытое суждение, которое страница выпуска отдаёт Opus 5.5 | в чате этой модели нет, ждать её как уже вышедшую кнопку нельзя |
| Короткий вопрос не про код | развилка Sonnet и Opus его не решает, смотреть гайд выбора модели |
| Картинка, которую надо нарисовать | не эта модель: она текст по картинке читает, сама не рисует |
В чате GPThub на эту дату путь один: открыть Sonnet 5, если тариф «Про» или «Ультра», и помнить, что прогон выше был про старую ступень. Новый Sonnet 5.5 в этот день нажать было нельзя, и обзор не делает вид, что было можно.
Вышел ли Haiku 5.5?
Нет, если смотреть на 6 октября 2026. В анонсе Sonnet 5.5 лёгкая модель обещана «в ближайшие недели» и описана как вариант для большого потока и чувствительной к цене работы. Твёрдого дня нет. TechCrunch в день выпуска пересказывает то же: планируют, даты не дают.
Обзор документации Sonnet 5.5, открытый 6 октября 2026, в таблице сравнения всё ещё показывает Haiku 4.5, не 5.5. Пока в этой таблице не появилось новое имя, обещание остаётся обещанием. Путать его с уже вышедшими Sonnet 5.5 и Opus 5.5 не стоит: у тех двух есть день, идентификатор и страница.
Для читателя, которому нужна лёгкая и быстрая модель «прямо сейчас», Haiku 5.5 не кандидат этого обзора. Кандидат из семьи Claude, которого можно открыть на названных тарифах, по-прежнему Sonnet 5.
Вопросы и ответы
Что такое Claude Sonnet 5.5?
Средняя модель Anthropic, вышла 28 сентября 2026, второй после Opus 5.5 от 22 сентября. Сильнее всего на ясной задаче: правка, документ, слайд, таблица. Открытое суждение разработчик оставляет Opus. Окно — миллион токенов, ответ до 128 тысяч, знания до июня 2026.
Claude Sonnet 5.5 или Opus 5.5?
Если цель уже ясна, страница выпуска указывает на Sonnet 5.5. Если шаги ещё надо придумать и удержать суждение, указывает на Opus 5.5. На офисном тесте GDPval-AA между ними два пункта, 1844 против 1846. На SWE-Bench Pro Opus впереди на 8,6 пункта, 89,9 против 81,3. Одного победителя таблица не даёт.
Чем Sonnet 5.5 отличается от Sonnet 5?
Окно то же. Сетка цен у разработчика та же, типичная задача до 30 процентов дешевле из-за более короткого ответа, скорость больше чем на 30 процентов. На Terminal-Bench в таблице анонса 70,6 процента против 10,3. На максимальном уровне независимый разбор видит задачу примерно наполовину дороже, чем у Sonnet 5: уровень тщательности там другой.
Claude Sonnet 5.5 бесплатно?
В чате на бесплатном тарифе, у гостя и на «Плюс» её нет и на 6 октября 2026 не было. Claude Sonnet 5 открыт на «Про» и «Ультра». Сколько стоит чужой интерфейс разработчика, этот текст не пересказывает.
Можно ли скачать Claude Sonnet 5.5?
Нет. Это модель в сервисе, не файл и не набор весов. В документации она вызывается по имени claude-sonnet-5-5. Ставить её себе на компьютер вместо чата этот обзор не предлагает.
Что меняет уровень тщательности?
Пять ступеней: низкий, средний, высокий, сверхвысокий, максимальный. В приложениях и в Claude Code обычно средний, у разработчика на платформе высокий. На тесте FrontierCode максимальный балл ниже сверхвысокого: 46,2 процента против 52,1. Выше не значит лучше на каждом тесте.
Связанные модели

Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, бесплатный тариф, «Плюс» или «Про». Короткая схема выбора и примеры под код, письма и разбор.
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash на бесплатном, «Плюс» (DeepSeek, Nano, Luna, GLM, Kimi) или «Про» (Claude, Terra, Grok 4.5).
Ещё по теме
Источники
- Anthropic, 28 сентября 2026: страница Claude Sonnet 5.5
- Документация Anthropic: обзор Claude Sonnet 5.5
- Документация Anthropic: обзор Claude Opus 5.5
- Системная карта Claude Sonnet 5.5
- Artificial Analysis, 28 сентября 2026: разбор Claude Sonnet 5.5
- TechCrunch, Lucas Ropek, 28 сентября 2026
- Системная карта Claude Sonnet 5, 30 июня 2026
- Anthropic, 30 июня 2026: новость о Claude Sonnet 5
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Открыть Claude Sonnet 5 в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.