
Как создать говорящего аватара: лицо, голос и текст
Обозреватель: как устроен ИИ
Содержание
18 декабря 2025 года Google объявил, что говорящие персонажи в Google Vids переведены на видеомодель Veo 3.1. В анонсе обещали более выразительную мимику, более плавную синхронизацию губ и более устойчивый кадр. Для человека, который ищет, как создать говорящего аватара, это звучит как одна кнопка. Между строкой сценария и готовым клипом лежат три разные работы — и каждую закрывает свой шаг. Ниже — то, что написано в справках и анонсах, открытых 2 ноября 2026 года. Русский в списке языков аватаров Vids к этой дате есть. В декабрьском анонсе его ещё не называли.
Чем это не похоже на видеозвонок
Привычная картина — человек сидит перед камерой и читает текст с суфлёра. Кажется, что нейросеть делает то же самое, только вместо актёра подставляет картинку. Камера так и устроена и пишет физическое движение губ, которое уже совпало со звуком в момент съёмки. У говорящего аватара звук часто собирают отдельно, а рот дорисовывают под готовую дорожку.
Правильная аналогия ближе к дубляжу без новой съёмки: есть исходное лицо — фотография, заранее снятый цикл или персонаж из библиотеки — и есть аудио, записанное или синтезированное. Сеть подгоняет движение рта и часть мимики под звук. Качество зависит от того, насколько удачно связаны эти два потока.
Рассинхрон выглядит так: губы открываются раньше слова, голос меняет тембр между фразами, глаза не моргают там, где ждёшь паузу, а зритель редко формулирует претензию технически и говорит, что «актёр деревянный».
Три звена одной цепочки
Сценарий — текст, который должен прозвучать дословно или почти дословно. Сюда же относятся паузы, ударения и длина фраз. Короткие предложения легче уложить в губы, длинный монолог чаще ломается на стыке слов.
Голос — звуковая дорожка, которую получают записью диктора, синтезом из текста или сборкой тембра по образцу. Тембр и скорость задают ритм кадра. Ускоренная речь оставляет модели меньше времени на широкие гласные, и рот начинает «жевать».
Лицо — источник картинки: готовый персонаж сервиса, портрет из конструктора, загруженное фото или короткий клип, с которого сняли цифрового двойника. От исходника зависит, насколько правдоподобно двигаются губы и держится ли лицо между кадрами.
Последний стык в инженерных текстах называют синхронизацией губ. На схеме это одна стрелка, внутри — отдельная модель или отдельный режим видеогенератора.
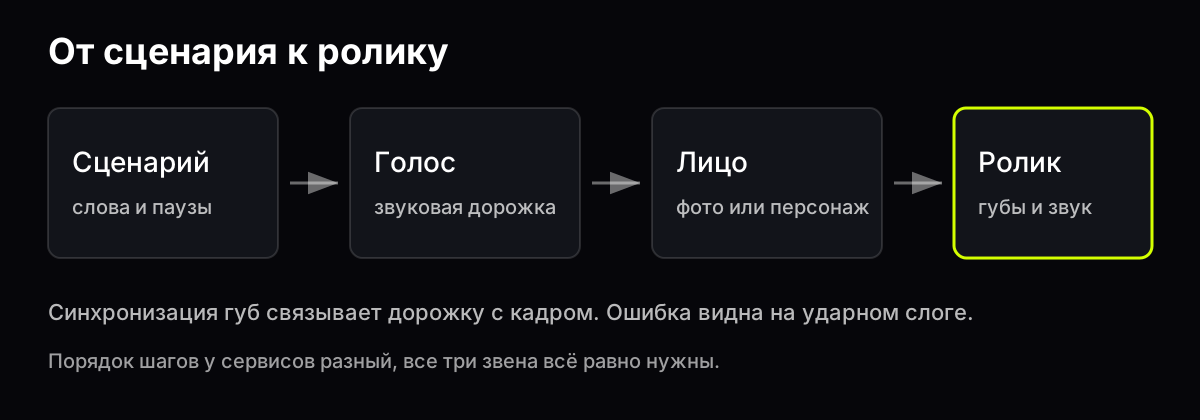
Схема цепочки, иллюстрация GPThub
Порядок шагов у продуктов разный, и это стоит держать в голове до первой генерации. В Google Vids персонажа выбирают, сценарий вводят сразу, клип собирается целиком и вставляется в монтаж. В Meta AI и Vibes лицо уже есть на картинке или в коротком видео, а синхронизацию губ добавляют следом — по тексту или по музыкальному фрагменту. Автору ролика важнее другое: можно ли обновить одну сцену после правки абзаца, не пересобирая весь файл.
Синтез речи — от текста к дорожке
Пока нет звука, говорящий аватар не из чего собирать, и синтез речи превращает символы в волну. Сначала модель строит промежуточный каркас — время, высота тона, длительность слогов, — затем декодер превращает каркас в слышимый сигнал. Как устроена сама озвучка, разобрано в материале про синтез речи. Для русского языка важны ударения и буква «ё». Без них синтезатор произносит слово иначе, чем автор сценария, и править приходится уже видео.
В справке Google Vids голос может быть вшит в готового персонажа, и тогда отдельная запись диктора не нужна. Свой голос выбирают при сборке персонажа. Пометки темпа, паузы, эмоции, стиля и звуков открываются в сценарии квадратной скобкой. Кнопка автоматической расстановки ставит такие пометки сама. Это способ заранее заложить паузу и интонацию, чтобы видеомодель не угадывала их с нуля.
Если дорожку записал живой человек, синтез уже позади, а синхронизация губ остаётся: так устроены многие корпоративные ролики с цифровым двойником, звук настоящий, движение рта дорисовано. Отдельную озвучку в Vids можно выровнять под тот же выбранный голос, что и у аватара.
Сборка тембра по чужому образцу — уже другая граница. Короткий фрагмент речи превращают в новые фразы, которых человек не произносил. Почему для этого нужно согласие и чем копия отличается от склейки чужой записи, разобрано в материале про клонирование голоса. Для учебного ролика безопаснее готовый голос сервиса или запись человека, который сам согласился на озвучку.
Перед генерацией клипа сценарий стоит прогнать через предпросмотр голоса. Отметьте места, где фраза не укладывается в одно дыхание. Числа и фамилии слушайте отдельно: синтезатор иногда подменяет окончание, и видеоблок этой ошибки не исправит.
Откуда берётся лицо
У Google Vids два пути для своего персонажа: загрузить изображение или собрать внешность в конструкторе — пол, возраст, одежда и свободное описание. Для загрузки справка советует пейзажный кадр 16:9, чёткое освещённое лицо и нейтральный фон. Персонаж остаётся в том проекте, где его сохранили. Чтобы перенести его в другой файл, копируют проект целиком.
Готовый персонаж экономит время: лицо и голос уже согласованы, фото грузить не нужно. Свой нужен, когда в серии уроков должен быть один и тот же «преподаватель» или когда в кадре человек, который дал согласие на своё изображение. 17 июня 2026 года Google расширил библиотеку готовых персонажей с 23 до 53. В анонсе названы фотореалистичные, объёмные рисованные и стилизованные под графический роман. В том же тексте — больше 30 вариантов голоса.
На стороне Meta вход другой. Берётся уже сгенерированное изображение или короткое видео с лицом, затем к нему добавляют синхронизацию губ. Справка формулирует задачу прямо: любую картинку или видео с лицом можно заставить говорить или петь, сценарий должен уложиться в лимит времени, который показан внизу поля, а числа секунд на странице нет. Если лимит превышен, цифры краснеют, и публикацию не откроют, пока текст не укоротят. Приложения Meta AI и Vibes при этом открыты не во всех странах.
Лаборатория идёт дальше кнопки: 18 февраля 2025 года вышла статья AV-Flow, номер в архиве 2502.13133. Среди авторов — Meta AI, лаборатория Codec Avatars и университет Стоуни-Брук. Модель по одному тексту одновременно строит речь и движение головы и лица. Две параллельные диффузионные ветки трансформеров связаны промежуточными переходами, чтобы высота тона и мимика не разъезжались. Авторы описывают и режим диалога: аватар улыбается, кивает и переводит взгляд в паузе, пока говорит собеседник.
В февральском тексте авторы ещё только собирались выложить код. Репозиторий Meta с реализацией статьи к 2 ноября 2026 года уже открыт, в описании он назван кодом доклада с конференции ICCV. До кнопки в телефоне этой схеме далеко, и потребительский путь в Meta AI короче: там берут готовое лицо и короткий текст, а не строят речь и мимику из символов вместе.
Текстовые модели, которые пишут сценарий, и видеомодели, которые двигают сцену, решают разные задачи. Свободная генерация видео создаёт кадр и часто звук «как получится». Говорящий аватар привязан к вашим словам. Если нужен разбор самой видеомодели, на которую Google повесил аватары Vids, он лежит в материале про Veo.
Как создать говорящего аватара
Запрос из поиска звучит как одно действие, на практике это серия проверок. Ниже — схема без студии, если текст и портрет готовите заранее, а связку губ и звука делаете там, где сервис её уже собрал.
Сначала сценарий: прочитайте черновик вслух. Для первого клипа держитесь заметно ниже потолка в 60 секунд — так проще поймать сбой на одном дыхании, а не в середине трёхминутного монолога. Разбейте абзац на фразы, которые произносятся без набора воздуха: ориентир рабочий, не норма из справки. Фраза короче двенадцати слов реже ломает губы на стыке.
Текстовые модели для этой правки, в том числе Gemini 3.8 Flash, уже доступны в чате GPThub. Картиночные модели для портрета — там же. Пример запроса, его стоит вставить целиком и подставить свой абзац.
- Перепиши текст для озвучки лицом.
- Фразы короче двенадцати слов, разговорный русский, паузы отметь многоточием.
- Все числа и имена оставь как в исходнике.
- Исходный текст: курс открывается 12 марта, запись на три потока, ведущая — Анна Верещагина.
Это форма задачи, не отчёт о прогоне. Годная нарезка, её можно написать и руками, выглядит так.
- Курс открывается 12 марта.
- Запись идёт на три потока.
- Ведущая — Анна Верещагина.
В ответе модели проверьте пять вещей. Число 12 не стало «двенадцатого» и не уехало в другой месяц, слово «три» на месте и нового числа нет, фамилия не упрощена и не переставлена, нет английской вставки, которой вы не просили, и каждую фразу можно произнести на одном дыхании. Как формулировать задачу, чтобы модель не раздувала абзац, разобрано в гайде как писать запросы.
Дальше портрет, если нужен свой персонаж, а не библиотечный. Для статичного лица с последующей анимацией запрос к картиночной модели короткий. «Портрет человека по пояс, нейтральный фон, мягкий свет, лицо анфас, без текста и логотипов, кадр 16:9.» Сверьте результат с советами по работе с изображениями. Один человек, без лишних пальцев на краю кадра, без мелкого текста на одежде. Второй проход тем же инструментом убирает фон и украшения и просит не менять черты. Так анимация реже тянет за собой рисунок на стене.
Если на портрете реальный человек, нужно его разрешение. Вымышленное лицо проще, но собирать его «похожим на знаменитость» не стоит. Узнаваемость срабатывает и без имени в сценарии. Как неподвижный кадр становится движением, отдельно разобрано в материале видео из фото. Для аватара к этому движению добавляется дословная речь.
На шаге видео задачи легко перепутать: обычная генерация сцены по описанию рисует комнату, камеру и часто какой-то звук, но редко читает ваш договор слово в слово. Говорящий аватар в смысле «лицо произносит мой текст» собирают там, где продукт явно соединяет сценарий, голос и лицо. В Vids это выбор персонажа, ввод текста, предпросмотр и вставка клипа в монтаж. В Meta AI это синхронизация губ на уже готовом лице. Если ролик собирают из двух инструментов, заранее решите, где источник правды для текста: только в аудио или ещё и в субтитрах.
Пример запроса к видеомодели для фона без диктора. «Комната переговоров, камера на штативе, без людей, мягкий дневной свет, несколько секунд, без текста в кадре.» Лицо встанет отдельным слоем в редакторе, где связаны губы и звук. Если модель должна говорить, сверяйте дословность в каждом дубле. «Крупный план человека анфас, говорит короткую фразу на русском, нейтральный фон.» Сравните звук с утверждённым текстом. При расхождении меняйте сценарий, затем уже описание сцены.
Просмотр идёт дважды: сначала без звука, потом в наушниках. Отметьте каждый момент, где губы не совпали с ударным слогом. Если сервис режет ролик на сцены, перегенерируйте только проблемный фрагмент. Иначе правьте сценарий и голос вместе с картинкой. Цифры и названия сверьте с исходником построчно.
Субтитры не заменяют синхронизацию, но снимают часть претензий. Зритель часто смотрит без звука, и короткая строка в монтаже помогает и дикции, и площадкам, где звук по умолчанию выключен.
Когда хватит готового персонажа
Готовые персонажи Vids и похожие библиотеки экономят время. Голос уже согласован с мимикой, кадр стабилен, фото не нужно. Ими пользуются, когда лицо не несёт смысловой нагрузки и зритель должен слушать текст.
Свой персонаж нужен, когда важна преемственность. Серия из десяти уроков с одним «преподавателем», внутренние новости с узнаваемым ведущим, инструкция с человеком в одежде компании. Здесь платят временем: каждый новый абзац требует проверки, что картинка ещё соответствует тексту.
2 апреля 2026 года Google описал режим постановки. Текстовым запросом аватар просят ходить, говорить и взаимодействовать с предметами, лицо и голос при этом остаются теми же. В том анонсе режим открыт учётным записям Workspace на английском. Русский сценарий к той дате в списке языков ещё не значился — красиво разошлись.
17 июня 2026 года постановку распространили на собранных персонажей. В анонсе прямо сказано, что раньше направлять текстом можно было только готовых. Про снятие английского ограничения июньский текст молчит, и для русского автора практичный порядок другой: сначала заморозить сценарий на готовом персонаже, затем решать, нужен ли свой. Так лицо не пересобирают десять раз из-за одной правки.
Для роликов внутри компании, где аватар заменяет запись с веб-камеры, полезен обзор нейросетей для бизнеса. Серия уроков живёт рядом с титрами и схемами, и номер сцены там важнее, чем эффект в ленте.
Что написано про Google Vids
В справке путь короткий: выбрать аватар, ввести текст, при необходимости настроить голос, открыть предпросмотр и вставить клип в монтаж, генерация занимает минуты, и окно Vids в это время закрывать нельзя. Если звук пропал, справка советует сначала проверить динамики компьютера, затем убедиться, что дорожка сгенерированного объекта не заглушена.
Ограничения лучше знать до того, как сценарий разрастётся. Один клип с аватаром — до 60 секунд. Число генераций зависит от плана. Для многих пользователей справка называет потолок в 25 генераций в месяц. У других планов лимит общий с роликами ИИ в том же Vids. Счётчик обнуляется в полночь по тихоокеанскому времени, в первый день месяца. В декабрьском анонсе 2025 года обещали повышенный запас минимум на 30 дней, а затем лимиты на человека. К ноябрю 2026 года рабочая цифра — та, что в справке, не рекламный запас первого месяца.
В том же анонсе от 18 декабря 2025 года есть формулировка про оценки. Люди в них предпочитают аватары Vids в пять раз чаще, чем аватары на других платформах. Это слова Google про их собственные оценки, независимого замера в том абзаце нет.
Язык сценария шёл отдельной лестницей. 24 февраля 2026 года к английскому добавили французский, немецкий, итальянский, корейский, португальский, испанский и японский. Русского в том списке нет, и 17 июня 2026 года Google объявил 16 новых языков, среди них русский, и назвал общий итог — 24 языка аватаров и озвучки. Более живую речь в том анонсе связали с Gemini 3.1 Flash, а сборку клипа по-прежнему с Veo 3.1. В справке, открытой 2 ноября 2026 года, русский в списке языков сценария стоит.
Если сценарий правят после генерации, интерфейс показывает пометку Avatar outdated. Она может висеть над блоком и рядом со сценами. Обновление идёт по одной сцене, не на весь файл разом. Для серии уроков это полезнее, чем кажется. Видно, какая версия текста уже не совпадает с картинкой.
16 июля 2026 года Google описал отдельный режим. Человек проходит проверку внешности и может появиться в сгенерированном клипе без съёмки. В анонсе этот путь назван личным аватаром на базе Gemini Omni. На старте он только на английском, с 18 лет, и его нет в Европейской экономической зоне, Швейцарии и Великобритании. Страница не говорит, что этот режим заменил аватары на Veo 3.1: это другая дверь, и туда пускают проверенное собственное лицо, а не загруженное чужое фото и не библиотечного персонажа, который читает русский сценарий.
На странице Veo 3.1 у DeepMind видео и звук рождаются в одной модели. Там же прямо сказано, что естественная связная речь, особенно на коротких фрагментах, остаётся зоной доработки, и что синхронизацию звука с картинкой продолжают уточнять, чтобы убрать бессвязные реплики. Слово «губы» на этой странице не написано, и к речи в свободно сгенерированном клипе имеет смысл относиться как к черновику, если важна каждая словоформа.
Кнопка в Meta и статья в лаборатории
Для короткого ролика в Meta AI путь короче, чем в Vids. Сгенерировали картинку или клип с лицом, открыли синхронизацию губ, выбрали музыку или текст, подобрали голос по картинке внизу поля, посмотрели превью, которое собирает кнопка Create. Справка отдельно просит загружать только то, на что есть право, и быть осторожнее с изображениями молодых людей.
Сравнивать Google и Meta по одному чужому ролику бессмысленно. У них разные потолки длины, разные языки на старте и разные правила хранения персонажа. В Vids аватар живёт в монтаже рядом с титрами. В Meta AI лицо берут из уже сгенерированного кадра, а сценарий ужимают до лимита, который виден в интерфейсе, но не назван секундами в справке. Для открытки в ленте часто хватает второго, а для курса из двенадцати глав удобнее редактор, где сценам видны номера и устаревшая версия текста.
Лабораторный AV-Flow показывает, куда отрасль целится. Речь и мимика из одного текста, плюс реакция на собеседника. Потребительские кнопки к ноябрю 2026 года ближе к монологу по сценарию. Имеет смысл не путать показательный ролик лаборатории с тем, что откроется в телефоне по той же фамилии компании.
Практичный приём для автора, у которого есть доступ к обоим инструментам, — один и тот же короткий сценарий секунд на двадцать. Запишите, где меньше правок на словах с «б», «п» и «м»: замер этот частный и быстрее, чем спор о качестве по чужому ролику.
Как проверить губы и согласие
Список проверок похож на контроль нейросетевого видео, но акцент на рте и на праве снять это лицо.
Согласные на губах: слова с «б», «м» и «п» должны сжимать губы в тот же момент, когда слышен удар. Если удар уже прозвучал, а рот ещё открыт, фрагмент лучше пересобрать, а не «дотянуть» в монтаже.
Длинные гласные: на «о» и «а» рот открыт дольше, чем на коротком слоге. Если все слоги выглядят одинаково, модель пережёвывает речь. Часто помогает укоротить фразу и убрать ускорение, а не менять описание комнаты.
Взгляд и моргание: неподвижные глаза или редкое моргание выдают синтез даже при хороших губах. На паузе между предложениями живой человек обычно моргает. Если пауза есть в звуке, а лицо застыло, кадр читается как маска.
Края лица: при повороте головы смотрите линию подбородка и волос. Там чаще всего возникает дрожание, особенно если исходник снят в жёстком боковом свете. Тень на половине лица ломает оценку формы губ, и при анимации тень ползёт не так, как на живой съёмке.
Смысл: сравните аудио с утверждённым сценарием. Модель может заменить имя или число, и красивые губы этого не выдадут. Для учебного ролика полезен простой лист: номер сцены, цитата из сценария, три отметки — губы, звук, смысл. Когда через месяц просят заменить одну фразу, видно, какие сцены затронуты.
Согласие проверяют до генерации, не после жалобы. Справка Meta пишет прямо: загружать можно только изображения и звук, на которые есть право, и осторожнее с изображениями молодых людей. Справка Google Vids говорит другое, и это тоже стоит процитировать точно. Аватары собраны генеративным ИИ и живыми людьми не считаются. Использование подчинено политике запрещённого применения генеративных моделей. В отзыв о функции не стоит класть персональные и служебные данные, его может прочитать человек.
Отдельного требования «приложите согласие на чужое фото» в открытой справке Vids нет. Из этого не следует, что чужое лицо можно ставить в ролик. Личный аватар, который Google описал 16 июля 2026 года, как раз проверенное собственное лицо, и то на английском и не в ряде европейских стран. Чужое фото в конструктор — не этот режим.
Если ролик идёт на площадку с автоматической модерацией, сохраните исходный сценарий и дату генерации. Спорные случаи разбирают по тексту и по дате генерации, картинки для этого мало, и юридическую консультацию этот абзац не заменяет. Он отделяет то, что написано в справках, от того, чего там нет.
Типичные ошибки при первом ролике
Слишком длинный монолог: один файл на три минуты упрётся в потолок 60 секунд в Vids и увеличит шанс рассинхрона в середине. Длинный материал собирают из сцен.
Сценарий без ударений в сложных именах: синтезатор исказит фамилию или название. Зритель решит, что сеть ошиблась в факте, хотя ошибка в озвучке.
Фото с резким боковым светом и мелким рисунком на фоне. Тень и узор тянутся в анимацию. Нейтральный фон из справки снижает лишнюю фактуру, которую модель тянет в движение.
Два голоса в одном проекте без перехода: в первой сцене женский готовый тембр, во второй мужской синтез. Зритель читает это как ошибку монтажа, даже когда губы синхронны.
Правка только видео при слабом тексте: если фраза неудачная, её переписывают и прогоняют синтез заново. Иначе получатся аккуратные губы с неверным смыслом.
Чужое фото без права: технически цепочка может быть той же, что у учебного ролика. По правилам сервисов и по смыслу задачи это уже другой случай.
Говорящий аватар и подмена лица
Подмена лица без согласия вынесена в отдельный материал, и смешивать задачи не стоит. Говорящий аватар для курса, инструкции или внутреннего объявления — это сценарий, который вы контролируете, и лицо, на которое есть право или которое собрано как вымышленный персонаж. Подмена — использование чужого лица так, будто человек сказал то, чего не говорил.
Технически шаги могут быть похожи, юридически и по правилам площадок это разные случаи. Где проходит эта граница и почему «оживить фото» не равно «подставить чужое лицо», разобрано в статье про аватар и дипфейк. Для редакционного ролика правило простое: только лица, на которые есть право, и только текст, который вы готовы показать вместе с исходником.
Куда смотреть дальше
Если нужна целая сцена с камерой и фоном, помимо лица, которое читает текст, начните с разбора генерации видео. Если важнее формулировки, пригодится гайд по запросам. Когда выйдет новость, что одна модель склеивает текст, голос и лицо без отдельного монтажа, её стоит проверять на коротком сценарии со словами на «б», «п» и «м». На них ошибка видна раньше, чем на гладкой рекламной фразе, и проверять стоит до того, как ролик уйдёт в серию.
Имеет смысл открыть справку сервиса в день съёмки сценария, а не месяц спустя. Лимит в 60 секунд и потолок генераций живут в справке Vids. Список языков с июня 2026 года включает русский, но личный аватар с проверкой внешности на старте был только английским. Эти две строки легко перепутать, если читать один заголовок.
Вопросы и ответы
Как создать говорящего аватара без камеры?
Нужны текст, звук и источник лица. В Google Vids выбирают готового персонажа или собирают своего, вводят сценарий и получают клип до 60 секунд. Запись с веб-камеры для готового персонажа не нужна, голос уже вшит, а в Meta AI можно взять изображение с лицом и добавить синхронизацию губ по короткому тексту, если приложение доступно в вашей стране и сценарий уложился в лимит поля. Сценарий и портрет готовят заранее. Связку губ и голоса делают в сервисе, где эта функция предусмотрена.
Можно ли озвучить такой ролик по-русски?
Да, 17 июня 2026 года Google включил русский в языки аватаров и озвучки Vids и назвал общий список из 24 языков. В справке, открытой 2 ноября 2026 года, русский по-прежнему указан. В февральском расширении 2026 года его ещё не было. Ударения и имена всё равно стоит прослушать до финального ролика. Режим личного аватара с проверкой внешности на старте был только английским. Это другой режим, не озвучка библиотечного персонажа.
Чем такой ролик отличается от обычной генерации видео?
Обычная генерация по описанию сцены создаёт картинку и часто звук как получится. Говорящий аватар привязан к вашему тексту. Сервис подгоняет движение рта под заданные слова. Это ближе к озвучке с контролем дословности, чем к свободному клипу по описанию. На странице Veo 3.1 у DeepMind короткая связная речь всё ещё названа зоной доработки. Дословность в каждом дубле проверяют ухом, не заголовком анонса.
Как оживить своё фото?
В Google Vids загружают изображение 16:9 с чётким освещённым лицом и нейтральным фоном, дорабатывают в конструкторе, выбирают голос и сохраняют персонажа. Затем вводят сценарий, и нужно право на изображение. После смены текста пометка Avatar outdated напомнит обновить сцену. Личный аватар с проверкой внешности, описанный 16 июля 2026 года, — отдельный путь. Английский, с 18 лет, и его нет в Европейской экономической зоне, Швейцарии и Великобритании.
Сколько длится один такой ролик?
В справке Google Vids для аватара указано до 60 секунд на один сгенерированный клип. Более длинный материал собирают из нескольких сцен в монтаже. У Meta секунды в справке не названы: лимит показан в поле сценария, и при превышении публикацию не откроют, пока текст не укоротят.
Почему губы не попадают в слова?
Чаще виноваты слишком быстрая речь, длинные слова без пауз или слабый исходник лица. Реже модель съедает согласные в начале слова. Укоротите фразы, пересоберите аудио и проверьте слова на «б», «п» и «м». Если в интерфейсе есть выбор точности и скорости, для учебного ролика берут точность. Цифры сверьте с исходником отдельно. Ошибка в числе губами не лечится.
Связанные модели

Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Нейросеть для бизнеса
Как использовать GPThub в работе: деловые письма, саммари встреч, черновик КП, ответы поддержке. Факты и цены — только ваши, без выдуманных гарантий.
Ещё по теме
Источники
- Use AI avatars in Google Vids, справка Google, открыта 2 ноября 2026
- Аватары Google Vids на Veo 3.1, анонс Workspace, 18 декабря 2025
- Постановка аватара текстом, анонс Workspace, 2 апреля 2026
- Новые языки аватаров и озвучки, анонс Workspace, 24 февраля 2026
- Расширение аватаров и языков, анонс Workspace, 17 июня 2026
- Личный аватар в Vids, анонс Workspace, 16 июля 2026
- Veo 3.1, страница Google DeepMind, открыта 2 ноября 2026
- Синхронизация губ в Meta AI и Vibes, справка Meta
- AV-Flow, arXiv 2502.13133, 18 февраля 2025
- Репозиторий AV-Flow, Meta
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Написать сценарий в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.