
"Видео из фото: чем ролик с сюжетом отличается от оживления снимка"

Обозреватель: как устроен ИИ
Содержание
12 февраля 2026 года команда ByteDance Seed опубликовала заметку о модели Seedance 2.0. Среди демонстраций там есть скромный пример, помеченный как генерация из картинки: девушка развешивает бельё, достаёт из таза следующую вещь и встряхивает её. Никакого моргания, никакого «портрет задышал». На снимке была сцена, а на выходе получилось маленькое происшествие с началом и продолжением. Этот пример хорошо показывает, чем видео из фото отличается от того, что в поиске называют «оживить снимок». Оживление — это когда портрет остаётся портретом: человек моргнул, волосы качнулись, камера стоит. Ролик с сюжетом — когда после первого кадра что-то происходит: вещь сдвинулась, человек сделал шаг, камера отъехала и показала комнату. Технически оба случая начинаются с одного и того же файла, а вот запрос, ожидания и типичные поломки у них разные. Как модель вообще достраивает кадры, которых не было на снимке, уже разобрано в двух материалах: как нейросеть делает видео и как оживить фото. Здесь теория будет короткой. Основная часть — о том, как превратить один снимок в ролик, где есть действие, и как написать для этого запрос.
Видео из фото и оживление: две разные просьбы
Привычная картинка в голове — старая кинолента: стоит её чуть протянуть, и неподвижный кадр поедет дальше. Аналогия неверна в главном. Лента хранит кадры, которые уже сняты, а у фотографии второго кадра нет вообще. Модель не «протягивает» снимок, она сочиняет продолжение так, чтобы его начало совпало с вашим файлом. Документация Google Cloud о генерации видео из изображения формулирует это прямо: существующая картинка служит первым кадром нового ролика.
Из этого следует простая вещь. Чем меньше вы просите сочинить, тем ближе результат к снимку. Просьба «моргнул один раз, камера неподвижна» оставляет модели доли секунды мимики, и почти всё в кадре остаётся вашим. Это и есть оживление, которое ищут для семейных фотографий.
Просьба «встаёт из-за стола, берёт чашку, камера медленно отъезжает к окну» устроена иначе. Модели придётся выдумать походку, стол сбоку, окно, которого на снимке не было, и то, как свет из этого окна ложится на лицо. Это уже ролик с сюжетом. Ошибки здесь другие: чашка меняет форму ручки, окно сдвигается, а лицо к пятой секунде становится немного чужим, хотя первый кадр был точным.
| Что просят | Что остаётся от снимка | Что модель сочиняет | Где обычно ломается |
|---|---|---|---|
| Моргание, лёгкий наклон | Почти весь кадр | Мимику на долю секунды | Зубы, очки, серьги |
| Один жест на месте | Человек и комната | Руку, ткань, мелкий предмет | Пальцы, край стола |
| Действие и проезд камеры | Только стартовый вид | Пространство за краем кадра | Стены, пол, масштаб |
| Заданы начало и конец | Два кадра | Путь между ними | Середина, смена позы |
Поиск эти случаи смешивает. Фраза «нейросеть видео из фото» покрывает и моргание бабушки на карточке 1970-х, и пятнадцать секунд со сменой планов для объявления. Модель по одному файлу не знает, какую строку таблицы вы имели в виду. Если в запросе нет действия и нет камеры, она выбирает самое среднее: лёгкий наезд и чуть живое лицо. Выглядит это как слабое оживление, даже если хотелось кино.
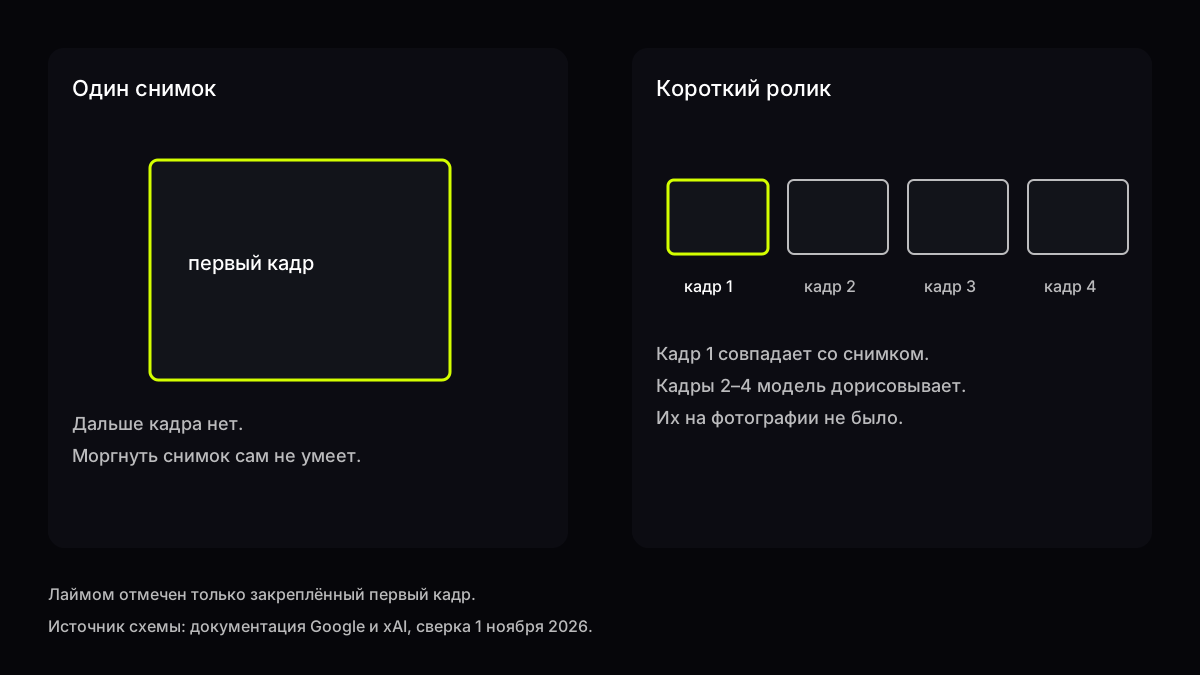
Схема первого кадра и сгенерированного продолжения, иллюстрация GPThub
Что разработчики дают на входе
Подробно про устройство генераторов написано в обзоре нейросетей для видео, здесь достаточно трёх вариантов входа, которые встречаются в документации на 1 ноября 2026 года.
Первый кадр — один снимок, с которого начинается ролик. У Google это основной режим генерации из изображения, и для модели Gemini Omni в документации указана длина от 3 до 10 секунд, разрешение по умолчанию 720p и две пропорции на выбор, широкая 16:9 и вертикальная 9:16. У xAI режим «картинка в видео» включается одним полем с изображением, а модель grok-imagine-video-1.5 в нём выдаёт родные 1080p.
Первый и последний кадр — два снимка: как начать и чем закончить. В той же документации Google к стартовой картинке можно добавить конечную. Середину никто не снимал, её модель рисует сама, и если на старте человек сидит, а в конце стоит у двери, подъём будет выдуманным. Для сюжета это удобно: вы задаёте не только начало, но и точку, куда история должна прийти.
Набор опор — несколько картинок, которые объясняют модели, кто в кадре и где всё происходит. Seedance 2.0, по заметке ByteDance, принимает за раз до 9 картинок, 3 фрагментов видео и 3 фрагментов звука вместе с текстом и собирает многоплановый ролик со звуком длиной до 15 секунд. Опора отвечает на вопрос «кто это и в какой комнате», но не на вопрос «с какого кадра начать». Персонаж может войти в кадр позже, и ни один кадр ролика не обязан совпасть с вашими фотографиями. Если важно, чтобы ролик открылся именно вашим снимком, нужен первый кадр.
У xAI граница проведена явно: стоит добавить к изображению последний кадр, ключевые кадры или опоры, и запрос становится другим режимом, хотя снимок по-прежнему закреплён в начале. Для читателя из этого полезно одно правило. Сначала решите, что для вас важнее, точное начало или узнаваемый герой, и только потом выбирайте, сколько картинок прикладывать.
Как придумать сюжет для одного снимка
Ролик из фото длится секунды, и сюжет в нём помещается ровно один. Это не недостаток, а рамка, внутри которой проще работать. Хороший сюжет для короткого ролика отвечает на три вопроса.
Прежде всего, что сдвинется. Нужен один глагол для того, что уже есть на снимке: встряхивает, отплывает, поворачивает голову, наливает, открывает. Предмет должен быть в кадре. Модель гораздо увереннее двигает то, что видит, чем приводит в кадр то, чего нет.
Затем, что делает камера. Варианта три-четыре: стоит, медленно наезжает, отъезжает, плавно идёт вбок. Камера, которая отъезжает, обязывает модель дорисовать то, что было за краем снимка, и это самый рискованный выбор. Неподвижная камера оставляет больше вашего снимка нетронутым.
Наконец, чем всё кончится. Если вам важен финал, его надо назвать: «кораблик доплывает до края лужи и останавливается». Без этого конец ролика ничем не обязан: предмет может уплыть за край, а может застыть на полпути. Если финал нужен точный, его лучше задать вторым снимком.
Короткий тест для сюжета: перескажите ролик одной фразой вслух. «Девушка встряхивает рубашку, камера стоит» — годится. «Девушка встряхивает рубашку, потом идёт дождь, потом приходит сосед, а камера облетает двор» — это три ролика, и модель попытается втиснуть их в восемь секунд. Обычно такая попытка заканчивается лишним пальцем или соседом с чужим лицом.
Как подготовить снимок перед роликом
Половина неудач с видео из фото случается ещё до запроса, на этапе выбора файла. Модель начинает с вашего кадра, и всё, что в нём плохо видно, она будет додумывать на каждом следующем кадре, причём каждый раз немного по-другому.
Прежде всего, кадр должен быть резким там, где будет движение. Если по сюжету человек поворачивает голову, его лицо должно быть чётким, а размытый фон модели как раз не помешает. Если двигаться будет предмет, предмет должен быть виден целиком, без обрезанного края, иначе модель дорисует недостающую часть, и в каждом прогоне она получится разной.
Затем стоит подумать о свободном месте в кадре. Кораблику, который должен отплыть вправо, нужно куда плыть, и если он стоит у самого края снимка, модели придётся сочинять стол за пределами кадра. Чем больше свободного пространства в направлении движения, тем меньше выдуманного в ролике.
Старые фотографии с царапинами и пятнами лучше сначала почистить картиночной моделью: модель видео воспримет царапину как часть сцены и может начать её двигать вместе с лицом. Сканы с бумажной рамкой лучше обрезать по краю изображения, иначе рамка станет частью кадра. И последнее: если снимок вертикальный, а ролик нужен широкий, решите заранее, что пожертвовать, верхом или низом, и обрежьте сами, а не оставляйте выбор модели.
Примеры запросов с разбором
Ниже пять запросов к одному и тому же типу задачи: снимок приложен, нужен короткий ролик. Как писать запросы к моделям вообще, разобрано в гиде как писать запросы, здесь только то, что относится к видео.
Семейная фотография, где нужно лишь лёгкое движение.
«Женщина на снимке медленно моргает и чуть улыбается. Камера неподвижна. Одежда, причёска и фон не меняются. Рот закрыт».
Это просьба об оживлении, и она честно узкая. Фраза «рот закрыт» защищает от попытки модели заставить человека говорить: рот на карточке не хранит ни зубов, ни звука, и любая речь будет придуманной. Если на выходе лицо всё равно поменялось, сократите движение ещё сильнее: оставьте только моргание.
Предмет на столе, нужен сюжет.
«Бумажный кораблик на мокром столе медленно отплывает вправо по луже и останавливается у края. Камера неподвижна, сверху под углом. Других предметов не добавлять».
Здесь есть всё нужное: один глагол, одна камера, финал и запрет. Сам кораблик заново не описан, потому что модель видит его на снимке. Повторное описание вроде «белый бумажный кораблик, складки, реализм» часто толкает модель перерисовать предмет «правильнее», и складки во втором кадре уже другие.
Пейзаж с поездки, нужна камера.
«Камера медленно наезжает на дом у озера. По воде идёт лёгкая рябь, облака плывут влево. Людей не добавлять».
Две вещи двигаются одновременно, вода и облака, но обе фоновые и не требуют рук или лиц. Такое движение модели даётся легко. Наезд, а не отъезд выбран специально: камере не нужно показывать то, чего на снимке не было.
Фото товара для объявления.
«Кружка на столе медленно поворачивается на полоборота, пар поднимается над ней. Камера неподвижна. Надпись на кружке не менять».
Надпись — самое уязвимое место в ролике. Буквы для модели — такой же рисунок, как складки ткани, и стоит предмету повернуться, текст на нём начинает плыть. Если надпись важна, поворот лучше убрать совсем и оставить только пар.
Портрет, из которого нужен ролик с действием.
«Мужчина откладывает книгу на стол и смотрит в окно. Камера стоит, план средний. Одежда и комната не меняются».
Это уже сюжет, и он рискованнее предыдущих: в кадре появляются руки и новый поворот головы. Если руки на снимке видны, шансов больше. Если они за краем кадра, модель их придумает, и пальцы стоит проверить в первую очередь.
| Запрос | Чего в нём нет | Что получится скорее всего |
|---|---|---|
| «Сделай красиво, как в кино» | Действия и камеры | Средний наезд и чуть живое лицо |
| «Оживи фото» | Масштаба движения | Оживление, а не сюжет |
| «Он встаёт, идёт, садится в машину и уезжает» | Одного действия | Ломаются руки, машина меняется |
| «Пусть скажет: с днём рождения» | Звука у снимка | Чужой рот и выдуманный голос |
Что проверять в готовом ролике
Посмотреть ролик целиком мало. Средний наезд на первом просмотре часто выглядит удачно, а на паузе оказывается, что у человека шесть пальцев.
Первый кадр сравните с исходным файлом рядом. Сдвинутая рамка, срезанная макушка, другой кроп — это вопрос пропорций, а не плохой модели. Почти квадратный снимок в кадр 16:9 сам не влезет: останутся поля или часть снимка пропадёт. Решите это до длинного прогона, например выбрав вертикальный формат для портрета.
Середину смотрите на паузе. Руки, уши, дужки очков, буквы на вывеске, края предмета. Модель охотнее всего ошибается там, где на снимке чего-то не было видно полностью: в первом кадре лишнего пальца ещё нет, он появляется, когда кисть пошла в сторону.
Конец сверьте с тем, что вы просили. Если задан только старт, финал свободный. Если заданы оба кадра, смотрите стык: не прыгнул ли предмет в последней доле секунды. Резкий скачок в конце — типичный способ выполнить условие двух кадров, не нарисовав путь между ними.
Звук, если модель его добавила, проверяйте по действию. Свист без пара, шаги при неподвижных ногах, голос, которому не соответствуют губы. Микрофона на снимке не было, весь звук сочинён так же, как второй кадр.
Ещё одна проверка — лицо на последней секунде. Даже когда первый кадр точный, к концу ролика черты иногда сдвигаются: другой разрез глаз, другая линия подбородка. Почему так происходит, подробно объяснено в разборе оживления фото. Практический вывод простой: для ролика с узнаваемым человеком короткая длина и неподвижная камера надёжнее длинного проезда.
Типичные ошибки и как их исправить
Первая ошибка — описать снимок заново вместо того, чтобы описать действие. Модель и так видит стол, кораблик и тёмную комнату. Запрос должен говорить, что случится после снимка.
Вторая — попросить жанр вместо движения. «Киношный трейлер», «атмосферно», «шедевр» не говорят, куда двинется рука и едет ли камера. Модель заполнит пустоту самым средним вариантом.
Третья — попросить слишком много. Два действия, смена плана и новый человек на восемь секунд почти всегда дают сломанные руки или скачки фона. Если сюжет длинный, его лучше разбить на несколько коротких роликов, каждый со своим первым кадром.
Четвёртая — менять в повторе всё сразу. Если первый ролик не удался, поменяйте что-то одно: сначала камеру, потом глагол. Когда меняется и то и другое, непонятно, что именно помогло.
Пятая — начинать с плохого снимка. Тёмная, смазанная фотография, где человек стоит вполоборота за столбом, не станет чётче от генерации: модель уверенно дорисует щёку и ухо, которых не видела. Сначала снимок стоит поправить, например картиночной моделью вроде Nano Banana 2.1, об этом есть гид по работе с картинками. Первый кадр зритель рассматривает дольше всего, поэтому в ролик лучше отдавать ту версию, которую не стыдно показать без движения.
Шестая — ждать звук «со снимка». Фотография не хранит голоса, даже если на ней открыт рот. Любая фраза будет новым звуком под новое движение губ. Для семейного архива честнее тишина или комнатный шум.
Длинный сюжет из нескольких коротких роликов
Один ролик из фото длится секунды: у Gemini Omni в документации Google верхняя граница 10 секунд, у Seedance 2.0 заявлено до 15. История длиннее в один прогон не помещается, и пытаться втиснуть её туда — верный путь к сломанным рукам. Работает другой подход, знакомый любому монтажёру: сюжет делится на планы, и каждый план делается отдельным роликом.
Возьмём бытовой пример. Есть фотография бабушкиной кухни: стол, чайник на плите, окно. Хочется короткий ролик для семейного чата, где закипает чайник, бабушкина рука ставит чашку, а камера потом показывает окно. Это три действия, и одним запросом их не сделать.
Первый план — чайник. Снимок кухни как первый кадр, запрос «над чайником поднимается пар, камера неподвижна, ничего не добавлять». Здесь двигается только пар, и модель почти наверняка справится.
Второй план — чашка. Если в кадре нет руки, модель её придумает, и это самое рискованное место всего сюжета. Надёжнее снять отдельное фото стола крупнее, уже с чашкой, и попросить «чашку медленно пододвигают к краю стола». Рука может так и не появиться в кадре, и это нормально: зритель достроит её сам.
Третий план — окно. Отдельный снимок окна или кадр из первого ролика, запрос «камера медленно наезжает на окно, за стеклом качаются ветки». Снова одно движение, снова фон без лиц.
Склеить три ролика можно в любом простом видеоредакторе на телефоне. Получится секунд двадцать, и в каждом плане модель решала одну задачу, а не три сразу. Если нужен плавный переход между планами, используйте режим первого и последнего кадра: конечный кадр одного ролика становится стартовым снимком следующего. Тогда склейка будет почти незаметной.
Логика в таком решении есть — модели проще удержать один предмет и одну камеру, чем помнить, какой формы была чашка пять секунд назад. Кино, впрочем, снимают так же: планами, а не одним дублем на весь фильм.
Когда честнее выбрать оживление
Ролик с сюжетом выглядит эффектнее, но подходит не всегда. Есть случаи, когда узкая просьба даёт результат лучше.
Старые семейные фотографии. Человек на карточке давно стоит в одной позе, и любой шаг или поворот головы модель придумает целиком. Для архива узнаваемость важнее действия: моргание и лёгкая улыбка сохраняют лицо, а попытка заставить прадеда встать и пройти по комнате, которой за кадром не было, почти наверняка даст чужого человека.
Групповые снимки. Чем больше людей в кадре, тем больше лиц и рук, которые надо удержать. Сюжет на пятерых модель обычно разваливает. Для группы лучше подходит неподвижная камера и мелкое общее движение: ветер, свет, лёгкий наезд.
Снимки с важным текстом. Вывеска магазина, табличка с адресом, надпись на торте. Здесь любой сюжет с движением предмета или камеры рискует испортить буквы, и оживление фона надёжнее.
Обратная ситуация тоже бывает. Пейзаж, предмет на столе, животное в движении, улица — тут оживление на месте выглядит бедно, а ролик с камерой и одним действием раскрывает снимок. Фон без лиц модель дорисовывает спокойно, и ошибки в листве или облаках зритель не заметит.
Чужое лицо и права
ByteDance в заметке о Seedance 2.0 оговаривает отдельно: лица в демонстрациях либо сгенерированы, либо использованы с разрешения, а реальный портрет как опора требует проверки самого человека или заранее полученного права. Модель согласие не проверяет, она видит только пиксели. Ролик из вашей фотографии с вами — ваше дело. Ролик из снимка коллеги, соседа или случайного человека в кафе — уже вопрос не техники, а разрешения.
Как сделать видео из фото нейросетью: порядок действий
- Решите, что нужно: оживление на месте или ролик с действием. От этого зависит весь запрос.
- Выберите снимок: чёткий, с видимыми руками и предметом, который должен двигаться.
- Подберите формат под снимок: вертикальный для портрета, широкий для пейзажа.
- Напишите одно действие, одну камеру, финал и что не менять.
- Сделайте первый прогон на короткой длине. Ошибка пальцев видна уже на третьей секунде, и длинный ролик её не исправит.
- Проверьте первый кадр, середину на паузе, конец и звук.
- Повторите с одним изменением. Если нужен длинный сюжет, соберите его из нескольких коротких роликов.
В чате GPThub снимок прикладывают к запросу на ролик и описывают движение словами, по-русски. Отдельной кнопки «превратить фото в фильм» нет и у разработчиков: есть первый кадр, пара кадров и опоры, а ширину того, что модели разрешено придумать, задаёте вы сами.
Вопросы и ответы
Как сделать видео из фото нейросетью?
Приложите снимок и напишите, что происходит дальше: одно действие, одно движение камеры и что не менять. Снимок станет первым кадром, остальное модель дорисует. Для первой попытки выбирайте короткую длину.
Чем создать видео из фото отличается от «оживить фото»?
Оживление просит мелкое движение на месте, чтобы снимок остался узнаваемым. Ролик с сюжетом просит действие и камеру, поэтому модель сочиняет больше. Начинаются оба с одного файла.
Какая нейросеть для генерации видео из фото подходит?
На 1 ноября 2026 года режим с картинкой в начале ролика описан в документации Google (Veo 3.1 и Gemini Omni) и xAI (Grok Imagine Video). Seedance 2.0 от ByteDance принимает до девяти картинок как опоры. Выбор зависит от того, нужно ли точное начало или узнаваемый герой.
Можно ли сгенерировать видео из фото с надписью?
Можно, но буквы сохраняются хуже всего. Держите камеру неподвижной, не просите поворачивать предмет и прямо напишите, что надпись менять нельзя.
Можно ли сделать видео из чужой фотографии?
Технически модель это сделает, но согласия она не проверяет. ByteDance прямо пишет, что реальный портрет как опора требует разрешения самого человека.
Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Сделать ролик из снимка в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.