
Как нейросеть превращает текст в голос

Обозреватель: как устроен ИИ
Содержание
12 сентября 2016 года Аарон ван ден Оорд и ещё восемь исследователей DeepMind сдали статью со спокойным названием: сеть, которая порождает сырой звук. В аннотации нет обещания «живого диктора», зато есть рабочее описание. Модель угадывает следующий отсчёт волны, опираясь на все предыдущие, и на синтезе речи слушатели ставят ей оценку заметно выше, чем лучшим тогда системам склейки и параметрического синтеза. И для английского, и для китайского сразу. Спустя десять лет запрос «нейросеть озвучка» набирают люди, которым нужен голос для ролика, и почти никто из них не открывает ту статью. Механика с тех пор сменила три оболочки. Предсказание следующего отсчёта при этом никуда не делось.
Откуда взялась нейросеть для озвучки
До 2016 года у синтеза речи было два ремесла, и оба слышны на слух.
Первое ремесло — конкатенация, то есть склейка готовых кусков. Диктора записывают часами, запись режут на фонемы, слоги и короткие слова, а новую фразу собирают из этих обрезков. Страница DeepMind об этой эпохе говорит прямо: любая правка требовала новых записей целиком. Швы между кусками давали щелчки, а интонация вопроса жила только там, где вопрос уже был произнесён на студии.
Второе ремесло называлось параметрическим синтезом. Модель выдавала набор чисел, высоту, длительность и спектр, и только потом из них собирали воздух. Дальше эти числа пропускали через вокодер, алгоритм цифровой обработки, и он уже собирал звук. Голос выходил ровнее склейки и одновременно более «синтезаторным»: свист, жужжание, пластиковая гласная. В таблице Tacotron 2, декабрь 2017 года, такая производственная система Google получила у слушателей 3,492 балла из 5. Живая запись в том же тесте — 4,582.
WaveNet ломает оба ремесла одним решением: сеть не клеит куски и не отдаёт числа вокодеру. Она учится на записях человеческой речи и на каждом шаге выбирает следующий отсчёт. Отсчёт — одно число громкости в один миг. На странице лаборатории указан потолок тех опытов: до 24 000 таких чисел в секунду. Двадцать четыре тысячи решений в секунду, каждое зависит от предыдущих. Отсюда берутся дыхание, причмокивание и акцент, хотя их никто не рисовал отдельной дорожкой: они просто часто встречались в записях, и сеть стала их повторять.
Цена такого счёта оказалась предсказуемой. Ранний WaveNet тратил часы на одну секунду звука, и ролик на две минуты превращался в эксперимент на всю ночь. Дистилляция — перенос умения большой сети в сеть поменьше — ускорила счёт примерно в тысячу раз. Секунда речи стала стоить 50 миллисекунд машинного времени. Рядом появился WaveRNN, родственник попроще, и его уже можно было считать на телефоне, а не только в стойке.
Одна и та же сеть держала много дикторов. Переключение устроено как признак «чей это голос», который подают вместе с текстом, без новой студийной смены. В аннотации 2016 года это сказано без рекламы: верность разным дикторам сопоставимая. На мой взгляд, именно эта строка, а не баллы, объясняет, почему через несколько лет «голос нейросети» стали путать с конкретным человеком. Технически путаница началась в тот день, когда диктор стал условием на входе, а не отдельной плёнкой в архиве.
Чем склейка слогов отличается от предсказания волны
Привычная картинка рисует нейросеть в кабине, с текстом перед глазами, будто диктора. Картинка удобная и при этом неверная: читающего внутри нет, рта нет, есть функция, которая по уже вышедшему звуку и по тексту оценивает, какой отсчёт вероятнее следующим.
Склейка, наоборот, как раз похожа на чтение по чужим обрезкам. Фраза «нейросеть для озвучки текста» в старой системе — это поиск ближайших кусков в архиве одного человека. Если куска «озвуч» в нужной интонации нет, шов слышен. Если архив английский, русское «ы» приходится лепить из чужого гласного, и ухо это не прощает.
Предсказание волны такого архива в момент ответа не открывает, потому что архив остался на обучении. В ответе сеть каждый миг выбирает число и может произнести сочетание, которого в записях не было целиком, лишь бы части были правдоподобны. В этом одновременно сила и риск. Новая фраза не обязана быть нарезкой, зато правдоподобный отсчёт ещё не равен верному слову. Сеть может проглотить слог, удвоить его или поставить ударение туда, где в языке его не бывает. Слушатель в 2016–2018 годах слышал это как «заикание робота», хотя механизм был другим: модель не заикалась, она теряла место в тексте.
Следствие из этого довольно прямое. Раз голос задаётся условием, а плёнка остаётся только в обучении, чужое имя на обложке ролика ничего не гарантирует. Гарантирует только то, на каких записях сеть училась и какой признак диктора ей подали сейчас. Записи студии, записи телефона и записи из ролика на площадке — разный материал. Сеть честно усреднит то, что ей дали.
Как нейросеть озвучивает текст
Общий контур после 2017 года у крупных лабораторий один, реализации разные. Текст не превращается в воздух одним прыжком.
Сначала текст становится последовательностью единиц, которые сети удобно держать. В Tacotron, март 2017 года, это были буквы: модель учили с нуля на парах «текст — звук», без отдельного словаря фонетистов. Оценка слушателей — 3,82 из 5, выше параметрической системы, и уже на кадрах, а не на каждом отсчёте, поэтому быстрее WaveNet. Буква для речи остаётся грубой единицей. В русском «ться» и «тся» пишутся по-разному и звучат почти одинаково, а «что» читается не так, как пишется. Сеть, которая видит только буквы, выучивает такие исключения, если они часто были в парах. Редкое имя собственное она прочитает по буквам, и это будет слышно.
Потом последовательность приходится растягивать во времени: букв в слове пять, а звучит оно треть секунды. Кто-то должен решить, сколько кадров спектра отдать на «о», а сколько на согласный. В пошаговых сетях 2017 года это делало внимание: декодер сам смотрел, какую букву озвучивать сейчас. На ровной фразе это работало, на длинной внимание соскальзывало, и слово выпадало или повторялось. Авторы FastSpeech из Чжэцзянского университета и Microsoft, май 2019 года, называют это прямой слабостью тогдашних систем.
Дальше сеть рисует мел-спектрограмму, картину, где по горизонтали идёт время, по вертикали частота, а яркость показывает, насколько эта частота громкая в этот миг. «Мел» — шкала, в которой низкие частоты разведены шире, чем высокие, примерно так, как их различает ухо. До колонки такой чертёж ещё не доходит, это описание звука, а не сам воздух. Tacotron 2, статья от 16 декабря 2017 года, как раз так и устроен: одна сеть переводит буквы в мел-спектрограмму, вторая, изменённый WaveNet, собирает из чертежа волну. Слушатели поставили 4,53 против 4,58 у профессиональной записи. Разрыв с живым диктором на том тесте стал тонким. Разрыв по времени счёта ещё нет: вокодер по-прежнему шёл отсчёт за отсчётом.
Последний шаг — волна, те самые тысячи чисел в секунду. У OpenAI на 1 ноября 2026 года сырой поток PCM для этого сервиса описан явно: 24 кГц, 16 бит, знаковое целое. Двадцать четыре тысячи отсчётов в секунду, тот же потолок, что в опытах WaveNet.
Между шагами сидят ошибки разного сорта, и их полезно не смешивать.
- Ошибка текста случается, когда число «2026» можно прочитать как год и как набор цифр, а сокращение без расшифровки сеть произносит по буквам латиницы.
- Ошибка времени выглядит как слишком короткий слог, проглоченная пауза и два слипшихся слова.
- Ошибка чертежа слышна, когда высота плывёт, гласная становится «жестяной», а шипящие начинают свистеть.
- Ошибка волны остаётся даже при нормальном чертеже: вокодер добавляет шорох, щелчок или металлический призвук.
Пока всё это делает одна пошаговая сеть, ошибка раннего шага портит всё, что после. FastSpeech разнимает этот контур на части. Длительность каждой фонемы предсказывает отдельный маленький блок, два свёрточных слоя и линейный выход, а метки для обучения снимают с внимания модели-учителя. Дальше регулятор длины просто повторяет вектор фонемы нужное число кадров, и спектрограмму можно считать параллельно, а не слева направо. На наборе LJSpeech, одна дикторша, английская речь, спектрограмма получилась в 270 раз быстрее, чем у пошагового трансформера, а весь синтез — в 38 раз. Пропуски и повторы на трудных фразах авторы называют почти ушедшими. Скорость голоса меняется множителем на этих длительностях, без новой записи.
VITS, июнь 2021 года, делает следующий шаг: от текста до волны одна модель, без отдельного вокодера как второго изделия. Внутри вариационный автокодировщик, потоки и состязательное обучение. Важная для уха деталь — случайный предсказатель длительности. Один и тот же текст можно сказать быстрее и медленнее, выше и ниже, и такой разброс оказывается свойством живой речи. На том же LJSpeech полный VITS получил 4,43 балла, живая запись — 4,46. Tacotron 2 с вокодером HiFi-GAN в той же таблице — 3,77, и только после дообучения вокодера 4,25. Цифры одной лабораторной таблицы, английский, одна дикторша, на русский ролик переносить нельзя. Вывод переносится отдельно: качество зависит от того, отдан ли ритм отдельной модели и учится ли волна вместе с чертежом.
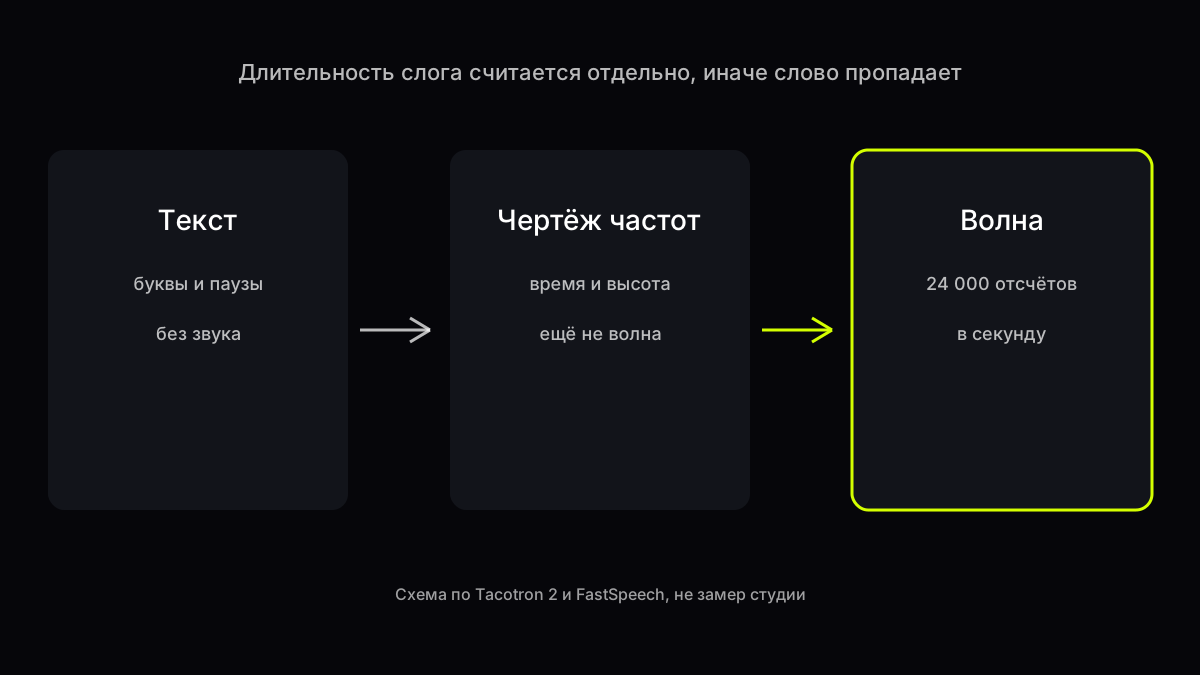
Источник: схема по статьям Tacotron 2 (16 декабря 2017) и FastSpeech (22 мая 2019)
Почему одна фраза выходит разной
Текст задаёт слова и при этом не задаёт, кто говорит и в каком настроении. Этот зазор лаборатории закрывают по-разному, и путаница в запросах «голос нейросети озвучка» растёт именно здесь.
У WaveNet диктор был условием: отдельный признак, и сеть переключала тембр. Записей этого человека должно было быть много. Новый тембр без записей этого человека не появлялся.
У VITS разнообразие отчасти случайное: высота и ритм гуляют даже у одного диктора, потому что так устроен предсказатель длительности. Заказать этим разбросом готовую эмоцию нельзя, зато без него речь звучит как метроном.
У текущего синтеза OpenAI, справка открыта 1 ноября 2026 года, рядом с текстом есть голос из списка и отдельное поле инструкций. Инструкцией задают акцент, диапазон эмоции, интонацию, скорость, тон, шёпот. Имена в списке оконечной точки: alloy, ash, ballad, coral, echo, fable, nova, onyx, sage, shimmer, verse, marin, cedar. Для лучшего качества справка сама советует marin и cedar. Модели tts-1 и tts-1-hd видят набор короче, девять имён, без ballad, verse, marin и cedar. Поле текста обрезано 4096 знаками, и длинный сценарий ролика одним куском туда не входит: его режут по фразам, иначе хвост просто не уедет в звук.
Голоса в этой справке оптимизированы под английский. Русский при этом есть в списке языков, который сервис делит с распознаванием Whisper: текст на русском сеть произнесёт, но тембр и ударение заточены не под него. Отсюда типичная картина «нейросеть озвучка русская»: слова узнаваемы, а ударение в фамилиях и в числительных плавает. Колонка здесь ни при чём: так выходит следствие того, на какой речи голос учили.
Отдельной развилкой остаётся свой голос. Справка OpenAI по пользовательским голосам делит два пути. Голос из текстового описания, без записи человека, в момент проверки поддерживается в режиме живого диалога, не в обычной озвучке файла. Голос из образца — наоборот: нужны запись согласия и короткий эталон, и уже такой идентификатор можно подать в синтез. Правила использования той же лаборатории требуют прямо сказать конечному слушателю, что голос создан моделью, а не человеком. Условие записано в правилах продукта, а не в подписи к кнопке.
Обещания и уже сделанное здесь лучше не склеивать. Отключение tts-1, tts-1-hd и gpt-4o-mini-tts назначено на 6 января 2027 года. До этой даты справка ещё описывает их как рабочий путь. После — это уже план миграции на другой интерфейс, и сегодняшняя кнопка «озвучить файл» может называться иначе. Имеет смысл смотреть дату страницы, а не пересказ годичной давности.
Что ломается на русской озвучке
Английские таблицы выше измеряли американскую речь одной дикторши, набор LJSpeech. Русский в тех статьях не звучал, и балл 4,53 на ролик для соцсети переносить нельзя: мешает устройство языка, а не вкус слушателя.
Ударение в русском подвижное, и «замок» с «замком» остаются разными словами при тех же буквах. Сеть, которая видит только строку, выбирает частый вариант. Редкое имя, топоним, название модели она прочитает по наиболее частому шаблону в своих парах. Проверка одна: слушать именно имена и числа, а не гладкую середину фразы. Середину фразы сеть почти всегда вытягивает.
С числительными отдельная беда: «14» можно сказать «четырнадцать» и «один четыре». Год «2026» в середине предложения и номер дома «2026» требуют разных чтений. Если в тексте оставить цифры, решение примет сеть, и оно будет устойчивым только на частых шаблонах. Надёжнее отдать ей уже развёрнутые слова, а спорное ударение пометить заглавной гласной или разбить слово дефисом так, как его произносят. Отдельной кнопки под этот приём нет, зато у сети пропадает выбор, в котором она слаба.
Латиница внутри русского абзаца, название модели, ссылка или аббревиатура, ставит сеть перед двумя чтениями. Она либо произнесёт буквы по-английски, либо попытается сложить из них русское слово. Оба варианта в ролике звучат как сбой, хотя технически это честное чтение входа. Имена вроде WaveNet в научной статье уместны. В дикторском тексте их лучше заменить русским описанием или произнести по слогам заранее, словами.
Предел в 4096 знаков у OpenAI — это несколько минут спокойной речи, не час лекции. Длинный текст режут по законченным фразам. На стыке кусков тембр иногда прыгает, потому что каждый запрос сеть начинает чуть заново, особенно если инструкция в поле настроения сформулирована по-разному. Один и тот же абзац настроения на все куски снижает скачок, хотя совсем его не убирает.
С паузой та же история. Запятая в живой речи часто обходится без остановки, а точка не всегда означает вдох. Сеть выучила среднюю связь знака и тишины. Там, где нужен вдох подлиннее, пустая строка или отдельный кусок надёжнее, чем надежда на многоточие. Многоточие разные системы читают по-разному: кто-то тянет гласную, кто-то ставит короткую дырку.
Видеоряд этот язык не чинит, потому что картинка и звук считаются отдельно. Если ролик собран в монтаже, длина дорожки и длина кадра обязаны сойтись на столе, а не «примерно». О том, как вообще устроен ролик из картинок, есть отдельный разбор нейросетей для видео, а механика генерации кадров описана в статье как нейросеть делает видео. Озвучка туда сама собой не встроена, её кладут отдельной дорожкой.
Озвучка видео: где кончается текст
Запрос «озвучка видео нейросетью» смешивает три разные работы, и из-за этого люди ждут от одной кнопки слишком много.
Первая работа касается слов: что сказано, в каком порядке, какие имена развёрнуты. Это всё ещё текст, его можно собрать заранее, в том числе в чате GPThub, и проверить глазами до того, как он станет звуком. Как формулировать задачу модели, чтобы она не раздувала абзац, разобрано в гайде как писать запросы. Готовый дикторский лист — короткие фразы, одна мысль на фразу, числа словами.
Вторая работа касается голоса. Текст и условие тембра превращаются в волну так, как описано выше, и на этом шаге картинки ещё нет. Хорошая дорожка — та, которую можно прослушать с закрытыми глазами и не потерять смысл.
Третья работа — укладка, когда дорожку кладут под кадры. Стык фразы и стык кадра лучше не совмещать в одной точке: и звук, и картинка прыгают одновременно, и глаз с ухом спорят. Запас в треть секунды тишины в начале и в конце дорожки спасает монтаж от обрезанного вдоха. Щелчок на склейке двух кусков почти всегда значит, что волны состыковали в случайной громкости, мимо нулевого пересечения. Это лечится короткой тишиной или стыком в паузе, не новой нейросетью.
Типичные ошибки на этом стыке повторяются.
- В кадр положили версию текста, а озвучили предыдущую. Имена в титрах и в голосе разъехались.
- Музыка оказывается громче речи именно на шипящих, а шипящие и так слабое место вокодера, так что музыка их добивает. Как сеть пишет саму музыку и почему вокал там считают отдельно, разобрано в статье нейросеть и музыка.
- Ролик вертикальный и короткий, а фраза написана как абзац статьи: ухо не успевает, и сеть тут ни при чём.
- Чужой голос знаменитости стоит на чужом видеоряде, и это уже выходит за ошибку монтажа.
Картинки к таким роликам живут отдельно от голоса. Практический разбор картинок — в гайде работа с картинками. Путать «модель нарисовала кадр» и «модель сказала фразу» не стоит: это разные сети, разные входы и разные сбои. Общий у них только текст, который вы им отдали.
Если нужен разбор того, как устроена языковая модель, начинать лучше с материала что такое DeepSeek. Та модель предсказывает следующее слово, а сеть озвучки предсказывает следующий отсчёт или следующий кадр спектра. Родство между ними есть, и оно ограниченное: слов в живой речи несколько в секунду, отсчёт же идёт двадцать четыре тысячи раз в секунду. Поэтому голос так долго был дороже текста, и поэтому склейка слогов прожила десятилетия. Она оставалась дешёвой.
Чужой голос и согласие
Сразу оговорка: это не юридическая консультация и не разбор вашей ситуации. Ниже только то, что написано в открытых документах на 1 ноября 2026 года, и то, чего в них нет.
Синтез сам по себе не равен подделке человека. Голос из заранее заданного списка, без образца конкретного лица, — это тембр, который выбрала лаборатория. Слушателя при этом правила OpenAI просят предупредить: говорит модель, не человек. Для ролика честная подпись в начале или в титрах эту просьбу закрывает. Прятать подпись в четвёртой строке описания площадки — слабый вариант, потому что её там не слышат.
Чужой голос начинается там, где на вход дали запись конкретного человека. В справке OpenAI такой путь без записи согласия не описан: нужны и согласие, и короткий образец того же говорящего. Запись с площадки, где человек что-то сказал в интервью, этим требованием не заменяется. Согласие на интервью журналисту и согласие на синтез своего тембра — разные разрешения, даже если оба когда-то прозвучали вслух.
Изображение в российском гражданском кодексе расписано жёстче, чем отдельное слово «голос». Статья 152.1 ГК РФ разрешает обнародовать изображение гражданина, в том числе фотографию и видеозапись, только с его согласия. Исключения узкие: государственный или общественный интерес, съёмка в месте, открытом для свободного посещения, если человек не главный объект, и позирование за плату. Синтезированный тембр в этой статье по имени не назван. Видеоряд, где синтетический голос положен на лицо человека, уже цепляет изображение. Голос без картинки статья 152.1 прямо не разбирает. Делать из этого вывод «значит, можно» нельзя. Делать вывод «статья всё запретила» тоже нельзя. Нормы про одно, практика про другое.
Уголовный кодекс на ту же дату не содержит отдельной статьи с словом «дипфейк». Проект № 1288702-8 предлагает добавить в статью 63 отягчающее обстоятельство: преступление с использованием сгенерированных аудиовизуальных материалов. В пояснительной записке приведена цифра АНО «Диалог Регионы»: 342 уникальных таких материала за первые девять месяцев 2025 года против 84 за весь 2024-й. Это аргумент авторов проекта, не приговор и не статистика суда. Пока проект не стал законом, опираться на него как на запрет нельзя, игнорировать сам риск тоже странно. Мошенничество остаётся мошенничеством и без специальной статьи про синтез. Голос родственника, который просит перевести деньги, опасен из-за доверия адресата, а устройство WaveNet тут вторично.
Практическое правило для креатора короче любого кодекса. Свой текст и студийный голос из списка — обычная озвучка, с подписью, что говорит модель. Запись чужого человека, даже короткая, даже «для пробы», даже знаменитости, которая «и так везде звучит», — это уже чужой тембр. Без прямого согласия на синтез такой файл лучше не собирать. Согласие имеет смысл хранить рядом с проектом, а не помнить «он в переписке не возражал».
Что слушать в готовой дорожке
Проверка не требует студии: нужны наушники и текст перед глазами.
Сначала имеет смысл слушать имена, марки и числа. Если они сошлись с листом, середина фразы почти наверняка тоже сойдётся. Если «GPThub» или фамилия поехали, править надо текст, а не крутить громкость. Сеть повторит ошибку на следующем куске с той же охотой.
Потом стоит пройти стыки: щелчок, двойное слово, пропавший предлог. Двойное слово остаётся следом соскользнувшего внимания у старых пошаговых сетей и следом кривой нарезки у новых. Пропавший предлог часто значит, что кусок обрезали посередине синтаксиса, и границу лучше вернуть на точку.
Потом слушают шипящие и свист на «с», «ш», «ч», и это уже слой волны, а не слой смысла. Если свист есть на всех голосах списка, виноват вход: слишком агрессивная инструкция вроде «очень чётко и громко» поднимает именно эти частоты. Если свист только на одном имени голоса, смените имя. Справка сама советует два имени, marin и cedar, но короткую пробу на вашем тексте это не заменяет.
В конце — одна фраза, прослушанная дважды с разницей в час. То, что в первый раз казалось «нормальным роботом», во второй раз часто оказывается кривым ударением. Ухо привыкает быстро, а заказчик откроет ролик один раз и привыкать не станет.
Текст листа, если его пишет модель в чате, стоит ограничить вводными. Попросите короткие фразы, числа словами, без английских вставок, без обращений к зрителю через каждое предложение. Длинный комплимент в начале дорожки съедает и лимит знаков, и терпение. Модель языка охотно добавляет такой комплимент, потому что в учебных текстах зачины встречаются часто. В дикторской дорожке такой зачин оказывается мёртвым временем.
Дальше техника будет менять оболочку быстрее, чем ухо. Пошаговый отсчёт, чертёж частот, параллельная длительность, одна модель до самой волны — четыре слоя за пять лет, с 2016-го по 2021-й, и после них промышленные сервисы всё ещё режут текст на куски по несколько тысяч знаков. Если завтрашняя новость обещает «голос, неотличимый от актёра», полезно проверить, на каком языке измеряли оценку и просили ли слушателя сравнить со знакомым человеком вслепую. Балл 4,43 на английской дикторше этот вопрос не закрывает. Согласие того, чей тембр взяли за образец, не закрывает тем более.
Вопросы и ответы
Как нейросеть озвучивает текст?
Строку она не читает вслух. Текст переводят в последовательность единиц, для каждой оценивают длительность, строят картину частот и по ней собирают волну из тысяч отсчётов в секунду. В схеме Tacotron 2 за картину и за волну отвечали две сети. В VITS обе части собраны в одну модель, слова на входе те же, а путь внутри другой.
Какая нейросеть для озвучки нужна для русского ролика?
Та, у которой вы можете прослушать именно ваши имена и числа, а не демо-фразу лаборатории. Голоса OpenAI на ноябрь 2026 года оптимизированы под английский, русский при этом в списке языков есть. Гладкое демо на английском ничего не говорит об ударении в русской фамилии. Лист лучше отдать уже с развёрнутыми числительными.
Чем нейросеть озвучка русская отличается от перевода?
Перевод меняет сами слова, а озвучка произносит уже готовые. Если отдать англоязычной по ударению сети русский текст, она прочитает строку с чужим ритмом и ничего при этом не переведёт. Ошибки ударения лечатся правкой листа, а не сменой языка интерфейса.
Что такое голос нейросети в озвучке?
В старой схеме это архив записей одного человека. В схеме после WaveNet это условие: признак диктора или имя из списка, иногда плюс короткая инструкция про темп и тон. У OpenAI в списке оконечной точки 13 имён, текст одного запроса не длиннее 4096 знаков. Имя из такого списка остаётся ярлыком тембра, а не биографией человека.
Можно ли сделать озвучку видео нейросетью одним шагом?
Слова, волна и укладка под кадр — три работы. Картинка эти три работы сама не синхронизирует. Дорожку проверяют отдельно, с текстом перед глазами, и кладут в монтаж с короткой тишиной по краям, иначе вдох обрежется ровно на склейке.
Как сделать озвучку нейросетью и не взять чужой голос?
Брать тембр из списка лаборатории, без загруженной записи конкретного человека, и подписывать, что говорит модель. Запись согласия нужна именно тогда, когда голос собирают из образца. Статья 152.1 ГК РФ прямо защищает изображение и видеоряд. Отдельного имени «голос» в ней нет, и это не разрешение.
Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
Ещё по теме
Источники
- WaveNet: A Generative Model for Raw Audio, arXiv, 12 сентября 2016
- WaveNet, страница Google DeepMind
- Tacotron, arXiv, 29 марта 2017
- Tacotron 2, arXiv, 16 декабря 2017
- FastSpeech, arXiv, 22 мая 2019
- FastSpeech, блог Microsoft Research, 11 декабря 2019
- VITS, arXiv, 11 июня 2021
- Таблица оценок VITS, HTML arXiv
- Text to speech, документация OpenAI, сверка 1 ноября 2026
- Create speech, ограничение 4096 знаков
- Custom voices, OpenAI
- Статья 152.1 ГК РФ, КонсультантПлюс
- Пояснительная записка к проекту № 1288702-8, ГАРАНТ
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Собрать текст ролика в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.