
Клонирование голоса: как это устроено и почему чужой голос копировать нельзя

Обозреватель: как устроен ИИ
Содержание
29 марта 2024 года OpenAI описала модель Voice Engine. На вход ей давали текст и один звуковой кусок длиной 15 секунд, на выходе получалась речь, близкая к голосу человека с этой записи. Широкой кнопки «сделай чужой голос» компания тогда не открыла. Клонирование голоса устроено именно так. Сеть достраивает новые звуки в чужой манере, а исходный файл целиком на выход не попадает. Ниже — как это считается и почему чужую запись для такой достройки брать нельзя. Как вообще устроен синтез речи из текста, разобрано в статье про синтез речи; здесь речь о голосе конкретного человека.
Чем клонирование голоса отличается от обычной озвучки
Озвучка текста готовым голосом и клонирование голоса решают разные задачи. В первом случае диктор заранее начитан в студии, а программа только подставляет новые слова в уже собранный голос. Во втором сеть должна сказать фразу, которой в исходной записи не было, и при этом звучать как конкретный человек.
Привычная картинка здесь — монтажный стол, где дорожку режут на слоги и склеивают заново. Так и работал склеечный синтез, который DeepMind в сентябре 2016 года описывал как тогдашнюю норму. Большая база коротких кусков одного говорящего, потом сборка фразы. Поменять ударение, эмоцию или самого говорящего без новой базы было трудно. Параметрические системы хранили голос в числах модели, но звук всё равно прогоняли через вокодер, и речь выходила суше живой.
WaveNet сломал эту схему другим ходом: сеть моделирует саму волну, отсчёт за отсчётом, без отдельного вокодера на выходе, и тот же ход узнаётся в более поздних системах, где сначала есть портрет того, как звучит человек, потом текст, который надо произнести, и только затем волна, которой в файле-образце не существовало.
Поэтому фраза «нейросеть копирует голос» легко врёт уже в глаголе. Копия файла звучала бы только теми словами, которые человек произнёс. Клон говорит то, чего человек не говорил. Сходство сидит в тембре, в дыхании, в том, как тянутся гласные, а не в совпадении дорожки.
Отдельная оговорка про продукты. Готовый голос в интерфейсе, который компания набрала у актёров и всем раздаёт одинаковым, — это библиотека, не клон случайного прохожего. OpenAI в июне 2024 года писала, что голосовой режим ChatGPT в сентябре 2023 года как раз включили на таких отобранных голосах. Отбор начался в мае 2023 года, с актёрами и агентствами. Это другая полка, чем образец на 15 секунд из поста марта 2024 года.
Как нейросеть для клонирования голоса считает звук
Звук в файле — ряд чисел, и в посте DeepMind от 8 сентября 2016 года обычная частота названа прямо: 16 000 отсчётов в секунду и больше, так что на каждом отсчёте сеть должна ответить, какое значение волны вероятнее всего следующим, опираясь на все предыдущие отсчёты, после чего выбранное число возвращают на вход и шаг повторяется.
Окно, в которое сеть смотрит назад, у WaveNet растили свёртками с разным шагом пропуска, без отдельной памяти на всю запись. Глубокий слой видит тысячи предыдущих отсчётов. Для уха это уже кусок слога, не одна точка на графике.
Текст в эту машину сам не записывается буквами. Его переводят в признаки: какая сейчас фонема, какой слог, какое слово. Без этой ленты сеть всё равно порождает речь. DeepMind выложил образцы такого лепета. Настоящие слова перемешаны со звуками, которые только похожи на слова. Дыхание и шорох рта тоже вылезают, потому что они были в обучающих волнах. Для клонирования это важная развилка: без текста голос болтает, а с текстом читает то, что ему подложили, в том числе фразу, которую живой человек никогда не произносил.
Личность говорящего в том эксперименте была ещё одним входом. Одну и ту же фразу можно было сдвинуть на другого диктора из обучающего набора. И тут вылез перенос умения. Сеть, учившаяся на многих людях, лучше держала одного человека, чем сеть, которую кормили только его записями. Чужие часы речи учат общему устройству голоса. Свой кусок потом только выбирает, кого из этого устройства изобразить.
Эмоцию и акцент авторы 2016 года назвали возможными добавочными входами. Это было обещание направления, не список уже выпущенных ручек. Путать «можно подать на вход» и «в продукте есть ползунок „злость“» не стоит.
Поздние модели считают быстрее и просят более короткий личный образец, но развилка та же: статистика речи вообще, короткий якорь конкретного человека, текст новой фразы и на выходе волна, собранная заново.
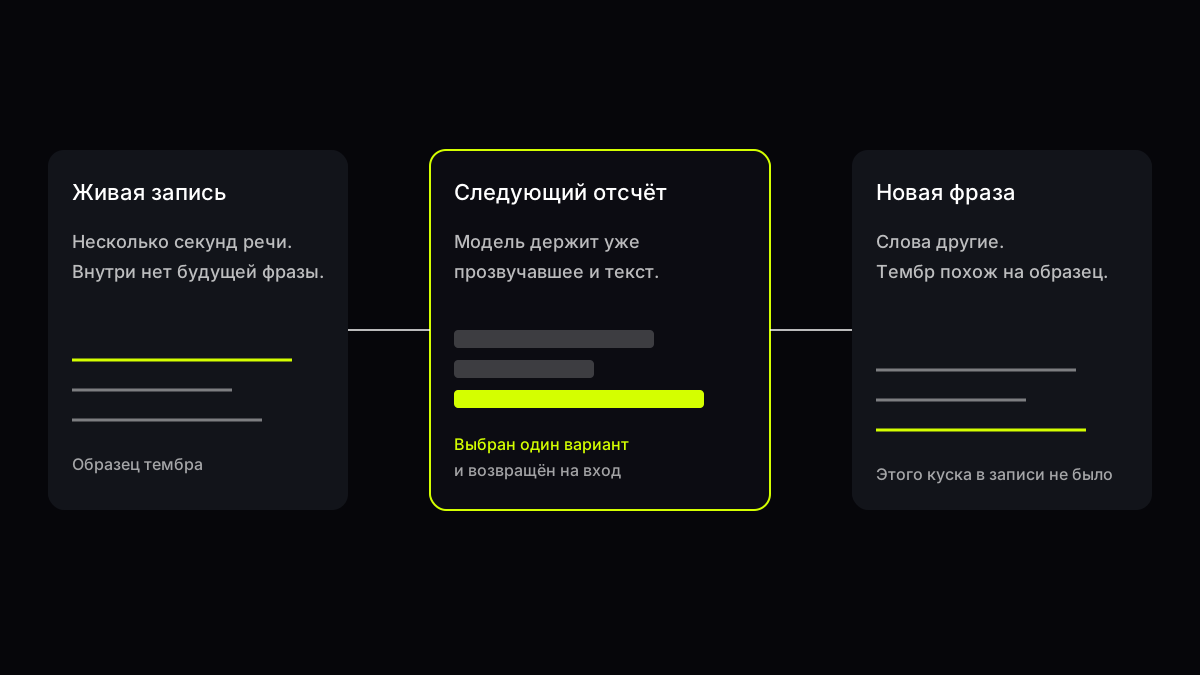
Источник: схема по описанию WaveNet, DeepMind, 8 сентября 2016
Почему хватает короткой записи
Ранний WaveNet был исследовательской машиной, не кнопкой в телефоне. На обзорной странице DeepMind прямо сказано, что первые версии тратили часы на одну секунду звука. 4 октября 2017 года ту же линейку включили в Google Assistant для японского и американского английского. Ускоренная сеть оставалась генератором сырой волны, но работала в тысячу раз быстрее исходной. На одну секунду речи уходило 50 миллисекунд. Частота поднялась до 24 000 отсчётов в секунду, разрядность каждого отсчёта — с 8 до 16 бит, как у компакт-диска. Слушатели в тестах компании назвали результат естественнее прежнего.
22 ноября 2017 года DeepMind объяснил, откуда взялась скорость. Исходная сеть строила отсчёты строго по очереди, до 24 000 штук на секунду звука. Для продукта это было медленно. Уже обученную сеть посадили учителем. Ученик, меньше и параллельнее, перенял её распределения. Имя приёма в статье — дистилляция плотности вероятности. Для читателя достаточно следствия. Качество удержали, а ждать часами одну секунду перестали.
Дальше лаборатории стали учить общий речевой навык на десятках тысяч часов, а одного диктора неделями уже не запирали в отдельную студию. 16 июня 2023 года Meta описала Voicebox, модель заполнения: ей дают кусок звука и текст, она достраивает недостающую речь. Обучали на более чем 50 тысячах часов записей, которые, по словам компании, не фильтровали и не чистили заранее. В тот день веса не выложили. Наружу ушли образцы, статья и описание классификатора, который отделяет живую речь от речи этой модели.
В карточке той же статьи Meta приводит свой замер. На задаче синтеза без отдельного дообучения на конкретном дикторе ошибка слов у Voicebox — 1,9 процента против 5,9 процента у системы VALL-E, с которой они себя сравнивали. Оценка сходства с целевым голосом — 0,681 против 0,580. Скорость они оценили как до двадцати раз выше. Это колонка из их статьи, не независимый экзамен и не рейтинг «лучшее клонирование голоса» для бытовой программы. Слово «лучшее» в поиске обычно ищет именно такую программу. У открытого замера другой вопрос. Насколько текст ещё можно разобрать и насколько волна похожа на образец в метрике авторов.
29 марта 2024 года OpenAI показала, до какой короткой личной записи дошло дело в их закрытой пробе. Voice Engine брала текст и 15 секунд речи. Модель, по их словам, собрали ещё в конце 2022 года. Готовыми голосами того же семейства уже кормили текстовый интерфейс синтеза и голосовой режим ChatGPT. Саму возможность «принести любой образец» широкой публике не отдали. Пробовала её маленькая группа партнёров.
В условиях той пробы было четыре жёстких пункта. Нельзя выдавать себя за другого человека или организацию без согласия или законного права. Нужно явное и осознанное согласие того, чей голос в образце. Нельзя строить продукт, где конечный пользователь сам заводит голос. Слушателю надо прямо сказать, что голос сделан моделью. Плюс водяные знаки, по которым звук можно отнести к системе, и мониторинг того, как партнёры этим пользуются. Для будущего широкого выпуска OpenAI отдельно назвала проверку, что человек сам сдаёт голос, и список голосов, слишком похожих на известных людей.
Короткая запись работает не оттого, что в пятнадцати секундах «лежит весь человек»: в них лежит якорь, общий навык речи сеть уже выучила на других, и якорь только выбирает, какой тембр из этого навыка изобразить на новом тексте. Риск в том, что фразы, которой человек не говорил, в образце нет и не должно быть, а на выходе она всё равно появляется.
Клонирование русского голоса и запись из видео
Отдельной физики «для русского» в этих работах нет: отсчёт волны алфавита не разбирает, язык сидит в тексте, который превращают в звуки, и в том, на какой речи сеть училась тянуть гласные.
Прямой пример есть в том же посте OpenAI от 29 марта 2024 года. Когда Voice Engine переводила речь, акцент образца сохранялся. Английская фраза по французской записи звучала с французским акцентом. Для клонирования русского голоса вывод практический. Образец на другом языке не становится сам по себе чистой русской дикцией. Манера исходного говорящего едет вместе с тембром. Насколько ровно конкретная сеть держит русские шипящие, по открытым страницам Google, Meta и OpenAI одной цифрой не скажешь. Таких таблиц в прочитанных первоисточниках нет, и выдумывать процент чистоты не из чего.
Запрос «клонирование голоса из видео» описывает источник файла, не другой алгоритм. У ролика есть дорожка. Если на ней говорит человек, это та же запись, что диктофон, только рядом лежит картинка. В пилоте, который OpenAI приводила как медицинский пример, голос пациентки после опухоли восстановили по школьному видео. Длина и чистота той дорожки в посте не разобраны. Важен факт. Картинка понадобилась как контейнер звука, не как чертёж связок.
Лицо на кадре — соседняя задача, про движение картинки. Ей место в разговоре о роликах, и подробно она разобрана в статье про аватары и дипфейки. Как нейросети вообще собирают видео из кадра и описания, разобрано в материале про нейросети для видео. Смешивать два контура опасно вот чем. Человек видит знакомое лицо и слышит похожую речь и решает, что узнал человека. Банк России 16 сентября 2024 года обновил страницу, где этот приём описан как инструмент кражи денег. Нейросетью делают видео, голос «иногда сложно отличить» от прототипа, герой просит перевод. Повод в их перечне — болезнь, ДТП, увольнение. Съёмку и запись, пишет регулятор, чаще берут из взломанного аккаунта или собирают фальшивую страницу с именем и фото.
Приложение клонирования голоса и «программа для клонирования голоса» в поиске обещают одну кнопку на этот контур. Имена таких оболочек здесь не разбираются. Крупные лаборатории, чьи документы открыты, как раз не отдали эту кнопку конечному пользователю. Meta в июне 2023 года оставила у себя веса Voicebox. OpenAI в марте 2024 года не пустила Voice Engine в широкий доступ и прямо запретила партнёрам делать пользовательский конструктор голоса. Обещание случайного приложения в магазине эту развилку не отменяет. Короткий якорь плюс новый текст дают фразу, которой человек не говорил. Откуда скачана оболочка, на устройство волны не влияет.
Почему чужой голос копировать нельзя
Чужой голос в этой схеме — не стиль шрифта и не фильтр на фото. На выходе человек, который вас знает, может решить, что говорил живой знакомый. В правилах использования OpenAI запрет сформулирован так. Нельзя использовать подобие человека, включая фотореалистичное изображение или голос, без его согласия, если из-за этого можно перепутать подделку с настоящим. Рядом отдельной строкой стоят обман, мошенничество и выдача себя за другого. Правила разработчика не равны приговору суда. Они показывают, где сама лаборатория проводит черту, и эту черту статья не предлагает обходить.
В закрытой пробе марта 2024 года планка была ещё уже. Даже согласие «вообще когда-то записать меня» им не хватало. Нужно явное согласие именно на этот синтез, и слушатель должен слышать, что говорит модель. Водяной знак они описывали как способ проследить происхождение звука, не как гарантию, что ухо само разоблачит ролик. Как такие метки устроены и почему их можно потерять, объясняет статья про водяные знаки нейросетей.
Дальше — российские нормы, и здесь нужна оговорка. Это пересказ открытых текстов закона на 1 ноября 2026 года, не консультация и не разбор вашего ролика. Юрист смотрит факты, которых в статье нет.
Статья 11 закона № 152-ФЗ «О персональных данных» называет биометрией сведения о физиологических особенностях, по которым можно установить личность, если оператор как раз использует их, чтобы личность установить. Обработка таких сведений — с письменного согласия. Часть 2 даёт закрытый перечень, где согласие не спрашивают. Там международные договоры о реадмиссии, правосудие, государственная дактилоскопия и геномная регистрация, оборона, безопасность и другие режимы, перечисленные в самой части. Вне этого перечня биометрию нельзя делать обязательной платой за услугу.
Роскомнадзор ещё 30 августа 2013 года разъяснял второе условие. Мало того, что снимок или другой след характеризует тело. Надо, чтобы им устанавливали личность. В пересказе тюменского управления от 7 октября 2013 года фото в личном деле, подпись в договоре и снимок в медкарте сами по себе биометрией не названы. Для голоса логика та же, и она режет обе крайности. Лекция на конференции не становится автоматически биометрической базой только потому, что в ней есть тембр. И наоборот. Запись, которой подтверждают «это он звонит, переводите», как раз попадает в цель нормы. Установление личности здесь и есть вся затея.
Статья 152.1 Гражданского кодекса охраняет изображение. В тексте — фотография, видеозапись, произведение, где человек изображён. Согласие нужно, с известными исключениями. Публичный интерес, съёмка в открытом месте, если человек не главный объект, позирование за плату. Отдельной формулы «голос гражданина охраняется так же» в этой статье нет. Переносить на тембр правила кадра один к одному нельзя. Если в ролике есть и лицо, и речь, изображение живёт по 152.1, а звук надо смотреть отдельно. Дыры в бытовом ожидании «раз лицо нельзя, значит и голос по той же статье нельзя» отсюда и растут.
С 11 декабря 2024 года в Уголовном кодексе есть статья 272.1. Её ввёл закон от 30 ноября 2024 года № 421-ФЗ. Часть 1 говорит о незаконных использовании, передаче, сборе или хранении компьютерной информации с персональными данными, если эти данные добыты неправомерным доступом или иным незаконным путём. Часть 2 называет более тяжёлым тот же состав, когда информация касается несовершеннолетних, специальных категорий или биометрических персональных данных. Суммы штрафов и сроки в этой статье не пересказываются. Их легко перепутать с редакцией, а читателю для бытового вывода хватает состава. Чужая компьютерная запись личности, добытая незаконно и пущенная дальше, — уже не «просто файл».
Отдельной статьи со словом «дипфейк» в открытых карточках кодекса, на которые опирается этот текст, нет. Если просьба в поддельном голосе — про деньги, включается обычное мошенничество, и его квалификация зависит от того, что именно сделали. Банк России описывает типовой сюжет, не статью приговора. Регулятор прямо пишет, что голос иногда трудно отличить от прототипа. Значит, расчёт злоумышленника строится на спешке получателя, а студийная чистота копии ему не обязательна.
Что проверять, если знакомый голос просит деньги
Страница Банка России, обновлённая 16 сентября 2024 года, даёт бытовой порядок, и он не требует экспертизы волны. Сначала деньги не отправляют, и только потом звонят человеку по номеру, который и раньше набирали сами, минуя кнопку «перезвонить» внутри подозрительного чата. Аккаунт могли угнать, страницу могли собрать заново с чужим именем и чужим фото.
Если трубку взять нельзя, регулятор советует вопрос, ответ на который знает только ваш знакомый. Общий вопрос из серии «как дела» синтез как раз и закроет. Личная деталь, которой не было в открытых роликах, у короткого якоря не хранится. Сеть достроит уверенную интонацию. Факта за ней нет.
Признаки, которые Банк России предлагает слушать и смотреть, скромные: неестественная монотонность, дефекты звука и картинки, мимика, которая этому человеку не свойственна. Это не тест «если дефекта нет, перед вами человек». Сами лаборатории пишут, что разрыв с живой речью сузили ещё в 2016 году больше чем наполовину по их шкале MOS. Шкала — средняя оценка слушателей от 1 до 5, в том замере больше 500 оценок на 100 фразах, слепым сравнением с тогдашними системами Google и с живой речью. Монотонность остаётся уликой, когда она есть. Её отсутствие улику не снимает.
| Что пришло | Что сделать сначала |
|---|---|
| Голосовое или видео от «знакомого» с просьбой перевести деньги | Не переводить. Позвонить по старому номеру |
| Звонок из мессенджера, голос похож, тема — срочная беда | Сбросить и набрать самому. Не продолжать разговор в том же чате |
| Позвонить нельзя | Личный вопрос, ответа на который нет в открытых записях |
| Ровная речь без срывов и без дефектов | Всё равно проверить звонком. Чистота звука личность не доказывает |
Дальше имеет смысл отделять три разных утверждения, которые в переписке слипаются. «Мне кажется, это его тембр» остаётся впечатлением, «файл собран моделью» — уже технический вопрос, и у Meta для своей Voicebox был отдельный классификатор, а не догадка на слух, тогда как «это он просит деньги» является выводом о живом человеке, и первое впечатление этот вывод не доказывает. Второе, даже если когда-нибудь подтвердится меткой разработчика, тоже не заменяет звонок. Метка говорит о происхождении волны. Она не говорит, что живой человек эту фразу одобрил.
OpenAI в марте 2024 года как раз просила общество отходить от входа в банк и в другие чувствительные кабинеты по одному голосу. Рядом — привычка помечать, где звук и картинка сделаны моделью, и прямо объяснять людям, что убедительная подделка возможна. Пока метка не приезжает вместе с каждым файлом в мессенджере, рабочий остаток один. Канал, который вы контролируете сами, важнее качества тембра.
Что имеет смысл спросить у текстовой модели
Текстовый чат не произносит чужим голосом и не должен получать чужую дорожку «чтобы попробовать». Он умеет разложить уже опубликованные правила. Это полезно, когда страница Банка России или пост лаборатории написаны плотно, а решить надо за минуту, переводить или нет.
Имеет смысл просить пересказ уже написанного правила. Например, попросить разложить абзац регулятора на три столбца. Что является просьбой о деньгах, что является проверкой личности, чего в тексте нет. Второй запрос — попросить отделить в посте OpenAI описание закрытой пробы от того, что компания прямо запретила партнёрам. В ответе должны остаться согласие говорящего, запрет пользовательского конструктора и обязанность сказать слушателю, что голос синтетический. Если модель предлагает формулировки, которыми можно уговорить сеть изобразить названного человека, ответ непригоден. Его выбрасывают целиком, не «оставляют полезную половину».
Проверять такой ответ легко. Каждое имя лаборатории и каждая дата должны находиться на открытой странице, а не только в пересказе чата. Ссылки на законы сверяют с карточками кодекса, не с абзацем модели. Типичная ошибка — принять гладкий текст за заключение эксперта. У чата нет вашей дорожки, нет постановления и нет права сказать «это точно он» или «это точно синтез». Как выбирать модель, когда вопрос длинный и фактический, разобрано в гайде как выбрать модель. Устройство сильных текстовых сетей, которые как раз любят уверенно достраивать пропуски, — в заметке что такое DeepSeek. Достройка пропуска в тексте и достройка отсчёта в волне похожи повадкой. Обе заполняют то, чего во входе не было, и обе делают это уверенным тоном.
В чате GPThub эти текстовые модели открываются как обычный диалог. Ждать от них кнопки «клон голоса» не нужно. Её нет в задаче этого разбора, и у лабораторий, на которых опирается текст, такая кнопка для произвольного чужого образца в широкий доступ не выходила.
Вопросы и ответы
Клонирование голоса нейросетью — это копия файла?
Нет, если говорить о системах вроде WaveNet, Voicebox и Voice Engine. Файл-образец задаёт манеру. Новые слова собираются заново, отсчёт за отсчётом или заполнением пропущенного куска. В образце этих слов не было.
«Клонирование голоса ИИ» и «нейросеть клонирует голос» — одно и то же?
Да, это разные слова для одного приёма. В документах лабораторий приём называется синтезом речи по образцу говорящего. Отдельной технологии под каждым названием в постах Google, Meta и OpenAI нет.
Клонирование голоса нейросеть на русском работает иначе?
Волну считают так же. Меняются текст и то, на какой речи сеть училась. OpenAI прямо писала, что акцент образца сохраняется при смене языка фразы. Отдельной таблицы «чистота русского» в открытых постах, на которые опирается статья, нет.
Нужен ли особый текст для клонирования голоса?
Особый заклинательный текст не нужен и здесь не приводится. Модели из открытых описаний как раз и опасны тем, что читают обычную фразу. Любая новая просьба, которой не было в образце, может прозвучать чужим тембром. Поэтому текст «для клона» не публикуется. В образце его всё равно нет.
Приложение клонирования голоса делает процесс другим?
Оболочка меняет кнопки, не физику. Короткий якорь и новый текст дают фразу, которой человек не говорил. Meta не выложила веса Voicebox. OpenAI не отдала Voice Engine широкой публике и запретила партнёрам пользовательский конструктор голоса.
Нейросеть копирует голос из видео сильнее, чем из аудио?
Дорожка ролика — это аудио в контейнере. Лицо на кадре тембр не усиливает. Банк России описывает связку. Картинка плюс похожая речь бьют по доверию сильнее, чем голос один, потому что человек узнаёт лицо. Это психология узнавания, не более точная копия связок.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- WaveNet: A generative model for raw audio, DeepMind, 8 сентября 2016
- WaveNet launches in the Google Assistant, DeepMind, 4 октября 2017
- High-fidelity speech synthesis with WaveNet, DeepMind, 22 ноября 2017
- Voicebox, Meta, 16 июня 2023
- Карточка статьи Voicebox, Meta, 16 июня 2023
- Navigating the challenges and opportunities of synthetic voices, OpenAI, 29 марта 2024
- Expanding on how Voice Engine works, OpenAI, 7 июня 2024
- Usage policies, OpenAI
- Мошенники обманывают людей с помощью дипфейков, Банк России, обновление 16.09.2024
- Статья 11 152-ФЗ, КонсультантПлюс
- Разъяснение Роскомнадзора 2013 года, пересказ на сайте управления по Тюменской области
- Статья 152.1 ГК РФ, КонсультантПлюс
- Статья 272.1 УК РФ, Гарант
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.