
Как нейросеть создает изображение
Обозреватель: как устроен ИИ
Содержание
1 августа 2024 года лаборатория Black Forest Labs выложила семейство FLUX.1. Все публичные варианты стоят на одной схеме: гибрид мультимодальных блоков и параллельных диффузионных трансформеров, 12 миллиардов параметров, обучение согласованием потоков. В том же анонсе метод назван общим, а диффузия — его частным случаем. Картинка при таком счёте не появляется сразу. Её собирают из шума, шаг за шагом. Короткого ответа на вопрос, как нейросеть создает изображение, в одном предложении нет. Сначала стоит посмотреть, от чего отказались до этой схемы.
Откуда взялся шум
10 июня 2014 года Ян Гудфеллоу с соавторами описал другую схему. Две сети спорят. Одна предлагает картинку, вторая пытается отличить её от настоящей. Победитель в этом споре рисует убедительно, но учится капризно: сети легко застревают, и разнообразие падает. Следующий ход описали в марте 2015 года.
В марте 2015 года Джаша Сол-Дикстейн и соавторы взяли приём из неравновесной термодинамики. Данные портят итерациями случайного шума, пока от исходной структуры не останется почти ничего. Затем учат обратный ход, который структуру возвращает. В статье 2020 года Джонатан Хо, Аджей Джейн и Питер Аббель довели этот ход до качества, с которым уже сравнивали тогдашние сильные модели. На безусловном CIFAR-10 их модель получила оценку Inception 9,46 и FID 3,17. На LSUN со стороной 256 точек качество было сравнимо с ProgressiveGAN.
FID здесь — число, насколько набор сгенерированных кадров похож на набор настоящих. Меньше обычно лучше. Цифра 3,17 относилась к крошечным кадрам CIFAR-10, не к сегодняшнему плакату. Сравнивать её с рекламой модели 2026 года бессмысленно: другой размер, другой набор, другая задача.
На странице проекта той же работы стоят примеры CelebA-HQ 256×256, и под ними прямая оговорка: это не реальные люди, места, животные или предметы. Лица на тех кадрах выдуманы. Выдуманы как выборка из распределения, которое сеть выучила, а не как выдача из паспортного стола.
Публичный толчок случился позже, когда счёт стал дешёвым. 10 августа 2022 года Stability AI объявила первый этап выпуска Stable Diffusion для исследователей. Веса обещали положить на Hugging Face после получения доступа, публичный выпуск был ещё впереди. Патрик Эссер из Runway и Робин Ромбах из Мюнхена опирались на латентные диффузионные модели, доложенные на CVPR 2022. Кадр 512×512 считался на потребительской видеокарте с памятью меньше 10 ГБ, за несколько секунд. Обучение шло на кластере Ezra-1 из 4000 ускорителей Nvidia A100. В бете сидело больше 10 тысяч человек, и они делали 1,7 миллиона изображений в день.
22 августа 2022 года веса открыли шире. Лицензия Creative ML OpenRAIL-M разрешала коммерческое и некоммерческое использование. Она же перекладывала этичное и законное применение на того, кто берёт модель, и требовала сопровождать любое распространение. В комплекте по умолчанию шёл классификатор безопасности: он смотрит на выход и убирает то, чего пользователь может не хотеть. Параметры этого фильтра в том же анонсе названы настраиваемыми. Рекомендованные веса — v1.4, 470 тысяч шагов, на несколько шагов дальше исследовательской v1.3 с отметкой 440 тысяч. Память на выпуске — 6,9 ГБ.
С этого дня схема «шум, потом картинка» перестала быть только статьёй. Её можно было запустить у себя.
Между 10 и 22 августа есть зазор, и он многое объясняет в сегодняшних продуктах. Сначала доступ был с заявкой, для исследователей. Через двенадцать дней тот же каркас открыли шире, уже с лицензией и с классификатором в комплекте. Лицензия — юридическая петля: правила едут вместе с моделью. Классификатор — отдельная программа в пакете, не понимание модели о том, что можно. Путают их до сих пор. Фраза «модель сама знает границу» здесь не работает. Границу на выпуске 22 августа держал фильтр рядом с весами, и его параметры можно было менять.
Цифра из исследовательского анонса легко теряется рядом с памятью видеокарты. 1,7 миллиона изображений в день при бете больше 10 тысяч человек — это уже нагрузка, а не стенд на конференции. Какие именно запросы люди повторяли, тот пост не публиковал. Из цифры не следует, что портрет победил пейзаж. Это отдельный вопрос, и ответ на него ищут на готовом кадре, не в пресс-релизе.
Почему сравнение с художником врёт
Привычная картинка такая. Художник видит чистый лист и кладёт мазок за мазком, пока не появится яблоко. У диффузионной модели лист в начале не чистый. Он забит случайными точками. Модель не добавляет краску. Она угадывает, какая часть этого поля — шум, и этот шум вычитает.
Поправка важная. Если думать кистью, кажется, что модель знает координату глаза и ставит его туда. На раннем шаге глаза ещё нет. Есть статистика: при таком уровне шума и таком тексте правдоподобные картинки выглядят вот так. Глаз проявляется, когда шума остаётся мало и соседние точки уже держат форму.
Ещё одно следствие. Два запуска с одним текстом и разным начальным шумом дают двух разных людей. Память тут ни при чём. Начальное поле и есть жребий, из которого модель выбирает один кадр из огромного множества подходящих.
Общий ход короткий. Испортить фотографию шумом легко, формула известна заранее, учить её не надо. Учить надо только обратное: по испорченному кадру и по номеру шага предсказать шум. На выводе формулу крутят назад десятки раз. У быстрых дистиллированных моделей шагов мало, у тяжёлых больше. Точное число у каждой семьи своё, и в анонсе FLUX.1 его не публиковали одной цифрой на все три варианта.
Полезно разложить один кадр на три момента, без претензии на внутренний журнал конкретной модели. В первом моменте поле ещё похоже на телевизионный снег. Текст запроса уже подмешан, но глазу почти не за что зацепиться: сеть вычитает только самую грубую долю шума, и наружу проступает пятно света и пятно тени. Во втором моменте пятна слипаются в контур. Здесь решается, человек это или ваза, и ошибка этого момента дороже всех остальных. Если контур уехал, последние шаги честно дорисуют ресницы на кривой голове. В третьем моменте шума мало, и сеть занимается фактурой: ткань, кожа, блик на кружке. Именно третий момент люди называют детализацией и пытаются усилить прилагательными. Прилагательные приходят в текст с самого начала, они не включают отдельный режим. Они лишь сдвигают то, какой шум сеть считает лишним на всех трёх моментах сразу.
Как нейросеть создает изображение
Один шаг выглядит бедно. На входе шумное поле и номер шага. Сеть, чаще всего раньше это была U-Net, а у новых семей трансформер, выдаёт оценку шума. Эту оценку вычитают, поле становится чуть чище, номер шага уменьшают. И так до конца.
U-Net здесь — сеть, которая смотрит кадр и в крупном масштабе, и в мелком, а потом собирает ответ обратно в тот же размер. Трансформер режет скрытое поле на куски и обрабатывает их как последовательность, с вниманием между кусками. В статье Уильяма Пиблза и Сайнинга Се, выложенной 19 декабря 2022 года, U-Net заменён трансформером по скрытым кускам. Крупнейшая модель DiT-XL/2 получила FID 2,27 на класс-условном ImageNet 256×256 и обошла прежние диффузионные модели ещё и на 512×512. Классом там служила метка вроде «собака», без свободного текста. Для бытового запроса этого мало, но архитектуру после этой работы стали растить вглубь.
Считать шум прямо в пикселях дорого. Робин Ромбах и соавторы в статье от 20 декабря 2021 года (правка 13 апреля 2022 года, доклад на CVPR 2022) пишут, что мощные диффузионные модели в пикселях съедают сотни дней видеокарт, а вывод дорог из-за последовательных оценок. Их ход — перенести диффузию в скрытое пространство заранее обученного автокодировщика. Картинку сжимают, шумят уже сжатый код, в конце код разжимают обратно в пиксели. Мелкая фактура при этом остаётся заботой автокодировщика, его учат отдельно.
Потеря при обучении простая. В скрытый код добавляют известный шум. Сеть должна этот шум назвать. Если назвала близко, веса чуть поправляют. Длинная череда таких поправок и есть умение рисовать. Отдельной строки «у человека два глаза» в коде нет. Если ограничение есть, оно сидит в весах, а не в правиле, которое можно прочитать.
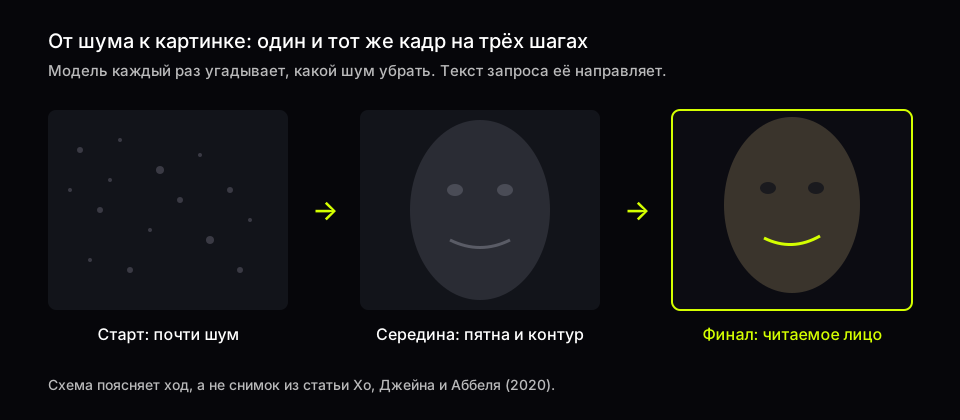
Источник: схема редакции по статье Хо, Джейна и Аббеля, 2020, и по латентной диффузии Ромбаха и соавторов, 2022. Чисел на схеме нет.
Чем этот ход отличается от фильтра на готовом снимке, разобрано в статье нейросети для картинок. Фильтр начинает с пикселей, которые уже есть. Генератор начинает с шума.
Куда девается текст запроса
Текст на холст не кладут. Его превращают в набор чисел отдельной текстовой сетью. CLIP, статья Алека Радфорда и соавторов от 26 февраля 2021 года, учат так, чтобы подпись и картинка из одной пары оказывались близко, а чужие пары далеко. Задача предобучения там простая: угадать, какая подпись подходит к какой картинке. Для генерации берут текстовую половину. Она уже умеет ставить «красное яблоко» ближе к одним описаниям и дальше от других.
В статье Ромбаха обусловленность сделана общим механизмом на перекрёстном внимании: так учат и класс-условные модели, и текст-в-картинку, и раскладку объектов. На каждом шаге куски картинки могут смотреть на слова запроса. Слово «полосатая» сильнее влияет на область, которая ещё не решила, чем быть. Поэтому правка текста на середине прохода не нужна: запрос присутствует на всех шагах сразу.
Сила этой привязки настраивается. 26 июля 2022 года Хо и Тим Салиманс описали управление без отдельного классификатора. Сеть учат совместно в двух режимах. Иногда ей дают текст, иногда нет, и тогда она должна уметь рисовать просто правдоподобную картинку. На выводе берут разницу двух оценок шума, условной и безусловной, и усиливают её множителем. Множитель больше, картинка послушнее тексту и обычно чище. Множитель меньше, вариантов больше, зато в кадр лезет то, чего в запросе не было. Авторы прямо пишут, что это обмен качества и разнообразия, в том же духе, что низкая температура или усечение у других порождающих моделей. Отдельный распознаватель картинок для этого уже не нужен. Раньше градиент такого распознавателя добавляли к оценке шума, и его приходилось учить рядом.
Отсюда бытовой эффект, который легко принять за характер модели. Жёсткая привязка к тексту делает кадр послушным и чуть пластмассовым: редкие, но живые сочетания света отсекаются, потому что они слабее совпадают со средним смыслом фразы. Слабая привязка оставляет зерно плёнки и странный ракурс, и вместе с ними третью руку.
У FLUX.1 лаборатория пошла от диффузии к более общему методу. Согласование потоков, статья Ярона Липмана и соавторов, первая версия 6 октября 2022 года, учит перенос из простого распределения шума в распределение картинок. Семейство гауссовых путей в той статье включает прежние диффузионные пути как частные случаи. Анонс Black Forest Labs 1 августа 2024 года говорит то же короче: согласование потоков — общий метод обучения порождающих моделей, и диффузия в нём частный случай. Все публичные FLUX.1 собраны из мультимодальных блоков и параллельных диффузионных трансформеров, 12 миллиардов параметров, плюс поворотные позиционные вложения и параллельные слои внимания. Подробный технический отчёт на день анонса обещали позже. В этом разборе его нет.
Вариантов три. [pro] оставлен для собственного интерфейса лаборатории. [dev] — открытые веса, прямо дистиллированные из [pro], для некоммерческого применения. В анонсе у [dev] качество и следование запросу близки к учителю, а вычислений меньше, чем у обычной модели того же размера. [schnell] заточен под локальную разработку и личное использование, выложен под лицензией Apache 2.0 и назван самым продвинутым вариантом с малым числом шагов на ту дату. Разрешения в анонсе — диапазон 0,1 и 2,0 мегапикселя, с разными пропорциями сторон. Типографика в том же тексте названа отдельным пунктом, по которому [pro] и [dev] обошли тогдашние сильные системы. [schnell] в этот пункт не включён.
Линейку, которая выросла из этой схемы, отдельно разобрали в статье FLUX. Другой ход, от лаборатории Google, лежит в разборе Nano Banana.
Откуда на кадре берётся лицо
Запрос про человека в поиске стоит особняком, и ответ у него тот же механизм, только цена ошибки выше. Зритель прощает кривую ветку. Кривой глаз он видит сразу.
Модель не хранит паспорт конкретного лица, если это лицо не было целью дообучения. На шаге с сильным шумом она выбирает крупное: где голова, куда повёрнут корпус, какой свет. На средних шагах появляются пятна глаз, линия рта, масса волос. На последних шагах добираются ресницы, поры, граница зуба. Страница проекта Хо это уже показывала на CelebA-HQ и сразу предупреждала, что люди на картинках выдуманы.
Поэтому два опасных ожидания. Первое: «нарисуй знакомого по имени». Имени в весах нет, если модель специально не доучивали на этом человеке. Получится собирательный тип: возраст, причёска и одежда из текста, лицо среднее для такого описания. Второе: «пусть на всех пяти кадрах будет один и тот же человек». При новом начальном шуме жребий другой. Похожая внешность выходит, когда в запрос кладут очень узкие приметы или когда модели дают исходный кадр и просят правку, а не новую съёмку. Что из готового кадра следует для прав, разобрано в статье права на картинку.
Правка у диффузионных моделей часто устроена иначе, чем первый кадр. Сети показывают уже готовые пиксели, и точка старта — ваша фотография, уже без чистого жребия. Лицо тогда держится лучше, потому что его не нужно вынимать из распределения заново. Как именно устроен внутренний шаг у линейки GPT Image, страницы справки OpenAI, открытые 2 ноября 2026 года, одной формулой не фиксируют. На входе и на выходе видно другое. Справка по созданию изображения описывает и генерацию, и правку для gpt-image-2.5-sunburst и gpt-image-2.5-flare. Размер кадра там задаётся строкой из ширины и высоты. Правка без исходной картинки, если её принудительно потребовать, возвращает ошибку. В справочнике метода создания рядом лежат gpt-image-2 со снимком от 21 апреля 2026 года и снимки sunburst и flare от 8 сентября 2026 года. Прежнюю gpt-image-1 тот справочник помечает отключённой 23 октября 2026 года. Линейку OpenAI отдельно разобрали в статье GPT Image.
Отдельно ломается анатомия на краю кадра. Кисть руки занимает мало точек, а вариантов у неё много: жест, перекрытие пальцев, предмет в ладони. Штраф за ошибку на обучении меньше, чем за ошибку в крупном лице, просто потому что точек меньше. Отсюда устойчивая привычка смотреть руки после лица. Это следствие устройства потери, а не опубликованный замер доли ошибок.
Текст на одежде и на вывеске — третий слабый участок старых диффузионных моделей. Буква для сети была фактурой, а не знаком. Новые семейства это место явно подтягивают: в анонсе FLUX.1 типографика названа отдельным пунктом у [pro] и [dev]. Проверять надпись всё равно нужно глазами. Сеть может собрать слово, похожее на нужное, с лишней палочкой.
Свет и тень модель тоже не считает как физический движок. Она помнит, как обычно выглядели тени на фотографиях рядом с такими лицами. Жёсткий источник справа в запросе часто срабатывает. Два источника, цветной фильтр и зеркало в кадре уже спорят друг с другом, и тень может лечь от предмета, которого в сцене нет. Для портрета это полезнее списка «стилей». Стиль — слово в тексте. Тень — проверка, поняла ли сеть геометрию.
Что смотреть на готовом кадре
Практическая часть короткая. Как собирать запрос по словам, разобрано в гайде как писать запросы. Работа именно с картинкой, включая правку готового кадра, лежит в гайде про изображения. Здесь только то, что следует из механизма.
Один и тот же сюжет стоит запросить дважды. Первый текст длинный и бытовой: «женщина сорока лет у окна, серое пальто, мокрые волосы, свет с левой стороны, плёнка, без улыбки». Второй короче и злее к деталям: «те же условия, обе руки видны, на кружке нет надписи, в окне нет лиц». Если второй кадр разваливается, модель тянула среднее по первому описанию и не держала ограничения. Имеет смысл оставить ограничения и убрать прилагательные настроения.
На готовом кадре смотрят пять вещей, всегда в одном порядке.
- Граница предмета и фона. Волосы, которые растворяются в шторе, значат, что на последних шагах сеть не решила, кому принадлежит точка.
- Число пальцев и стык запястья. Даже если лицо удалось.
- Надписи. Любая буква, которую просили, и любая, которую запретили.
- Направление тени против названного источника света.
- Повтор человека. Если нужен один и тот же герой в двух сценах, второй кадр лучше просить правкой первого, а не новым жребием шума.
Типичная ошибка запроса — список стилей без предмета. «Кино, 35 миллиметров, шедевр, высокая детализация» не говорит, где стоит человек и какой у него возраст. Сеть заполнит пустое место самым частым кадром из обучения. Вторая ошибка — взаимоисключающие свет и время суток в одной фразе. Третья — просьба «сделай как в жизни» без фотографии-опоры. Жизнь в весах — это среднее по корпусу, а не конкретная кухня.
Для портрета в таком проходе берут GPT Image 2.5 Sunburst: модель уже доступна в чате GPThub. GPT Image 2 уже доступна в чате GPThub рядом с ней. Сжать длинное описание в короткие ограничения удобно текстовой моделью, к самому кадру она не относится. Gemini 3.8 Flash уже доступна в чате GPThub.
Если кадр почти верный, жребий заново не запускают. Просят правку одной фразой: что оставить и что сдвинуть. У диффузионного хода правка стартует от уже данных пикселей. Новый шум стартует от ничего. В справке OpenAI по линейке 2.5 это видно снаружи: правка требует исходную картинку, иначе вызов с принудительной правкой падает.
Пример запроса, который делает жребий видимым, без претензии на замер. Запрос первый: «мужчина в тёмном пальто стоит в пустом подъезде, одна лампочка сверху, руки в карманах, лица почти не видно». Запрос второй, тем же текстом, но с другой случайной начальной точкой, если интерфейс её показывает. Совпасть должны лампочка и пальто. Не обязаны совпасть рост, возраст и то, как ляжет тень на ступени. Это и есть жребий, а не обещание конкретного кадра. Запрос третий — правка лучшего из двух: «оставь человека и лампочку, убери граффити на стене, обе кисти по-прежнему в карманах». Если после правки человек заметно помолодел, правка задела лицо, хотя об этом не просили. Тогда фразу сужают: «возраст и черты не менять». Так проверяют, стартует ли ход от данных пикселей или сеть тихо бросает жребий заново.
Что будет дальше с этим ходом
Дистилляцию Black Forest Labs прямо назвала у FLUX.1 [dev]: открытые веса выгнаны из [pro], качество и следование запросу близки к учителю, вычислений меньше, чем у обычной модели того же размера. [schnell] в том же анонсе назван моделью малого числа шагов и поставлен рядом с недистиллированными системами, но слово «дистилляция» к нему не приписано отдельной фразой. Зрителю короткий проход кажется рисованием сразу. Внутри это ученик, который повторяет уже обученного учителя за малое число оценок. Быстрый вариант выложили под Apache 2.0. Тяжёлый [pro] оставили в интерфейсе лаборатории. Связывать лицензию с числом шагов одной причиной анонс не просит.
Вторая развилка видна по справке OpenAI на 2 ноября 2026 года. Картиночная модель сидит рядом с текстом: справка описывает генерацию и правку по текстовому запросу, размер кадра задаётся явно. Сама картинка при этом не обязана быть диффузией 2020 года. Пока открытые страницы не фиксируют схему весов одной формулой, честнее говорить о поведении. GPT Image 2 и ветки 2.5 принимают текст и отдают кадр заданного размера. Ветки 2.5, по руководству генерации, ещё и правят кадр, если исходная картинка передана. Как устроен внутренний шаг, эти страницы не раскрывают. Значит, в объяснении механизма опора — диффузия Хо и согласование потоков Липмана и анонса FLUX.1, а линейку OpenAI описываем по тому, что у неё на входе и на выходе.
Если попадётся новость «модель рисует за один шаг», откройте, от какого учителя её выгнали и сколько оценок сети осталось. Один шаг без учителя и малое число шагов после дистилляции — разные изделия. [schnell] в анонсе 2024 года как раз назван моделью малого числа шагов, не одним шагом. Скорость там куплена сокращением прохода, а не отказом от прохода вовсе.
Вопросы и ответы
Как нейросеть создает изображение человека?
Тем же обратным ходом от шума, что и яблоко. Сначала крупные массы головы и света, потом пятна черт, в конце кожа и волосы. Конкретного живого человека в весах нет, если модель на нём не доучивали. На странице проекта Хо 2020 года под портретами так и написано: это не реальные люди.
Как работает генерация изображений?
Сеть учат предсказывать шум, которым заранее испортили настоящие кадры. На выводе начинают со случайного поля и десятки раз вычитают предсказанный шум. Текст запроса в виде чисел участвует на каждом шаге. В конце сжатый код, если счёт шёл в скрытом пространстве, разжимают в пиксели.
Как нейросеть рисует картинки?
Не кистью и не по слоям графического редактора. Она уточняет случайное поле, пока оно не станет похоже на кадры, которые видела при обучении, и на ваш текст. Два разных начальных поля при одном тексте дают две разные картинки.
Почему на картинке портится текст и руки?
Рука и буква занимают мало точек, а допустимых форм у них много. Ошибка там слабее двигала обучение, чем ошибка в крупном лице или в общем сюжете. Новые семейства это место подтягивают, но надпись и пальцы всё ещё стоит проверять глазами.
Можно ли получить одного и того же человека на двух кадрах?
Новый запуск со случайным шумом сдаёт другого человека того же типа. Устойчивее правка: отдать модели первый удачный кадр и попросить сменить фон или одежду, не трогая лицо. Узкие приметы в тексте помогают, имя знакомого без фотографии не помогает.
Чем диффузия отличается от согласования потоков?
Согласование потоков учит перенос из шума в картинку более общим способом. Диффузия в статье Липмана и в анонсе FLUX.1 названа его частным случаем. Для зрителя разница сводится к тому, как считают шаг и сколько шагов остаётся после дистилляции.
Связанные модели

Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
- Generative Adversarial Networks, Гудфеллоу и соавторы, 10 июня 2014
- Deep Unsupervised Learning using Nonequilibrium Thermodynamics, Сол-Дикстейн и соавторы, 12 марта 2015
- Denoising Diffusion Probabilistic Models, Хо, Джейн, Аббель, 2020
- Страница проекта DDPM с оговоркой, что лица не настоящие
- High-Resolution Image Synthesis with Latent Diffusion Models, Ромбах и соавторы, 20 декабря 2021
- Classifier-Free Diffusion Guidance, Хо и Салиманс, 26 июля 2022
- Scalable Diffusion Models with Transformers, Пиблз и Се, первая версия 19 декабря 2022
- Flow Matching for Generative Modeling, Липман и соавторы, 6 октября 2022
- Анонс Black Forest Labs и FLUX.1, 1 августа 2024
- Stable Diffusion для исследователей, 10 августа 2022
- Публичный выпуск Stable Diffusion, 22 августа 2022
- CLIP, Радфорд и соавторы, 26 февраля 2021
- Справочник OpenAI: создание изображения, снимки GPT Image
- Руководство OpenAI по генерации изображений
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.