
Нейросети для картинок: чем генерация изображения отличается от фильтра
Обозреватель: модели и релизы
Содержание
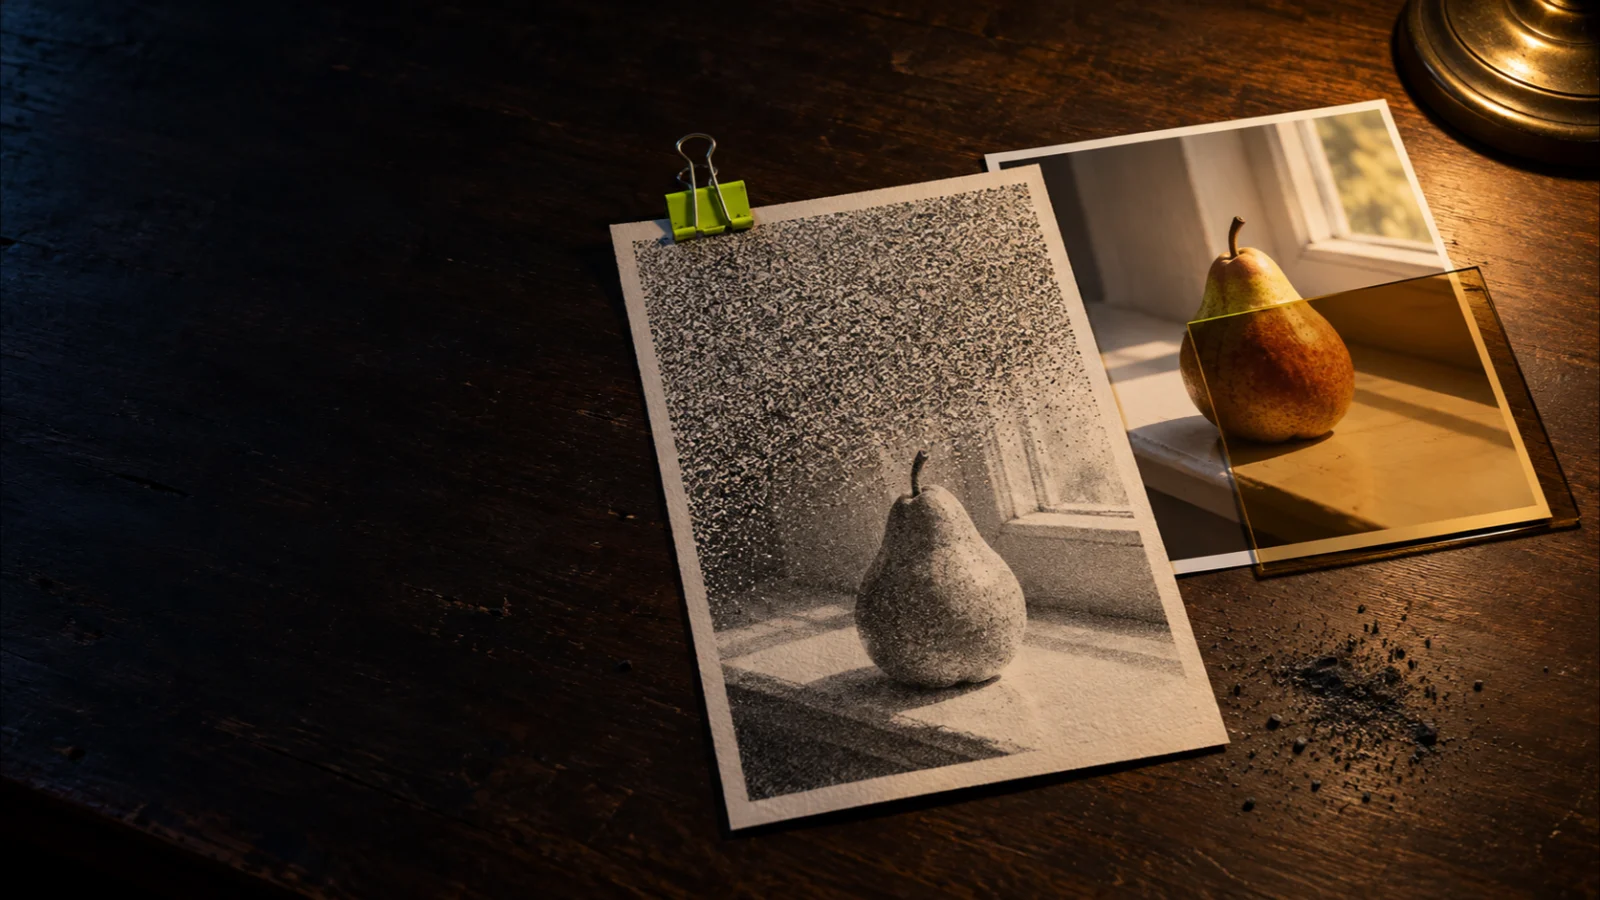
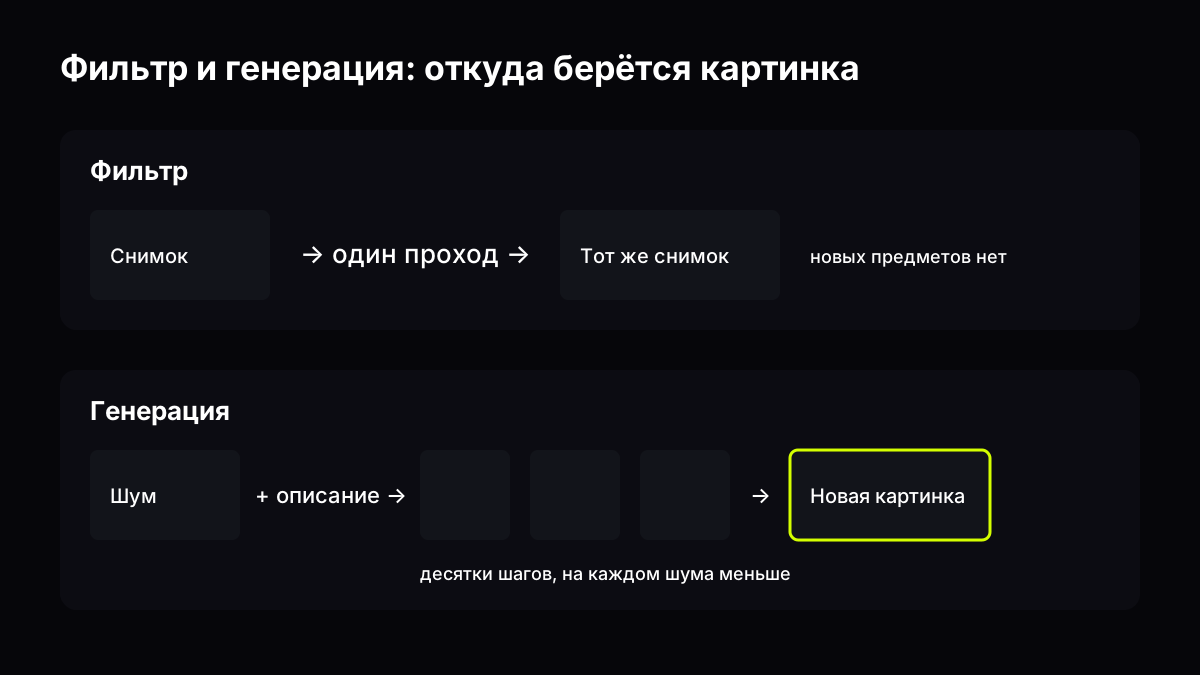
Фильтр берёт готовый снимок и меняет в нём цвет, резкость или манеру. Нейросеть для генерации изображений получает текстовое описание и рисует картинку, которой до запроса не существовало. Начинает она со случайного шума и идёт к результату шаг за шагом. Отсюда разные сильные стороны: фильтр бережёт снятое, генерация придумывает то, чего не снимали. Собрали, как к этому пришли, как устроен генератор изнутри и какой путь выбрать под задачу. Срез на 1 ноября 2026 года.
С чего всё началось: фильтр, который фильтром не был
В июне 2016 года в App Store появилось приложение Prisma, которое сделала небольшая московская команда. За первую неделю его скачали примерно 1,6 миллиона раз. Приложение превращало фотографию в «картину» в манере Мунка, Кандинского или комикса — стилей на старте было около двадцати, и команда обещала добавлять по два в день.
Пользователи называли это фильтрами. Сооснователь Алексей Моисеенков в интервью TechCrunch с этим спорил: приложение не накладывает эффект поверх снимка, а строит изображение заново, с пустого холста, по двум входам — фотографии и образцу стиля. «Мы создаём фотографию с нуля», — сказал он тогда (перевод редакции). Считалось всё на серверах, телефон бы такую работу не вытянул, и в цепочке стояли три нейросети: одна вытаскивала стиль, вторая переносила его на снимок, третья ускоряла процесс.
Под капотом была статья трёх исследователей из Тюбингена — Леона Гатиса, Александра Эккера и Маттиаса Бетге. «A Neural Algorithm of Artistic Style» вышла на arXiv 26 августа 2015 года. Идея в ней такая: обученная распознавать предметы сеть хранит в своих слоях отдельно «что изображено» и «как нарисовано», и эти две части можно разнять и собрать заново — содержание с одной картинки, манеру с другой. Как такая сеть вообще учится узнавать предметы на фото, разобрано в статье про компьютерное зрение.
Prisma стоит ровно на границе, о которой эта статья. Предметы в кадре оставались те же, что снял человек: если на фото была чашка, на выходе тоже была чашка. Нового сюжета приложение не придумывало. Но и обычным фильтром в старом смысле это уже не было — пиксели рисовались заново.
Чем фильтр отличается от генерации
Обычный фильтр представляет собой формулу, которую применяют к каждому пикселю или к его соседям. Поднять контраст, сдвинуть цвет к тёплому, размыть фон, добавить зерно. Фильтр ничего не знает о том, что изображено: для него лицо и стена состоят из одинаковых чисел. Зато он предсказуем, и тот же снимок с тем же фильтром даст тот же результат и завтра.
Генерация устроена иначе. На входе описание — «натюрморт с грушей на подоконнике, утренний свет», на выходе новая картинка. Предметов из описания до запроса нигде не было, их никто не фотографировал. Модель собирает их из того, что усвоила на миллионах пар «картинка — подпись».
Привычная аналогия звучит так: генератор — это очень умный фильтр, который «склеивает» кусочки чужих картинок. Аналогия неверна в главном. В готовой модели нет базы картинок, из которой что-то вырезают. Есть миллиарды чисел (их называют весами), в которые при обучении упаковались закономерности: как падает свет на округлый предмет, какая текстура у коры, где обычно стоит горизонт. Из этих закономерностей и рисуется новый кадр. Ближе всего тут художник, который видел очень много картин и пишет по памяти. С оговоркой: «память» у него статистическая, и детали он путает.
Между двумя полюсами лежит третья зона, и она сейчас самая людная. Нейросеть берёт ваш снимок и меняет в нём часть: убирает лишнего человека с заднего плана, дорисовывает фон за краем кадра, заменяет небо, переодевает героя. Формально это правка. По механике это генерация, просто ограниченная тем, что уже есть на фото.
| Что меняется | Фильтр | Правка нейросетью | Генерация с нуля |
|---|---|---|---|
| Что на входе | Готовый снимок | Снимок и описание правки | Только описание (иногда опорные картинки) |
| Появляются ли новые предметы | Нет | Да, в выбранной области | Да, весь кадр новый |
| Повторяемость | Полная | Частичная | Каждый запуск даёт другой вариант |
| Где ошибается | Пересвет, шум, грубые края | Швы, чужая перспектива, странные руки | Текст, мелкие детали, логика сцены |
| Годится для документа | Да | С оговорками | Нет |
Как нейросеть создаёт картинку по описанию
Сначала несколько терминов. Без них дальше трудно. Модель — файл с обученными весами, который принимает запрос и отдаёт результат. Промпт — текстовое описание того, что нужно нарисовать. Шум — картинка из случайных точек, похожая на снег в старом телевизоре. Шаг — один проход модели, на котором шума становится чуть меньше. Скрытое пространство — сжатое представление картинки, в котором модель работает вместо обычных пикселей.
Общий принцип прост: модель учат убирать шум. Берут миллионы настоящих картинок, портят их, добавляя шум понемногу, и заставляют сеть угадать, каким был кадр шагом раньше. Когда сеть научилась этому хорошо, процесс запускают в обратную сторону: дают ей чистый шум, и она шаг за шагом «вспоминает» из него картинку. Описание при этом подсказывает, какую именно: грушу или кота.
Метод называется диффузией. Решающая статья «Denoising Diffusion Probabilistic Models» Джонатана Хо, Аджая Джейна и Питера Аббеля вышла 19 июня 2020 года. На тестовом наборе CIFAR10 их модель показала оценку качества FID 3,17 (чем меньше, тем ближе сгенерированные картинки к настоящим), лучший результат на тот момент. До этого лучшие картинки рисовали генеративно-состязательные сети (GAN): Ян Гудфеллоу с соавторами описал их 10 июня 2014 года. Там две сети учатся друг против друга: одна рисует, другая пытается отличить подделку от настоящего снимка. Работали GAN быстро, но учились капризно и плохо слушались длинных описаний.
Диффузия по пикселям оказалась страшно дорогой: в статье группы Робина Ромбаха, опубликованной 20 декабря 2021 года, обучение таких моделей описано как «сотни дней» работы видеокарт. Решение, которое предложили авторы, и легло в основу почти всех сегодняшних генераторов: картинку сначала сжимают автокодировщиком в скрытое пространство, там и убирают шум, а в пиксели переводят только в самом конце. Текст подключается через механизм внимания, который на каждом шаге сверяет картинку с описанием.
Остаётся вопрос, откуда модель знает, как связаны слова и изображения. В феврале 2021 года вышли две работы, после которых это стало решаемой задачей. OpenAI 24 февраля показала DALL·E, первую широко известную модель, рисующую по произвольному описанию. Через два дня появилась статья о CLIP. Эту модель учили на 400 миллионах пар «картинка — подпись» из интернета сопоставлять текст и изображение. Связка «модель, понимающая язык» плюс «модель, убирающая шум» и стала стандартной схемой. Как OpenAI потом перешла от DALL·E к рисованию внутри языковой модели, рассказано в разборе GPT Image.
В августе 2022 года Stability AI выложила Stable Diffusion — открытую модель на основе той самой латентной диффузии. Для запуска ей требовалось около 6,9 ГБ видеопамяти, то есть хватало обычной игровой видеокарты. С этого момента генерация картинок перестала быть демонстрацией из лаборатории. Веса, описание модели и код лежали в открытом доступе, лицензия CreativeML OpenRAIL-M разрешала и личное, и коммерческое использование. По умолчанию в комплект входил отдельный классификатор, который отсеивал нежелательные картинки, и его настройки можно было менять.
Рекомендованная к запуску версия называлась v1.4 и отличалась от уже бывшей у исследователей v1.3 лишь дополнительными шагами обучения. Новой идеи в ней не было: тот же метод и та же архитектура, только больше обучения. Важнее другое: любой человек с игровой видеокартой мог запустить генератор у себя дома, дообучить его на собственных рисунках и выложить получившуюся версию для других, и очень многие именно так и сделали.
Почему одна и та же просьба даёт разные картинки
У фильтра на входе снимок, у генератора — случайный шум. Каждый запуск начинается с нового шума, поэтому одинаковое описание даёт разные варианты: груша то слева, то справа, свет то тёплый, то холодный. Так устроен сам метод, и сбоем это считать нельзя. Некоторые программы позволяют зафиксировать начальное число шума, и тогда результат повторяется — но обычный чат такую настройку не показывает.
Есть и вторая причина. Описание никогда не задаёт картинку полностью. «Утренний свет на подоконнике» — это тысячи возможных кадров, и модель выбирает один из правдоподобных. Чем подробнее описание, тем уже выбор: материал, ракурс, время суток, что в фокусе. Как писать такие описания, подробно разобрано в гайде как писать промпты, здесь оставим только принцип: недосказанное модель заполняет средним.
Из этого следует практическое неудобство. Если вам нужна серия из пяти картинок с одним героем, генератор без опоры будет каждый раз рисовать немного другого человека. Поэтому у новых моделей появились опорные снимки: картинку-образец подают вместе с текстом, и модель старается удержать лицо, предмет или стиль. У FLUX 3 Image Klein, которую Black Forest Labs открыла 15 октября 2026 года, таких опор может быть до десяти. Подробнее о ней написано в отдельном разборе FLUX 3 Image Klein.
Правка снимка нейросетью: где она ближе к фильтру
Правку стоит разобрать отдельно, потому что именно её чаще всего путают с фильтром. Пользователь видит знакомую картину: загрузил своё фото, получил своё фото, только без лишнего прохожего. Кажется, что программа аккуратно стёрла кусок, как ластиком. На деле стёртое место модель рисует заново.
Механика у правки та же, что у генерации с нуля. Выбранную область заполняют шумом, а остальной кадр оставляют как подсказку. Модель убирает шум только внутри области и на каждом шаге сверяется с краями: какой там свет, какая перспектива, какая фактура стены. В статье группы Ромбаха такая дорисовка выделенной области указана среди задач, где латентная диффузия показала лучший на тот момент результат, и с тех пор почти каждый генератор умеет её из коробки.
Отсюда понятны типичные огрехи. Если выделить слишком маленькую область, модели не хватает места, и заплатка выглядит как пятно другого цвета. Если слишком большую, модель начинает выдумывать лишнее: на месте убранного прохожего появляется скамейка, которой там никогда не было. Причём выглядит она вполне убедительно.
Правка по словам устроена хитрее. Пользователь не выделяет ничего, а пишет «замени чашку на вазу». Модель сама решает, где чашка, какую область перерисовать и насколько. Новые модели делают это неплохо, но иногда заодно «подправляют» соседние предметы: чуть другой узор на скатерти, чуть другой оттенок стены. Для открытки это незаметно. Для снимка, который потом будут сравнивать с оригиналом, уже заметно.
Логика у правки, в общем, двойная. Снаружи область неприкосновенна, как у фильтра. Внутри модель свободна, как при генерации. Чем меньше область, тем больше результат похож на работу фильтра, и тем меньше шансов, что в кадре появится что-то выдуманное.
Что делает описание хорошим
Нейросеть для картинок по описанию слушается текста ровно настолько, насколько текст конкретен. Описание «красивый пейзаж» оставляет модели почти полную свободу, и она выдаёт что-то среднее: горы, озеро, закат. Описание «сосновый лес после дождя, туман у земли, низкое солнце слева, снято с уровня травы» сужает выбор в десятки раз.
Работает это так. Текст сначала превращается в набор чисел текстовой моделью, той самой частью связки, которая знает, как соотносятся слова и изображения. Эти числа на каждом шаге подсказывают генератору, в какую сторону убирать шум. Слово, которого текстовая модель не поняла или поняла иначе, просто не повлияет на картинку, и модель заполнит пробел привычным.
Из этого вытекают несколько наблюдений, которые полезно держать в голове. Отрицания работают плохо: фраза «без людей» иногда добавляет людей, потому что слово «люди» в описании всё-таки есть. Порядок важен: то, что названо первым, модель обычно считает главным. Длинное описание с десятком предметов модель выполняет частично, теряя то, что упомянуто мимоходом.
С языком сложнее. Современные модели понимают описание на русском, но учились они в основном на английских подписях к картинкам. На простых запросах разницы почти нет. На редких словах, сленге и названиях предметов русского быта модель может промахнуться, и тогда помогает переформулировать то же самое проще.
Что умеют нейросети для картинок в 2026 году
За четыре года после Stable Diffusion генераторы научились трём вещам, которые раньше давались плохо. Первое касается текста на картинке: надписи на вывесках и упаковках перестали быть набором похожих на буквы закорючек, хотя мелкий шрифт всё ещё расплывается. Второе связано с правкой по словам: можно попросить «убери чашку, поставь вазу» и получить тот же кадр с заменой. Третье умение заключается в работе с несколькими опорными картинками сразу, чтобы собрать сцену из конкретных предметов.
Для примера возьмём две модели, вышедшие этой осенью. Обе уже доступны в чате GPThub.
- Nano Banana 2.1 от Google вышла 6 октября 2026 года. Она построена на основе Gemini 3.6 Flash, принимает текст вместе со снимками и умеет править кадр по нескольким опорным картинкам. Разбор есть в статье Nano Banana 2.1: что это за модель.
- FLUX 3 Image Klein от Black Forest Labs вышла 15 октября 2026 года. В ней 5,6 миллиарда параметров, быстрая сборка рисует за 16 шагов, базовой нужно 50. Веса открыты.
Разница в числе шагов наглядно показывает цену диффузии. Каждый шаг означает полный проход модели, поэтому разработчики учат быстрые версии «перешагивать», сокращая путь от шума к картинке. Быстрая сборка обычно чуть теряет в детали, зато отвечает в несколько раз быстрее.
Какая нейросеть для картинок подходит под задачу
Вопрос «какая нейросеть лучше» без задачи смысла не имеет. Поэтому идём так: сначала критерии, потом сценарии. Победителя назначать не будем. Критериев четыре: должен ли результат совпадать с реальностью, нужен ли новый сюжет, нужна ли серия с одним героем и важен ли текст в кадре.
| Задача | Что подходит | Почему |
|---|---|---|
| Поправить цвет, свет, резкость снимка | Фильтр или обычный редактор | Предметы не меняются, результат повторяем |
| Убрать лишнее, дорисовать фон, заменить небо | Правка нейросетью | Новое появляется только в выбранной области |
| Иллюстрация к тексту, обложка, открытка | Генерация с нуля | Сюжета нет в реальности, снимать нечего |
| Серия картинок с одним героем | Генерация с опорными снимками | Без опоры лицо будет «плыть» от кадра к кадру |
| Фото товара для карточки магазина | Съёмка плюс правка фона | Покупатель должен получить именно этот товар |
| Документ, справка, снимок для отчёта | Только съёмка | Любая генерация здесь — подделка |
Для студента самый частый случай связан с иллюстрацией к докладу или презентации. Здесь генерация удобна: картинка «экосистема пруда в разрезе» или «римский форум в III веке» должна быть наглядной, фотографической точности от неё никто не ждёт. Но подписи на такой схеме лучше делать самому в редакторе слайдов — мелкий текст генератор по-прежнему путает, а ошибка в подписи на защите курсовой выглядит хуже, чем её отсутствие.
Для тех, кто делает картинки для соцсетей или магазина, граница проходит по слову «покупатель». Фон, настроение, сезонную сцену вокруг товара генерировать можно. Сам товар генерировать не советуем: берите его только с настоящего снимка, иначе генератор незаметно поменяет форму крышки или число пуговиц, и это всплывёт в первом же отзыве.
Как всё это выглядит на практике, по шагам и с примерами запросов, разобрано в гайде работа с картинками. Если выбор модели пока непонятен в принципе, начните с гайда как выбрать модель.
Где генерация ошибается
Самые известные ошибки генераторов, лишние пальцы и сломанные надписи, стали заметно реже, но не исчезли. Причина у них одна. Модель хорошо знает, как выглядит рука «в среднем», и плохо считает. Пять пальцев требуют подсчёта, и на нём диффузия спотыкается до сих пор чаще, чем на шерсти или облаках.
Вторая группа ошибок — логика сцены. Тень падает не туда, отражение в зеркале не совпадает с предметом, у стула три ножки на виду и четвёртая растворяется в полу. Человек замечает это не сразу, но ощущение «что-то не так» возникает почти всегда. В рабочей картинке такие места проще перегенерировать или поправить точечно, чем спорить с моделью.
Третья группа связана с правдоподобной неправдой. Попросите нарисовать конкретное здание, и генератор выдаст красивый дом в похожем стиле, с другим числом окон. Для иллюстрации это нестрашно. Для текста, где картинка подаётся как «вот так это выглядит», это уже ошибка по существу.
Фильтр ошибается по-другому и проще. Пересвет, шум в тенях, ореолы на границах, кожа «как пластик» после агрессивного сглаживания. Всё это видно сразу и правится ползунком. Предметов, которых не было, фильтр не добавит, и в этом его главное преимущество, когда важна достоверность.
Как отличить картинку, созданную нейросетью
Глазом это удаётся всё хуже. По мелочам вроде пальцев и надписей ещё можно что-то заподозрить, но новые модели рисуют чисто, и уверенно отличить кадр от фотографии без подсказки уже нельзя.
Подсказкой служит подпись о происхождении. Стандарт C2PA (его называют Content Credentials) описывает подписанные криптографически метаданные: кто и чем создал файл и как его меняли. Первая версия спецификации вышла 21 декабря 2021 года, текущая версия 2.4 вышла в апреле 2026-го. Такие подписи ставят к своим картинкам OpenAI, Google, Black Forest Labs, ByteDance и ещё десятки компаний.
У метода есть очевидная слабость. Метаданные легко теряются: обычное пересжатие при загрузке в мессенджер или на сайт часто их срезает. К тому же подпись подтверждает происхождение файла. О правдивости изображения она ничего не говорит. Если подписи нет, это ничего не доказывает ни в одну, ни в другую сторону.
Что дальше
Граница между фильтром и генерацией за десять лет сдвинулась несколько раз. В 2015 году сеть научилась переносить манеру с картины на снимок, в 2016-м это стало приложением в телефоне, в 2020–2022 годах появились модели, рисующие по описанию с нуля. Сейчас основная работа идёт в средней зоне, в правке снимка словами, где генератор обязан уважать то, что уже есть в кадре. Прежний фильтр при этом никуда не делся. Он по-прежнему стоит в каждом телефоне, поднимает контраст и греет цвет, и для обычной фотографии его хватает чаще, чем кажется по новостям о генераторах.
Следующий заметный сдвиг, судя по осенним релизам, касается серий. Опорных снимков становится больше, модели всё лучше держат одного героя и один предмет от кадра к кадру. Вслед за этим идёт видео: генератор роликов по сути использует ту же диффузию, только растянутую во времени. Об этом есть отдельный текст: нейросети для видео.
Видите в ленте эффектную «фотографию» события, которого никто больше не снимал? Ищите подпись о происхождении и второй источник, прежде чем пересылать дальше.
Вопросы и ответы
Какая нейросеть лучше для генерации картинок?
Зависит от задачи. Для иллюстрации с нуля подходит модель, которая хорошо слушается длинного описания; для серии с одним героем — модель с опорными снимками; для правки фото — модель, умеющая менять выбранную область. Обзор по задачам — в гайде как выбрать модель.
Можно ли создать картинку с помощью нейросети на русском?
Да. Современные модели принимают описание на русском. Короткие надписи внутри картинки надёжнее получаются латиницей, кириллица в мелком шрифте ещё бывает кривой.
Нейросеть копирует чужие картинки?
Готовая модель не хранит базу картинок и не вырезает из неё куски. Она рисует по закономерностям, усвоенным при обучении. Но если попросить стиль конкретного художника или известного персонажа, результат может оказаться очень близким к оригиналу — такие вещи лучше проверять.
Почему нейросеть рисует лишние пальцы?
Диффузионная модель хорошо передаёт текстуры и плохо считает. Число пальцев — подсчёт, поэтому ошибки в руках встречаются чаще, чем в фоне. Новые модели ошибаются реже, но не никогда.
Чем генерация изображения отличается от фильтра?
Фильтр меняет пиксели готового снимка и не добавляет новых предметов, генерация же строит новую картинку по описанию, начиная со случайного шума.
Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- Gatys, Ecker, Bethge. A Neural Algorithm of Artistic Style, 26 августа 2015
- TechCrunch о запуске Prisma, 24 июня 2016
- Goodfellow и др. Generative Adversarial Networks, 10 июня 2014
- Ho, Jain, Abbeel. Denoising Diffusion Probabilistic Models, 19 июня 2020
- Rombach и др. High-Resolution Image Synthesis with Latent Diffusion Models, 20 декабря 2021
- Ramesh и др. Zero-Shot Text-to-Image Generation (DALL·E), 24 февраля 2021
- Radford и др. Learning Transferable Visual Models From Natural Language Supervision (CLIP), 26 февраля 2021
- Stability AI: публичный выпуск Stable Diffusion, август 2022
- Карточка модели Nano Banana 2.1, Google DeepMind, 6 октября 2026
- FLUX 3 Image Klein, Black Forest Labs, 15 октября 2026
- Content Credentials (C2PA), справка, открыто 1 ноября 2026
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Создать картинку с помощью нейросети в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.