
Нейросеть для аналитика: где считает человек, а где модель
Обозреватель: ИИ в работе
Содержание
Объяснение у всех наготове. Нейросеть для аналитика будто уже сидит рядом и сама ведёт таблицу. Я тоже так думала, пока не открыла пост OpenAI от 10 сентября 2026 года. Там агент для данных есть. Но права на строки, смысл показателя и следующий шаг остаются у людей. Дальше речь о том, кому отдать черновик разбора, а кому нельзя отдавать решение.
Работа начинается с чужой таблицы
Запрос «ИИ для анализа данных» обычно значит одну из трёх бытовых задач. Человек хочет понять, что в файле вообще лежит. Хочет коротко сказать, что выросло и что упало. Хочет заготовку фразы для совещания.
С первой задачей модель помогает, если таблица уже у вас. Вы показываете столбцы и просите назвать, чего не хватает для простого сравнения. Пустые ячейки, странные повторы, дата вперемешку с текстом. Это черновик осмотра. Он не доказывает, что файл полный.
Со второй задачей осторожнее. Модель может назвать разницу. Она может и промахнуться в знаке, в периоде, в том, какую строку считать итогом. OpenAI 5 сентября 2025 года прямо пишет, что такое у них зовётся галлюцинацией. Модель уверенно выдаёт ответ, который неверен. Обычные оценки награждают угадывание сильнее, чем честное «не знаю».
С третьей задачей, с языком сводки, проще. Черновик абзаца для планёрки модель собирает быстро. Смысл цифры в этот абзац всё равно ставите вы. Если показатель в компании считают иначе, красивая фраза уедет мимо.
Я сверила это с тремя страницами, которые открываются без закрытого кабинета. Пост OpenAI от 10 сентября 2026 года про агента данных. Документация той же компании про запуск кода. Документация Anthropic про тот же класс инструмента. И заметка от 5 сентября 2025 года про уверенные неверные ответы.
Обычно это объясняют двумя причинами
«Модель уже считает лучше таблицы». Так говорят, когда ответ выглядит готовым отчётом. У разработчика правда есть инструмент, который пишет код и гоняет его в изолированной среде. OpenAI описывает его для разбора файлов, графиков и математики. В примере на странице документации, как я её открыла 1 ноября 2026 года, стоит модель gpt-6-astra. Anthropic пишет то же про свои сильные модели, включая Claude Sonnet 5. Среда без интернета. Пакет на ходу туда не поставить.
Только вот обычный ответ словами и запуск кода это разные режимы. Страница Anthropic сама говорит, что на простой арифметике модель может ответить без кода. На нетривиальном расчёте и на файле код у них как раз уместен. Если в переписке вы видите только текст, число всё равно стоит пересчитать. Я не проверяла, какая кнопка в конкретном окне включает среду. Поэтому обещания «здесь всегда считается кодом» не даю.
«Виноват только человек, который плохо спросил». Плохой вопрос встречается. Но даже ясный вопрос не чинит чужую метрику. OpenAI в сентябрьском посте 2026 года пишет, что их агент в ChatGPT Work опирается на термины компании, определения показателей и связи данных. Администратор выбирает подключения. Запрос соблюдает уже выданные права, вплоть до строки и столбца. Без этого слоя модель видит таблицу, а не правило, по которому в фирме считают выручку.
Где считает человек
Человек задаёт вопрос. Не «проанализируй», а что именно надо решить. Почему просели заявки на прошлой неделе. Считать ли возвраты. Брать ли один город или всю сеть.
Человек знает, откуда строка. Выгрузка из кассы, ручная правка, тестовый магазин, который забыли выключить. Модель этого не видит, пока вы не скажете.
Человек сверяет число. Два итога в ответе. Тот, что совпал с вашей формулой, можно нести дальше. Тот, что разъехался, выбрасывают вместе с выводом, который на нём стоит.
Человек решает, кому это показывать. Сводка для руководителя и черновик для себя требуют разной осторожности. Модель не знает, чья это тайна и какой вывод у вас уже нельзя отзывать.
Человек держит ответственность. Если цифра ушла в письмо клиенту, подпись под письмом человеческая. Это скучно. И это как раз то место, где профессия не сжимается до кнопки.
На схеме слева как раз эти шаги. Справа то, что модели отдают спокойнее. Лаймом я отметила проверку числа. Её нельзя переложить.
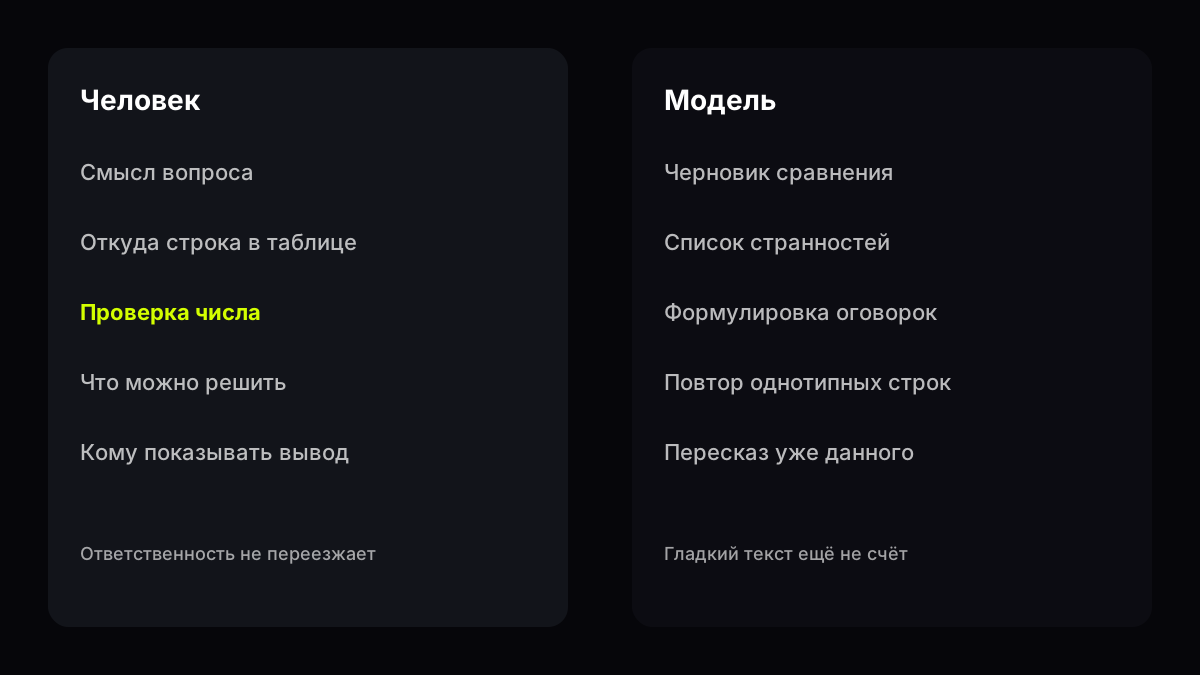
Источник: разметка по постам OpenAI от 10 сентября 2026 и 5 сентября 2025 и по страницам инструментов OpenAI и Anthropic, сверка 1 ноября 2026
Где считает модель
Модель быстро читает однотипные строки. Она замечает, что один столбец почти пустой. Она предлагает, какие два периода положить рядом. Она собирает список вопросов, которые стоит задать данным, пока вы ещё не открыли сводную.
Модель хорошо держит уже данный текст. Вы вставляете определение показателя своими словами. Просите не подменять его соседним. Тогда ответ меньше расползается. Если определения нет, она достроит привычное. Привычное может совпасть с вашей фирмой. Может и не совпасть.
Модель может набросать оговорки. Какие срезы тонкие. Где мало строк. Где сравнение периодов нечестное из-за праздника. Это полезный список. Его всё равно читают. Иначе оговорка сама станет украшением, а не границей вывода.
Для длинного файла есть отдельный механизм. Модель не «помнит» папку, пока кусок файла не попал в разговор. Почему модель без опоры на текст достраивает правдоподобное, подробно разобрано в статье почему нейросеть выдумывает. Здесь мне важно другое. Нет строки в запросе, нет права цитировать её как факт.
Какую модель открыть под длинную таблицу, а какую под короткий разбор, в этой статье не выбираю. Это соседний разбор, какая модель для аналитики. В чате GPThub на 1 ноября 2026 года среди карточек живы Grok 4.5, Gemini 3.8 Flash и Claude Sonnet 5. Про сами линейки есть отдельные тексты, например про Grok 4.7 и про GPT-6 Astra.
Ещё одна граница, про которую легко забыть в спешке. Модель сравнивает то, что попало в кусок. Она не знает, что соседний лист вы оставили на столе. Если на том листе другая неделя, другой магазин или ручная правка, ответ будет уверенным и неполным. Я бы в такой момент остановилась. Дописала бы в просьбу, чего в куске нет. И только потом слушала бы вывод.
Полезно просить модель спорить с самой собой. Так же работают рассуждающие модели: они сначала раскладывают задачу на шаги, и эти шаги можно проверить. Пусть назовёт две причины роста. Потом пусть скажет, какая из них не следует из столбцов. Вторая часть обычно ценнее первой. Первая легко соскальзывает в знакомую историю про рекламу, сезон и «людей стало меньше». Вторая возвращает к файлу.
Пробуем на живой таблице
Что понадобится. Небольшая таблица, которую не жалко показать. Определение одного показателя своими словами. Калькулятор или своя формула для сверки. Модель в чате.
Дальше короткие просьбы, не инструкция на вечер. Полный разбор кнопок живёт в гайдах. Здесь только границы.
- Покажите имена столбцов и десять строк. Попросите сказать, чего не хватает, чтобы сравнить две недели. Не просите сразу вывод для директора.
- Дайте определение показателя. Попросите пересчитать только по этому правилу и выписать, какие строки пришлось отбросить.
- Попросите список странностей. Пустые даты, дубли, отрицательные количества, город, которого нет в справочнике.
- Сверьте одно число сами. Если сошлось, можно просить черновик абзаца. Если нет, правьте данные или просьбу. Вывод на кривом числе не спасают словами.
- Попросите назвать, чего модель не знает. Источник выгрузки, правила возврата, праздники, тестовые точки.
Что проверять в ответе. Совпал ли период. Не перепутаны ли числитель и знаменатель. Нет ли процента там, где вы просили штуки. Нет ли причины, которой нет в таблице. Фраза «скорее всего из-за рекламы» без столбца про рекламу это догадка. Её помечают как догадку или удаляют.
Типичные ошибки. Отдать весь архив и ждать один верный ответ. Смешать в одной просьбе уборку файла, прогноз и текст для клиента. Поверить круглому проценту, потому что он звучит уверенно. Спрятать в запрос чужие персональные строки. Поправить вывод под желаемый знак, а сверку пропустить.
Поможет ли конкретная формулировка на вашей выгрузке, честно, пока не знаю. Я сегодня открывала страницы разработчиков, а не гоняла чужой файл. Если на ваших столбцах повторится один и тот же промах, его стоит записать рядом с определением показателя.
Отдельно смотрю на единицы. Штуки, рубли, доли, минуты. Модель любит перевести всё в проценты, потому что процент звучит как вывод. Процент без базы легко врёт. Десять из двадцати и десять из десяти тысяч это разный разговор. Просите рядом с долей ещё и абсолютные числа. Если абсолюта нет, долю в сводку не берут.
Смотрю и на пустые клетки. Пустая клетка бывает нулём. Бывает «ещё не пришло». Бывает «здесь показатель не считают». Три смысла дают три разных итога. Попросите модель не заменять пустоту нулём молча. Пусть перечислит, сколько строк она выбросила и почему. Этот список часто полезнее самого среднего.
Есть и тихая ошибка с названиями. Столбец «выручка» в файле может быть выручкой без налога, с налогом или уже после возврата. Модель возьмёт бытовое слово. Человек знает учёт. Если не сказать правило одной фразой, черновик будет про другое слово, похожее на ваше. Потом на планёрке спорят уже не с таблицей, а с двумя разными определениями.
Как это выглядит в обычной неделе
В рабочей неделе всё выглядит скромнее, чем в рекламе кнопки. Утро начинается с вопроса, а не с отчёта. Что изменилось против прошлой недели. Где дыра в данных. Какой срез тонкий.
Модель здесь черновик. Человек решает, какой срез честный. OpenAI в том же посте от 10 сентября 2026 года приводит свои примеры просьб. Почему изменились недельные активные пользователи. Какие вероятные причины. Что сравнить с прошлыми периодами. Какие проверки делать дальше. Второй пример про каркас показателей для новой области. Третий про сводку для руководства, с фактом, сравнением, оговорками и действиями.
Обратите внимание, чего в этих примерах нет. Там нет фразы «реши за нас». Есть просьба назвать проверки. Это хорошая планка и для небольшой команды. Модель предлагает, что открыть следующим. Решение остаётся в комнате.
Если вы ведёте небольшой бизнес и хотите понять, куда вообще класть такие просьбы, рядом есть гайд нейросеть для бизнеса. Он про задачи компании. Эта статья про границу между счётом человека и текстом модели.
Большие данные не меняют вопрос
Про большие данные часто думают так, будто размер файла сам меняет профессию. Размер меняет технику. Смысл вопроса остаётся тем же.
На стороне разработчика агент подключают к складу, который компания уже считает своим. В посте OpenAI названы Amazon Redshift, Datadog, Google BigQuery, ClickHouse, Databricks, MongoDB, Snowflake и другие. Файлы можно подмешивать из Google Drive и SharePoint. Это не «модель скачала весь интернет». Это доступ, который выдал администратор.
Пока такого доступа нет, большая таблица в переписке всё равно кусок. Вы приносите срез, определение и вопрос. Модель не достраивает недостающие месяцы из воздуха так, чтобы этому можно было верить. Если достраивает, это гипотеза. Её подписывают отдельно.
Всемирный экономический форум 7 января 2025 года поставил специалистов по большим данным среди самых быстрорастущих ролей в процентах. Рядом инженеры финтеха, специалисты по ИИ и машинному обучению, разработчики программ. Опрос собрал больше тысячи работодателей. Вместе они представляют более 14 миллионов работников, 22 отраслевые группы и 55 экономик. Горизонт у отчёта до 2030 года. Это ожидания работодателей, не приказ рынку.
Для человека с обычной выгрузкой вывод простой. Большие данные не отменяют маленькую проверку. Они делают её нужнее. Ошибка в определении показателя на огромном складе расходится дальше, чем на десяти строках.
Прогноз — это отдельный вопрос
Разбор и прогноз звучат как одна кнопка. На деле это два разных вопроса. Первый про то, что уже случилось. Второй про то, что может случиться.
С прошлым модель помогает, если прошлое лежит в таблице. Она сравнивает недели. Она показывает, какой день выбивается. Она предлагает, не смешаны ли праздник и обычный вторник. Сверку всё равно делаете вы.
С будущим модель пишет правдоподобное продолжение. Она может протянуть последнюю неделю вперёд. Она может сказать, что тренд слабый и вывод рано делать. Это полезно как оговорка. Это не обещание спроса.
Я не нашла у разработчиков в сегодняшних страницах честной цифры вида «прогноз попадает в стольких-то случаях». Поэтому такой цифры здесь нет. Если вам обещают точность без вашей проверки на прошлых периодах, это реклама, не метод.
Практическая граница короткая. Просите отдельно описать прошлое. Потом отдельно попросить сценарий. В сценарии пусть будут условия. Что будет, если следующая неделя похожа на эту. Что будет, если выкинуть один аномальный день. Два сценария честнее одного круглого числа.
Решение о закупке, о штате и о цене на этих сценариях принимает человек. Модель не видит договор, полку и нервы поставщика.
Хороший прогноз в этой работе начинается с проверки на прошлом. Вы прячете последнюю неделю. Просите модель продолжить предыдущие. Потом открываете спрятанное и смотрите, куда она промахнулась. Это не научный экзамен. Это бытовая привычка. Если промах большой, сценарий вперёд лучше не нести на совещание. Если промах маленький, всё равно подпишите условия. Похожая неделя. Без одного странного дня. Без нового магазина.
Модель плохо чувствует разовые события, пока вы их не назвали. Закрытие улицы, поломка кассы, одна оптовая отгрузка. В таблице это просто высокая строка. В жизни это не тренд. Попросите отдельно выписать строки, которые тянут итог сильнее остальных. Сами решайте, это сигнал или случай. Я бы случай не протягивала на месяц вперёд только потому, что фраза получилась гладкой.
Медицинские данные — другая стена
С медицинскими таблицами всё иначе. Это уже не сводка продаж.
Всемирная организация здравоохранения 28 июня 2021 года выпустила первый глобальный доклад об этике и управлении искусственным интеллектом для здоровья. Генеральный директор Тедрос Гебрейесус сказал прямо. Технология может улучшить здоровье миллионов людей. Она же может навредить. Доклад просит не переоценивать пользу, если из-за этого режут базовые вложения в помощь.
Среди рисков на той странице названы неэтичный сбор данных о здоровье, смещения в алгоритмах, безопасность пациента, кибербезопасность и среда. Системы, которые учили в основном на данных богатых стран, могут хуже работать для людей в странах с низким и средним доходом.
Первый принцип доклада про автономию. В помощи человек остаётся хозяином системы и медицинского решения. Тайна и частная жизнь защищены. Согласие пациента должно быть настоящим, через нормальные правила защиты данных.
Для аналитика вне клиники это значит бытовую вещь. Чужие анализы, карты и переписки о здоровье в обычный чат не кладут. Даже обезличенный кусок может оказаться узнаваемым, если строк мало. Разбор такого файла это работа контура, где есть допуск, журнал доступа и врач. Не вечерний вопрос модели.
Эта статья не медицинская консультация и не разбор вашего случая. Она не говорит, болен человек или нет. Она не заменяет назначенное обследование. Если вопрос про здоровье, его несут врачу. Модель можно спросить о том, как устроена таблица в учебном примере без живых людей. Диагноз из этого не делают.
То же касается денег и права, если таблица внезапно про них. Черновик формулировки ещё не совет. Договор и отчётность сверяет человек, который за них отвечает.
Заменит ли ИИ аналитика
Заменит ли ИИ аналитика? Короткий ответ из тех страниц, что я открыла. Работодатели так не пишут.
В том же отчёте форума от 7 января 2025 года аналитическое мышление остаётся самым востребованным базовым навыком. Семь компаний из десяти считают его необходимым в 2025 году. Среди навыков, которые растут быстрее всего, на первом месте стоят ИИ и большие данные. Рядом сети, кибербезопасность и техническая грамотность. Это ожидание до 2030 года. Оно совместимо с простой картиной. Рутину сравнения отдадут модели чаще. Умение понять, что сравнивать, спросят чаще.
Роли вокруг данных в том обзоре как раз среди растущих в процентах. Специалист по большим данным там назван явно. Это не обещание вакансии в вашем городе. Это срез ожиданий крупных работодателей на начало 2025 года. Следующий такой отчёт может сдвинуть список. Пока он последний на странице серии у форума.
Где модель вредна. Когда её текст уходит клиенту без сверки. Когда в запрос кладут тайну. Когда прогноз продают как факт. Когда медицинскую строку суют в общий чат. Когда один удачный абзац убеждает команду больше не смотреть в исходник.
Где модель помогает. Когда надо быстро назвать дыры в файле. Когда черновик сводки экономят час, а час потом уходит на проверку. Когда вы учитесь формулировать показатель так, чтобы его понял и коллега, и модель. Как вообще собирать ясную просьбу, разобрано в гайде как писать запросы. Сравнение ответов разных моделей на одной задаче лежит в гайде сравнение моделей на практике.
Что это значит на практике, если убрать догадки. Беспокоиться стоит тому, кто сдаёт чужие цифры без пересчёта. Тому, кто только учится смотреть на таблицу, модель скорее тренажёр вопросов. Готовым аналитиком она от этого не становится. И вас она с места не снимает одной кнопкой.
Вопросы и ответы
Как использовать ИИ для анализа данных?
Дайте модели кусок таблицы, определение показателя и один вопрос. Попросите дыры в данных и сравнение двух периодов. Одно число пересчитайте сами. Потом уже просите абзац. Без определения показателя ответ будет про «среднюю таблицу», не про вашу.
Чем применение ИИ для анализа данных отличается от обычного отчёта?
Применение начинается с черновика. Отчёт заканчивается подписью человека. Модель может предложить срезы и оговорки. В письмо и на слайд уходит только то, что совпало с вашей формулой и с правилом компании.
Можно ли отдать ии анализ медицинских данных?
В обычный чат живые медицинские данные лучше не класть. Всемирная организация здравоохранения ещё в 2021 году оставила решение о человеке за людьми и предупредила про тайну, согласие и смещения. Учебный файл без пациентов для языка таблицы допустим. Вывода о здоровье из него не делают. Это не консультация врача.
Годится ли ИИ для анализа больших данных без склада?
Большой файл в переписке всё равно приходит кусками. Подключение к складу, о котором пишет OpenAI, выдаёт администратор, с уже существующими правами. Пока доступа нет, работайте срезом и проверкой. Размер архива не заменяет определение показателя.
Что умеет ИИ для анализа данных и прогнозирования?
Прошлое, которое есть в таблице, модель помогает описать. Будущее она раскладывает на сценарии с условиями. Точность такого продолжения я по открытым страницам разработчиков цифрой не подтверждаю. Закупку и цену на одном сценарии не решают.
Какие лучшие ИИ для анализа данных?
Одной лучшей кнопки на все таблицы нет. Смотрите, нужна ли вам длинная таблица, короткий разбор или аккуратный текст сводки. Выбор под задачу разобран в гайде какая модель для аналитики. В чате уже открываются карточки Grok 4.5, Gemini 3.8 Flash и Claude Sonnet 5.
Связанные модели


Связанные гайды
- Модель для аналитики
Как выбрать модель GPThub для саммари, таблиц, отчётов и длинного контекста: Gemini 3.8 Flash, DeepSeek, GLM 5.2, GPT-6.1 Sol, Claude, Kimi. Без API-прайсов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Нейросеть для бизнеса
Как использовать GPThub в работе: деловые письма, саммари встреч, черновик КП, ответы поддержке. Факты и цены — только ваши, без выдуманных гарантий.
Ещё по теме
Источники
- OpenAI, агент данных в ChatGPT Work, 10 сентября 2026
- OpenAI, инструмент запуска кода
- Anthropic, инструмент исполнения кода
- OpenAI, почему языковые модели уверенно ошибаются, 5 сентября 2025
- Всемирный экономический форум, The Future of Jobs Report 2025, 7 января 2025
- ВОЗ, шесть принципов ИИ для здоровья, 28 июня 2021
Об авторе
Обозреватель: ИИ в работе
Пишет о том, как нейросети меняют работу и где без человека не обойтись.
Как выбрать модель для аналитики
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.