
Рассуждающая нейросеть: что это и когда она нужна

Обозреватель: как устроен ИИ
Содержание
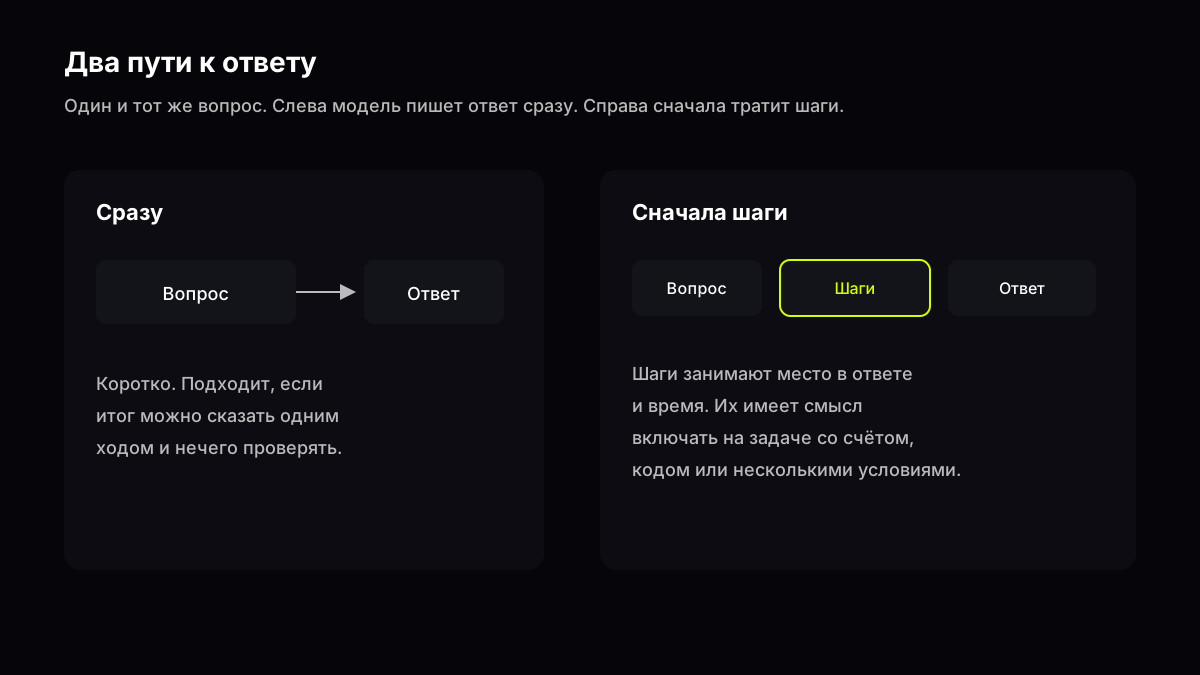
12 сентября 2024 года OpenAI выложила пост с сухим заголовком про обучение рассуждению. Внутри была модель o1. Ей разрешили молчать дольше обычного и сначала писать длинную внутреннюю цепочку, а уже потом ответ человеку. На отборе американской математической олимпиады AIME 2024 обычная тогдашняя модель GPT-4o решала в среднем 12% задач, o1 с одной попытки — 74%. С этого дня слово «рассуждающая нейросеть» перестало быть метафорой из рекламы. Так стали называть модель, которая перед видимым ответом тратит отдельные шаги. В поиске рядом всплывает английское reasoning. Речь об одном и том же приёме.
Откуда взялась пауза перед ответом
До осени 2024 года чат отвечал почти сразу. Модель читала запрос и с первого куска текста писала то, что увидит человек. Как устроено это угадывание следующего куска, подробно разобрано в статье что такое LLM. Если задача была из нескольких действий, её просили расписать ход прямо в ответе. В январе 2022 года группа из Google показала, что несколько готовых примеров «условие, шаги, ответ» заметно поднимают счёт на арифметике и на символьных задачках. Летом того же года другая работа показала ещё более дешёвый трюк. Достаточно дописать «давай подумаем по шагам», и модель сама начинает промежуточный текст. Никакого нового обучения для этого не требовалось, менялся только запрос.
Логика в таком решении есть. Пока модель пишет промежуточную строку, следующая строка опирается уже на неё, а не только на исходный вопрос. Ошибка, которую можно было сделать одним прыжком, иногда пропускается, хотя порой она всё равно случается, просто уже в середине листа.
У этого приёма был потолок, и его честно назвали в статье DeepSeek в январе 2025 года. Шаги, которые модель копирует с людей, не лучше тех тетрадей, по которым её доучили. Человек пишет медленно, размеченных решений мало, и чужой ход мысли модель повторяет, а не ищет свой. OpenAI к сентябрю 2024 года пошла другим путём. o1 учили с подкреплением так, чтобы цепочка до ответа становилась полезной. Человеку эту цепочку целиком не показывали. В исследовательском посте прямо сказано: модель думает, прежде чем ответить, и может выдать длинную внутреннюю цепочку.
Цифры того поста стоит держать рядом с оговорками, потому что их потом носили в заголовках без дробей. AIME 2024 — 15 задач. GPT-4o брал в среднем 1,8. o1 с одной попытки — 11,1. Если взять 64 независимых попытки и оставить ответ, за который проголосовало большинство, выходило 12,5. Если перебрать тысячу попыток и отранжировать их отдельной функцией, 13,9. Это не «модель решила олимпиаду». Это доля задач на одном конкретном отборе, и она сильно зависит от того, сколько раз модели разрешили пробовать.
На задачах по спортивному программированию Codeforces o1 поставили в 89-й перцентиль. На наборе GPQA по физике, биологии и химии она обошла экспертов с докторской степенью, которых наняли ответить на те же вопросы. В посте тут же стоит ограничение. Речь только об этом наборе. Из результата не следует, что модель сильнее живого специалиста вообще.
Продуктовый пост вышел в тот же день. Наружу отдали ранние версии o1-preview и o1-mini. На странице, открытой в ноябре 2026 года, OpenAI уже пишет, что описание доступа относится к сентябрю 2024-го, превью сняты из программного интерфейса, а сама o1 помечена устаревшей: живым остался приём, имя кнопки сменилось.
17 декабря 2024 года для разработчиков вышел снимок o1-2024-12-17. У него появился рычаг усилия: сколько модели разрешено думать до ответа. Тот снимок в среднем тратил на 60% меньше токенов рассуждения, чем превью, и на AIME 2024 с первой попытки брал 79,2% против 42,0% у превью. Рычаг важнее конкретной версии. С тех пор у OpenAI в документации тот же смысл. Модель выделяет внутренние токены рассуждения до видимого ответа. Усилие бывает от нуля до очень высокого, набор ступеней зависит от модели. Ниже усилие — короче и быстрее, выше — заметно длиннее.
Почему «нейросеть, которая думает» — кривая аналогия
Привычная картинка здесь — человек, который замолчал над тетрадью. Пауза, нахмуренные брови, потом ответ, и у модели пауза выглядит похоже, хотя аналогия на этом кончается.
Человек в паузе может ничего не произносить. Модель в паузе продолжает выбирать следующий кусок текста. Эти куски спрятаны от чата или показаны отдельным блоком «ход мысли», и они занимают тот же механизм, что и обычный ответ, а меняется только бюджет, то есть сколько кусков разрешено потратить, прежде чем начать фразу для человека.
Вторая неточность — слово «поняла». Верный итог на задаче со счётом значит, что итог сошёлся с известным ответом или прошёл проверку, и из этого ещё не следует модель мира, которой можно доверить соседнюю задачу без проверки. Статья DeepSeek как раз на этом стоит. Награду давали за верный итог и за то, что рассуждение лежит в нужных метках. Как именно рассуждать, в правилах награды не было.
Третья неточность — «чем дольше думает, тем умнее». Длина растёт, потому что так устроено обучение и потому что на трудной задаче модель научили не останавливаться сразу. Длинный черновик бывает пустым и может кружить вокруг одной и той же формулировки, о чём ниже, на материале разбора DeepSeek-R1.
Короткая связка терминов, без которых дальше не собрать схему. Токен — кусок текста, буквально несколько букв или слово, который модель обрабатывает за шаг. Цепочка рассуждений — последовательность таких кусков до итогового ответа. Токены рассуждения — те же куски, только отведённые под черновик. У OpenAI они идут отдельно от входа и от видимого выхода. У Anthropic запас на такой черновик в ручном режиме не может быть меньше 1024 токенов, и эти токены входят в предел длины ответа.
Скрытый черновик и открытый — разные вещи для читателя, не для счёта. OpenAI сырой черновик человеку не показывает. В чате Claude над ответом есть блок с ходом мысли, его можно раскрыть. DeepSeek в R1 как раз сделала черновик частью текста, который можно прочитать. Для студента так удобнее, потому что ошибку видно в шаге, а не только в итоговой цифре.
Как модель учат тратить шаги
Обучение обычного чата устроено так. Сначала модель читает горы текста и учится продолжать. Потом её поправляют на примерах, где человек уже написал хороший ответ. Для пошаговой математики таких примеров мало.
DeepSeek в работе, поданной 22 января 2025 года и позже вышедшей в Nature, убрала человеческие цепочки из первого эксперимента. Взяли базовую модель V3. Дальше шло только обучение с подкреплением по алгоритму GRPO. На каждую задачу модель писала пачку вариантов. Награда была правилом, а не оценкой другой нейросети. В математике ответ сверяли с известным числом. В программировании программу гоняли на тестах. Плюс формальная награда за то, что рассуждение обёрнуто в нужные метки. Нейросетевой оценщик на этих задачах не использовали. Авторы пишут, что такой оценщик на большом обучении начинают обманывать: модель находит дыру в оценщике, а не решение.
Модель этого прогона назвали R1-Zero. Ей не показывали, как думать. Шаблон просил сначала блок рассуждения, потом блок ответа. За время обучения доля решённых задач AIME 2024 с первой попытки выросла с 15,6% до 77,9%. Если оставить ответ, который устойчиво повторяется, выходило 86,7%. На графике из статьи средняя длина ответа на учебных задачах росла сама. Модель тратила сотни и тысячи токенов там, где раньше обходилась короткой строкой.
В черновике нашлась фраза, которую авторы вынесли в таблицу. Посреди уравнения промежуточная версия пишет по-английски: «Wait, wait. Wait. That's an aha moment I can flag here» — и начинает выкладки заново. Частота слова wait в размышлениях скакнула. Это не дневник и не характер. Это кусок текста, который стал полезен, потому что после него чаще получался верный итог, и обучение его закрепило.
Читать R1-Zero было плохо. В статье сказано прямо: слабая читаемость и смесь языков в одной цепочке. Базу учили на многих языках, прежде всего на английском и китайском, и черновик прыгал между ними. Для тетради студента это бесполезно, даже если число в конце верное.
Обычную R1 собирали уже в несколько стадий. Сначала несколько тысяч аккуратных примеров, чтобы черновик был похож на связный разговор. Потом снова подкрепление, но с добавкой за долю слов нужного языка. Авторы отмечают, что от этой добавки результат на тестах чуть проседает, зато текст можно читать. Дальше модель сама нагенерировала примеры, базу доучили на смеси рассуждающих и обычных задач, и в конце ещё один этап подкрепления — уже про полезность и безвредность. На меньшие открытые модели перенесли готовые примеры R1 и выложили эти модели открыто.
Приём разошёлся именно поэтому. Не потому, что у каждой лаборатории внезапно появился одинаковый «режим думания», а потому что на задачах с автоматической проверкой длинный черновик можно награждать без армии разметчиков. Где проверку автоматизировать нельзя — вкус, спорный пересказ, «напиши теплее», — такую награду собрать не из чего. Там рассуждающая модель не получает честного сигнала и легко пишет уверенную ерунду тем же длинным почерком.
Какие рассуждающие нейросети есть к ноябрю 2026 года
Имена кнопок с 2024 года сменились несколько раз, и полезнее держать четыре семейства приёма по документам, которые ещё открываются.
Первое — линия OpenAI, начатая o1. Отдельной кнопки o1 больше нет, рычаг усилия перешёл в семейство GPT-6. В документации OpenAI у GPT-6 Astra, вышедшей 3 сентября 2026 года, пять уровней: low, medium, high, xhigh и max. Режима none, когда модель отвечает сразу, у Astra нет: даже на самом низком уровне она сначала думает. У GPT-6 Sol и GPT-6 Luna, добавленных 22 сентября, режим none есть, по умолчанию стоит medium. Сырой черновик человеку не отдают. Чем модели семейства отличаются друг от друга, разобрано в статье GPT-6 Astra или GPT-6.1 Sol.
Второе — Claude от Anthropic. Расширенное мышление впервые появилось у Claude 3.7 Sonnet, потом у Claude 4: в чате над ответом висел блок, который можно раскрыть, а разработчик задавал запас токенов, минимум 1024. У Claude Opus 5.5, вышедшей 22 сентября 2026 года, рассуждение включено всегда, выключить его или задать ручной бюджет нельзя. Выбирается только глубина, от low до max, по умолчанию medium. Anthropic пишет, что на том же уровне Opus 5.5 думает больше, чем Opus 5. Подробности в разборе Claude Opus 5.5. Советы Anthropic по мышлению прямые: режим нужен для математики, кода и разбора. Сам черновик лучше всего выходит на английском, итоговую фразу модель может написать на другом языке. Значит, ход мысли может быть по-английски, даже если вопрос был по-русски.
Третье — Gemini от Google. У Gemini 3.8 Flash глубина задаётся уровнями low, medium и high, отдельный числовой бюджет заменили этими уровнями. Самый короткий уровень minimal эта модель не принимает.
Четвёртое — DeepSeek-R1 и то, что из неё выросло. Здесь черновик с самого начала был текстом, который публикуют. Как компания потом смешала «ответить сразу» и «сначала разобрать» в одном семействе, разобрано в материале что такое DeepSeek. Для этой статьи важен перелом января 2025 года: рассуждение перестало быть закрытым приёмом одной лаборатории.
Из моделей, с которых удобно начать учебную задачу, — DeepSeek V4 Flash, наследник той же компании, и Gemini 3.8 Flash, быстрая модель Google на каждый день. Обе уже доступны в чате GPThub. Как выбрать под задачу, коротко сказано в гайде как выбрать модель.
Путать линейки не стоит, потому что модель с длинным окном и модель с длинным черновиком лежат на разных осях: окно говорит, сколько текста она удержит, черновик говорит, сколько шагов она сделает по пути к фразе, так что можно держать в голове весь конспект и всё равно прыгнуть к ответу, а можно писать длинный ход по короткому условию из трёх строк.
Когда шаги нужны, а когда они мешают
Студенту развилка довольно простая, и она плохо совпадает с рекламой «включи самую умную».
Шаги окупаются, если у задачи есть проверка, которую можно сделать без модели. Число в конце. Равенство, которое подставляется назад. Программа, которая проходит тесты. Доказательство, где каждый переход можно оспорить. Условие из нескольких ограничений, и ответ обязан удовлетворить всем сразу. Олимпиадная задача, где один неверный знак в середине убивает итог. Здесь пауза — рабочий инструмент. Именно на таких задачах o1 и R1 показали скачок, который есть в таблицах.
Шаги мешают, если проверять нечего, кроме вкуса: сократить абзац, перевести письмо, объяснить интеграл как на первой лекции, напомнить формулу площади круга, и короткий ответ здесь честнее, потому что длинный черновик создаёт ощущение работы и прячет простую ошибку в середине. Anthropic в советах по расширенному мышлению прямо отправляет такие задачи в обычный режим.
Отдельный случай — вопрос, на который модель не знает ответа, но может уверенно его сочинить. Рассуждение это не лечит. Оно даёт больше места, куда положить выдумку. Если в задании нужна свежая цифра, дата закона, строка из методички преподавателя, черновик не заменяет источник. Его надо принести в запрос самому или проверить по конспекту.
Есть и обратная неприятность, уже измеренная. Разбор Thoughtology, поданный 2 апреля 2025 года, смотрел на сами цепочки DeepSeek-R1. У длины нашлась сладкая точка. Дальше дополнительное время на вывод качество уже портит. Модель склонна заново перебирать уже рассмотренную формулировку задачи вместо того, чтобы сменить ход. Авторы называют это пережёвыванием. На практике это выглядит как три абзаца «подождите, пересчитаю» с одним и тем же уравнением. Для учебника такое не нужно, и если черновик пошёл по кругу, дешевле остановить и переспросить с более узким условием, чем ждать четвёртый круг.
Ещё одна граница — язык хода. Награда R1 за одноязычный черновик чуть резала тестовый балл и сильно поднимала читаемость. Если вы учитесь по шагам, читаемый ход важнее рекордного процента на закрытом экзамене. Процент с чужой таблицы задачу по сопромату сам по себе не сдаёт.
Источник: схема GPThub по документам OpenAI и DeepSeek, сверка 1 ноября 2026
Что смотреть в ответе, если вы студент
Ниже нет инструкции «скопируй запрос», а как формулировать вопросы в целом, лежит в гайде как писать запросы. Здесь только то, что меняется именно из-за черновика.
Возьмите задачу, где вы сами можете поймать ошибку. Например, школьное уравнение или кусок кода, который у вас уже падает на одном тесте. Попросите модель сначала выписать, что дано и что надо найти, потом ход, и только потом итог одной строкой. Смысл не в магических словах. Смысл в том, чтобы ход и итог было легко разнять глазами.
Дальше читаете ход, потому что итог как раз написан самым уверенным голосом.
Смотрите, совпало ли «дано» с вашим условием. Модели часто теряют ограничение «x больше нуля» или путают, что именно спрашивают: корни или их сумму. У R1-Zero это было бы спрятано в каше языков. У нормального ответа это первая строка, и её проверка занимает десять секунд.
Смотрите один переход, который легко подставить назад. Раскрыли скобки — подставьте число. Взяли производную — проверьте на простой функции. Написали цикл — прогоните его на массиве из трёх элементов, который считаете руками. Если переход не сходится, остальное можно не читать: длинный хвост после сломанного шага обычно аккуратно доказывает уже неверную вещь.
Смотрите, не пошёл ли ход по кругу. Два раза одно и то же уравнение с словом «подождите» — тот самый симптом из Thoughtology. Здесь полезно сузить вопрос. Не «реши задачу», а «проверь только знак во второй строке» или «напиши, при каком условии этот корень посторонний».
Отдельно смотрите язык: если ход на английском, а сдавать нужно по-русски, перепишите своими словами хотя бы итоговое обоснование. Иначе на зачёте вы воспроизведёте чужой черновик, которого не поняли. Anthropic прямо предупреждает, что сам процесс расширенного мышления сильнее всего на английском. Это не дефект вашего запроса.
И имеет смысл смотреть, нужна ли была пауза: если модель пять абзацев шла к формуле, которая есть у вас на форзаце, в следующий раз берите модель короче или просите ответ без разбора, потому что пауза стоит времени и на контрольной, где вы только сверяете память, она не обязана окупаться.
Два типа вопросов, на которых приём исторически проверяли сами разработчики, студенту полезно знать, чтобы не ждать чуда на третьем. Первый — задача с коротким проверяемым ответом, как AIME: пятнадцать задач, ответ числом. Второй — программа против тестов, как задачи Codeforces. Открытый вопрос «расскажи про причины реформы» к этим экзаменам не относится. Там нет автоматической награды, и длинный ход не делает текст источником.
Если ответ пойдёт в работу, которую сдаёте под своим именем, черновик модели — не ссылка и не соавтор. Это калькулятор с привычкой объяснять. Цифру, которой нет в условии, всё равно надо откуда-то взять. Юридический или медицинский текст так не готовят вообще. Учебная задача по этим предметам — про понимание хода, а не про совет человеку.
Что будет дальше с этим приёмом
К ноябрю 2026 года отдельная кнопка «o1» уже история, а приём остался. Документация OpenAI говорит об усилии как о настройке текущих моделей. Anthropic описывает запас токенов на мышление как обычный параметр запроса. DeepSeek показала, что черновик можно открыть и перенести на модели поменьше примерами, без второго такого же обучения с подкреплением.
Для читателя из этого следует бытовое правило. Если новость обещает модель, которая «думает как человек», откройте, на каком экзамене её мерили и сколько попыток разрешили. Одна попытка и шестьдесят четыре — разные новости, это видно уже по таблице o1 от 12 сентября 2024 года. Если новость обещает, что дольше значит лучше, вспомните сладкую точку из разбора R1. Если в ответе нет хода, а ставка высокая, попросите ход явно или возьмите модель, которая его показывает. Итог без шага на задаче со счётом проверяется только повторным счётом.
Карточки, с которых это можно потрогать руками, названы выше. Дальше уже вопрос задачи, а не названия линейки.
Вопросы и ответы
Какие рассуждающие нейросети выбрать для учёбы?
Для учебной задачи со счётом или кодом подойдёт модель, которая либо показывает ход, либо хотя бы коротко его излагает. Сегодня уровни рассуждения есть у GPT-6, Claude Opus 5.5 и Gemini 3.8 Flash, а открытый черновик ведёт свою историю от DeepSeek-R1. Для начала подойдут DeepSeek V4 Flash и Gemini 3.8 Flash. Имя на кнопке меньше говорит, чем проверка одного перехода своими руками.
Чем рассуждающая нейросеть отличается от обычной?
Обычная пишет ответ с первого куска. Рассуждающая сначала тратит отдельные токены на шаги. Механизм тот же, бюджет другой. На AIME 2024 разница между GPT-4o и o1 была как раз в этом бюджете и в том, как модель учили его тратить, а не в новом виде памяти.
Нужна ли думающая модель, если вопрос короткий?
Часто нет. Формула, перевод, правка абзаца, напоминание определения не становятся точнее от длинного черновика. Anthropic советует расширенное мышление для математики, кода и сложного разбора. Thoughtology показала, что лишняя длина у R1 после некоторой точки вредит.
Нейросеть, которая думает, не ошибается?
Ошибается. Подкрепление награждает верный итог на задачах, где итог можно проверить автоматом. На остальных задачах длинный текст только звучит увереннее. Фраза «aha moment» в черновике R1-Zero — удачный пример того, как модель переписывает ход, а не доказательство, что она поняла задачу по-человечески.
Что такое reasoning у модели простыми словами?
Это английское имя того же приёма. Модели выделяют время и токены на промежуточные шаги до фразы, которую видит человек. У OpenAI эти шаги скрыты. В чате Claude блок с ходом мысли можно раскрыть. У R1 они были обычным текстом.
Модель с рассуждением заменяет конспект?
Сама по себе не заменяет, потому что она не хранит вашу методичку и не отвечает за цифру, которой не было в вопросе. На закрытом экзамене вроде AIME у неё есть шанс, потому что ответ проверяется числом. На вопросе «как у нас на кафедре оформляют ссылки» шанса нет, пока это правило не лежит в запросе.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
- Learning to reason with LLMs, OpenAI, 12 сентября 2024
- Introducing OpenAI o1-preview, 12 сентября 2024
- OpenAI o1 and new tools for developers, 17 декабря 2024
- Reasoning models, документация OpenAI
- Chain-of-Thought Prompting, arXiv:2201.11903
- Large Language Models are Zero-Shot Reasoners, arXiv:2205.11916
- DeepSeek-R1, arXiv:2501.12948
- DeepSeek-R1 Thoughtology, arXiv:2504.07128
- Extended thinking, документация Claude
- Extended thinking tips, Claude
- Using extended thinking, справка Claude
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.