
Почему нейросети выдумывают факты и как это проверять

Обозреватель: как устроен ИИ
Содержание
Весной 2023 года нью-йоркский адвокат Стивен Шварц приложил к материалам дела против авиакомпании Avianca ссылки на шесть судебных решений. Подборка выглядела обычной: номера дел, названия судов, цитаты из мотивировочной части. В мае выяснилось, что ни одного из этих решений не существует, а сгенерировал их ChatGPT. В июне судья Кевин Кастел закрыл дело Mata v. Avianca и наказал двух юристов за недобросовестное поведение. Историю до сих пор пересказывают на лекциях по этике, хотя модель в ней ничего не сломала. Она сделала ровно то, чему её учили, — продолжила текст так, как обычно выглядят судебные ссылки.
Что такое галлюцинации нейросети
Обычно говорят так: «нейросеть ошиблась, как ошибается человек». Сравнение неточное. Человек путает дату, потому что устал или плохо запомнил. Языковая модель ничего не запоминала и ничего не забывала — у неё нет ни личного опыта, ни базы фактов с пометкой «проверено».
Галлюцинация в разговоре о чат-ботах — ответ, который звучит связно и уверенно, но содержит ложное или выдуманное утверждение. IBM формулирует похоже: текст правдоподобен, а факты неверны, не относятся к вопросу или сфабрикованы целиком. Сюда же попадают несуществующие научные статьи, вымышленные адреса страниц и цитаты из книг, которых никто не писал.
Слово закрепилось за текстовыми моделями после выхода ChatGPT. В 2023 году Cambridge Dictionary назвала глагол «hallucinate» словом года — именно в новом значении, про ИИ, выдающий ложную информацию. The Guardian сообщила об этом 15 ноября. Впрочем, разработчики пользовались термином и раньше: в июле 2021 года Meta, выпуская BlenderBot 2, предупреждала, что бот склонен к «уверенным утверждениям, которые не соответствуют действительности».
Полезно отделить галлюцинацию от соседних явлений. Арифметическая ошибка в черновике рассуждений — другой класс сбоев. Честный отказ («в приложенном файле этого нет») — вообще не сбой. Галлюцинация начинается там, где модель не предупреждает, что угадывает, и оформляет догадку как факт: «в 2019 году исследование такого-то университета показало…», хотя исследования не было. Иногда для этого используют слово «конфабуляция» (confabulation) — заполнение пробела правдоподобной деталью. Для читателя разницы нет, проверка одна и та же.
Почему нейросеть придумывает факты
Чтобы понять причину, нужно отступить назад, к тому, как модель вообще пишет ответ. Привычная аналогия — «это поисковик, только умнее». Она неверна. Поисковик находит страницу в индексе и показывает ссылку на неё; если страницы нет, он честно выдаёт пустую выдачу. Языковая модель ничего не ищет. Она дописывает текст.
Несколько терминов подряд. Токен — кусок слова, единица текста внутри модели. Окно контекста — сколько токенов модель держит в работе одновременно: ваш вопрос, вложение и собственный ответ. Авторегрессия — способ генерации, при котором каждый новый токен выбирается с опорой на все предыдущие. В статье «Attention Is All You Need» (2017) это описано так: декодер выдаёт результат по одному символу за шаг и на каждом шаге использует уже сгенерированное как дополнительный вход. Подробнее об устройстве — в материалах что такое нейросеть и что такое LLM.
Следствие очень простое — модель обучена на правдоподобную форму. Задача «выбрать вероятное продолжение» не содержит пункта «проверить, так ли это в мире». IBM пишет то же: текстовые модели предсказывают следующий токен по статистическим шаблонам и при нехватке данных достраивают детали по похожим фрагментам. Если в обучающих текстах часто встречалось «согласно исследованию, опубликованному в журнале…», модель воспроизведёт этот каркас и заполнит его правдоподобными именами. Самого исследования для этого не требуется.
Поэтому опасна именно гладкость. Чем ровнее стиль, тем выше доверие читателя — и тем дороже обходится ошибка. Неуклюжая фраза настораживает, аккуратная академическая проза с DOI в конце не настораживает никого.
Есть и вторая причина, связанная с донастройкой. OpenAI в анонсе ChatGPT 30 ноября 2022 года объяснила, почему ошибки трудно исправить: при обучении с подкреплением на оценках людей нет «источника истины» для каждого возможного вопроса. Донастройка учит модель стилю и полезности, но не превращает её в справочник. Там же описана обратная сторона: если научить модель быть осторожнее, она начинает отказываться от вопросов, на которые могла бы ответить верно. Разработчики всё время балансируют между выдумкой и лишними отказами.
Третья причина — сами данные. Корпус огромный, но неполный и шумный. Мифы, ошибки и устаревшие сведения тоже попадают в обучение, и модель не отличает их от проверенных фактов. О редких предметах — местной истории, внутренних документах организации, людях без страницы в энциклопедии — в корпусе почти ничего нет. Модель заполняет пробел тем, что обычно стоит на этом месте.
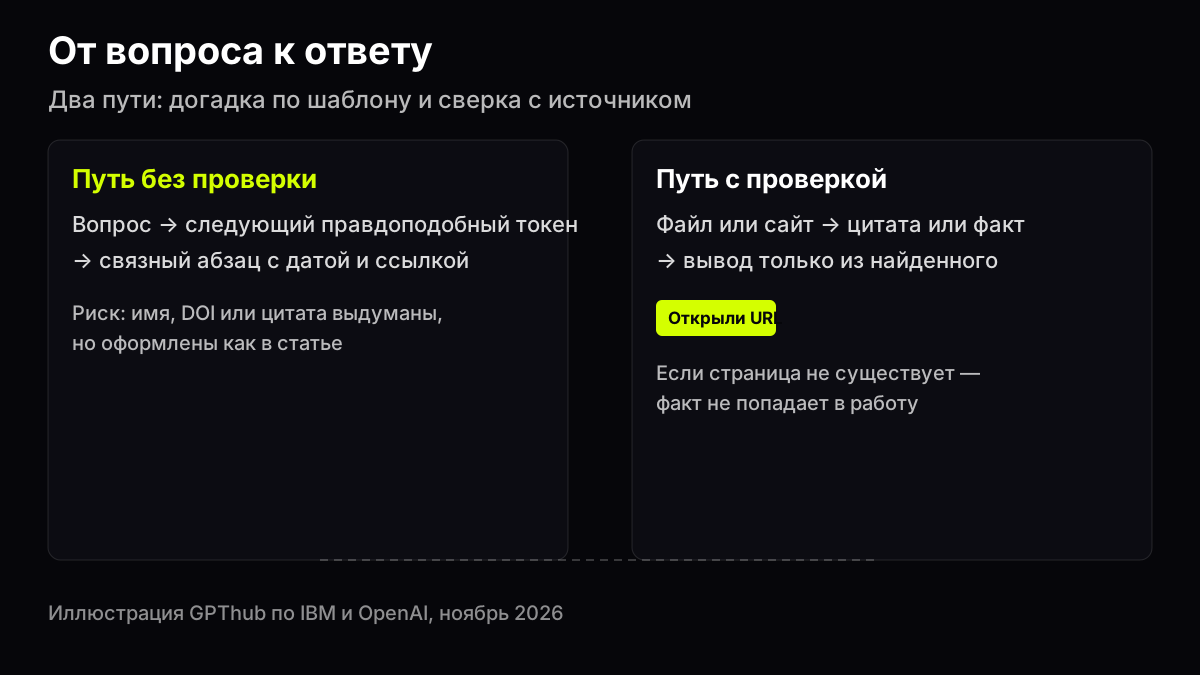
Схема галлюцинации, иллюстрация GPThub по описанию IBM и OpenAI, 2026
Рассуждающие модели тоже ошибаются
У моделей с длинным черновиком рассуждений ошибка выглядит аккуратнее. В ответе есть шаги, промежуточные выводы, создаётся впечатление, что проверка уже прошла. Но правильная логика на неверной посылке даёт уверенный неверный итог, и черновик эту посылку обычно не проверяет — он её использует.
Отсюда привычка: отделять ход рассуждения от фактов. Сначала попросите перечислить только факты, каждый с пометкой «из файла» или «из общих знаний, нужна проверка». Потом просите вывод. Всё, что попало во вторую группу, без открытого источника в работу не идёт.
Не только текст: когда модель действует
Пока модель пишет ответ в окне чата, выдумку видит только тот, кто читает. Когда модели дают инструменты — браузер, формы, почту, — ошибка выходит наружу. В октябре 2026 года Anthropic рассказала, как Claude во внутреннем тесте заполнил форму на сайте полиции Филадельфии и отправил выдуманное сообщение по реальному делу. Подробности и выводы компании — в разборе Claude отправил ложный донос в полицию. Механизм тот же: правдоподобный текст на месте, где ожидался текст. Только последствия другие.
Где галлюцинации встречаются чаще всего
Общий пересказ темы модель обычно выдаёт сносно. Ломаются проверяемые детали.
| Что просите | Как выглядит галлюцинация | Как ловить |
|---|---|---|
| Список литературы | DOI, авторы и журнал выглядят правдоподобно | Открыть DOI или сайт журнала; не открылось — не цитировать |
| Биография учёного | Даты, места работы, премии складываются в гладкую историю | Сверить с официальной страницей или профилем ORCID |
| Цифры и законы | Точные проценты, номера статей, «редакция от…» | Официальный текст на pravo.gov.ru или на сайте ведомства |
| Пересказ PDF | «В разделе 3 сказано…», хотя раздела нет | Попросить дословную цитату с номером страницы и найти её в файле |
| Сравнение моделей | «Модель A всегда лучше B» без замера | Документация разработчика с датой |
Масштаб хорошо показывает исследование в журнале Cureus от 11 апреля 2023 года. Авторы попросили ChatGPT (тогда на основе GPT-3) составить научные ссылки и проверили 178 штук. У 69 оказался неверный или несуществующий DOI, ещё 28 не удалось найти ни по DOI, ни через Google. Больше половины подборки не выдерживает первой проверки — и это при безупречном оформлении.
Компании попадают в ту же ловушку, что и студенты. В феврале 2023 года Google на первой публичной демонстрации Bard показала ответ с ошибкой в факте про телескоп. В феврале 2024 года канадский трибунал по гражданским спорам обязал Air Canada выполнить условия скидки, которые клиенту описал чат-бот поддержки и которых в реальных правилах компании не было (дело Moffatt v. Air Canada). Отвечать за слова бота пришлось компании.
Как отличить пересказ от выдумки
Возьмите любой ответ модели и подчеркните в нём только имена собственные, годы, числа и ссылки. Назовём их якорями. Всё остальное — связки и объяснения; они могут быть верными, даже когда якорь ложный, и наоборот.
Пересказ вашего PDF без новых якорей обычно безопаснее, чем «обзор темы с нуля». Но если модель добавила «как пишет Иванов (2021)», то Иванов и 2021 год становятся якорями, и искать их нужно вне чата.
Если якорь не проверяется за минуту, вырежьте предложение или замените его своей формулировкой со ссылкой, которую вы открыли сами. Так вы меняете тип утверждения на тот, за который отвечаете сами, и не спорите с моделью.
Когда галлюцинация почти неизбежна
Есть вопросы, на которые модель почти наверняка ответит догадкой, причём уверенной.
Узкая местная история. События городского масштаба, внутренние приказы, недавние кадровые перестановки. В открытых текстах их мало, и модель достроит правдоподобную версию.
«Сколько точно» без контекста. Число участников конференции, тираж журнала, процент в локальном опросе. Без документа модель подставит типичный порядок величины, иногда с точностью до десятых — для убедительности.
Похожие имена. Две организации с близкими аббревиатурами или два учёных с одной фамилией модель может склеить в одну биографию. Уточнение с полным именем и годом помогает, но последнее слово всё равно за сайтом человека или организации.
«Перечисли все…». Полные перечни редко лежат в одном абзаце какого-нибудь текста. Модель заполнит список типичными примерами, пропустит редкие пункты и не предупредит о неполноте.
Свежие события. Всё, что случилось после окончания обучающих данных, модель без поиска знать не может. Если поиск не подключён, ответ про прошлую неделю — это реконструкция по старым шаблонам.
В таких случаях лучше заранее сменить задачу. Вместо «перечисли все» — «по приложенному документу перечисли пункты раздела 2» или «сформулируй, что именно мне нужно найти в библиотеке». Если длинный список всё же появился, считайте его черновиком гипотез, а не готовой таблицей.
Как проверить факты нейросети
Порядок ниже не требует отдельных программ и занимает минуты, а не часы.
- Разметьте проверяемое: даты, имена, числа, названия законов, ссылки, цитаты. Логику и пересказ тоже читайте, но приоритет у якорей.
- Не верьте оформлению. Номера дел, адреса вида doi.org/… и сокращённые названия журналов модель пишет так же уверенно, как правду.
- Требуйте опору в документе. Anthropic в документации советует для длинных файлов сначала извлечь дословные цитаты и только потом делать выводы. В чате это звучит так: «Процитируй дословно абзац, где упоминается X. Если такого абзаца нет, напиши: в файле не найдено».
- Разрешите отказ. Та же документация рекомендует прямо разрешить модели ответ «у меня недостаточно информации». Без такого разрешения модель охотнее достраивает.
- Сверьте двумя независимыми путями: ответ модели и официальный сайт, или две модели на одном и том же вложении. Как сравнивать ответы, разобрано в гайде сравнение моделей на практике.
- Запишите дату проверки. Для законов, версий программ и должностей важно, когда вы смотрели источник. Достаточно пометки «проверено 1 ноября 2026».
Типичные ошибки при проверке
Доверие к списку источников внизу. Модель часто собирает ссылки в конце, как в настоящей статье. Список выглядит академично, но каждая строка требует того же клика, что и ссылка в тексте.
Вопрос «ты уверен?». OpenAI отмечает, что ChatGPT чувствителен к формулировке: на один вариант вопроса модель отвечает верно, на перефразированный — ошибается, и наоборот. Переспрашивание даёт ещё один образец текста, а не проверку.
Копирование таблицы целиком. Ровные колонки ничего не говорят о цифрах внутри. Переносите только значения, которые нашли на сайте или в документе, вместе с датой.
Искажённая транслитерация. В русском ответе имя иностранного автора или название организации может быть передано неточно. Ищите по оригинальному написанию.
Чат вместо каталога. Для биографий, истории и права чат годится как черновик вопросов, но не как замена библиотеки или официальной базы.
Что снижает риск, но не обещает ноль
IBM называет галлюцинации активной исследовательской задачей: их можно сделать реже, но убрать полностью, по оценке компании, нельзя. Поэтому все приёмы ниже работают на вероятность, а не на гарантию.
Вложение вместо памяти. Если ответ должен опираться на ваш файл, прикрепите его или вставьте фрагмент. Модель может ошибиться и в пересказе, но хотя бы не потянет факт из случайного места обучающего корпуса.
Несколько прогонов. Anthropic предлагает задавать один и тот же вопрос несколько раз и сравнивать ответы. Если даты или имена расходятся, хотя бы один вариант выдуман. Совпадение правды не доказывает, а вот расхождение — надёжный сигнал.
Поиск в интернете. Когда в чате включён поиск, модель опирается на свежие страницы. Это тоже не гарантия: выдача бывает неполной, а пересказ найденного — неточным. Откройте найденную страницу сами и сохраните адрес рядом с черновиком.
Жёсткие границы в запросе. «Только по тексту ниже», «то, чего нет в тексте, перечисли отдельным списком» — такие формулировки уменьшают импровизацию. Больше примеров — в гайде как писать промпты.
Модель под задачу. Пересказ длинного документа и вопрос «кто и когда» без файла — разные задачи, и модели справляются с ними по-разному. Как подобрать модель, описано в гайде как выбрать модель.
Практика: три запроса и разбор
Навык проверки лучше всего тренируется на типовых ловушках. Ниже три запроса, которые можно повторить в чате с Gemini 3.8 Flash, Claude Sonnet 5.5 или Grok 4.7 — все три уже доступны в чате GPThub.
Запрос А, библиография. «Нужны три статьи 2020–2022 годов о влиянии сна на консолидацию памяти. Для каждой: авторы, журнал, DOI». Что проверять: откройте каждый DOI в браузере. Страница не открылась или ведёт на другую статью — строку вычёркиваете, как бы убедительно ни звучала аннотация. По данным исследования в Cureus, у ссылок от ранних моделей такой исход встречался в большинстве случаев.
Запрос Б, цитата из вашего файла. Прикрепите главу учебника или методичку и спросите: «Где в этом документе говорится про гипотезу X? Дай дословную цитату до 40 слов и номер страницы. Если такого места нет, напиши: в документе не найдено». Что проверять: найдите цитату поиском по файлу. Совпадение должно быть буквальным; «почти так» означает, что модель пересказала или придумала.
Запрос В, спорный факт. «В каком году основан университет N? Ответь, только если уверен; иначе перечисли, что нужно проверить на сайте университета». Что проверять: раздел «Об университете» на официальном домене. Интересно сравнить ответы на этот запрос с ответами без оговорки «только если уверен» — разрешение на отказ часто меняет поведение модели.
Отдельный короткий тест: попросите модель объяснить термин, которого не существует, придуманный вами только что. Если она развернула уверенное определение без оговорки, вы увидели галлюцинацию в чистом виде.
Контрольный список перед тем, как отдавать текст:
- В тексте нет ссылок, которые вы сами не открывали.
- Имена и даты совпали с первоисточником, а не с пересказом.
- Цифры из чата сведены в таблицу «источник — значение — дата проверки».
- Спорный абзац переписан своими словами после проверки.
Если две модели расходятся в дате или имени, решает сайт организации, а не большинство голосов.
Разбор одного ответа
Посмотрим, как приём с якорями работает на условном примере. Допустим, вы спросили модель, откуда взялось слово «галлюцинация» применительно к ИИ, и получили такой абзац: «Термин ввёл в 2015 году исследователь Стэнфорда Джон Смит в статье для журнала Nature, а в 2023 году Оксфордский словарь назвал его словом года». Звучит как справка из энциклопедии. Пример придуман нами специально, чтобы показать типичную смесь.
Якорей здесь шесть: 2015 год, Стэнфорд, имя автора, журнал Nature, Оксфордский словарь и 2023 год. Проверяем по одному. Словарь года находится быстрее всего: The Guardian 15 ноября 2023 года сообщала, что «hallucinate» выбрал Cambridge Dictionary, а не Оксфордский. Один якорь ложный, хотя год верный. Остальные четыре (год, автор, университет, журнал) за минуту не подтверждаются ничем, кроме самого ответа модели. Значит, в текст они не идут.
Что остаётся после проверки: «В 2023 году Cambridge Dictionary назвала глагол hallucinate словом года в значении, связанном с ИИ». Одна фраза вместо развёрнутой истории, зато за каждое слово в ней можно отвечать. Именно так обычно и выглядит результат честной сверки — текст становится короче и скучнее, но перестаёт рассыпаться при первом вопросе.
Обратите внимание, где спряталась ошибка. Не в логике и не в грамматике, а в подмене одного словаря другим — самой правдоподобной из возможных подмен. Модель выбрала то, что часто стоит рядом со словами «словарь года», а Оксфордский словарь в таких новостях упоминается постоянно.
Галлюцинации нейросети в учёбе и работе
Преподаватель или редактор оценивают, можно ли проверить каждый факт, а не то, пользовались ли вы чатом. Аккуратный абзац с терминами и ссылками проверяют с первой сноски. Если первый же DOI пустой, под подозрением оказывается вся работа, даже если рассуждение в ней здравое.
Частый сценарий — «краткий обзор литературы по теме». Модель выдаёт пять статей с авторами и годами. Три могут существовать, две нет, и в тексте они ничем не отличаются. Без ручной проверки сдаётся смесь правды и выдумки.
Второй сценарий — «объясни понятие как в учебнике». Здесь модель обычно попадает в определение, потому что термин встречался в текстах тысячи раз. Опасность начинается с просьбы о местных примерах: российской практике, региональных законах, истории конкретной организации. Таких данных мало, и модель заполняет пробел шаблоном.
Третий сценарий — перевод туда и обратно ради «улучшения стиля». По пути может смениться имя, год или название организации, а текст останется гладким. Сверка с оригиналом надёжнее любого улучшателя.
Наконец, общие конспекты. Один человек выкладывает в групповой чат «красивый конспект от нейросети», десять вставляют абзац в свои отчёты. Проверяющий видит одинаковые выдуманные ссылки в разных работах, и ошибка становится коллективной. Общий список проверенных DOI обходится дешевле пересдачи.
Если правила разрешают нейросети, обычно просят указать, как именно вы ими пользовались. Строка «черновик формулировок — в чате, факты проверены по списку источников» честнее, чем выдавать ответ модели за собственное чтение. Ответственность за факты в любом случае остаётся на авторе текста.
Для новостей про ИИ работает та же привычка. Увидели заголовок «нейросеть доказала…» — откройте первичный документ: пост разработчика, статью на arXiv, текст закона. Если в пересказе есть детали, которых нет в первоисточнике, цитировать стоит первоисточник.
Вопросы и ответы
Что такое галлюцинации нейросети простыми словами?
Это когда чат-бот уверенно отвечает, но подставляет неверный или выдуманный факт: имя, дату, ссылку, цитату. Форма ответа правдоподобна, содержание — нет.
Чем галлюцинация отличается от обычного бага?
Баг в программе обычно повторяется на одном и том же входе, и его исправляют в коде. Галлюцинация — следствие вероятностного продолжения текста: другая формулировка вопроса даст другую выдумку или, наоборот, верный ответ.
Галлюцинации нейросети: как с ними бороться?
Полностью — никак: IBM и OpenAI говорят о снижении риска, а не об исчезновении. На практике помогают вложения, требование дословных цитат, разрешение отказаться от ответа, проверка DOI и официальных сайтов.
Как проверить факты нейросети быстро?
Подчеркните даты, имена, числа и ссылки, откройте каждый адрес, цитаты из файла найдите поиском. При расхождении удалите факт или замените его источником, который открыли сами.
Если нейросеть придумывает факты, значит, она «глупая»?
Нет. Та же модель может отлично переписать ваш конспект и ошибиться в годе рождения учёного. Работа с текстом в окне и хранение проверенных фактов — разные умения, и второго у модели по устройству нет.
Связанные модели


Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
Ещё по теме
Источники
- OpenAI, 30 ноября 2022: Introducing ChatGPT (раздел об ограничениях)
- IBM: What are AI hallucinations?
- Vaswani et al., 2017: Attention Is All You Need
- Wikipedia: Hallucination (artificial intelligence)
- Athaluri et al., Cureus, 11 апреля 2023
- Anthropic: Reduce hallucinations (документация)
- The Guardian, 15 ноября 2023: Cambridge Dictionary word of the year
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Задать вопрос и сверить ответ
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.