
Удаление фона нейросетью: как модель отделяет объект от картинки
Обозреватель: как устроен ИИ
Содержание
5 апреля 2023 года исследовательская группа Meta выложила модель Segment Anything и набор из 1,1 миллиарда масок на 11 миллионах снимков. Задача звучала шире студийного «убери фон»: по точке или рамке отметить любой предмет на незнакомой фотографии. Удаление фона нейросетью как раз из этой семьи. Программа не ищет зелёную ткань за спиной и ставит каждому пикселю долю покрытия: ноль — пусто, единица — объект, дробь — волос, дым, стекло.
Откуда взялась карта покрытия
Прежде всего стоит отступить на сорок лет. В июле 1984 года Томас Портер и Том Дафф, тогда в графической группе Lucasfilm, доложили на конференции SIGGRAPH статью о сборке картинки из отдельных слоёв. Доклад занимает страницы 253–259, и авторы показали, зачем картинке четвёртый канал рядом с красным, зелёным и синим. Этот канал они назвали альфой: ноль — пиксель предмет не покрывает, единица — покрывает целиком, дробь — покрывает частично. Дробь нужна против зубцов на наклонной границе.
То есть «вырезать объект» в графике давно значило не ножницы. Это запись, какая доля пикселя принадлежит предмету, а дальше любой новый фон подмешивают по этой доле. Край яблока на клетчатой скатерти перестаёт быть пилой.
Нейросеть для удаления фона делает ту же запись автоматически. Раньше её рисовал человек в программе монтажа или отдел спецэффектов. Сеть смотрит на кадр и выдаёт карту тех же чисел.
Аналогия с ножницами по цвету здесь подводит. На хромакее актёр стоит перед ровным зелёным или синим полотном, и программа вычитает этот цвет. Логика в таком приёме есть — на съёмочной площадке цвет выбран специально и почти не встречается на костюме. На обычном фото кухни, улицы или полки цвет фона повторяется на самом предмете. Зелёная кружка на зелёной стене для вычитания цвета неразличима. Сети приходится смотреть на форму, границу и то, что обычно бывает предметом.
Что такое мягкий край
Маска — чёрно-белая карта: пиксель либо внутри, либо снаружи. Маттинг — расчёт мягкой карты, где по краю лежат дроби. Портер и Дафф как раз защищали дроби: без них наклонный край режется ступенькой.
В марте 2017 года Нин Сюй, Брайан Прайс, Скотт Коэн и Томас Хуан сдали в архив работу Deep Image Matting. Статья вошла в материалы CVPR 2017, и сеть принимает снимок и тримап. Тримап — грубая подсказка из трёх зон: точно объект, точно фон и узкая полоса «не знаю» вдоль контура. Первая часть сети — свёрточный кодировщик с расшифровкой, она предсказывает карту альфы. Вторая, маленькая, подчищает значения и делает край резче там, где он должен быть резким. Для обучения авторы собрали 49 300 учебных изображений и 1 000 проверочных.
Старые методы, пишут они, ломаются, когда цвета объекта и фона близки или фактура сложная. Причина в тексте прямая: прежние алгоритмы опирались на низкоуровневые признаки и плохо видели контекст всего кадра. Глубокая сеть как раз тащит и местный цвет, и более крупный смысл.
Для бытового фото тримап рисовать никто не хочет. Отсюда развилка: одни сети по-прежнему ждут подсказку. Другие сами решают, где полоса сомнения, и сразу отдают мягкий край. Вторая удобнее в чате и чаще ошибается на стекле, сетке и чёлке.
Полоса «не знаю» в тримапе — не декоративная рамка. Именно в ней живут дробные значения. Внутри уверенного объекта альфа держится у единицы, на уверенном фоне падает к нулю, а волос проводит градиент поперёк пряди. Если сеть без подсказки сужает эту полосу до одного пикселя, на экране получается нож. Если расширяет на всю чёлку, вместе с волосом уезжает кусок стены, и на новом фоне остаётся серая кайма. Оба провала выглядят как «плохое вырезание», хотя ломается ширина сомнения, а не вкус цвета.
Сжать кадр и вернуть карту
18 мая 2015 года Олаф Роннебергер, Филипп Фишер и Томас Брокс из Фрайбурга выложили описание U-Net. Сеть делали для биомедицинских снимков, где размеченных кадров мало, а ответить нужно по каждому пикселю. Архитектура из двух путей, и сжимающий путь собирает контекст: картинка уменьшается, признаки становятся грубее и «смысловее». Симметричный расширяющий путь возвращает точную локализацию. На соревновании ISBI 2015 та же схема выиграла трекинг клеток в категориях фазового контраста и дифференциально-интерференционного контраста. Разбор кадра 512 на 512 пикселей занимал меньше секунды на тогдашней видеокарте.
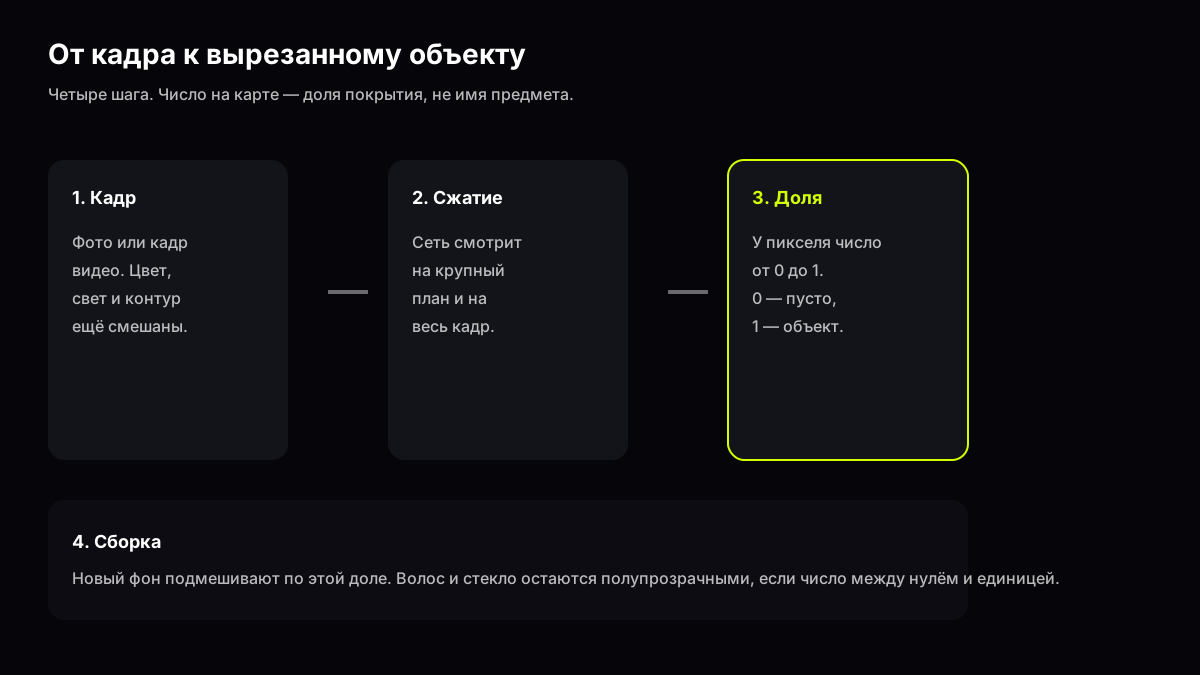
Схема GPThub по Портеру и Даффу, 1984, и по архитектуре U-Net, 2015
К удалению фона это относится буквально. Чтобы понять, что в кадре человек, а не обои, сети нужен широкий обзор. Чтобы не срезать ресницу, нужна мелкая сетка. U-образная схема склеивает оба взгляда. Почти все бытовые «вырезатели» после 2015 года так или иначе наследники этой развилки, даже если блоки внутри другие.
В мае 2020 года группа Альбертского университета во главе с Сюэбинем Цинем описала U2-Net. Имя читается как «ю-квадрат»: U-блоки вложены друг в друга. Задача — выделение заметного объекта: того, что на снимке зрительно главное. Сеть учится с нуля, без заимствованного классификатора картинок. Авторы собрали две версии, и полная весит 176,3 МБ и на видеокарте GTX 1080 Ti с входом 320 на 320 пикселей даёт 30 кадров в секунду. Облегчённая весит 4,7 МБ и даёт 40 кадров в секунду. Обе держатся на уровне сильных систем на шести открытых наборах. Код они выложили открыто.
Здесь полезно не перепутать скорость лабораторного замера с кнопкой в телефоне. 30 кадров в секунду — на конкретной карте 2017 года и на маленьком входе 320 пикселей по стороне. Исходное фото с телефона в несколько раз крупнее. Перед сетью его уменьшают, карту потом растягивают обратно. На мелкой чёлке растянутая карта мылит край. Отсюда привычный совет, который следует из размеров, а не из вкуса: если на фото важен контур, смотреть результат в полном размере, не в превью чата.
Три постановки одной бытовой кнопки
Снаружи кнопка одна: «убери фон». Внутри с 2020 по 2024 год разошлись три постановки. Путать их — главный источник странных результатов.
Первая постановка — найти заметный предмет и отдать силуэт. Это линия U2-Net, и сеть сама выбирает, что на фото главное. На снимке одного товара на столе выбор обычно совпадает с желанием человека. На семейном фото «главным» может оказаться лицо ближе к камере, а торт в руках пропадёт. На полке из десяти коробок заметный объект — не вся полка.
Вторая постановка — портрет без ручной подсказки. 24 ноября 2020 года Чжанхань Кэ и соавторы выложили MODNet. Это лёгкая сеть мягкого края для портрета по одному кадру, без тримапа. Идея в разложении цели на подзадачи, которые учатся вместе. Для многомасштабной оценки смысла они ввели свой блок, для подстройки под живые фото — приём самопроверки согласованности. На видеокарте GTX 1080 Ti сеть идёт 67 кадров в секунду. Для проверки живых портретов авторы собрали набор PPM-100. В аннотации прямо сказано: без тримапа модели страдают от сдвига между учебными и настоящими фото, и их приём как раз про этот сдвиг.
Портретная сеть ждёт человека, так что коробку, машину и кота она не обещала. Если запрос «нейросеть вырезает объект», а объект — стул, портретная модель честно вне своей задачи.
Третья постановка — любой предмет по подсказке. 5 апреля 2023 года Meta описала Segment Anything как новую задачу, модель и набор данных. Модель задумана «спрашиваемой»: точка, рамка или маска переносят её на новые снимки без дообучения под конкретный класс. В наборе SA-1B — 11 миллионов кадров и 1,1 миллиарда масок, в среднем около 100 масок на кадр. Средний размер кадра в описании набора — 1500 на 2250 пикселей. Подписей классов нет: маска не говорит «это чашка», она говорит «это связная область». Снимки лицензированы. Лица и номерные знаки на них обезличены, набор описан как защищающий частную жизнь. В блоге Meta от того же дня сказано, что масок в 400 раз больше, чем в любом прежнем наборе сегментации, и что люди в проверке находили качество сравнимым с маленькими полностью ручными наборами.
Отсутствие имён классов — развилка для бытового сценария. Нейросеть вырезает объект, на который показали. Она не обязана понимать слово «логотип» или «только человек слева». Слово остаётся заботой той модели, которая умеет читать запрос. Маска Segment Anything сама по себе ближе к жёсткому делению пикселей, чем к дробной альфе волоса. Мягкий край после неё — отдельный шаг, не подарок за компанию.
7 января 2024 года Пэн Чжэн и соавторы выложили BiRefNet — схему для дихотомической сегментации высокого разрешения. Дихотомия здесь значит двоичный ответ «объект или фон», но на крупных кадрах, где мелкие детали нельзя выбросить. В сети два модуля. Модуль локализации по глобальному смыслу находит, где предмет. Модуль сборки маски сверяет куски исходного кадра и карты перепадов яркости. Отдельный учебный сигнал заставляет сеть держать внимание на тонких местах. 22 августа 2024 года статья вышла в журнале CAAI Artificial Intelligence Research. В сообщении EurekAlert Дэн-Пин Фань из Нанкайского университета называет BiRefNet лучшей открытой моделью выделения переднего плана на тот момент. Это оценка автора работы, не независимый экзамен. Само сообщение отдельно говорит, что прежние схемы теряют самые тонкие детали, а эта держит их за счёт исходного масштаба и карт перепадов. Для читателя важен сам раскол: локализация и тонкий край — два модуля, их оптимизируют по-разному.
Где карта врёт
Волос, мех и тюль — дробная зона. Если сеть имеет право только на ноль и единицу, прядь либо пропадает, либо тянет за собой кусок стены. MODNet и линия Deep Image Matting как раз учатся ставить дробь. Силуэтные сети вроде раннего выделения заметного объекта чаще отдают твёрдую границу. На превью оба результата «без фона», а в полном размере видна лестница по контуру.
Стекло и дым плохо имеют одну границу. Бокал — и контур, и то, что видно сквозь него. Карта покрытия должна быть слабой на стенках и сильной на толстом дне. Сети, которые учили на людях и товарах с непрозрачной поверхностью, заливают бокал сплошняком или выгрызают его до ножки.
Тень и отражение сеть часто принимает за предмет. Для съёмки товара это ломает смысл: тень как раз хочется оставить, она сажает предмет на новый фон. Для паспортного портрета тень на стене как раз надо убрать. Одна и та же карта не знает этой разницы. Её задаёт запрос человека, а не архитектура U-Net.
Дырка внутри объекта — отдельный провал. Рука на поясе, ручка кружки, просвет между ножками стула. Силуэт «по внешнему контуру» зальёт просвет цветом объекта. Модель с поточечной маской, как Segment Anything, способна отметить дырку, если её спросить про дырку. Сама она не обязана догадаться.
Мелкий текст на упаковке страдает дважды. Сначала карту считают на уменьшенном кадре, потом растягивают. Буквы тоньше пары пикселей учебной сетки пропадают или обрастают ореолом. Это не «лень модели». Это размер входа, который честно указан в замерах U2-Net: 320 на 320.
Чужой предмет того же цвета сеть путает реже, чем вычитание цвета, но всё же путает. Две кружки одного обжига на одном столе для сети «заметного объекта» — один слипшийся ком или две области. Какой ответ нужен магазину, сеть не вычитывает из пикселей.
Почему видео мигает
Удаление фона видео нейросеть делает заметно хуже, если кормить ей кадры по одному. Предмет чуть сдвинулся, свет блика прыгнул, и граница на соседних кадрах расходится на пиксель-другой. Глаз видит дрожь контура, хотя каждый отдельный кадр выглядит приемлемо.
В материалах WACV, январь 2022 года, Шаньчуань Линь, Линьцзе Ян, Имран Салеми и Соумьядип Сенгупта описали метод мягкого края для видео с человеком. Линь и Сенгупта — Вашингтонский университет, Ян и Салеми — ByteDance. Сеть рекуррентная: она несёт состояние от кадра к кадру и сама решает, что помнить. Авторы прямо противопоставляют это покадровой обработке, у которой нет временной связности. Подсказка-тримап и заранее снятый пустой фон не нужны. На GTX 1080 Ti они называют 76 кадров в секунду для 4K и 104 кадра в секунду для HD. Учебный сигнал двойной: и мягкий край, и обычная сегментация. Это снова человек, не произвольный товар. Ролик с крутящейся коробкой в задачу статьи не входит.
29 июля 2024 года Meta выпустила Segment Anything 2, первую общую модель сегментации для снимка и для видео. К «спрашиваемой» схеме первой версии добавили память сессии: выбранный предмет сеть ведёт по кадрам, в том числе если он ненадолго скрылся. На вход годятся щелчок, рамка или маска. В аннотации статьи — более высокая точность на видео при втрое меньшем числе правок, чем у прежних методов, а на фото — выше точность и в шесть раз выше скорость, чем у Segment Anything 2023 года. Набор SA-V, который группа открыла вместе с моделью, — порядка 600 тысяч цепочек масок на примерно 51 тысяче роликов из 47 стран.
Память лечит мигание не до конца. Быстрое движение, смена облика и перекрытие чужим предметом в новостном тексте Meta названы причиной, почему видео труднее фото. Если человек передал в кадре куртку из рук в руки, память может уехать за курткой или за руками. Проверка одна: пролистать ролик, а не смотреть удачный стоп-кадр.
Про то, как устроены модели, которые сразу рисуют ролик, отдельный разбор есть в материале о нейросетях для видео. Вырезание уже снятого кадра и генерация нового ролика делят слово «видео» и почти не делят математику.
Рисунок новой картинки — другой механизм
Кнопка в чате иногда выглядит так же, а внутри считает другое. Сеть сегментации отдаёт карту и оставляет пиксели объекта как были. Сеть, которая умеет рисовать, получает просьбу «продукт на белом» и синтезирует новый кадр. Край она может сделать приятнее исходника. Заодно она может поправить этикетку, число пальцев, шов на сумке.
Модели картинок уже доступны в чате GPThub. Как прикрепить снимок и какая модель вообще видит изображение, разобрано в гайде про картинки в чате. Там речь о скриншотах и вопросах к кадру. Вырезание фона тот гайд не обещает. Форма самого запроса — цель, ограничения, вид ответа — в гайде про запросы.
Две заметки полезны как соседний контекст, не как инструкция по маске. Flux и Nano Banana — про то, как рисующие модели держат предмет и свет. Если после «убери фон» изменилась форма товара, это симптом рисующей модели, а не сломанной альфы.
Что сверять с исходником, список короткий.
- Контур волоса и меха: лестница из пикселей или серая кайма старого фона.
- Дырки: ручка кружки, просвет подлокотника, щель между пальцами.
- Стекло и сетка: сквозь них должен читаться новый фон, а не замазка.
- Мелкий текст и логотип: буквы те же, не «похожие».
- Тень: она либо цела, если так просили, либо ушла вместе со стеной.
- На видео — соседние кадры, не один удачный.
Запрос имеет смысл писать про предмет и про край, а не про слово «фон». «Оставь кружку и тень на плоскости, вычисти стену и стол, буквы на этикетке не меняй» отличается от «сделай красиво без фона». Второе рисующая модель слышит как разрешение переписать кадр.
Удаление фона нейросетью на практике
Если цель — паспортный портрет или говорящая голова, ближе портретная линия: MODNet и видеометод 2022 года заточены под человека и умеют дробный край. Если цель — произвольный предмет по тычку, ближе Segment Anything и её видеопродолжение 2024 года. Если цель — один заметный товар в кадре, хватает линии U2-Net, с оговоркой про размер входа. Если цель — тонкий край на крупном файле, смотреть на схемы вроде BiRefNet, где локализация и сборка маски разведены.
Запрос имеет смысл проверять на двух кадрах, а не на одном удачном. Для портрета: «Оставь человека и волосы, вычисти стену, не перерисовывай лицо, край волоса оставь дробным». Для товара: «Оставь кружку, ручку и просвет внутри ручки, тень на плоскости не трогай, буквы на этикетке не меняй». Если после второго запроса изменилась форма предмета, это уже не карта покрытия. Как сеть переписывает сам снимок, а не только край, разобрано в материале про улучшение фото.
Нейросеть для удаления фона с фото не заменяет съёмку. Ровный свет и расстояние между предметом и стеной по-прежнему упрощают границу. Сеть сильнее старого хромакея именно там, где фон грязный. Она слабее человека там, где граница тоньше пикселя учебного кадра.
Нейросеть для удаления фона с картинки, нарисованной другой моделью, путается чаще, чем на фото. У рисунка края уже «пластиковые», теней нет или они нарисованы не по свету, и карта покрытия цепляется за декоративный контур. Имеет смысл править фон в том же запросе на рисунок, а не гонять готовый плакат через вторую сеть.
Для выбора, какая модель в принципе смотрит на изображение, а какая только читает текст, есть короткий ориентир по моделям. К механике альфы он не относится. Он экономит попытку скормить портрет сети, которая видит только буквы.
Дальше развилка простая. Нужна честная карта — ищите операцию сегментации или маттинга и смотрите край в полном размере. Нужен новый рекламный кадр — рисующая модель уместнее, но исходные пиксели товара она не обязана хранить. Смешивать обещания этих двух кнопок пока рано: статьи с 2017 по 2024 год решают разные уравнения.
Вопросы и ответы
Нейросеть для удаления фона смотрит на цвет стены?
Только как на один из признаков. Рабочая величина — доля покрытия пикселя, от нуля до единицы, как в канале альфы у Портера и Даффа в 1984 году. Ровный зелёный фон помогает старому приёму вычитания цвета. На бытовом фото цвет стены часто совпадает с цветом предмета, и одного цвета мало.
Нейросеть вырезает объект или перерисовывает его?
Сеть сегментации и маттинга оставляет пиксели объекта и прикладывает к ним карту. Так устроены U2-Net, MODNet, Deep Image Matting, Segment Anything. Сеть, которая генерирует изображение по запросу, собирает новый кадр. Тогда меняются и фон, и детали предмета. Сверка с исходником отличает одно от другого за минуту.
Чем нейросеть для удаления фона с фото отличается от видео?
На фото достаточно одного кадра и одной карты. На видео соседние карты должны совпасть, иначе край дрожит. Метод Линя и соавторов 2022 года несёт состояние между кадрами и заточен под человека. Segment Anything 2 с июля 2024 года ведёт указанный предмет по ролику, даже если тот ненадолго пропал из кадра.
Удаление заднего фона нейросеть делает вместе с тенью?
Не обязана. Тень для одних задач — часть предмета, для других — часть стены. В статьях про маски тень отдельно не названа классом. Её судьбу задают запросом и потом смотрят на плоскость под предметом.
Нейросеть для удаления фона с картинки испортит текст?
На мелком тексте риск высокий, если карту считают на уменьшенном кадре. У U2-Net в замере 2020 года вход 320 на 320 пикселей. Буквы тоньше этой сетки после растягивания карты плывут. На рисующей модели буквы ещё и заменяются похожими. Крупный товар без надписи страдает меньше.
Удаление фона видео нейросеть тянет любой предмет?
Нет. Рекуррентный метод WACV 2022 заявлен для человека. Segment Anything 2 ведёт тот предмет, который указали щелчком, рамкой или маской, и это не привязано к классу «человек». Коробка в кадре без указания может остаться фоном.
Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- Портер и Дафф, сборка цифровых изображений, SIGGRAPH 1984
- Текст доклада Портера и Даффа, канал альфы
- Роннебергер, Фишер, Брокс, U-Net, 18 мая 2015
- Сюй, Прайс, Коэн, Хуан, Deep Image Matting, март 2017
- Цинь и соавторы, U2-Net, май 2020
- Кэ и соавторы, MODNet, 24 ноября 2020
- Линь и соавторы, мягкий край видео, WACV 2022
- Meta, Segment Anything, 5 апреля 2023
- Набор SA-1B, описание Meta
- Segment Anything, архивная статья
- Meta, Segment Anything 2, 29 июля 2024
- Аннотация SAM 2
- Страница модели SAM 2 и набор SA-V
- Чжэн и соавторы, BiRefNet, январь 2024
- Сообщение о журнальной версии BiRefNet, 22 августа 2024
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат с картинкой
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.