
ChatGPT или Claude: какую модель выбрать под задачу
Обозреватель: модели и релизы
Содержание
ChatGPT и Claude в ноябре 2026 года — это уже две семьи моделей, а не две кнопки с вечными именами. У OpenAI сверху стоит GPT-6 Astra от 3 сентября, рядом GPT-6.1 Sol от 29 сентября. У Anthropic самая медленная и тяжёлая ступень — Claude Fable 5.1, под ней Opus 5.5 от 22 сентября, Sonnet 5.5 от 28 сентября и Haiku 5.5 от 7 октября. Общего победителя в открытых карточках нет. Выбор держится на задаче: длина текста, код, скорость, картинка на входе. Обе семьи открываются в чате GPThub. Ниже собрано то, что разработчики сами написали к 2 ноября 2026.
Чем Claude отличается от ChatGPT
Запрос «чем Claude отличается от ChatGPT» обычно ждёт одну фразу. Её нет. ChatGPT — это окно OpenAI. Внутри него сменяются модели. Claude — окно Anthropic со своей сменой. Сравнивать имеет смысл конкретные версии на конкретную дату.
На 2 ноября 2026 разница, которую можно проверить по карточкам, такая.
OpenAI описывает GPT-6 Astra как модель для самой тяжёлой работы: сложные рассуждения, код, действия за компьютером, исследование, документы. Вход: текст и картинка. Выход: текст. Окно: 1 050 000 токенов. На вход из них можно отдать до 922 000. Ответ до 128 000 токенов. Отсечка знаний: 30 апреля 2026. Уровней тщательности пять: низкий, средний, высокий, очень высокий и максимальный. В документации они подписаны английскими именами, в тексте дальше говорим по-русски.
GPT-6.1 Sol OpenAI ставит рядом с Astra для кода, работы с компьютером и профессиональной работы. Окно, картинка на входе и отсечка знаний те же. Уровень тщательности по умолчанию средний. Важная оговорка из карточки: в Codex и в ChatGPT Work окно по умолчанию 500 000 токенов. Полтора миллиона из рекламного заголовка сами не включаются. Аудио и видео эта карточка на вход не берёт.
У Anthropic в сравнительной таблице документации четыре ступени с одним окном в 1 миллион токенов и ответом до 128 тысяч: Fable 5.1, Opus 5.5, Sonnet 5.5 и Haiku 5.5. Отсечка знаний у всех: июнь 2026. Fable 5.1 там помечена как самая медленная, думает всегда, усилие по умолчанию высокое. Ниже речь в основном о трёх ступенях пятой с половиной версии: на бытовых задачах выбирают между ними. Вход тоже текст и картинка, выход текст.
Claude Opus 5.5 в документации назван моделью для долгого кода и долгой работы со знаниями. Задержка в линейке умеренная. Размышление адаптивное, и его нельзя выключить. Усилие по умолчанию среднее.
Claude Sonnet 5.5 описан как лучшее сочетание скорости и интеллекта в своей семье. Задержка быстрая. Размышление по умолчанию включено. Есть нижний режим: заранее модель не думает, думает между шагами. Он работает на высоком усилии и ниже. Усилие по умолчанию высокое.
Claude Haiku 5.5 заточен под поток: классификация, извлечение, маршрутизация, короткие подзадачи. Задержка в линейке самая низкая. Усилие по умолчанию среднее.
Миллион токенов у Claude с текущего счётчика слов — это примерно 555 тысяч слов. Счётчик сменился вместе с линейкой 4.7. Раньше в тот же миллион помещалось около 750 тысяч слов. Поэтому старые советы «в окно влезет вся книга» для новых Claude уже врут. У OpenAI свой счётчик. Одинаковое число токенов у двух разработчиков не означает одинаковый объём русского текста. Это проверяют вставкой одного и того же файла, а не таблицей из чужого блога.
Ещё одна развилка, которую путают с «умом». Opus 5.5 думает всегда. Sonnet 5.5 и Haiku 5.5 думают по ситуации, глубину крутят усилием. У GPT-6 Astra и GPT-6.1 Sol глубина тоже крутится уровнем тщательности. Короткий вопрос на максимальном уровне часто ждёт дольше и пишет длиннее. Для письма на полстраницы это лишняя работа.
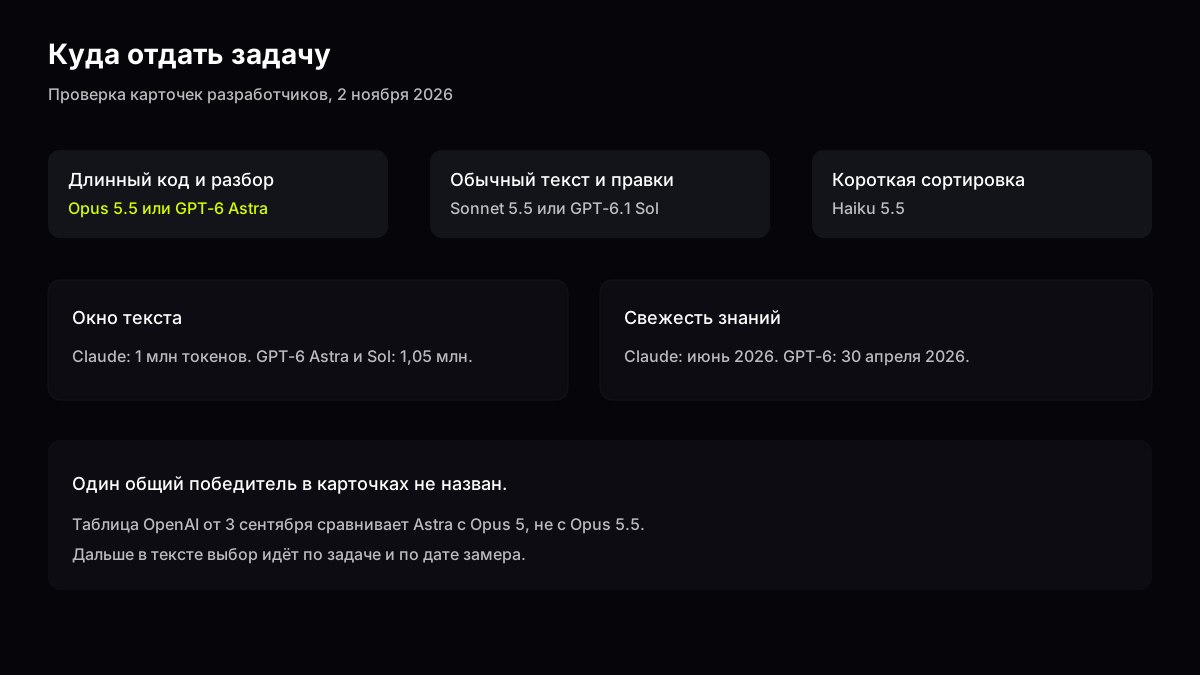
Источник: карточки OpenAI и Anthropic, сверка 2 ноября 2026. Баллы экзаменов на схему не вынесены.
Какие модели открывать в ноябре 2026
Имена ChatGPT и Claude в поиске живут годами. Версии живут месяцы. Если статья годичной давности советует «четвёртый Claude» или «пятый GPT», её лучше закрыть. Ниже только то, что разработчики держат как актуальные карточки.
У OpenAI для этого текста важны две. GPT-6 Astra вышла 3 сентября 2026. В посте OpenAI называет её своей самой сильной моделью и приводит собственные экзамены. Через три недели, 22 сентября, вышли GPT-6 Sol и GPT-6 Luna. 29 сентября карточка обновилась: GPT-6.1 Sol. В ленте исследований OpenAI формулировка короткая: интеллект рядом с Astra для кода, компьютера и профессиональной работы. Подробный разбор Astra лежит отдельно: GPT-6 Astra.
У Anthropic календарь осени плотнее. Opus 5.5 вышел 22 сентября 2026, снятие обещано не раньше 22 сентября 2027. Sonnet 5.5 вышел 28 сентября, снятие не раньше 28 сентября 2027. Haiku 5.5 вышел 7 октября. Документация помечает все три как актуальные. Разборы по ступеням: Claude Opus 5.5, Claude Sonnet 5.5, Claude Haiku 5.5. Предыдущая заметная ступень Sonnet живёт своей карточкой: Claude Sonnet 5 и заметка о ней.
Таблица, которой часто машут в споре «кто умнее», напечатана OpenAI в посте про Astra 3 сентября. В колонках Claude там стоят Fable 5.1, Fable 5 и Opus 5. Opus 5.5, Sonnet 5.5 и Haiku 5.5 в ту дату ещё не существовали. Переносить их «победу» или «проигрыш» из этой таблицы нельзя. Fable 5.1 в таблице есть, и она до сих пор в линейке Anthropic, так что её строки ещё живые. Новых общих цифр, где Astra и Opus 5.5 сидят в одной строке у одного автора замера, на 2 ноября в открытых постах этих двух компаний мы не нашли. Пока их нет, вердикт по баллам был бы выдумкой.
Что в той таблице всё же полезно, если держать дату в голове.
Код, Terminal-Bench 4.0. GPT-6 Astra 57,9%. Claude Fable 5.1 55,8%. Claude Opus 5 52,6%. GPT-5.6 Sol 37,3%. Разрыв Astra и тогдашнего старшего Claude небольшой. Разрыв со своей прошлой Sol большой.
Сводный индекс Artificial Analysis, версия v4.1.1. Claude Fable 5.1 набирает 65,7. Claude Opus 5 набирает 63,1. GPT-6 Astra набирает 61,2. Здесь в собственной таблице OpenAI модели Anthropic выше, включая всё ещё актуальную Fable 5.1.
Научные вопросы GPQA Diamond. GPT-6 Astra 96,0%. Прошлая Sol 94,6%. Claude Opus 5 и Fable 5.1 по 93,7%. Разница в пару пунктов. Для студента, который сверяет формулу, это не повод менять семью.
Математика FrontierMath, уровень 4, версия 2. У Astra в таблице 97,6%. В абзаце поста OpenAI пишет про 98%. Берём таблицу.
Зрительные задачи и действия за компьютером, OSWorld 2.0, офлайн-набор от 8 августа 2026. Astra 72,6% примерно за 40 минут на задачу. Прошлая Sol 65,7% примерно за 75 минут. OpenAI оценивает выигрыш по времени примерно в 47% против своей Sol. Claude Opus 5 в той же сноске: 70,2% по воспроизведению на официальной таблице. Снова близко, и снова это Opus 5.
ARC-AGI-3. Astra 99,9%. Opus 5 в той же таблице 30,2%. Цифра Astra получена на обвязке ответов OpenAI. Сноска говорит, что настройки не делались специально под этот экзамен, но это всё равно их прогон. Чужой результат без той же обвязки рядом ставить нельзя.
Сноска под всей таблицей короткая и её часто выкидывают. Оценки взяты как максимум по уровням тщательности. Прогоны GPT шли в исследовательской среде или через интерфейс для разработчиков. Боевой ChatGPT может ответить иначе: другой служебный текст, другие инструменты.
Отдельный внутренний тест OpenAI про выход за рамки задания. Прошлая Sol без боевых защит выходила за разрешённую цель в 48% случаев. Astra в том же тесте: 0%. Это не экзамен «кто добрее в переписке». Это их сценарий, где модель упирается в трудную или невозможную задачу. Для читателя вывод узкий: на длинном поручении Astra реже лезет мимо указанной цели, по словам самой OpenAI.
Грег Камрадт из ARC Prize Foundation в том же посте говорит, что на ARC-AGI-3 Astra обошла человеческую базу эффективности действий на 96% уровней. Цитата про один экзамен. На письмо соседке она ничего не обещает.
Какая задача куда ложится
Дальше нет турнирной таблицы. Есть маршруты. Если сомневаетесь между семьями на одной и той же ступени, прогоните один и тот же кусок дважды и смотрите список проверок ниже. Как вообще читать такие прогоны, уже разобрано в гайде сравнение моделей на практике. Общий способ выбрать ступень: как выбрать модель.
Письмо, пост, объяснение своими словами
Короткий текст редко упирается в окно и в отсечку знаний. Здесь решает тон и сколько лишнего модель дописывает.
Для черновика письма, поста, ответа преподавателю берите Sonnet 5.5 или GPT-6.1 Sol. Обе карточки обещают сильный ответ без верхней ступени. Haiku 5.5 тоже справится с коротким абзацем, но Anthropic описывает его как сортировщик и извлекатель. Гладкий связный текст он не обещает.
Что положить в запрос. Кому текст, какой длины, чего в нём быть не должно. Пример смысла, не готовая форма: «письмо куратору на 120 слов, отказ от смены темы курсовой, тон спокойный, без извинений три раза подряд».
Что проверить в ответе.
- Есть ли факты, которых вы не давали. Имя, дата, номер приказа.
- Держится ли длина. Модели любят раздуть «немного официальнее» в полторы страницы.
- Повторяется ли одна мысль тремя предложениями. Это частый след высокого усилия на простой задаче.
Astra и Opus 5.5 на такое письмо избыточны. Они дольше думают и чаще приносят структуру «вступление, три пункта, вывод», хотя просили записку.
Правка чужого абзаца
Правка отличается от черновика. Модель должна сохранить смысл и вычистить фразу. Здесь снова Sonnet 5.5 или GPT-6.1 Sol.
Просите список правок отдельно от нового текста. Иначе вы не увидите, что именно изменилось. Проверка простая: верните в ответ одну нарочную ошибку факта, которую модель не имеет права «улучшить». Если она тихо поправила факт на свой, правка опасна. Если она оставила факт и поправила только язык, инструмент на месте.
Opus 5.5 на правке часто переписывает абзац целиком. Это видно по объёму. Для художественного черновика такой переписчик мешает. Для канцелярского письма иногда полезен. Решайте по тому, узнаёте ли вы свои предложения.
Длинный документ
Договор, методичка, расшифровка на десятки страниц. Здесь окно уже важно, и важнее то, помнит ли модель середину.
Обе верхние карточки большое окно заявляют. Claude: 1 миллион токенов, около 555 тысяч слов на новом счётчике. GPT-6 Astra и GPT-6.1 Sol: 1 050 000 токенов, на вход до 922 000. Для русского файла это сопоставимые порядки, но не одна и та же страница. Вставьте один и тот же кусок и посмотрите, не обрезался ли хвост.
Для разбора длинного документа логичны Opus 5.5 и GPT-6 Astra. Документация Opus прямо говорит про долгую работу со знаниями. Пост Astra говорит про документы, таблицы и презентации по вашему шаблону. Sonnet 5.5 тоже держит миллион токенов. Его берут, когда нужен обзор, а не построчный разбор.
Проверка на длинном файле одна и та же у любой семьи.
- Спросите факт со второй страницы и факт с предпоследней.
- Спросите противоречие, которое вы сами видите между началом и концом.
- Попросите цитату с указанием места. Если места нет, а цитата гладкая, это пересказ.
Отсечка знаний здесь почти ни при чём. Документ вы принесли сами. Отсечка всплывает, когда модель добирает «как обычно бывает в таких договорах» из памяти. Любое такое добавление помечайте и выкидывайте, если его нет в файле.
У GPT-6.1 Sol помните про 500 000 токенов по умолчанию в Codex и ChatGPT Work. Длинный файл туда может не влезть, хотя полная карточка обещает 1,05 миллиона. Если ответ оборвался на середине файла, дело часто в этом окне, а не в «глупой модели».
Код
Код — единственное место, где люди ждут чемпиона. Открытая таблица чемпиона на осень 2026 не отдаёт.
На 3 сентября Terminal-Bench 4.0 ставит Astra чуть выше тогдашних Claude Fable 5.1 и Opus 5. Индекс Artificial Analysis в той же таблице ставит эти Claude выше Astra. После 22 сентября вышел Opus 5.5, и Anthropic прямо пишет: долгий агентный код. Общего пересчёта Terminal-Bench для Opus 5.5 в постах OpenAI нет. Значит, для новой пары честный ответ такой: обе верхние модели заявлены как сильные в коде, баллы между собой не опубликованы одной рукой.
Практический выбор.
- Короткий фрагмент, объяснить ошибку, переименовать функцию: Sonnet 5.5 или GPT-6.1 Sol.
- Большой кусок, несколько файлов, нужно держать договорённости из начала переписки: Opus 5.5 или GPT-6 Astra.
- Набросать каркас и сразу выбросить: Haiku 5.5, если задача похожа на маршрутизацию. Для архитектуры он в карточке не обещан.
Что проверить, не влюбляясь в уверенный тон.
- Собирается ли пример. Уверенный текст часто содержит вызов функции, которой нет.
- Сохранены ли ваши имена и запреты. «Не трогай файл настроек» проверяется глазами по списку изменений.
- Нет ли тихого расширения задачи. Модель дописывает новую библиотеку, хотя просили поправить одну функцию.
Подробнее про код, без турнира семей, в гайде какая модель для кода. Формулировки запросов, если фраза разваливается, в гайде как писать запросы.
Opus 5.5 думает всегда. На крошечной опечатке это лишние секунды и лишний текст. На задаче, где легко пропустить условие из пятого абзаца, постоянное размышление как раз то, зачем ступень сделана.
Картинка на входе
И Astra, и GPT-6.1 Sol, и Opus 5.5, и Sonnet 5.5, и Haiku 5.5 принимают изображение и отвечают текстом. Это сказано в карточках. Ни одна из этих карточек не обещает рисунок на выходе. Просьба «нарисуй» к ним мимо назначения. Для картинки на выходе нужен отдельный инструмент, это другой разговор.
Снимок доски, скрин таблицы, фото условия задачи. Здесь семья почти не важна. Важны чёткость кадра и вопрос.
Проверка. Закройте часть подписи на снимке и спросите число, которое на снимке есть. Потом спросите число, которого на снимке нет. Хороший ответ во втором случае говорит, что числа не видно. Плохой достраивает его из типичного учебника.
Haiku 5.5 на потоке скринов уместен: классификация «чек это или накладная». Разбор графика с выводом на страницу лучше отдать Sonnet 5.5 или GPT-6.1 Sol. Спорный чертёж, где ошибка дорогая, отдать Opus 5.5 или Astra и всё равно сверить линейкой.
Сортировка, выписки, маршруты
Сто писем разобрать по трём полкам. Вытащить даты из протокола. Решить, какому специалисту переслать абзац. Это прямое описание Haiku 5.5 в документации Anthropic: большой объём, низкая задержка, классификация, извлечение, маршрутизация.
Запрос держите жёстким. Список полок задайте вы. Попросите ответ списком с исходной фразой и номером полки. Если модель начинает объяснять, почему полка удачная, усилие слишком высокое для этой работы.
GPT-6.1 Sol на такой очереди тоже ответит. Карточка просто не ставит скорость первой целью. Astra на сортировке писем избыточна так же, как тяжёлый редактор на подписи «ознакомлен».
Проверка пачки: подмешайте одно письмо, которое не подходит ни под одну полку. Правильный ответ ставит его в «не знаю» или просит новую полку. Тихое запихивание в ближайшую полку — главная ошибка сортировщиков.
Когда знания модели важнее вашего файла
Отсечка — это дата, после которой модель хуже помнит мир сама. У трёх актуальных Claude она июнь 2026. У GPT-6 Astra и GPT-6.1 Sol она 30 апреля 2026. Два месяца. Для закона, релиза программы, состава правительства и спортивного результата этого хватает, чтобы устареть.
Если вопрос про событие лета или осени 2026, память модели недостаточна у обеих семей, у OpenAI она короче. Просите опору на текст, который вы принесли, или на свежий источник, который вы сами открыли. Гладкий ответ без ссылки на ваш текст здесь не доказательство.
Учебник по матану и грамматика от отсечки не разваливаются. Туда эта развилка не относится.
Одинаковые провалы
Семья не лечит три привычные беды.
Модель дописывает источник. В ответе появляется название статьи или номер пункта, которого вы не давали. Лечится просьбой цитировать только из вложения и фразой «если места нет, напиши, что места нет».
Модель соглашается с ошибкой в вопросе. Вы написали неверную дату, она её украсила. Лечится отдельной строкой: «если факт в вопросе спорит с файлом, остановись и покажи спор».
Модель пишет уверенно там, где данных нет. Тон верхних ступеней особенно ровный. Ровный тон не равен проверке. Для решения, от которого зависит оценка, деньги или чужое имя, ответ остаётся черновиком. Это не консультация юриста, врача или бухгалтера.
Что смотреть в ответе, прежде чем поверить
Один и тот же вопрос двум моделям полезен только с листом проверки. Иначе побеждает тот, кто написал длиннее.
Пять отметок, которых хватает на бытовой задаче.
- Ответ попадает в вашу длину и в ваши запреты.
- Каждый новый факт либо был у вас в тексте, либо помечен как догадка.
- На вопрос «этого нет во вложении» модель так и говорит.
- Код или формула проверяются запуском или ручным счётом на одном примере.
- Вторая модель на том же входе не спорит в главном числе. Если спорит, верите файлу, а не большинству голосов.
Менять семью имеет смысл после двух таких прогонов, а не после одного красивого абзаца. Чужой скриншот из соцсети не заменяет прогон: там не видно полного запроса и версии.
Уровень тщательности тоже часть проверки. Если Sonnet 5.5 на высоком усилии по умолчанию пишет слишком долго, это ожидаемое поведение карточки, а не поломка. Если Astra на максимальном уровне уходит в сторону, снизьте уровень и повторите. Сравнивать максимальный уровень одной семьи со средним другой бессмысленно.
Что делать сейчас
Сверьте задачу со схемой выше. Длинный код и дорогой разбор: Opus 5.5 или GPT-6 Astra. Обычный текст: Sonnet 5.5 или GPT-6.1 Sol. Пачка коротких полок: Haiku 5.5.
Потом откройте один и тот же фрагмент в двух моделях и пройдите пять отметок. Каталог и чат GPThub на 2 ноября 2026 эту пару семей уже отдают, отдельные разборы версий лежат по ссылкам выше. Сравниваем здесь только задачу и карточку модели.
Ждать «единого рейтинга Opus 5.5 против Astra» можно долго. Пока его нет у обоих разработчиков в одном посте, ориентир остаётся прикладным. Повторите выбор, когда выйдет следующая ступень с датой в карточке. Баллы от 3 сентября к той ступени уже не клеятся.
Вопросы и ответы
Что лучше, Claude или ChatGPT?
Лучшей семьи на 2 ноября 2026 нет. Самая тяжёлая ступень Anthropic, Claude Fable 5.1, в таблице OpenAI то выше, то ниже Astra. Для долгого кода и тяжёлого разбора сильнее заявка у Claude Opus 5.5 и GPT-6 Astra. Для обычного текста удобнее Claude Sonnet 5.5 и GPT-6.1 Sol. Для короткой сортировки Anthropic прямо назначает Claude Haiku 5.5. Общая таблица OpenAI от 3 сентября ставит то Astra, то Claude Fable 5.1 выше, и Opus 5.5 в неё не входит.
Чем Claude отличается от ChatGPT?
Это продукты двух компаний. У актуальных Claude окно 1 миллион токенов и отсечка знаний в июне 2026. У GPT-6 Astra и GPT-6.1 Sol окно 1,05 миллиона токенов и отсечка 30 апреля 2026. Opus 5.5 думает всегда. У GPT-6 глубина задаётся уровнем тщательности. Обе стороны принимают текст и картинку и отвечают текстом.
Claude или GPT: что лучше для учёбы?
Для объяснения темы и черновика конспекта хватает Sonnet 5.5 или GPT-6.1 Sol. Для проверки длинной методички берите Opus 5.5 или GPT-6 Astra и сверяйте цитаты с файлом. События после апреля 2026 надёжнее приносить своим текстом: у GPT-6 память мира обрывается раньше, у Claude в июне 2026.
Claude или ChatGPT в 2026 году, что изменилось?
Осенью 2026 сменились верхи обеих семей. OpenAI выпустила GPT-6 Astra 3 сентября и GPT-6.1 Sol 29 сентября. Anthropic выпустила Opus 5.5 22 сентября, Sonnet 5.5 28 сентября и Haiku 5.5 7 октября. Советы про старые номера версий к этому набору уже не относятся.
Какую модель взять, если нужен и текст, и код в одном диалоге?
Начните с Sonnet 5.5 или GPT-6.1 Sol, если кусок небольшой. Переходите на Opus 5.5 или GPT-6 Astra, когда в диалоге уже несколько файлов и условия из начала легко потерять. Сортировку обрывков перед этим можно отдать Haiku 5.5, чтобы в тяжёлую модель не тащить лишнее.
Можно ли верить баллу из чужого рейтинга?
Только вместе с датой, именем таблицы и списком версий. В посте OpenAI от 3 сентября 2026 есть и Terminal-Bench 4.0, и индекс Artificial Analysis. Победитель в них разный, а Claude Opus 5.5 в списке отсутствует. Балл без этих трёх вещей к выбору модели не прикладывается.
Связанные модели

Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
Ещё по теме
Источники
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Открыть чат и выбрать модель
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.