
Что такое эмбеддинг: как нейросеть превращает текст в числа

Обозреватель: как устроен ИИ
Содержание
В июне 2013 года на конференции NAACL в Атланте Томаш Миколов, Вэнь-тау Йи и Джеффри Цвейг из Microsoft Research показали неожиданный эксперимент. Если взять длинный список чисел, который описывает слово «король», вычесть числа для «мужчина» и прибавить числа для «женщина», результат оказывается близок к списку для «королева». Никакой программист вручную не прописывал правило «королевская семья» — его вытащила из текстов статистика. Такие списки чисел называют эмбеддингами, и без них не работает ни поиск по смыслу, ни многие функции больших языковых моделей.
Зачем нейросети вообще нужны числа
Компьютер хранит буквы как коды символов. Для человека «кот» и «кошка» близки, для таблицы Unicode — это разные цепочки без всякой «близости». Старые поисковики сравнивали слова буквально: опечатка или синоним ломали выдачу.
Нейросеть для текста устроена иначе. Она умножает вход на огромные матрицы весов, а умножать можно только числа. Значит, каждый фрагмент текста нужно превратить в числовой объект фиксированной длины. Такой объект и есть эмбеддинг, или векторное представление текста.
Если сжать историю до одной линии, получится так: сначала инженеры научились складывать слова в векторы статистически (word2vec, GloVe), потом научились пересчитывать вектор на каждом слое с учётом соседей (BERT), потом стали продавать отдельные модели, которые выдают вектор целого абзаца для поиска (семейство text-embedding-3 у OpenAI), а большие чаты спрятали всю цепочку внутрь одной кнопки «отправить». Для понимания хватит трёх уровней: слово, токен в предложении, документ в базе.
Привычная аналогия — «каждому слову присвоили номер в телефонном справочнике». Справочник здесь слабый пример. Номера не отражают смысл, а эмбеддинги устроены так, чтобы близкие по смыслу слова имели близкие списки чисел. Расстояние между двумя векторами подсказывает, насколько тексты похожи, даже если общих слов нет.
Схема короткая: текст превращается в длинный вектор, и дальше слои сети работают уже с ним. Вопросы начинаются потом: сколько в векторе чисел, откуда они берутся и меняются ли от предложения к предложению.
Сначала полезно отделить две задачи. Обучение эмбеддингов — долгий прогон по интернету или корпусу книг, который делают лаборатории. Использование — уже готовая модель превращает ваш абзац в вектор за доли секунды. Обычный пользователь почти всегда имеет дело со вторым: веса давно посчитаны, вы лишь подаёте текст на вход.
Внутри чата эмбеддинги не «выключить» и не «увидеть». Они часть цепочки обработки, как скрытые слои в любой нейросети. Когда в новости пишут «компания выпустила эмбеддинги», речь чаще об отдельном продукте для поиска. Чат-боты использовали эмбеддинги и раньше.
Что такое эмбеддинг
Эмбеддинг (от англ. embedding — «вложение») — способ записать объект в пространстве с фиксированной размерностью так, чтобы полезные свойства объекта превратились в геометрию. Для текста объектом может быть отдельное слово, предложение, абзац или целый документ.
Размерность — сколько чисел в списке. В ранних моделях word2vec часто встречались 100 или 300 чисел на слово. У сервисных моделей эмбеддингов OpenAI семейства text-embedding-3 по умолчанию 1536 или 3072 числа, и размер можно уменьшить параметром запроса, если базе данных нужны более короткие векторы. Речь идёт о компромиссе между детальностью и местом на диске, а не о «точности в процентах».
Токен — кусок текста, с которым модель работает за один шаг (часто это часть слова или целое слово). Окно контекста — сколько токенов модель видит сразу. Эмбеддинг токена — первый слой представления внутри большой сети; дальше идут блоки внимания и прочие преобразования.
Эмбеддинг слова: word2vec и GloVe
Первые массовые векторы слов принёс word2vec. В январе 2013 года Томаш Миколов и соавторы из Google описали две лёгкие архитектуры. CBOW угадывает слово по соседним, Skip-gram наоборот угадывает соседей по одному слову. Модель читает огромный корпус и подстраивает числа так, чтобы слова, которые встречаются в похожих окружениях, оказались рядом в векторном пространстве. На наборе в 1,6 миллиарда слов обучение занимало менее суток — для своего времени это было рекордно дёшево по вычислениям.
В экспериментах по точности CBOW авторы сравнивали размерности 50, 100, 300 и 600. Больше чисел — обычно лучше на тестах сходства, но с убывающей отдачей: каждый следующий десяток измерений даёт меньше, чем предыдущий.
Статья Миколова, Йи и Цвейга из Microsoft Research на NAACL в июне 2013 года показала линейные закономерности: вектор «король» минус «мужчина» плюс «женщина» ложится близко к вектору «королева». Это следствие статистики языка, без «магии словаря». В 2014 году появился GloVe — там эмбеддинги строят из глобальной таблицы, как часто слова встречаются рядом в тексте. Подходы разные, идея одна — смысл в координатах.
С готовыми статическими векторами работа выглядит так: скачанный файл уже содержит строки чисел для огромного словаря, и программа лишь находит строку по слову, ничего не переучивая. Если на учёбе просят «построить эмбеддинг», уточните, нужно ли обучить модель на корпусе или получить вектор готовой моделью. По времени и железу это разные задания.
У такого статического эмбеддинга слова есть заметный недостаток. Слово «мир» в «мир между странами» и «объехал весь мир» получает один и тот же вектор, хотя значения разные. Для старых поисковых систем это терпели; для вопросов и ответов — уже нет.
Тем не менее статические векторы до сих пор полезны как первый слой интуиции. Они объясняют, откуда взялась идея «синонимы рядом на карте». Если вы видите в курсе формулу «король − мужчина + женщина», это как раз наследие word2vec, а не шутка из форума.
| Поколение | Что кодируется | Зависит от соседних слов? |
|---|---|---|
| word2vec / GloVe | одно слово | нет |
| BERT и позже | каждый токен в предложении | да |
| Сервисные эмбеддинги | абзац или документ | да, через большую модель |
Контекстные эмбеддинги и BERT
Контекстные эмбеддинги решают проблему омонимов. Модель BERT, которую Google AI Language представила в октябре 2018 года, читает предложение с двух сторон сразу — каждый токен видит и левых, и правых соседей через механизм внимания в архитектуре Transformer. На наборе GLUE итоговый балл BERT достиг 80,5% — на 7,7 процентных пункта выше предыдущего лучшего результата на тот момент.
Конфигурация BERT-Base — 12 слоёв, скрытый размер 768, 12 голов внимания, порядка 110 миллионов параметров. На выходе каждого слоя у токена свой вектор; для классификации предложения часто берут специальный токен в начале последовательности.
Логика в таком решении простая. Пока модель читает предложение только слева направо, слово в конце фразы «не видит» начало. Для грамматики русского это больно: согласование, относительные прилагательные, отрицание. Двунаправленное чтение дороже по вычислениям, зато один токен несёт в себе след и левого, и правого контекста. Именно поэтому в курсах 2020-х годов BERT стал эталонным примером «контекстного эмбеддинга», хотя генеративные модели вроде GPT читают текст только слева направо.
BERT вообще не чат. Это кодировщик, который дообучают под поиск ответа, определение тональности, разметку имён. Но именно контекстные векторы из таких моделей легли в основу промышленного поиска по документам и в корпоративные базы знаний.
Когда говорят об эмбеддинге в контексте, имеют в виду, как модель представляет ваш фрагмент текста прямо сейчас, с учётом соседних слов. В большом чате тот же приём: каждый токен вашего запроса проходит через таблицу эмбеддингов и дальше через десятки слоёв. Вы не видите списка чисел, но без этого шага ответ не родится.
Эмбеддинги внутри нейросети
Архитектуру Transformer описали в 2017 году: в базовой конфигурации размерность модели 512, восемь голов внимания, шесть слоёв в кодировщике и столько же в декодировщике. С тех пор масштабы выросли на порядки, схема осталась.
Механизм внимания здесь не декорация. Он решает, какие уже посчитанные эмбеддинги соседних токенов смешать с текущим. После каждого слоя вектор токена чуть ближе к «смыслу фразы целиком», а не только к «смыслу одного слова». Поэтому эмбеддинг в нейронной сети — это целая траектория векторов от входа к выходу, а не одна строчка чисел.
Если описать точнее, это первый обучаемый слой, который переводит дискретные токены в непрерывные векторы, плюс все последующие преобразования, которые уточняют смысл. В чистом кодировщике цепочка заканчивается вектором, пригодным для сравнения или классификации. В генеративном чате та же цепочка подаётся в блоки, которые предсказывают следующий токен.
Коротко: это внутреннее состояние сети на входе (и частично внутри), записанное в виде чисел. Отдельные сервисы продают готовые модели эмбеддингов: вы отправляете текст, получаете вектор для базы данных. Большой чат вроде Gemini 3.8 Flash или DeepSeek V4 Flash строит эмбеддинги внутри себя и сразу использует их для генерации ответа — отдельный файл векторов вам не показывают.
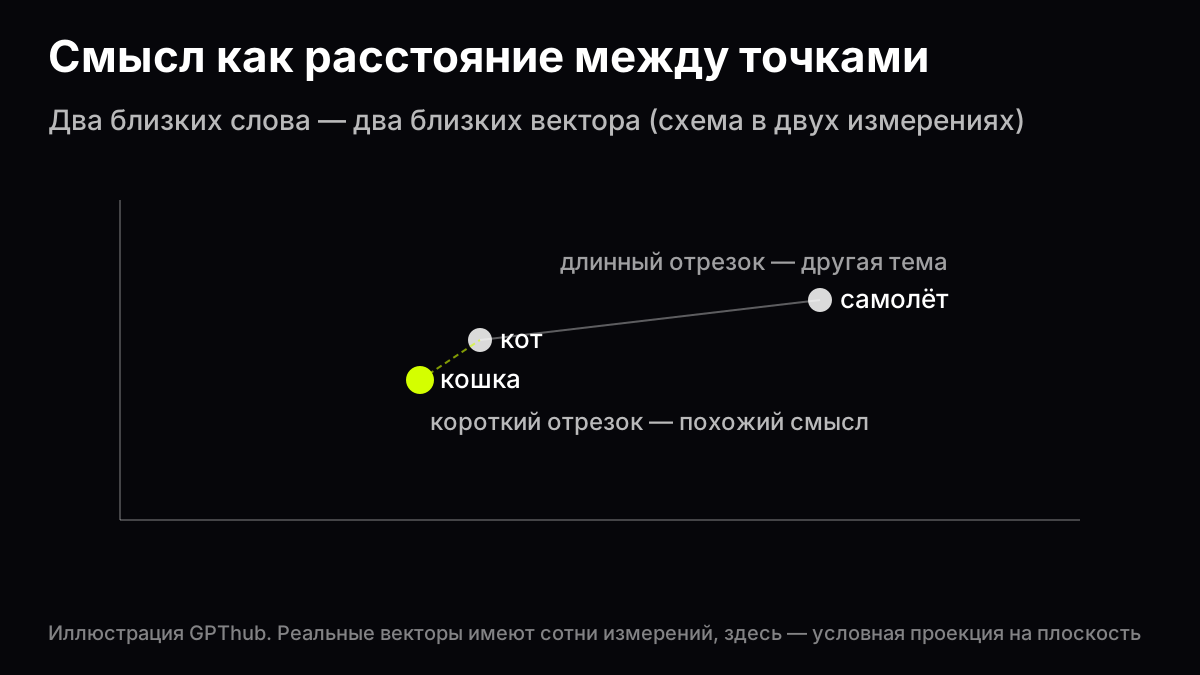
Схема расстояния между векторами, иллюстрация GPThub
Связь с тем, как устроен DeepSeek, прямая: и смесь экспертов, и длинное окно контекста работают уже после того, как текст стал числами. Экономия параметров не отменяет эмбеддинги — меняет то, что происходит дальше.
Векторное представление текста и поиск
Когда эмбеддинг посчитан для абзаца, его кладут в векторную базу — специализированное хранилище, где быстро ищут ближайшие соседи. Запрос пользователя тоже превращают в вектор тем же алгоритмом, и система достаёт тексты с минимальным «угловым» расстоянием. Так работает семантический поиск в корпоративных архивах и в связках «база документов + чат», где модель сначала находит фрагменты, потом пишет ответ.
Типичный рабочий цикл включает четыре шага.
- Разбить документы на куски по смыслу (абзац, страница, раздел).
- Прогнать каждый кусок через модель эмбеддингов и сохранить вектор с метаданными.
- При вопросе пользователя построить вектор запроса и выбрать несколько ближайших кусков.
- Передать найденный текст в большую языковую модель как контекст.
На шаге 2 важно не перепутать модель — векторы от разных версий несовместимы, как разные системы координат. На шаге 3 мелкие ошибки поиска бьют по фактам сильнее, чем красивый стиль ответа.
Сервисные модели вроде text-embedding-3-small принимают до 8192 токенов на один текст и ограничивают суммарный объём одного пакетного запроса 300 000 токенов. Длинный договор приходится резать, иначе вектор будет считаться только для начала файла.
Похожесть двух векторов чаще всего меряют косинусным расстоянием — смотрят на угол между стрелками, а не на длину списка чисел. Если угол маленький, тексты близки по смыслу, даже когда формулировки разные. Это удобно при поиске по конспектам: запрос «лекция про гравитацию» может найти абзац, где слово «гравитация» не встречается, но говорится про «ускорение свободного падения».
Эмбеддинги не обязаны описывать слова. Те же списки чисел строят для картинок, фрагментов звука и строк кода, если модель учили на таких данных. Здесь речь о словах и предложениях, потому что их чаще всего и имеют в виду.
Как почувствовать идею в чате
Отдельный сервис эмбеддингов для этого не нужен. Уже в чате можно проверить, как модель различает смысл, и поймать типичные ошибки.
Эксперимент 1 — омоним. Напишите две фразы: «Замок на двери ржавый» и «Замок на холме старый». Попросите модель одной строкой объяснить, о чём каждая фраза, и указать ключевое слово-омоним. Хороший ответ называет разные значения «замок» без подмены одного другим. Если модель путает дверь и крепость, значит, контекст она собрала слабо — для таких задач лучше брать модель с запасом по окну контекста, как DeepSeek V4 Flash на длинных вставках.
Эксперимент 2 — синонимы и перефраз. Дайте короткий абзац из учебника и попросите пересказать его двумя способами, сохранив факты, но сменив формулировки. Сравните: совпадают ли имена, даты, числа. Эмбеддинги внутри модели как раз заточены под то, чтобы перефраз оставался близким к оригиналу; ошибки на цифрах показывают, где близость по смыслу не гарантирует точность.
Эксперимент 3 — объяснение термина. Попросите объяснить разницу между «эмбеддинг слова» и «эмбеддинг предложения» простыми словами, без формул. В ответе должны появиться идея одного вектора на слово против вектора, зависящего от контекста. Если модель уходит в общие слова про «нейросеть всё понимает», сузьте запрос: «приведи один пример омонима на русском».
Эксперимент 4 — близость без копирования. Вставьте два абзаца на одну тему: в первом формальным языком опишите, что такое фотосинтез, во втором — перескажите тем же смыслом бытовой метафорой про «кухню листа». Спросите: «какой абзац ближе к вопросу “как растение делает сахар из света” и почему». Модель не показывает косинусное расстояние, но аргументация в ответе обычно повторяет логику эмбеддингов — совпадают роли объектов, а не буквы.
Проверять ответы лучше по чек-листу, а не «на глаз»:
| Что спросили | На что смотреть в ответе |
|---|---|
| Омоним | Два разных значения названы явно |
| Перефраз | Числа и имена не поплыли |
| Определение | Есть контраст «одно слово / целая фраза» |
| Два абзаца | Модель ссылается на смысл, а не на общие слова |
В учебниках часто показывают «карту слов». Реальные карты строят алгоритмом понижения размерности: тысячи измерений сжимают до двух, чтобы точки поместились на плоскости. Такая картинка учебная. Расстояния на ней приблизительные — два слова могут выглядеть рядом на рисунке и быть далеко в полном векторе. Поэтому в статьях и лекциях схему всегда подписывают как иллюстрацию, а не как измерение.
Подробнее о формулировках — в гайде как писать запросы. Выбор модели под длину текста — в как выбрать модель.
Gemini 3.8 Flash уже доступна в чате GPThub и удобна на коротких экспериментах: быстрый отклик, понятные объяснения на русском. Для сравнения двух моделей на одном и том же абзаце переключите модель в интерфейсе и повторите эксперимент 2 — расхождения в цифрах и именах покажут, где эмбеддинги и память модели расходятся с вашим текстом.
Типичная ошибка в экспериментах — просить модель «выведи эмбеддинг слова кот». Большой чат не обязан показывать сырой вектор — у него другой интерфейс, не архив чисел. Корректная постановка звучит так — «объясни, чем отличаются два значения слова «коса» в двух предложениях» или «найди в моём тексте абзац, ближайший по смыслу к вопросу». Так вы проверяете поведение, которое и дают эмбеддинги внутри, а не несуществующую кнопку «скачать вектор».
Впрочем, если цель — именно база для поиска по лекциям, это уже ближе к инженерной задаче: нужна модель эмбеддингов, индекс и скрипт загрузки. Для понимания идеи хватит чата и пары аккуратных запросов, а для «умного архива» без кода не обойтись.
Как проверить поиск по смыслу на своих документах
Если вы собрали базу из конспектов или рабочих инструкций, качество поиска стоит проверить до того, как доверять ответам. Удобнее всего завести короткий список контрольных вопросов, к которым вы заранее знаете правильный абзац.
- Выпишите десять вопросов разной формы: точная цитата, пересказ своими словами, вопрос с опечаткой, вопрос с синонимом.
- Для каждого вопроса отметьте, какой фрагмент базы считается правильным ответом.
- Посмотрите, попадает ли этот фрагмент в первые три найденных результата.
- Поменяйте одну настройку, например длину фрагментов, и повторите тот же список.
Типичная картина такая: точные цитаты находятся почти всегда, пересказы чуть хуже, а вопросы с числами и именами собственными страдают сильнее всего. Причина понятна из устройства эмбеддингов: вектор хорошо передаёт общий смысл, но номер статьи закона или фамилия для него лишь одна деталь из многих. Поэтому в рабочих системах поиск по смыслу часто дополняют обычным поиском по словам и объединяют результаты.
Второе, на что стоит смотреть, — границы фрагментов. Если абзац разрезан посередине, половина мысли попадает в один вектор, половина в другой, и ни один не похож на вопрос. Помогает резать по заголовкам и абзацам, а не по фиксированному числу символов, и оставлять небольшое перекрытие между соседними кусками. Как сравнивать ответы разных моделей на одном материале, разобрано в гайде сравнение моделей на практике.
Частые путаницы
Эмбеддинг ≠ перевод. Вектор не является текстом на другом языке. Его нельзя «расшифровать» обратно в абзац без полной модели.
Эмбеддинг ≠ хеш. Хеш текста меняется от одной запятой; эмбеддинг близких по смыслу фраз остаётся близким, даже если слова другие.
Больше размерность ≠ всегда лучше. После определённого порога качество растёт медленно, а память базы — быстро. У моделей эмбеддингов OpenAI третьего поколения размер можно уменьшить осознанно.
Один вектор на документ ≠ понимание. Если слишком длинный файл сжали в один эмбеддинг, мелкие детали потерялись. Отсюда правило резать документ на куски.
Чат без поиска по базе всё равно использует эмбеддинги внутри. Просто он не показывает вам этап «найти похожий абзац в архиве».
Ещё одна путаница — между эмбеддингом и вероятностью следующего слова. Чат на каждом шаге выбирает следующий токен из словаря, а эмбеддинги — это промежуточное представление, на котором строится выбор. Можно думать так — эмбеддинги это черновик смысла, оценки на выходе это ставки на конкретное слово. Это помогает понять случаи, когда модель «поняла вопрос», но ответила термином мимо: черновик был верный, финальное слово — нет.
Что меняется дальше
Модели эмбеддингов обновляются отдельно от больших чатов. В январе 2024 года OpenAI представила text-embedding-3-small и text-embedding-3-large с возможностью укоротить вектор без полного пересчёта базы. На бенчмарке MTEB средний балл small-модели вырос с 61,0% у предыдущего поколения ada-002 до 62,3% — скромный, но измеримый шаг.
В больших чатах тренд другой: контекстные эмбеддинги давно встроены внутрь, а соревнование идёт за длину окна и точность на фактах. Если вы читаете новость «новая модель эмбеддингов», проверьте, идёт ли речь о поиске по архиву или о генерации текста — это смежные, но не одинаковые продукты.
Для учёбы полезно один раз прогнать четыре эксперимента из раздела выше в чате и сохранить удачные формулировки запросов в свои заметки. Это ближе к реальной работе с нейросетью, чем заучивание определения из учебника. Актуальность цифр по word2vec, BERT и text-embedding-3 сверяли 1 ноября 2026 года по первичным статьям и документации разработчиков. Если запомнить одну мысль, пусть это будет она: текст в модели всегда сначала становится числами, а уже потом — ответом или найденным абзацем.
Вопросы и ответы
Что такое эмбеддинг в нейросети?
Это числовое представление текста внутри сети: сначала токены превращаются в векторы, затем слои внимания и другие блоки уточняют смысл. Без этого шага матричные операции просто не к чему применить.
Что такое эмбеддинг слова?
В классическом word2vec у каждого слова один фиксированный вектор, общий для всех предложений. Он отражает статистику соседей в большом корпусе, но не различает омонимы.
Что такое эмбеддинг в нейронных сетях?
Тот же векторный язык, но уже внутри глубокой архитектуры: начальная таблица эмбеддингов плюс все последующие преобразования до выходного слоя. В BERT и похожих моделях итог зависит от контекста.
Что такое эмбеддинг в ИИ?
Бытовой синоним «векторного представления текста» в продуктах на базе машинного обучения: от поиска по документам до внутренних расчётов чата. Термин не привязан к одной компании.
Что такое эмбеддинг в контексте?
Представление токена с учётом окружающих слов. «Ключ» у двери и «ключевой» в «ключевой фактор» получают разные векторы, хотя буквы совпадают.
Чем эмбеддинг отличается от токена?
Токен — кусок текста в разборе. Эмбеддинг — список чисел, который модель сопоставляет этому токену (и контексту вокруг) для дальнейших вычислений.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
- Efficient Estimation of Word Representations in Vector Space (Mikolov et al., 2013)
- Linguistic Regularities in Continuous Space Word Representations (Mikolov, Yih, Zweig, NAACL 2013)
- BERT: Pre-training of Deep Bidirectional Transformers (Devlin et al., 2018)
- Attention Is All You Need (Vaswani et al., 2017)
- Vector embeddings — документация OpenAI
- New embedding models and API updates (OpenAI, 2024)
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.