
"ГигаЧат: что это за нейросеть Сбера"

Обозреватель: как устроен ИИ
Содержание
24 апреля 2023 года Сбер открыл чат GigaChat. Доступ был по приглашениям, а обещание звучало по-деловому: отвечать на вопросы, держать диалог, писать код, тексты и картинки в одном разговоре и говорить по-русски грамотнее, чем чужие чаты того года. С тех пор имя не сменилось, а внутри него сменилось уже несколько моделей. К ноябрю 2026 года под вывеской ГигаЧата живут и сайт для человека, и программный доступ с именами Lite, Pro, Max и Ultra, и отдельно выложенные веса GigaChat 3.5.
Откуда взялось имя
На старте Сбер описал устройство как ансамбль NeONKA. Расшифровка длинная: нейронная сеть, которая работает с несколькими видами данных и опирается на знания. В ансамбль входили разные модели, их доучивали на размеченных примерах и на отклике людей. Картинки рисовала отдельная модель Kandinsky 2.1. Текстовая ruGPT-3.5 на 13 миллиардов параметров, по словам банка в том же анонсе, должна была уйти в открытый доступ, чтобы лаборатории могли ставить опыты у себя.
Рядом с банком модели вели две его команды, SberDevices и Sber AI, и институт AIRI. То есть ГигаЧат с первого дня был витриной, за которой стоят несколько сетей. Это важно помнить, когда в поиске спрашивают «гигачат нейросеть» так, будто речь об одном номере версии.
Дальше имя осталось, а поколение сменилось. 13 марта 2025 года Сбер показал GigaChat 2.0 и разложил его на три ступени. Старшая MAX рассчитана на трудные задачи, Pro и Lite легче и быстрее. 14 апреля 2025 года этот ряд открыли без приглашений: на сайте, в боте Telegram и в мессенджере MAX. В чате для человека тогда назвали две ступени, Pro и Max. Lite в том сообщении для широкой аудитории не фигурировал, зато в программном доступе он есть до сих пор.
Что такое ГигаЧат, если коротко
Привычная аналогия — «это ChatGPT, только от Сбера и на русском». Она удобная и неверная. ChatGPT — закрытый продукт одной компании, и человек не скачивает его веса. ГигаЧат — сразу три разных вещи с одним товарным знаком.
Первая — чат для человека. Пишете по-русски, прикладываете файл или картинку, просите текст или рисунок. С 14 апреля 2025 года этот чат ещё и ходит в интернет и ставит ссылку на источник. Вторая — программный доступ для тех, кто встраивает модель в свою программу. Там модели вызывают по именам: GigaChat или GigaChat-2 для лёгкой, GigaChat-2-Pro, GigaChat-2-Max и, с 15 июля 2026 года, GigaChat-3-Ultra. Третья — файлы весов, которые Сбер выложил сам. Их можно забрать и запустить на своём сервере. К ноябрю 2026 года такой файл — GigaChat 3.5, лицензия MIT.
Одно имя закрывает и разговор, и вызов из программы, и скачиваемую модель. При этом окно, умения и даже число параметров у этих трёх входов не совпадают. Человек на сайте не выбирает «432 миллиарда». Разработчик в запросе указывает имя модели. Лаборатория, которая скачала веса, видит уже другую карточку, с другим окном.
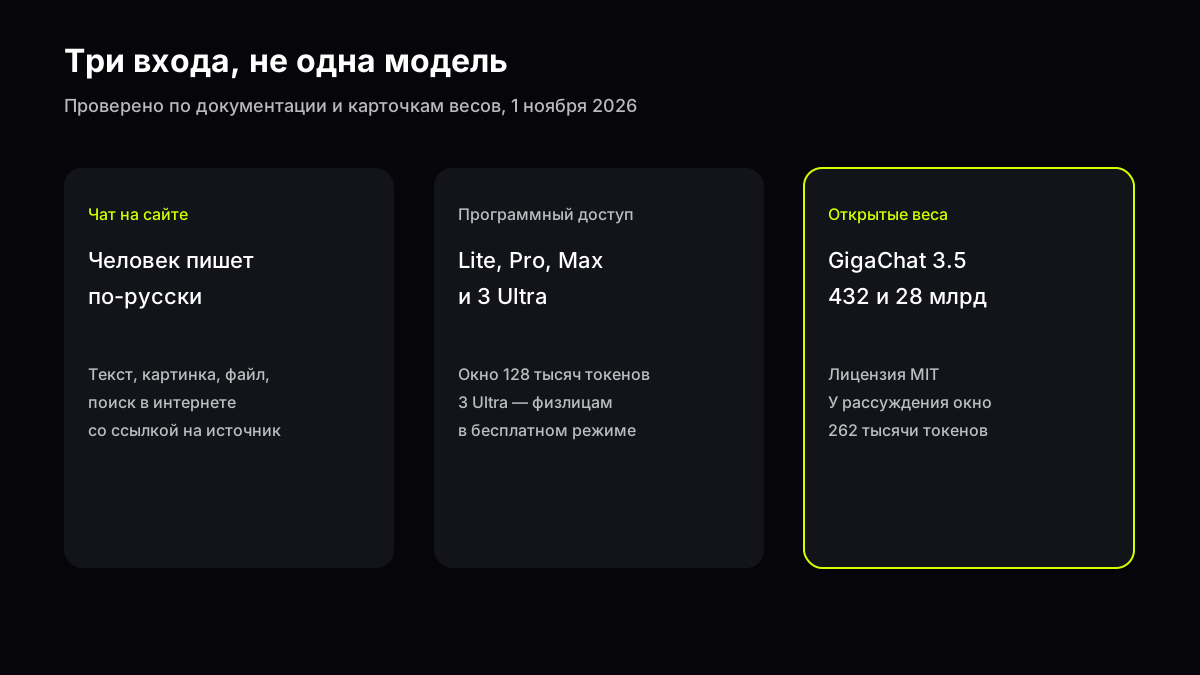
Схема трёх входов ГигаЧата, иллюстрация GPThub по документации Сбера и карточке весов, ноябрь 2026
Параметр — одно число внутри модели, которое подстроили при обучении. Токен — кусок текста, который модель обрабатывает за шаг. Окно контекста — сколько токенов она держит разом: вопрос, файл и уже написанный ответ.
Сбер — разработчик. Сбербанк в быту называют и сам банк, и всю группу. В пресс-релизах стоит Sber, сервис живёт на giga.chat, а документы для программистов — на сайте разработчиков Сбера. Запрос «гигачат от сбербанка нейросеть» и запрос «гигачат нейросеть от сбера» попадают в одну и ту же линейку. Отдельной «нейросети Сбербанка», которая была бы не ГигаЧатом, в этих документах нет.
Как устроена большая модель
GigaChat 3.5 Ultra, о котором команда написала 13 октября 2026 года, построен как смесь экспертов. Эту схему часто рисуют как совет специалистов, которые спорят и голосуют. Голосования нет. Эксперты не делятся на «физика» и «юриста». На каждый токен небольшая сеть-маршрутизатор включает только часть блоков. Остальные в этот момент молчат.
Поэтому размера два. Общий у 3.5 Ultra — 432 миллиарда параметров. Активный, то есть тот, что считает на один токен, — 28 миллиардов. Предыдущий флагман, GigaChat 3.1 Ultra, был на 700 миллиардов. Новая модель примерно на 40 процентов компактнее и, по таблице самих авторов на карточке весов, сильнее прежней в коде, математике и задачах, где модель должна сама вызывать инструменты. Хранить её всё ещё тяжело. Считать каждое следующее слово — уже легче, чем если бы работали все 432 миллиарда сразу.
Память длинного текста сидит в так называемом KV-кэше: модель помнит, с чем уже сверила каждое слово. Чем длиннее документ, тем больше этот кэш. В 3.5 его на один токен примерно в четыре раза меньше, чем было. В ту же память видеокарты влезает более чем вдвое больше контекста, а скорость выдачи текста выше примерно на 20 процентов. Это слова команды в блоге и те же цифры на карточке базовых весов.
Внимание сделали гибридным. Часть слоёв — обычное сжатое внимание MLA. Часть — линейное внимание GatedDeltaNet. Линейное внимание дешевле на длинном тексте, зато хуже держит мелкую связь между далёкими кусками. Гибрид оставляет точные слои там, где они нужны, и удешевляет остальные. Чтобы обучение на сотнях миллиардов не разваливалось, команда добавила стабилизирующие механизмы.
Ещё одна деталь — предсказание сразу нескольких будущих токенов. Для этого у модели есть дополнительные головы, и основной выигрыш, по словам команды, дают первые две. На жадном декодировании, когда модель каждый раз берёт самый вероятный следующий кусок, выдача ускоряется до 2,2 раза. Учили сеть в пониженной точности FP8 на всех этапах.
Корпус предобучения команда описала так. Около 52 процентов — веб, 16 процентов — код, 6 процентов — математика, 26 процентов — научные статьи и прочие отобранные источники. Кода по языкам было 16, стало больше 600. Сырой HTML прогоняли через разбор моделью, чтобы на выходе оставался чистый текст с формулами и таблицами, а не каша из тегов. На маленьких моделях синтетические тексты, которые сеть пишет себе сама, работали хорошо. На сотнях миллиардов команда увидела, что синтетика схлопывается в однообразие, и для основы взяла живые тексты. Синтетика осталась позже, ближе к концу обучения, и уже не «с нуля», а как достройка объяснения к вопросу из книги или статьи. Рядом с вопросом модели показывали исходный абзац. Так меньше выдумок.
Рассуждающую версию собрали иначе. Сначала обычное дообучение на примерах. Потом шесть отдельных специалистов, каждого учили с подкреплением на своём типе задач. Точные науки и олимпиады проверяют по конечному ответу. Код — запуском. Агент по репозиторию — тестами после правки. Общий агент — по тому, в каком состоянии осталась среда: вызвана ли функция, что записано в память. Диалог оценивает другая модель, пара ответов рядом. Мягкие навыки снова проверяют по конечному ответу. Задачи, которые текущая сборка решает больше чем в 75 процентах попыток, из набора убирают, иначе модель учится на лёгком. Потом шесть специалистов сводят в одну сеть: ученик пишет свой ход, а специалист нужной области подсказывает на уровне отдельных токенов.
Окно у этих весов — до 262 тысяч токенов. Это написано на карточке рассуждающей модели. У GigaChat 2 Max и у GigaChat 3 Ultra в документации программного доступа окно другое, 128 тысяч. Путать их нельзя. Скачанный файл и модель, которую вызывает сайт или программа по имени, живут по разным карточкам.
Что умеет ГигаЧат
На старте список был коротким: вопрос, диалог, код, текст, картинка. К апрелю 2025 года в чат для человека добавили разбор голосового файла, разбор изображения и поиск свежих сведений со ссылкой. Справка сервиса от 19 декабря 2025 года прямо пишет, что картинки в чате делает Kandinsky, и называет актуальной тогда версией Kandinsky 5.0. Вход на сайт — через Сбер ID. Идентификатор можно получить и без продуктов банка, так написано в той же справке.
В документации GigaChat 2 Max умения перечислены суше. На вход идут текст, изображение и аудио. На выход — текст и изображение. Отдельными пунктами стоят пакетная обработка, вызов функций, анализ аудио и картинок, генерация изображений и трёхмерных моделей и разбор текстовых документов. Звёздочка у картинок, трёхмерных моделей и документов означает, что это встроенные функции, а не «модель сама рисует каждым своим параметром».
GigaChat 3 Ultra в документации от 15 июля 2026 года умеет то же по списку: функции, картинки туда и обратно, аудио. Окно те же 128 тысяч токенов. Вызов сразу нескольких функций параллельно добавили 6 октября 2026 года и только для этой модели. Доступ к ней в документах ограничен. По странице от 17 июля 2026 года её открыли только частным лицам в пробном режиме, компаниям она пока не выдаётся. Имя в запросе — GigaChat-3-Ultra, адрес с 16 июля 2026 года общий: api.giga.chat.
Запрос «нейросеть текст гигачат» попадает в самую спокойную часть умений. Пересказ, письмо, правка формулировки, ответ по приложенному файлу. Здесь модель сильна ровно настолько, насколько текст уже лежит в окне. Запрос «gigachat что умеет» шире, и честный ответ длиннее одного абзаца. Умеет писать и править русский текст. Умеет смотреть картинку и слушать файл, если это позволяет выбранный вход. Умеет звать функцию, если её описали в программе. Умеет нарисовать, но рисует отдельная модель внутри сервиса. Не умеет заменить сверку с законом, с прайсом и с первоисточником. Даты и имена она говорит уверенно и в том числе тогда, когда ошибается.
Таблица метрик на странице GigaChat 2 — замер самого Сбера, не независимый экзамен. Доли записаны от нуля до единицы. На общих знаниях MMLU Lite заметно ниже старших, на русском ruMMLU разрыв того же порядка. Школьные текстовые задачи GSM8K все три закрывают уверенно, и здесь Pro чуть выше Max. Конкурсная математика MATH у Lite слабее, у Pro и Max она совпадает. Русская арена Arena-Hard без фильтра безопасности от лёгкой к старшей растёт сильно. В коде HumanEval снова впереди Pro, а не Max. На задачах MBPP Max всё же первый. Следование инструкции IFEval и на английском, и на русском лучше всего у Max. Русский столбец у Lite при этом ниже английского.
Из этой таблицы видно две бытовые вещи. Лёгкая модель заметно слабее на русском следовании инструкции и на арене. Старшая не выигрывает каждый столбец. Брать Max «на всякий случай» для короткой правки письма по этим цифрам незачем. Брать Lite для длинной инструкции на русском уже рискованно. Точные доли по каждому столбцу лежат в документации, в текст их имеет смысл тащить только вместе с именем теста и датой страницы.
У GigaChat 3 Ultra в документе от 24 июля 2026 года другая таблица, её нельзя класть в один ряд с предыдущей и говорить «стало лучше на столько-то». Другие тесты. MMLU-PRO и MATH 500 выглядят крепко для общей модели. IFBench, проверка жёстких инструкций, заметно скромнее. RuBQ, вопросы по-русски, высокие. Pollux у этой таблицы в другой шкале, не от нуля до единицы, и сравнивать его с долей бессмысленно. AIME 2026, олимпиадная математика, в этом замере закрывает меньше половины задач. Для домашнего примера по алгебре чата может хватить. Для олимпиады — нет, и документ этого не скрывает. Arena-Hard RU в той же строке есть, но это снова замер разработчика.
13 марта 2025 года Сбер написал, что по русскоязычному набору MERA модель GigaChat 2 MAX стоит на первом месте, а по ряду международных проверок обходит GPT-4o, DeepSeek-V3, Llama на 70 миллиардов и Qwen2.5. Там же сказано, что следование инструкции выросло вдвое, а ответы на вопросы — на 25 процентов, и что в запрос стало влезать почти 200 страниц A4 вместо прежних примерно 48 при кегле 14. Это пресс-релиз. Пока рядом нет протокола чужой лаборатории с той же датой и тем же списком задач, фразу стоит читать как заявление разработчика. Заявление полезное, потому что оно фиксирует скачок окна. Оно не заменяет таблицу, где у каждой строки написан чужой судья.
На карточке рассуждающих весов 3.5 авторы сравнивают свою инструкционную сборку, свою рассуждающую и предварительную рассуждающую DeepSeek V4 Flash. На олимпиадном AIME рассуждение поднимает результат сильно и встаёт рядом с этой сборкой DeepSeek, с небольшим перевесом в свою сторону. На IFBench, где смотрят жёсткие инструкции, скачок тоже большой, и здесь своя рассуждающая сборка впереди. На Live Code Bench сосед всё же выше, хотя и своя рассуждающая уходит далеко от инструкционной. На русской арене Arena Hard RU картина обратная: обе сборки ГигаЧата выше названного соседа. На четырёх математических наборах рассуждающая модель тратит примерно на треть меньше токенов рассуждения, чем DeepSeek V4 Flash Preview. Среднее по всей таблице у соседа всё же выше. Картина ровная. На русской арене и на части инструкций своя модель впереди. На коде и на нескольких научных наборах впереди сосед. Обе колонки посчитал автор карточки. Точные доли в статье не повторяю второй раз, они лежат в карточке весов.
Похожая развилка есть у открытых моделей вообще. В разборе DeepSeek быстрая модель почти догоняет старшую там, где условие уже в окне, и отстаёт на голых фактах. С ГигаЧатом логика та же, только ступени названы иначе.
Картинки, не текст
Запрос «гигачат нейросеть фото» и соседний про картинки ищут одно: можно ли описать кадр словами и получить изображение. Можно, и это отдельный контур. В апреле 2023 года его закрывал Kandinsky 2.1 внутри ансамбля. В справке декабря 2025 года картинки чата отнесены к Kandinsky 5.0. Документация 2 Max помечает генерацию изображений и трёхмерных моделей как встроенные функции. Языковая модель принимает русское описание и передаёт его дальше. Путать «ГигаЧат нарисовал» и «ГигаЧат сам является моделью картинок» не стоит.
Отсюда типичные разочарования. Просите фотографию конкретного человека или точный логотип — сервис либо откажется, либо соберёт похожую, но чужую вещь. Просите текст на плакате — буквы на картинке у генераторов вообще слабое место, и русский тут не исключение. Просите «как в жизни, только лучше» без света, материала и эпохи — получите гладкий рекламный кадр. Полезнее описать предмет, износ, откуда свет и чего в кадре быть не должно. Как вообще смотреть на результат картиночной модели, разобрано в гайде про работу с изображениями. Готовый набор запросов «скопируй и вставь» этой статье не нужен. Достаточно одного пробного описания и проверки, совпали ли число предметов, цвет и то, что вы запретили.
Трёхмерная модель в документации есть отдельной функцией у 2 Max. Это не «ожившее фото» и не ролик. Если нужен именно ролик из картинки, это другая задача и другие модели. Обзор того, как видео собирают из кадра, лежит в материале про нейросети для видео.
Русский язык и проверка ответа
Запросы «гигачат русскоязычная нейросеть», «гигачат русскоязычная нейросеть от сбера» и «гигачат нейросеть на русском» звучат так, будто есть отдельный переключатель языка. Переключателя нет. Русский был целью с первого анонса, и карточки весов 3.5 помечены как русские и английские, с пометкой о многоязычности. Насколько чат на сайте силён на других языках, по этим карточкам судить нельзя.
Русский в продукте виден по метрикам, которые Сбер вообще стал публиковать отдельно. ruMMLU, IFEval на русском, Arena-Hard RU, RuBQ. У лёгкой модели второй версии русский IFEval 0,73 при английском 0,80. Разрыв небольшой, но он есть, и на длинной инструкции с условиями «не используй канцелярит, держи пять абзацев, сохрани термины» лёгкая модель чаще теряет одно из условий.
Проверять ответ всё равно нужно, и русский тут не защищает. Модель дописывает правдоподобные реквизиты. Типичная ошибка на бытовом тексте выглядит так. Вы просите пересказ договора поставки на одну страницу. В пересказе появляется пеня, которой в файле не было, или срок «30 дней» вместо «10 рабочих». Гладкость фразы ничего не доказывает. Сверьте числа, даты, имена сторон и то, чего в исходнике нет. Если модель пошла в интернет и дала ссылку, откройте ссылку. Страница может быть про соседний сюжет.
Вторая ошибка — смешение входов. Человек проверил удачный ответ на сайте и решил, что программа, которая зовёт GigaChat-2, ответит так же. Имя GigaChat-2 в документации относится к лёгким моделям. Сайт в апреле 2025 года показывал людям Pro и Max. Третья ошибка — принять пресс-релиз за протокол. «Первое место на MERA» в марте 2025 года сказано Сбером. Пока вы не открыли таблицу MERA сами и не увидели дату прогона, это заявление, а не ваш результат.
Четвёртая — окно. «Почти 200 страниц» из релиза 2025 года — перевод в листы A4, не число токенов. В документации 2026 года у 2 Max и у 3 Ultra стоит 128 тысяч токенов. Страница канцелярского текста и тысяча токенов не равны друг другу. Длинный договор с таблицами съедает окно быстрее, чем кажется по числу листов. Если ответ оборвался на середине приложения, дело часто не в «глупой модели», а в том, что хвост файла в окно не вошёл.
Пятая — рассуждение. Рассуждающая сборка 3.5 пишет длинный черновик и только потом ответ. Черновик тоже занимает окно, до 262 тысяч токенов на карточке весов. На простом вопросе «поправь падеж» этот режим только замедляет. На олимпиадной задаче, судя по AIME в таблице авторов, он поднимает долю решённых сильно. Включать его имеет смысл там, где итог можно проверить: сошлось число, прошёл тест, сошлась цитата с файлом.
Если вы видите новость «ГигаЧат обошёл всех», полезно открыть, какую именно сборку сравнивали и кто считал. Инструкция и рассуждение на одной карточке расходятся на десятки пунктов. Чат на сайте и файл на Hugging Face — тоже не близнецы.
Рядом имеет смысл держать чужую открытую модель того же класса, чтобы спорное место прогнать вторым мнением. Как устроена такая модель у DeepSeek, уже разобрано отдельно, а выбрать, какой размер звать под задачу, помогает гайд как выбрать модель. DeepSeek V4 Flash уже доступен в чате GPThub. Для короткого русского черновика его окно и привычка опираться на приложенный файл закрывают ту же бытовую дыру, что и пересказ в ГигаЧате. Расхождение двух ответов — повод открыть источник, а не повод усреднить.
Что смотреть в ответе
Практическая проверка укладывается в несколько вопросов, без отдельной инструкции по кнопкам.
На тексте спросите себя, все ли числа из вашего файла доехали в ответ и не появилось ли нового числа. На инструкции из трёх условий выпишите условия на поля и отметьте, какое выполнено. На вопросе о факте без файла требуйте опору. Либо цитата из приложенного, либо живая ссылка, которую вы открыли. Фраза «по данным исследований» без названия исследования — пустая.
На картинке сверьте число объектов, материал и запрет. Если просили пустой стол и лампу слева, а в кадре человек и неон, запрос был слишком короткий либо модель картинок проигнорировала хвост. Повторять его пять раз подряд с теми же словами обычно бесполезно. Меняют одно условие.
На коде, если вы не программист, хотя бы запустите пример на данных, которые вы сами придумали, включая пустой ввод и очень длинную строку. HumanEval в таблице Сбера — это короткие функции с тестами, не ваш рабочий репозиторий. Процент 0,91 у Pro не обещает, что скрипт для выгрузки из вашей таблицы заведётся с первого раза.
На математике школьный уровень и олимпиада разведены самими таблицами. Школьные текстовые задачи вторая версия закрывает уже лёгкой ступенью. Олимпиадный AIME у GigaChat 3 Ultra в документации программного доступа — меньше половины, а у рассуждающих весов 3.5 в карточке авторов — почти весь набор, и там среднее по многим попыткам. Это разные модели и разный способ подсчёта. Домашнее уравнение можно отдать чату и проверить подстановкой. Задачу с олимпиады нельзя считать решённой, пока подстановка или чертёж не сошлись у вас в тетради.
Опечатка в запросе «гигачал нейросеть» попадается часто, второй гласный в названии а, не ал. Имя в латинице пишут GigaChat, без пробела. В разговоре нормальны и «ГигаЧат», и «гигачат». На поиск это не влияет. На вызов из программы влияет: имя модели в запросе чувствительно к регистру и к дефисам, как они записаны в документации.
Что будет дальше и что уже есть
Команда в октябрьском блоге пишет, что сырьё для предобучения пока берёт из Common Crawl и хочет качать сеть сама, плюс больше опытов на крупных промежуточных размерах и отдельный упор на математику и код. Это план, не вышедшая модель. Вышедшее на 1 ноября 2026 года такое. Чат для человека с текстом, файлами, картинками Kandinsky и поиском со ссылкой. Программный доступ с Lite, Pro, Max и с 3 Ultra для частных лиц, окно 128 тысяч токенов, параллельные функции только у Ultra. Открытые веса 3.5 Ultra и 3.5 Reasoning, 432 и 28 миллиардов, лицензия MIT, у рассуждения окно 262 тысячи токенов.
Если новость обещает «новую ГигаЧат» без номера, смотрите, про какой из трёх входов речь. Сайт, имя в программном запросе и файл весов обновляются не в один день. Пока номер не назван, сравнивать не с чем.
Вопросы и ответы
Что такое GigaChat?
GigaChat, по-русски ГигаЧат, — чат и семейство языковых моделей Сбера. Первый публичный показ прошёл 24 апреля 2023 года. К ноябрю 2026 года это и сайт для человека, и программный доступ нескольких моделей, и открытые веса поколения 3.5.
ГигаЧат — это нейросеть от Сбербанка?
Да, разработчик — Сбер. В пресс-релизах банка сервис так и представлен, с 2023 года. Отдельной другой нейросети «только Сбербанка», с другим именем и другими документами, в официальных материалах нет.
Что умеет ГигаЧат?
Пишет и правит текст, отвечает по файлу, разбирает изображение и аудио, вызывает описанные функции и рисует картинку через встроенную функцию. В чате для человека с апреля 2025 года есть поиск в интернете со ссылкой на источник. Старшие открытые веса ещё и ведут пошаговое рассуждение.
ГигаЧат — русскоязычная нейросеть?
Русский был заявлен с первого дня и остаётся основным языком карточек. Рядом стоит английский и пометка о многоязычности. Отдельной кнопки «только русский» в документации нет. На русских проверках лёгкая модель второй версии слабее старших.
ГигаЧат делает фото и картинки?
Да. В чате картинку по описанию рисует модель Kandinsky, в справке конца 2025 года указан Kandinsky 5.0. В программном доступе генерация изображений помечена как встроенная функция. Надписи на изображении и точные портреты реальных людей ждать не стоит.
Как правильно пишется, ГигаЧат или Гигачал?
ГигаЧат, во второй части слова буква а. В латинице — GigaChat. «Гигачал» — частая опечатка из поиска, отдельного продукта с таким именем у Сбера нет.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.