
"Нейросетевой перевод: чем модель отличается от словаря"
Обозреватель: как устроен ИИ
Содержание
27 сентября 2016 года исследователи Google Brain выложили отчёт о системе с длинным именем Google Neural Machine Translation и в тот же день включили её на живой паре китайский — английский. Около 18 миллионов таких переводов в сутки шло уже через новую модель, а не через прежний фразовый автомат. Двуязычные оценщики сверяли переводы предложений из Википедии и новостных сайтов. На нескольких крупных языковых парах число ошибок сократилось больше чем на 55–85%. Нейросетевой перевод с того дня перестал быть лабораторной статьёй. Словарь при этом никуда не делся: он по-прежнему лежит на столе у того, кто учит язык. Модель устроена иначе, и путаница между двумя способами как раз и портит курсовые, субтитры и любительские русификаторы.
Что стояло на месте словаря
Привычная картина такая. Открываешь двуязычный словарь, находишь слово, выписываешь перевод, переходишь к следующему. Для человека это черновик, для машины десятилетней давности это была почти вся работа, только словарь заменили таблицей, собранной с миллионов уже переведённых предложений.
Google в посте от 27 сентября 2016 года прямо противопоставляет новую систему своей прежней фразовой производственной системе. Фразовая схема переводила слова и короткие сочетания по отдельности, а потом склеивала. 29 ноября того же года, уже в Сеуле, Барак Туровский сказал журналистам Yonhap, что прежнюю систему приняли около десяти лет назад: она брала слова и фразы порознь, новая смотрит на предложение целиком. На короткой новости склейка часто выглядела приемлемо. На фразе с дальним согласованием она разваливалась: подлежащее уехало в конец, отрицание прилипло не к тому глаголу, имя собственное разбилось на обычные слова.
Логика в таком решении была простая. Параллельный корпус — это уже готовые пары «исходник и человеческий перевод». Посчитать, какие куски часто стоят напротив друг друга, дешевле, чем учить сеть на всём предложении. Ошибки тоже были местные: не нашлось редкое слово, и на его месте дыра или транслит. Читатель хотя бы видел, где машина спасовала.
Нейросеть эту дыру закрывает слишком уверенно. Пропуск она иногда заполняет правдоподобной выдумкой, и по гладкости фразы дыру уже не заметить. 17 ноября 2016 года ZDNET, пересказывая запуск, написал, что система всё ещё теряет слова и плохо берёт имена. Сокращение ошибок больше чем на 55–85% Google мерил на предложениях из Википедии и новостных сайтов.
Чем модель отличается от словаря
Словарь хранит соответствие. Спросил «стол» — получил строку. Спросил оборот, которого в книге нет, — не получил ничего. Модель соответствие в виде строки не хранит. Она хранит огромный набор чисел, подобранных на примерах, и по этим числам каждый раз заново вычисляет следующий кусок перевода.
Токен — кусок текста, который сеть берёт за один шаг. Это бывает целое короткое слово, бывает хвост длинного, бывает знак препинания. Окно — сколько таких кусков сеть видит одновременно, исходник и уже написанный перевод. Внимание — веса, которыми текущий шаг смотрит на разные места исходника: на подлежащее сильнее, на вводное слабее. Декодер — часть, которая выдаёт перевод по одному куску, и каждый новый кусок зависит от уже выданных. Как режется текст и где кончается окно, разобрано отдельно: токены и контекстное окно.
Кодер сжимает исходное предложение в набор внутренних состояний. Декодер разворачивает эти состояния в новую фразу, на каждом шаге заглядывая обратно в исходник через внимание. Дальше важнее то, чего в словаре нет вообще.
Во-первых, одного слова на входе может не быть. Редкое имя режется на куски, которые сеть уже видела в других именах, и на выходе собирается заново. Во-вторых, один и тот же кусок исходника в разных предложениях тянет перевод в разные стороны: «ключ» рядом с дверью и «ключ» рядом с нотами не обязаны получить одну строку. В-третьих, сеть может выдать слово, которого во входе не было, если по статистике обучения оно тут «полагается». Для связки это иногда удача. Для числа, даты и фамилии это брак.
Аналогия с переводчиком-человеком тоже хромает, хотя к ней тянет сразу. Человек держит в голове смысл и может остановиться, спросить, открыть справочник. Сеть на одном проходе смысла отдельно от текста не хранит. Она продолжает наиболее вероятную цепочку кусков. Если вероятная цепочка расходится с фактом, сеть об этом не сигналит, если её отдельно не попросили сомневаться.
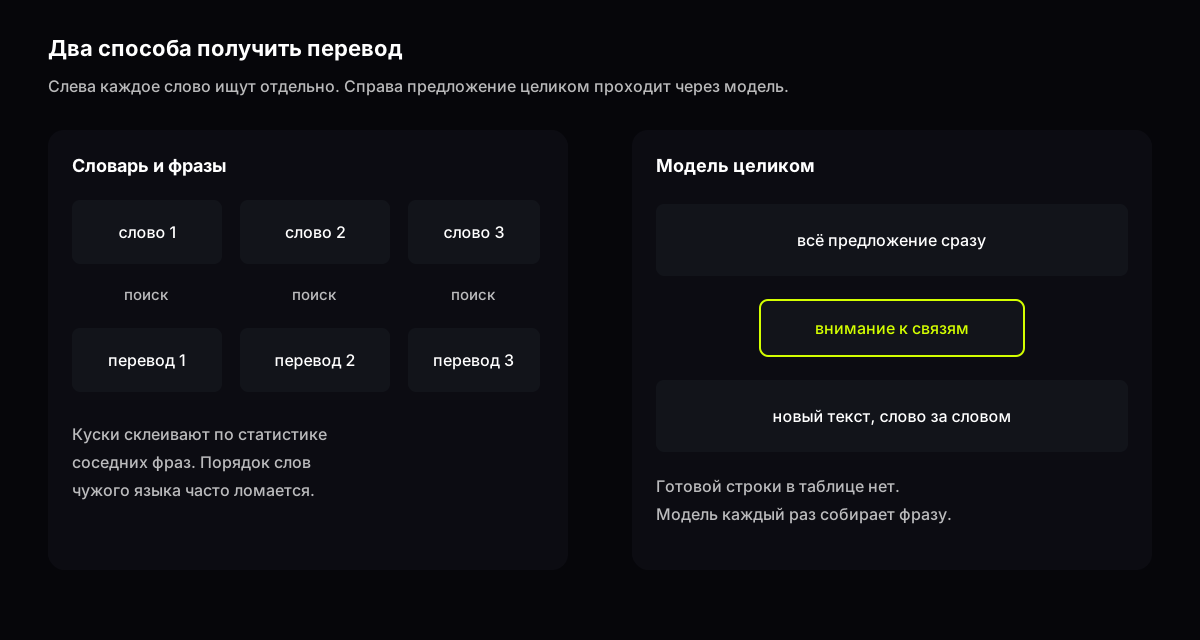
Схема редакции, по описанию GNMT в блоге Google Research, 27 сентября 2016
Поэтому студенческий приём «прогнать абзац и сдать» ломается на предсказуемых местах. Гладкий русский ещё не значит верный перевод. Словарь на тех же местах честнее: он молчит. Модель молчать не обучена.
Как предложение проходит сквозь сеть
Возьмём короткую английскую фразу про экзамен: студент перенёс срок, потому что библиотека закрылась раньше. Фразовый автомат мог перевести «раньше» к другому глаголу или выбросить причину, если кусок причины редко встречался в корпусе новостей. Нейросеть видит запятую, союз и оба глагола в одном окне.
Сначала текст режется на токены. Служебные слова часто остаются целыми. Длинное имя библиотеки разваливается на несколько кусков, и это нормально: так сеть переживает слова, которых не было в учебнике. Потом кодер строит для каждого куска состояние, и внимание связывает «раньше» с глаголом закрытия, а не с глаголом переноса. Декодер начинает русскую фразу. Первый кусок влияет на второй. Если первым вышло «из-за», дальше сеть уже склоняет причину, а не время.
На этом месте и сидит характерный сбой. Сеть может начать фразу так гладко, что обратный ход дорог: она уже выбрала падеж, и редкое имя втискивается в него криво. Правка одного слова в середине иногда дешевле, чем просить перевести абзац заново, но только если править по исходному тексту, а не по слуху.
Вторая характерная ошибка — покрытие. 17 ноября 2016 года в разборе ZDNET прямо сказано, что система теряет слова. Декодер любит короткую гладкую фразу и тихо выкидывает обстоятельство, если оно мешает ровному продолжению. Снаружи, в чате, этого механизма не видно. Его заменяет привычка читателя сверять длину и состав.
Третья ошибка — регистр. Учебный корпус машинного перевода десятилетиями собирали из новостей, протоколов и субтитров. Студенческое эссе, договор и реплика в игре устроены по-разному. Сеть, которую не попросили держать регистр, усредняет: канцелярит в бытовом диалоге, разговорный оборот в условии задачи. Для курсовой это уже содержательная порча, даже если все факты на месте.
Ещё один малоизвестный для широкого читателя факт — метрика, которой в 2017 году мерили скачок. BLEU считает пересечение кусков машинного перевода с человеческим эталоном, шкала у неё от нуля и выше, на практике смотрят на баллы вроде двадцати и сорока. Долей смысла эта цифра не меряет. Два верных перевода одного абзаца могут разойтись в словах и получить разный BLEU. Метрика годится, чтобы сравнить две системы на одном и том же тесте. Она плохо годится, чтобы поставить оценку одному абзацу в курсовой.
Что сделал трансформер в июне 2017 года
До трансформера сильные нейросетевые переводчики были рекуррентными: они шли по предложению слева направо, и длинная фраза затирала начало. Внимание уже прикручивали сверху, чтобы декодер мог заглянуть назад. 12 июня 2017 года группа из восьми авторов, среди них Васвани, Шейзир, Пармар, Кайзер, выложила статью, где рекуррентность убрали совсем. Осталось внимание: каждый кусок смотрит на остальные напрямую.
На тесте WMT 2014 английский в немецкий их одна модель взяла 28,4 BLEU и обошла прежний лучший результат, включая ансамбли из нескольких моделей, больше чем на 2 балла. Английский во французский — 41,8 BLEU. Обучение заняло 3,5 дня на восьми графических процессорах. Статья подаёт срок как практический смысл архитектуры: рекуррентность убрали, учить можно параллельно, один прогон уложился в три с половиной дня.
Для читателя важнее следствие, чем строка в таблице. Когда каждый кусок видит всё предложение сразу, сеть лучше держит согласование на длинной дистанции: кто кому что обещал в третьем придаточном. Параллельно учить такую сеть проще, чем рекуррентную, поэтому следующие годы масштаб вырос быстро. Тот же механизм потом уехал из чистого перевода в обычные чат-модели. Сама архитектура разобрана отдельно: что такое трансформер. Разбор одной открытой модели, которая на этом механизме говорит с человеком, лежит рядом: DeepSeek и чем она отличается от обычного чата.
Перевод от этого не стал словарём нового вида. Он стал генерацией, которую обучили на парах языков сильнее, чем на прочих задачах. Чат, который умеет и код, и пересказ, переводит тем же следующим куском. Отдельного ящика «только словарь» внутри него нет. Если попросить его перевести, он продолжит текст в сторону перевода. Если попросить свободнее, он начнёт объяснять, сокращать и добавлять от себя. Для контрольной это разные режимы, и их стоит называть в запросе прямо.
Одна модель на много языков
Ранний GNMT включали парами. 15 ноября 2016 года Барак Туровский, руководитель продукта Google Translate, написал в блоге компании, что нейросетевой режим включили для восьми пар в и из английского: французский, немецкий, испанский, португальский, китайский, японский, корейский, турецкий. Вместе они закрывали больше 35% запросов Google Translate. Довести систему планировали до всех 103 языков сервиса. Скачок он назвал большим, чем за предыдущие десять лет вместе взятые. Это оценка продукта, не лабораторный балл, и её имеет смысл читать вместе с оговоркой ZDNET от 17 ноября: имена и потерянные слова никуда не делись.
Дальше лаборатории стали учить одну сеть сразу на многих парах. Выгода понятная. Редкий язык почти не имеет своих параллельных текстов с русским, зато имеет хоть что-то с английским. Общая сеть переносит приёмы с богатой пары на бедную. 6 июля 2022 года Meta опубликовала NLLB-200: одна модель на 200 языков. На карточке проекта прирост к прежнему лучшему результату указан как 44% BLEU. Технический пост относит сравнение в 44% к набору Flores-101 (10 тысяч направлений), а для части африканских и индийских языков заявляет прирост больше 70%. Более широкий набор Flores-200 смотрит 40 тысяч направлений. Учебных пар у проекта набралось 18 миллиардов, в два с половиной раза больше, чем у предыдущей модели M2M-100. Модели, код обучения и сам набор открыли.
Цифры эти — про их тест и их предыдущее состояние дел, не про то, что любой абзац на языке с малым корпусом теперь переводится как газетный английский. Для студента вывод практический. Пара русский — английский набита примерами десятилетиями, и гладкость там обманчиво высокая. Пара с языком, которого в корпусе мало, чаще теряет оттенки и выдумывает канцелярит. Просить сеть «переведи как носитель» эту дыру не закрывает. Закрывает сверка с человеком, который язык знает, или хотя бы обратный перевод на исходный язык вторым проходом.
Обратный проход устроен так. Берёте машинный перевод и просите перевести его назад, не показывая исходник. Расхождения — список мест, где сеть что-то потеряла или дописала. Совпадения ничего не гарантируют: сеть может устойчиво ошибаться в обе стороны. Приём дешёвый и хорошо ловит выкинутые отрицания.
Нейросетевой перевод игр
Релиз был назначен на 3 сентября 2026 года, студия Rebel Wolves, издатель Bandai Namco. За день до этой даты креативный директор Матеуш Томашкевич ответил на вопрос о языках: добавлять что-то сверх уже указанного списка студия не планирует. Playground в тот же день написал, что в релизной версии будет 13 языков текста и субтитров и 6 языков полного дубляжа. Среди названных английский, польский, французский, немецкий, испанский, чешский, венгерский, корейский и китайский. Русского среди них нет, хотя игру в России продают, а описание страницы магазина по-русски существует.
В день релиза, 3 сентября, iXBT писал уже о двух любительских русификаторах, авторы под никами clarkkent и wolvovic. Издание прямо говорит, что перевод делали современными средствами ИИ и что до человеческой локализации этим текстам далеко. Язык в таких модах выбирается в настройках игры. Так осенью 2026 года и выглядит перевод игры, который ищут в поиске. Студия этого не обещала. Это пачка строк, прогнанная моделью и упакованная энтузиастом.
Игра для сети труднее абзаца из учебника, и причины технические.
- Строка интерфейса короткая, контекста почти нет, и «save» может стать и сохранением, и спасением.
- У реплики есть потолок знаков. Кнопки и субтитры короткие, а сеть любит развернуть вежливую фразу.
- Имена, фракции и выдуманные термины не лежат в новостном корпусе. Сеть либо транслитерирует их по-разному в разных главах, либо «переводит» как обычные слова.
- Пол и число в русском должны согласоваться с тем, кто говорит. В английском исходнике подсказки часто нет.
- Шутка и отсылка живут звучанием. Пословный смысл, даже верный, убивает каламбур, и сеть об этом не предупреждает.
Отсюда типичный след машинного русификатора. Имена пляшут. Квестовый предмет в журнале называется не так, как в диалоге. Вежливая формула занимает две строки там, где в английской версии было одно короткое слово. Сюжет при этом читается, и именно поэтому мод расходится быстрее официального отказа студии. Для учёбы это хороший стенд. Видно, где модель сильна (связный абзац описания) и где она слепа (системная строка без контекста).
Если разбираете такой текст на семинаре, полезно взять десять строк подряд и отметить четыре колонки: имя, число, отрицание, лимит длины. Десять строк уже показывают, случайная ли ошибка или системная. Жалоба «нейросеть плохо перевела игру» без этих колонок не отличит слабую модель от спешки сборщика мода.
Как устроен дубляж ролика
Видео добавляет к тексту время. 10 декабря 2024 года YouTube включил автодубляж шире, чем в закрытых пробах: английский ролик получал дорожки на французском, немецком, хинди, индонезийском, итальянском, японском, португальском и испанском, а ролик на этих языках — английскую дорожку. На старте это касалось сотен тысяч каналов партнёрской программы с познавательным и информационным видео. Компания сразу писала, что перевод бывает неточным, а голос не всегда похож на автора, и что над качеством они работают вместе с Google DeepMind и Google Translate. Отдельной обещанной надстройкой был Expressive Speech: тон, эмоция и даже фон помещения.
4 февраля 2026 года продуктовый менеджер YouTube Чандралекха Мотати описала следующий шаг. Автодубляж открыли всем, языков в библиотеке стало 27. По формулировке поста, в декабре в среднем больше 6 миллионов зрителей в день смотрели не меньше десяти минут такого звука. Expressive Speech к этой дате работал на всех каналах для восьми языков: английский, французский, немецкий, хинди, индонезийский, итальянский, португальский, испанский. Зрителю добавили настройку предпочитаемого языка, чтобы ролик не переключался сам.
Устройство здесь двойное. Сначала речь распознают в текст, потом текст переводят, потом новый текст озвучивают. Ломается любой из трёх слоёв. Ошибка распознавания имени уже не лечится хорошим переводчиком. Ошибка перевода укладывается в чужой тайминг и звучит уверенно, потому что голос ровный. Ошибка озвучки сохраняет слова и теряет ударение, и термин становится неузнаваемым.
Для студента, который смотрит лекцию на чужом языке, правило то же, что у абзаца. Автодубляж годится, чтобы понять ход мысли. Он не годится, чтобы выписать формулу, фамилию или число в конспект без сверки с оригинальной дорожкой. Подпись «автодубляж» в описании ролика как раз про это предупреждает. Как устроена картинка и движение в ролике, который сеть собирает с нуля, разобрано в другом тексте: как нейросеть делает видео. Дубляж чужой лекции — соседняя задача. Там исходник уже снят человеком, сеть меняет только язык звука.
Субтитры прощают больше, чем дубляж. Их можно остановить и сверить. Дубляж занимает уши целиком, и выдуманное обстоятельство проходит незамеченным. Если готовитесь к семинару по иностранной лекции, держите открытыми и субтитры исходного языка, и перевод, а звук перевода считайте подсказкой, не источником цитаты.
Как проверить перевод на учебном тексте
Практическая часть короткая, потому что механизм уже описан. Нужен абзац, который вы способны частично проверить: страница учебника, условие задачи, аннотация статьи. Свободное эссе без ключа проверяется только обратным проходом, и это слабее.
Запрос к чат-модели лучше держать узким. Подойдёт такая формулировка, её можно вставить почти дословно.
«Переведи на русский дословно по составу. Не добавляй пояснений. Имена, числа и отрицания сохрани. Если в исходнике неоднозначность, оставь оба варианта в квадратных скобках, не выбирай сам.»
Второй запрос, отдельным сообщением, про регистр.
«Тот же абзац переведи как речь преподавателя на семинаре, без канцелярита. Смысл и числа не меняй. В конце списком выпиши места, где пришлось выбрать между двумя русскими словами.»
Что смотреть в ответе, по пунктам.
- Все числа, единицы и даты на месте и не «округлились».
- Отрицание не переехало к соседнему глаголу.
- Имя человека и название института написаны одинаково по всему абзацу.
- В квадратных скобках действительно развилка, а не пустая отписка.
- Второй вариант не стал короче первого за счёт выброшенного придаточного.
Типичные сбои, которые на этих пунктах вылезают сразу. Сеть раскрывает аббревиатуру по догадке и один раз из двух раскрывает не ту. Она заменяет «не менее» на «около». Она переводит фамилию как нарицательное, если фамилия совпала с обычным словом. Она в научном абзаце ставит разговорное «кучу» вместо сохранённого количества. Она в условии задачи добавляет шаг решения, хотя просили только перевод.
Отдельный проход имеет смысл для терминов. Сначала просите список терминов исходника с переводом и пометкой «термин устоялся / перевод по смыслу». Потом просите перевод абзаца, где эти термины уже зафиксированы. Без списка сеть качает термин от предложения к предложению, и конспект расползается. Это та же болезнь, что у квестового предмета в игре.
Если абзац длинный, режьте его сами, по смыслу, а не просите «сократи и переведи». Сокращение — вторая задача. Она выкидывает как раз те придаточные, которые штраф покрытия в старых переводческих системах пытался сохранить. Для конспекта сокращение полезно. Для цитаты в работе оно уже искажение, и преподаватель ловит его сверкой с источником.
Выбор модели на эту работу почти не меняет чеклист. Меняется гладкость и то, насколько охотно сеть лезет объяснять. Как сравнивать модели на одном и том же абзаце, не смешивая задачи, разобрано в гайде как выбрать модель. Коротко о форме самого запроса — в гайде как писать запросы. Для черновика берут модель, которая уже доступна в чате GPThub: DeepSeek V4 Flash или Gemini 3.8 Flash. Вставили абзац, получили текст, прошлись по пяти пунктам. Второй диалог с обратным переводом ловит то, что глаз на гладком русском пропустил. Где черновик кончается и начинается ответственность живого переводчика, разобрано отдельно: нейросеть для переводчика.
Увы, ни один из пунктов не заменяет человека, который отвечает за текст. Курсовая, медицинская памятка, договор и субтитры к чужому фильму расходятся по цене ошибки. Сеть не знает, какой из текстов вы ей принесли, пока вы этого не сказали, и даже после этого она не несёт ответственности за строку. Для учебного черновика этого достаточно. Для строки, под которой стоит ваша фамилия, черновик всё равно читает человек.
Дальше смотреть имеет смысл на те же пять пунктов на вашем абзаце. Новые обещания «почти как носитель» тут слабее старой оговорки. Обещания в сентябре 2016 года уже звучали сильно, и измеренный скачок был настоящим. Имена и потерянные слова никуда не делись ни к восьми языкам ноября 2016-го, ни к двумстам языкам 2022-го, ни к автодубляжу 2026-го. Словарь этих ошибок не делает. Он просто оставляет пустое место, и пустое место честнее гладкой выдумки.
Вопросы и ответы
Как работает машинный перевод?
Сегодня машинный перевод устроен как сеть. Она режет фразу на куски, строит для них внутренние состояния и заново собирает фразу на другом языке, подглядывая в исходник через внимание. Старый способ, фразовый, искал готовые соответствия кускам и склеивал их. Google переключил массовый продукт с фразового способа на сеть осенью 2016 года, начав с пары китайский — английский.
Как нейросеть переводит текст?
Она не открывает словарь. Следующий кусок перевода выбирается как продолжение уже написанного, с оглядкой на весь исходник в окне. Поэтому редкое слово может собраться из знакомых кусков, а может и подмениться правдоподобным соседним по смыслу. Проверка — сверка чисел, имён, отрицаний и того, не стало ли предложение короче исходника.
Что такое нейросетевые переводы The Blood of Dawnwalker?
Официального русского языка у игры на релизе 3 сентября 2026 года не было: креативный директор Rebel Wolves сказал, что языки сверх заявленного списка добавлять не планируют. В день релиза отраслевые новости уже писали о любительских русификаторах и прямо указали, что строки переводили средствами ИИ. К студии эти тексты отношения не имеют. До вычитанного литературного перевода им далеко.
Чем нейросетевой перевод игр отличается от перевода абзаца?
В игре мало контекста у короткой кнопки, есть жёсткий лимит знаков, повторяющиеся имена и русский род, которого в английском исходнике часто нет. Абзац описания локации сеть обычно держит лучше, чем системную строку. Пляшущие имена одного предмета в журнале и в диалоге — типичный след такого прогона.
Как устроен нейросетевой перевод видео?
Ролик распознают в текст, текст переводят, перевод озвучивают заново. YouTube с декабря 2024 года делает это автодубляжем, а к февралю 2026 года писал уже о 27 языках и о более естественной речи на восьми из них. Ошибка любого из трёх слоёв звучит уверенно. Для конспекта лекции дорожку стоит сверять с исходными субтитрами, а числа и фамилии с неё не списывать.
Вышли ли нейросетевые переводы The Blood of Dawnwalker от разработчиков?
Нет. Студия и издатель накануне релиза подтвердили список языков без русского. Нейросетевые тексты, которые ищут по этому запросу, собрали энтузиасты сразу после 3 сентября 2026 года. Гладкий русский в таком моде не означает, что квесты и имена вычитаны.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
- Google Research, GNMT, 27 сентября 2016
- Блог Google Translate, восемь языков, 15 ноября 2016
- ZDNET о потерянных словах и именах, 17 ноября 2016
- Yonhap, заявление в Сеуле, 29 ноября 2016
- Attention Is All You Need, arXiv:1706.03762
- Meta, новость об NLLB-200, 6 июля 2022
- Meta AI, разбор NLLB-200
- Карточка NLLB: 18 миллиардов пар и 44% BLEU
- YouTube, автодубляж, 10 декабря 2024
- YouTube, 27 языков и Expressive Speech, 4 февраля 2026
- Playground.ru о языках Dawnwalker, 2 сентября 2026
- iXBT.games, цитата Томашкевича, 2 сентября 2026
- iXBT.games о любительских русификаторах, 3 сентября 2026
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Перевести абзац в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.