
Что такое токен в нейросети и почему она «забывает»

Обозреватель: как устроен ИИ
Содержание
6 июля 2023 года Нельсон Лю из Стэнфорда с соавторами сдал в архив препринтов статью с бытовым названием. Моделям уже разрешали скармливать длинные тексты, а проверка показала другое. Нужный абзац, поставленный в середину, модели находили хуже, чем тот же абзац в начале или в конце. К ноябрю 2026 окна выросли до сотен тысяч и до миллиона кусков, а привычка «забывать» середину никуда не делась. Прежде чем мерить окна, стоит понять, чем вообще меряют. Как устроена сама большая языковая модель, разобрано отдельно, здесь речь о её мерке. Что такое токен в нейросети, видно не по словарю, а по тому, как текст режут до первого шага счёта.
Что такое токен в нейросети
Справочники обычно начинают с мирного сравнения: токен — это примерно слово. У OpenAI для английского текста даже есть линейка, один токен около четырёх знаков или около трёх четвертей слова, а сто токенов — около семидесяти пяти слов. Линейка честная ровно там, где её нарисовали. Справка тут же оговаривается, что это оценка, не счёт, и что в других языках связь букв, слов и токенов другая.
Чем аналогия со словом врёт, видно на первом же шаге: модель не листает словарь целиком, перед счётом текст проходит через нарезчик, и тот отдаёт цепочку номеров. Номер может прийтись на целое короткое слово, на хвост длинного, на знак препинания или на пробел вместе со следующим словом. OpenAI приводит простой пример: написания red, Red и то же слово с пробелом впереди — разный текст, и кодировка имеет право нарезать их по-разному. Номер из одного нарезчика нельзя переносить на другой, у каждой семьи моделей свой. Номер ещё ничего не значит сам по себе: смысл куску модель придаёт уже потом, превращая номер в вектор, об этом подробно в статье про эмбеддинг.
Отсюда следствие: два абзаца одной длины в словах могут стоить модели разное число шагов. Код, адреса, таблицы и обрывки журналов режутся гуще обычной прозы. Справка OpenAI отдельно говорит, что подсчёт голого абзаца не равен целому запросу. К тексту добавляются роли сообщений, описания инструментов, схемы, картинки и файлы. Кто прикинул «тут страниц на десять, влезет», считает не то.
Есть и второй счёт, его путают с первым. Входные токены — всё, что ушло в запрос, выходные — всё, что модель породила. У моделей, которые сначала думают, а потом пишут, есть ещё токены обдумывания: на экране их нет, в расходе выхода они есть. Короткий ответ на трудный вопрос поэтому бывает толще длинного ответа на простой, и видимая строка тут плохая линейка.
Откуда взялась нарезка на куски
Чтобы понять, зачем резать слово, надо отступить на десять лет. В августе 2015 года Рико Зеннрих, Барри Хаддоу и Александра Бёрч сдали работу про перевод редких слов. Нейросетевой переводчик тогда жил с фиксированным словарём. Слово, которого в словаре не было, приходилось подменять по отдельному списку. Авторы предложили другое: редкое слово кодируется цепочкой подслов. Имя можно переложить по кускам, сложное немецкое слово разобрать на части, заимствование узнать по знакомому корню.
Среди способов нарезки они взяли старый приём сжатия: частые пары знаков снова и снова склеиваются в один новый знак, пока не наберётся словарь нужного размера. В статье это названо попарным кодированием байтов. На задачах WMT 2015 такая нарезка обошла словарь-запасной вариант. Прибавка составила 1,1 балла BLEU на паре английский-немецкий и 1,3 балла на паре английский-русский. BLEU — автоматическая оценка близости перевода к человеческому, не школьная отметка.
Антология ACL в 2026 году отметила эту работу премией Test of Time и прямо написала, чем она стала. Попарное кодирование байтов теперь стоит нарезчиком по умолчанию у большинства больших языковых моделей. Из этого следует бытовая вещь: «слово» для модели — случайный гость. Кусок, который часто встречался при обучении нарезчика, получает свой номер, а редкий кусок собирается из нескольких номеров. Русское слово с приставкой, корнем и двумя суффиксами редко бывает одним номером.
В июне 2017 года Ашиш Васвани и семь соавторов предложили архитектуру, которую с тех пор и называют трансформером. До них сильные переводчики были рекуррентными или свёрточными сетями, а внимание использовали как добавку. Новая схема оставила только внимание: каждый кусок текста сверяется с другими кусками того же текста, и по этой сверке решается, что учесть сильнее. На переводе WMT 2014 модель набрала 28,4 BLEU с английского на немецкий и 41,8 BLEU с английского на французский. Вторую цифру получили за 3,5 суток на восьми видеокартах.
Для окна контекста из той статьи важен способ чтения, рекорд перевода здесь побочный. Модель не бежит по тексту слева направо, запоминая «настроение» в одной ячейке: она держит перед собой всю поданную цепочку и смотрит по ней связями. Цепочка и есть окно, и чем она длиннее, тем больше сверок. Разработчики следующие годы как раз и учились делать эти сверки дешевле. У DeepSeek поколения V4 на миллионе токенов старшая модель тратит 27 процентов вычислений на один токен и 10 процентов памяти промежуточной сверки от того, что тратила предыдущая V3.2. Миллион стал обычным окном не потому, что сверка вдруг стала бесплатной: её ужали.
Что такое контекстное окно
Окно контекста — сколько токенов модель согласна учесть за один ответ. Токен — один шаг этой мерки, его мы уже разобрали. Лимит ответа — отдельное число. Оно говорит, сколько новых токенов модели позволено дописать, и это число сидит внутри окна, а не рядом с ним.
Страница Anthropic формулирует жёстче, чем реклама «безлимитной памяти». Окно — рабочая память на текущий запрос. Корпус, на котором модель учили годами, сюда не входит. Туда входит другое: системная инструкция, все реплики диалога, результаты инструментов, картинки, документы, описания инструментов и новый ответ, вместе с обдумыванием, если оно есть. Кэш, который удешевляет повтор уже виденного куска, место в окне не освобождает: платят меньше, полоса занята так же.
Отсюда картинка, которая обычно всплывает первой, и она тоже врёт: кажется, что чат — тетрадь и модель помнит, что вы писали в сентябре, пока вы сами переписку не сотрёте. На деле каждый новый ход заново кладёт в модель пачку текста. Пока пачка короче окна, в неё входят и старые ходы. Когда пачка длиннее, продукт обязан что-то выкинуть или пересказать. Anthropic прямо описывает два разных поведения. В программном интерфейсе ранние реплики копятся целиком, пока не упрутся в потолок. В чате на сайте куски могут уходить по правилу «первым вошёл — первым вышел». Серверное сжатие, у них это отдельный режим для моделей линейки 4.6 и новее, само пересказывает начало, чтобы разговор продолжался за потолком.
Google на своей странице про длинный контекст пользуется той же бытовой меркой: окно похоже на кратковременную память, и места мало, даже когда «мало» означает миллион кусков. Ранние порождающие модели брали 8 000 токенов за раз, затем 32 000 и 128 000, а миллион Google считает своей первой планкой такого размера. В быту миллион английских токенов они прикидывают как 50 000 строк кода по 80 знаков, восемь романов средней длины, расшифровки более чем двухсот подкастов или все текстовые сообщения за пять лет. Прикидка снова английская, и русский конспект той же книги займёт другую долю окна.
Внутри одного окна у семейств разная арифметика. У GPT-6 Astra в карточке OpenAI окно 1 050 000 токенов, на вход из них не больше 922 000, на выход не больше 128 000. У ряда моделей Claude окно 1 000 000, и один запрос может дописать до 128 000 токенов ответа. У Gemini 4 Argon окно 1 048 576 общее. Вход, обдумывание и ответ делят одну сумму. Если вход плюс заявленный потолок ответа эту сумму превышает, интерфейс сам урезает потолок до остатка. У более ранних Gemini 3 и Gemini 2.5 бюджеты были раздельными: миллион на вход и 64 тысячи на выход.
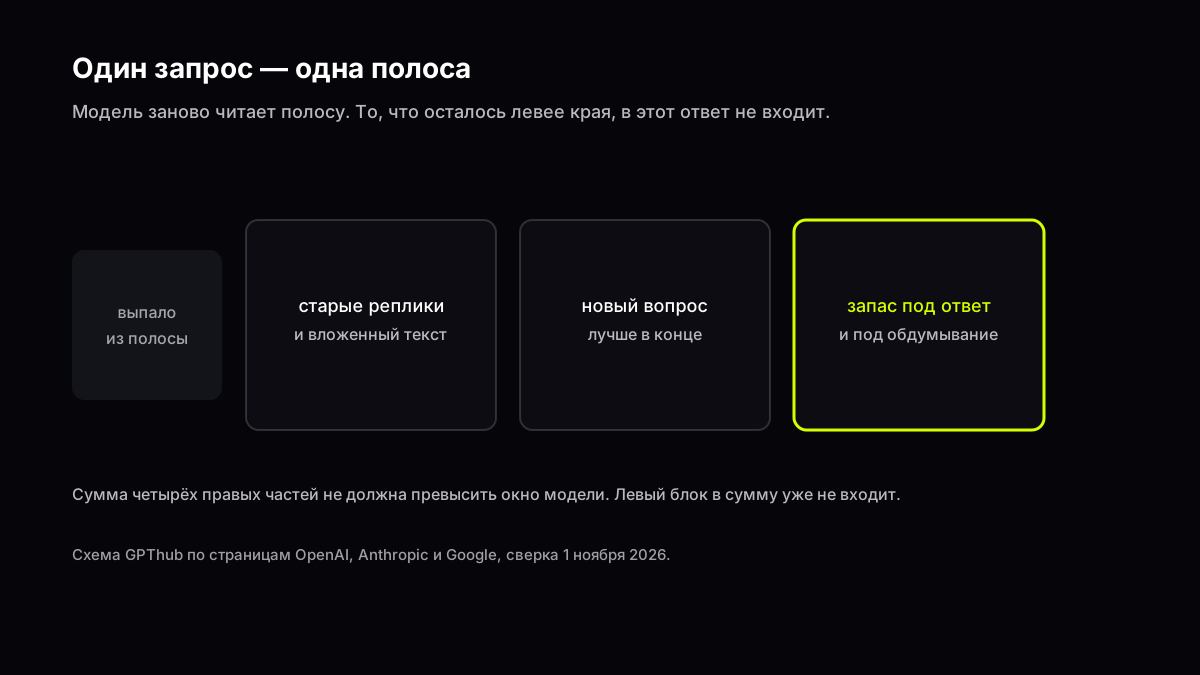
Источник: страницы OpenAI, Anthropic и Google, сверка 1 ноября 2026
Полоса на схеме и есть весь разговор с точки зрения модели: левый серый блок уже не читается, дальше старые реплики и вложение, потом новый вопрос, потом запас. Запас нужен не только под буквы, которые вы увидите. OpenAI пишет, что у рассуждающих моделей место в выходе уходит и на скрытые шаги, и Anthropic пишет то же про блоки обдумывания. У части новых Claude эти блоки остаются в следующих ходах и снова едят вход. У более ранних интерфейс сам их снимает, когда диалог присылают обратно. Две модели с одинаковой вывеской «миллион» оставляют под ваши слова разное место.
Если вход один, без ответа, уже длиннее окна, Claude отвечает ошибкой, и текст ошибки на странице — запрос слишком длинный, код 400. На моделях Claude 4.5 и новее запрос могут принять, даже если вход вместе с заявленным потолком ответа не влезает, и генерация тогда обрывается особой остановкой: окно модели исчерпано. Для человека в чате это выглядит как ответ, который оборвался на полуслове. Модель не «устала», ей просто не оставили клеток в полосе.
Почему середина пропадает
Заголовочный вопрос — почему нейросеть «забывает» — решается не багом памяти. Забывать в бытовом смысле ей нечего: полки, куда складываются вчерашние сообщения, у неё нет, есть только полоса текущего запроса. Что в полосу не попало, того в этом ответе нет, а что попало, ещё не значит, что модель одинаково опирается на каждый абзац.
Именно это мерили Лю, Линь, Хьюитт и соавторы. Работа сдана 6 июля 2023 года, 20 ноября вышла правка, журнал TACL её принял в том же году. Задач было две: вопросы по стопке документов и поиск нужного значения по ключу, а меняли только место нужного куска. Качество было выше, когда кусок стоял в начале или в конце, и заметно ниже, когда он стоял в середине. Модели, которые разработчики уже называли длинноконтекстными, проваливались так же, и кривая получалась седлом: края держатся, середина проседает.
Google в октябре 2026 года пишет о том же другими словами, уже как инструкцию разработчику. На длинном контексте вопрос лучше ставить в конец, после всего материала. Одна «иголка» в стоге на их проверках находится очень часто, страница говорит о точности до 99 процентов во многих таких случаях. Несколько разных сведений в одном длинном тексте находятся уже хуже, и разброс большой. Лишние токены, пишет та же страница, лучше не посылать вовсе. Длиннее запрос — как правило, дольше ждать первой буквы ответа.
Anthropic называет падение точности и припоминания по мере роста числа токенов отдельным словом. В документации это context rot, по-русски здесь достаточно «порча контекста», и смысл практический: окно в миллион токенов не обещает, что миллионный по счёту факт будет учтён так же, как факт из последнего абзаца. Курировать, что класть в полосу, страница считает не менее важным, чем размер самой полосы.
Есть и третий механизм, его легко принять за забывчивость модели, хотя режет продукт. Когда диалог подходит к потолку, чат может выкинуть ранние реплики или заменить их коротким пересказом, и пересказ пишет тоже модель. Она обязана что-то опустить: номер задачи, оговорку преподавателя, имя файла. На следующем ходу в полосе лежит уже пересказ, а не исходные слова, и модель честно отвечает по тому, что ей дали. Человеку кажется, что она «забыла вчерашнее», хотя вчерашнего в запросе больше нет.
Скрытое обдумывание добавляет ещё одну утечку: ответ на экране короткий, а клетки окна уже заняты шагами, которых вы не видели. Следующая реплика стартует с меньшей свободной полосы, чем кажется по истории чата. У тех Claude, которые оставляют старые блоки обдумывания в диалоге, утечка копится от хода к ходу. У тех, которые блоки снимают, место возвращается, зато модель не опирается на собственный прошлый ход мысли, только на видимый текст.
Сколько токенов держат модели к ноябрю 2026 года
Одного числа «сколько токенов у чата» не существует, потому что окно записано у модели, и даже у одной модели вход, выход и обдумывание делят его по-разному. Ниже цифры со страниц разработчиков, открытых 1 ноября 2026 года: это потолок одного запроса в документации, не обещание, что бытовой чат всегда дотягивает до потолка.
| Модель | Окно на запрос | Как делятся вход и ответ |
|---|---|---|
| GPT-6 Astra | 1 050 000 | вход до 922 000, ответ до 128 000 |
| Claude Sonnet 5, Sonnet 5.5, Opus 5.5, Haiku 5.5 и ряд соседних | 1 000 000 | ответ до 128 000 |
| Прочие Claude, включая устаревшую Sonnet 4.5 | 200 000 | отдельный потолок ответа на той же странице для них не выписан |
| Gemini 4 Argon | 1 048 576 | общая сумма на вход, обдумывание и ответ |
| Gemini 3 и Gemini 2.5 | 1 000 000 на вход | на ответ отдельный бюджет 64 000 |
| DeepSeek V4 Pro и V4 Flash | 1 000 000 | в анонсе это окно по умолчанию во всех службах компании |
| Grok 4.7 | 500 000 | отдельный потолок ответа на странице моделей не выписан |
Рядом с этими именами легко потерять дату знаний. У GPT-6 Astra отсечение в карточке стоит на 30 апреля 2026 года, у Grok 4.7 на странице xAI указан май 2026 года, и окно с датой отсечения — разные оси. Модель может прочитать вложенный конспект, написанный вчера, и при этом не знать новость, которой не было в обучении. Вложение как раз и нужно, когда факт моложе отсечения, а длинное окно само по себе новости не подтягивает.
Ещё одна развилка, её путают с размером окна. GPT-6 Astra в документации принимает текст и изображение и отвечает текстом, и картинка тоже занимает токены, хотя на глаз это «одна фотография». Anthropic ограничивает не только токены: до 600 изображений или страниц PDF на запрос у моделей с миллионным окном и до 100 у моделей с окном в 200 тысяч. Упереться можно в размер запроса раньше, чем в число токенов, и приём «приложу двадцать сканов методички» упирается именно сюда.
У DeepSeek обе модели поколения V4, старшая и быстрая, заявлены с окном в миллион, и компания пишет, что миллион теперь стоит по умолчанию. Как именно ужали сверку, сказано выше, а для выбора модели важнее другое: окно одинаковое, а число параметров, которые работают на один токен, разное. У быстрой это 13 миллиардов активных из 284, у старшей 49 миллиардов из 1,6 триллиона. Подробный разбор семьи лежит в статье про DeepSeek, и окно там не аргумент «кто умнее».
Grok 4.7 на ноябрь 2026 года держит 500 000 токенов, это меньше миллиона у соседей по таблице и всё ещё далеко за старыми планками в 8 и 32 тысячи. Отдельный потолок длины ответа xAI на общей странице моделей не публикует, поэтому в таблицу он не поставлен. Разбор самой модели лежит в материале про Grok 4.7.
В чате GPThub из этого списка уже открываются DeepSeek V4 Flash, Claude Sonnet 5 и Gemini 3.8 Flash. Окно Gemini 3.8 Flash в таблицу не попало, потому что страница Google, которую сверяли 1 ноября, отдельно для этой модели потолок не выписывает и говорит про семейство и про Gemini 4 Argon. Ставить чужую цифру рядом с её именем было бы выдумкой.
Почему русский текст толще английского
Линейка «четыре знака на токен» разъезжается, как только текст перестаёт быть английским. В мае 2023 года Петров, Ла Мальфа, Торр и Биби показали, что разъезд начинается ещё до модели, на нарезке. Один и тот же смысл, переведённый на разные языки, получает разную длину в токенах. В отдельных парах языков разница доходила до 15 раз. Нарезчики, которые специально учили на многих языках, разрыв не убрали. Даже посимвольные и побайтовые схемы давали больше чем четырёхкратную разницу на некоторых парах. Работа вышла на NeurIPS в том же году.
Множитель именно для пары русский-английский авторы в аннотации не называют, и выдумывать его здесь незачем: для дела хватает направления. Конспект на русском почти наверняка займёт больше токенов, чем английская прикидка по числу слов, и окно, которое «вмещает восемь романов», вмещает меньше русских романов. Методичка, которая «точно влезет, там всего сорок страниц», может упереться раньше английской статьи того же объёма в знаках.
От этого зависит не только «влезет или нет». Петров и соавторы прямо связывают длину нарезки с тремя бытовыми вещами: сколько содержания можно положить в контекст, сколько ждать и сколько платить там, где счёт идёт за токен. Русский вопрос с вложенным русским файлом съедает полосу быстрее, чем кажется по линейке OpenAI, и ответ на него тоже толще, если модель отвечает по-русски.
Практический вывод скучный, и он рабочий: прикидывайте запас. Если английская оценка говорит, что текст занимает половину окна, для русского исходника держите в голове, что доля может быть заметно больше. Точный счёт даёт только нарезчик конкретной модели. Чужой нарезчик, приложенный к Claude или к Gemini, покажет соседнее число, не их.
Что проверить, когда ответ «поплыл»
Это не инструкция по запросам. Как формулировать задачу, разобрано в гайде как писать запросы, а как выбрать модель под задачу — в гайде как выбрать модель. Что вообще считается запросом и из чего он складывается, объясняет статья что такое промпт. Здесь только проверка, которая отличает «модель забыла» от «в полосу не положили».
Возьмите текст, который вы и так собирались вложить, конспект, главу или условие лабораторной, и задайте три вопроса подряд, новым сообщением каждый: первый про факт из самого начала, второй про факт из середины, третий про факт из последнего абзаца. Если начало и конец находятся, а середина нет, это как раз седло из работы 2023 года, а не «модель глупее на этой теме». Google советует в таком случае ставить вопрос после материала, а не перед ним, и имеет смысл повторить средний вопрос отдельным ходом, одной фразой напомнив, в каком месте текста смотреть.
Вторая проверка — про вчерашний диалог. Спросите деталь, которую называли двадцатью репликами раньше и которую легко выкинуть при пересказе: номер варианта, порог в задаче, оговорку «не считать черновик». Если модель отвечает гладко и мимо, откройте, что реально осталось в переписке на экране: часто ранних реплик уже нет или на их месте короткий пересказ. Тогда чинить надо состав полосы, и деталь придётся повторить в новом вопросе своими словами. Ждать, что модель «вспомнит», некуда, вспоминать попросту нечего.
Третья проверка — про скрытый расход. Трудный вопрос, короткий ответ, и следом модель вдруг хуже держит вложение, потому что у рассуждающих моделей часть окна съело обдумывание. Новый ход лучше начать с короткого повтора условия, а не со слова «продолжай»: оно опирается на полосу, которую вы не видите целиком.
Типичные промахи собираются без порядка «сделай раз, сделай два». Считать слова вместо токенов и верить английской линейке на русском конспекте. Класть вопрос в начало длинного вложения, а нужный абзац прятать в середину. Прикладывать пачку сканов и удивляться обрыву, хотя лимит страниц и картинок наступает раньше лимита токенов. Путать дату отсечения знаний и окно: модель прочитала ваш файл и всё равно не знает новость, которой в файле нет. Принимать пересказ старого диалога за исходные реплики. Мерить ум модели размером окна, хотя миллион токенов не лечит слабое место в задаче, для которой эта модель и не бралась.
Если после трёх проверок середина находится, вчерашняя деталь на месте, а ответ всё равно пустой по сути, дело уже не в окне, и тогда смотрят модель и задачу. Для этого как раз сравнение в гайде выбора, а не ещё одна тысяча токенов того же текста.
В чате GPThub тот же конспект можно прогнать на двух моделях с разным окном из таблицы выше и посмотреть, где седло начинается раньше. Имеет смысл держать вопрос дословным, иначе вы сравниваете формулировки, а не длину полосы.
Вопросы и ответы
Что такое токены в нейросети простыми словами?
Куски, на которые режут текст перед счётом: иногда кусок совпадает со словом, иногда это слог, пробел или знак. Модель шагает по кускам, не по словам, и два текста с одинаковым числом слов часто дают разное число кусков.
Что такое контекстное окно нейросети?
Окно — это сколько кусков модель держит в одном запросе, вместе с вопросом и вместе с ответом, который ещё пишет. Это рабочая полоса на сейчас, а не память обо всех ваших прошлых чатах. Что за край полосы вытеснили, в этот ответ не входит.
Что такое токены в контексте нейросетей, когда речь о длине запроса?
Та же мерка, только в составе окна, и окно измеряют токенами, потому что модель читает токены. Фраза «контекст в десять тысяч слов» в документации разработчика не встречается: там стоят токены входа, токены ответа и, у части моделей, токены обдумывания.
Сколько токенов у ChatGPT, если смотреть документацию модели?
Одного числа нет, окно записано у конкретной модели. У GPT-6 Astra в документации OpenAI на 1 ноября 2026 года это 1 050 000 токенов на запрос, из них на вход не больше 922 000 и на ответ не больше 128 000. Чат на сайте разработчика имеет право сжимать или вытеснять старые реплики раньше этого потолка. Цифры по тарифам самого ChatGPT в открытую карточку модели не входят, и переписывать их из пересказов здесь незачем.
Что такое токены, когда говорят именно про нейросеть?
В этой статье — только куски текста для языковой модели. В других областях тем же словом называют жетон, учётную единицу или ключ доступа, и к размеру окна чата те значения отношения не имеют. Если в разговоре про нейросеть говорят «токены кончились», речь о полосе или о лимите расхода на запрос, не о жетоне в кассе.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.