
Что такое трансформер в нейросети — архитектура простыми словами

Обозреватель: как устроен ИИ
Содержание
12 июня 2017 года восемь исследователей выложили на arXiv статью с названием, похожим на лозунг: «Attention Is All You Need», то есть «внимания достаточно». Шестеро работали в Google Brain и Google Research, ещё двое (Эйдан Гомес из Университета Торонто и Илья Полосухин) делали свою часть работы там же. В аннотации авторы назвали новую архитектуру Transformer и прямо написали, что в ней нет ни рекуррентных связей, ни свёрток. Архитектура трансформера в нейросети с тех пор стала общим каркасом и для переводчиков, и для моделей, которые сегодня отвечают в чате. Слово путают с электротехникой и с игрушечными роботами, но в машинном обучении оно значит другое. Трансформер — чертёж нейросети, которая читает последовательность кусков текста и на каждом шаге решает, какие другие куски сейчас важны. Этот приём называется механизмом внимания, и почти весь текст ниже — про него. Без формул: только то, что написано в самой статье, и числа оттуда же.
Что было до 2017 года
Для понимания придётся отступить назад. К 2017 году машинный перевод уже делали нейросетями, и лучшие из них были рекуррентными. Рекуррентная сеть идёт по фразе слева направо: состояние на текущем слове вычисляется из состояния на предыдущем. Авторы статьи формулируют следствие очень просто: внутри одного примера шаги нельзя посчитать одновременно. Видеокарта умеет делать тысячи операций разом, но здесь она ждёт, пока закончится предыдущее слово.
Вторая беда — дальние связи. Между первым и сотым словом в такой сети лежит девяносто девять промежуточных состояний, и сигнал по дороге размывается. В статье это названо трудностью длинных зависимостей: чем длиннее путь между двумя позициями, тем тяжелее сети выучить, что они связаны.
Внимание к тому моменту уже существовало. Оно стояло в сильных переводчиках и позволяло слову перевода опереться на нужное слово оригинала, а не на одно сжатое состояние всей фразы. Но почти всегда внимание работало поверх рекуррентной сети. Авторы предложили выбросить саму рекуррентность и оставить только внимание.
Была и третья линия, свёрточные переводчики. Они считали позиции параллельно, зато далёкие слова связывали только стопкой слоёв: чем дальше слова, тем больше слоёв между ними. В трансформере путь между любыми двумя позициями постоянный. Цена у этого тоже есть: каждая позиция сверяется со всеми остальными, и объём счёта растёт как квадрат длины текста.
В таблице 1 статьи это сведено в три колонки: цена слоя, сколько операций обязаны идти по очереди и длина пути между дальними позициями. У рекуррентного слоя последовательных операций столько же, сколько слов, у самовнимания постоянное число. Для предложений тогдашнего перевода длина обычно была меньше ширины вектора (512), поэтому самовнимание выходило ещё и дешевле. Для очень длинных текстов авторы сами предлагали смотреть только на окрестность каждого слова и честно написали, что проверить это предстоит потом.
Как устроен трансформер
Исходный трансформер — переводчик, и устроен он как две башни. Левая читает фразу на исходном языке и называется кодировщиком (encoder), правая пишет перевод и называется декодировщиком (decoder). Такая пара была и раньше, новым оказалось то, из чего башни собраны.
Кодировщик представляет собой стопку из шести одинаковых слоёв. В каждом слое два подслоя: сначала многоголовое самовнимание, потом небольшая полносвязная сеть, одна и та же для каждой позиции. Вокруг каждого подслоя стоит остаточная связь: к входу прибавляют то, что подслой посчитал, и результат нормируют. Ширина везде одна, 512 чисел на позицию, иначе складывать вход с выходом было бы нельзя.
Декодировщик тоже из шести слоёв, но подслоёв в нём три. Третий смотрит на выход кодировщика, то есть на уже прочитанную фразу. Самовнимание декодировщика закрыто маской: позиция видит себя и всё, что левее, а будущие слова для неё не существуют. Перевод пишется по одному куску — написанный кусок подаётся обратно на вход, и следующий зависит от всех предыдущих. Это и называется авторегрессией.
Полносвязная сеть внутри слоя устроена скромно: два линейных преобразования, между ними функция ReLU, которая обнуляет отрицательные числа. Вектор из 512 чисел внутри раздувается до 2048 и сжимается обратно. Разделение труда такое: внимание решает, у каких соседей спросить, а эта сеть решает, что сделать с собранным ответом на месте.
На вход сеть получает не буквы и не всегда целые слова. Для пары английский–немецкий авторы нарезали текст методом byte-pair encoding, общий словарь вышел около 37 000 кусков, для французского — 32 000. Такой кусок называют токеном (подробно про нарезку — в статье про токены и контекстное окно). Каждый токен превращается в вектор из 512 чисел, эмбеддинг. Что это такое и зачем тексту числа, разобрано отдельно.
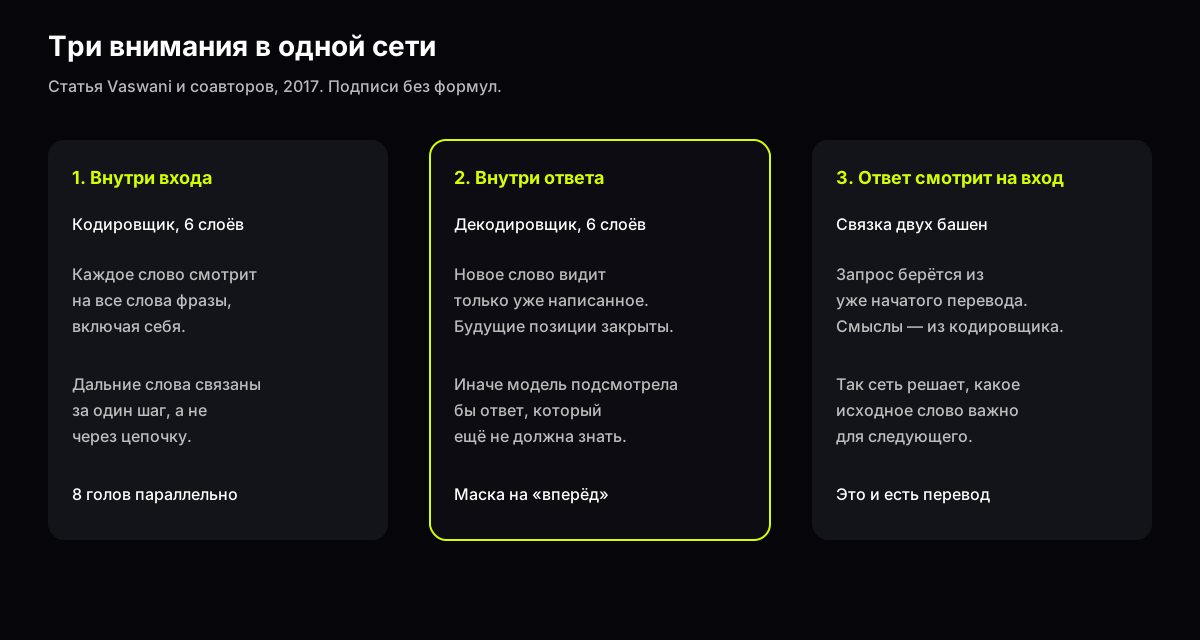
Схема трёх вниманий по разделу 3.2.3 статьи Васвани и соавторов, иллюстрация GPThub
Архитектура трансформера: что такое внимание
Обычно внимание объясняют через фонарик: луч выхватывает одно важное слово, остальные остаются в темноте. Картинка неверна в двух местах. Сеть не выбирает одного победителя. Она смешивает все позиции сразу, просто с разными весами, и веса в сумме дают единицу. И делает она это для всех позиций одновременно, а не водит лучом по очереди.
Точнее другая картинка. Каждая позиция задаёт вопрос всем остальным. У каждой позиции есть ярлык, по которому видно, насколько она подходит к вопросу, и есть содержимое, которое она готова отдать. В статье это запрос, ключ и значение (query, key, value). Выход — взвешенная сумма значений, а вес зависит от того, насколько запрос совпал с ключом. Все три роли получаются из одного вектора позиции тремя разными обучаемыми преобразованиями.
Совпадение запроса и ключа меряют скалярным произведением, то есть, грубо говоря, перемножают числа попарно и складывают. При большой ширине векторов такие суммы раздуваются, нормировка весов уходит в область, где сеть почти перестаёт учиться, поэтому произведение делят на корень из ширины ключа. У базовой модели ширина ключа 64, корень из неё равен 8. Скалярный вариант выбрали ещё и ради скорости: он сводится к умножению матриц, а видеокарты к 2017 году умели делать это очень быстро.
Голов внимания восемь. Каждая голова смотрит на свою проекцию вектора шириной 64 (512, делённые на 8), считаются они параллельно, потом их выходы склеивают и ещё раз проецируют в 512. По объёму счёта это почти то же, что одна голова на всю ширину. Смысл в другом: одна голова всё усредняет, а разные могут заняться разными связями. В приложении статьи авторы показывают, что отдельные головы цепляются за синтаксис и за смысловые связи слов, — впрочем, это наблюдение по их картинкам, а не отдельное исследование.
Сколько голов нужно, видно по таблице 3. На проверочном наборе базовая модель с восемью головами набирала 25,8 BLEU. Одна голова опускала результат до 24,9, четыре давали 25,5, шестнадцать — те же 25,8, тридцать две — 25,4. Восемь здесь не магическое число. Просто на этих данных качество к восьми вышло на полку, а дальше каждая голова становилась слишком узкой.
Ключевой компонент архитектуры трансформера
Ключевой компонент — механизм внимания, и это не оборот из конспекта, а суть заявки авторов. Рекуррентность и свёртки убрали, и внимание осталось единственным способом связать позиции между собой. Полносвязные подслои, остаточные связи и нормировка никуда не делись, без них блок не работает. Но отличает чертёж от предшественников именно внимание.
В чертеже оно стоит в трёх местах, и путать их вредно.
- В кодировщике — самовнимание по всей фразе. Запросы, ключи и значения берутся из одного слоя, каждое слово смотрит на все слова, включая себя.
- В декодировщике — самовнимание с маской. Связи, ведущие вправо, перед нормировкой зануляются, иначе при обучении сеть подглядывала бы в слово, которое должна предсказать.
- Между башнями — внимание кодировщик–декодировщик. Запросы приходят из перевода, ключи и значения — из оригинала, и каждое новое слово перевода может опереться на любое место исходной фразы.
Остаётся порядок слов. Внимание само по себе видит набор позиций, а не очередь, — переставьте слова, и смеси получатся те же. Поэтому к эмбеддингу каждого токена прибавляют позиционный код той же ширины 512, составленный из синусов и косинусов разных частот. Гипотеза авторов: так сети проще уловить относительный сдвиг («через три слова левее»), чем запоминать абсолютные номера.
Обучаемые позиционные векторы авторы тоже пробовали — результат почти тот же (таблица 3, строка E). Синусы оставили по другой причине: они продолжаются за пределы длины, на которой сеть учили, а выученная таблица позиций за этим краем просто кончается.
Цифры исходной статьи
Базовая модель по таблице 3 содержит 65 миллионов параметров. Параметр — одно число, которое подстраивается при обучении. Глубина на качество влияла заметно: два слоя вместо шести давали 36 миллионов параметров и 23,7 BLEU на проверочном наборе, восемь слоёв — 80 миллионов и 25,5. Расширение внутреннего слоя до 4096 дало 90 миллионов параметров и 26,2 BLEU.
Учили на одной машине с восемью NVIDIA P100. Шаг базовой модели занимал около 0,4 секунды, 100 000 шагов — 12 часов. Большая модель тратила около секунды на шаг и делала 300 000 шагов, то есть 3,5 суток. Первые 4000 шагов скорость обучения росла, дальше плавно падала. Ещё одна деталь: авторы сглаживали правильные ответы, чтобы модель не была уверена на сто процентов. Перплексия от этого ухудшалась, а качество перевода росло.
Данные были вполне конкретные: конкурсный корпус WMT 2014. Для немецкого около 4,5 миллиона пар предложений, для французского 36 миллионов. Никакого «всего интернета»: исходный трансформер учили только переводить.
| Что | Базовая модель | Большая модель |
|---|---|---|
| Слоёв в каждой башне | 6 | 6 |
| Ширина / голов | 512 / 8 | шире базы |
| Параметров | 65 млн | — |
| Обучение на 8×P100 | 12 часов | 3,5 суток |
| Английский → немецкий, newstest2014 | выше прежних моделей и ансамблей | 28,4 BLEU |
| Английский → французский | — | 41,8 BLEU |
С английского на немецкий большая модель получила 28,4 BLEU — больше чем на 2 пункта выше прежних лучших результатов, включая ансамбли из нескольких моделей. С английского на французский — 41,8 BLEU и рекорд для одиночной модели, причём обучение стоило меньше четверти цены прежнего рекордсмена. Даже базовая модель за 12 часов обошла все опубликованные до неё модели на немецком.
BLEU — автоматическая оценка перевода: насколько куски машинного текста совпали с человеческим эталоном, по шкале от 0 до 100. Это не проценты правильных ответов. 28,4 BLEU в 2017 году — очень высокий счёт, а не «двойка».
У пересказов здесь частая путаница. В сборнике конференции NeurIPS 2017 напечатана более ранняя аннотация с другими цифрами: 27,5 BLEU на немецком и 41,1 на французском. Позднейшая версия на arXiv их обновила. Внутри седьмой версии тоже есть разнобой: в аннотации и таблице 2 стоит 41,8, а в тексте раздела 6.1 — 41,0. Если вы видите одну из этих цифр, это не обязательно ошибка, просто разные снимки одной работы.
Две ветки после 2017 года
Следующий ход сделали быстро. Ту же стопку блоков стали учить на сыром тексте, без пар «фраза и перевод», а потом доучивать под конкретную задачу. И от чертежа взяли по половине.
В октябре 2018 года Джейкоб Девлин и коллеги из Google описали BERT — двунаправленный кодировщик, собранный по реализации статьи 2017 года. Базовая версия — 12 слоёв, ширина 768, 12 голов, 110 миллионов параметров; большая — 24 слоя и 340 миллионов. BERT видит текст в обе стороны, поэтому учили его заполнять пропуски: в каждом примере закрывали 15% токенов и просили их восстановить. Подробно про BERT и про то, как он превращает слова в векторы с учётом соседей, — в статье про эмбеддинги.
Вторая ветка выросла из декодировщика. В той же статье про BERT прямо сказано, что OpenAI GPT — левосторонний трансформер: каждое слово видит только то, что слева. Размер базового BERT авторы специально подогнали под тогдашний GPT, чтобы сравнение было честным.
14 февраля 2019 года OpenAI представила GPT-2 — языковую модель на трансформере с 1,5 миллиарда параметров. По словам компании, это прямое увеличение GPT больше чем в десять раз и по размеру, и по объёму данных: около 40 гигабайт текста с 8 миллионов веб-страниц. Задача обучения одна — предсказать следующее слово по предыдущим. Полную модель в день анонса не выложили, сначала открыли меньшие версии.
Развилка держится до сих пор. Кодировщик удобен, когда весь текст уже лежит перед сетью: классификация, поиск ответа внутри абзаца, сравнение двух фраз. Декодировщик удобен, когда текст ещё пишется, — продолжение, ответ в чате, перевод слово за словом. Как из декодировщика выросли большие языковые модели и чем модель отличается от чата, рассказано в статье про LLM.
Позднейшие надстройки чертёж не отменили. Смесь экспертов, о которой подробно написано в разборе DeepSeek, включает на каждый токен только часть блоков: хранится большая сеть, а считает маленькая. Сжатое и разреженное внимание борются с той самой квадратичной ценой длинного текста, о которой авторы предупреждали в 2017 году. Внутри по-прежнему запросы, ключи и значения.
Пример на трёх словах
Полезно один раз прогнать в голове короткую фразу из трёх токенов. На первом слое кодировщика каждый из них получает смесь всех трёх — с разными весами. На втором слое смешиваются уже смеси. После шестого слоя вектор каждого слова зависит от всей фразы, хотя ни одного рекуррентного шага не было.
В декодировщике картина другая. Первое слово перевода видит только себя и всю левую башню. Второе видит первое и снова всю левую башню, третье — два уже написанных. Сеть каждый раз заново выбирает, куда смотреть в оригинале, и не сжимает его в один вектор.
Квадрат здесь крошечный, три на три, девять пар. На документе в тысячу токенов тот же шаг сверяет уже миллион пар. Отсюда весь разговор о длине контекста у современных моделей: сколько токенов помещается в этот квадрат на практике, с учётом памяти видеокарты. В статье 2017 года слов «контекстное окно» ещё нет — есть длина последовательности и предостережение про очень длинные тексты.
Как проверить ответ про архитектуру
Вопрос «как устроен трансформер» одинаково звучит на зачёте и в чате с моделью. Слабый ответ начинается словами «это нейросеть нового поколения» и заканчивается общими фразами про понимание контекста. Сильный за несколько абзацев называет дату, две башни, шесть слоёв, внимание и маску.
Запрос можно составить так: «Объясни, чем самовнимание кодировщика отличается от самовнимания декодировщика в статье Attention Is All You Need, и приведи параметры базовой модели. Укажи, из какого раздела статьи каждое число». В ответе стоит проверить пять вещей.
- Есть ли дата (июнь 2017 года) и хотя бы фамилия Vaswani. «Примерно в 2018-м» — уже помарка.
- Названо ли внимание, а не «память» и не «база знаний».
- Сказано ли, что декодировщик не видит будущих слов. Если этого нет, пересказана только половина чертежа.
- Совпадают ли 6 слоёв, ширина 512, 8 голов и 65 миллионов параметров. Круглые «100 миллионов» к базовой модели не относятся.
- Не превратились ли 28,4 BLEU в «точность 28%» или «90% правильных ответов».
Хорошая проверка понимания — вопрос, что будет, если убрать маску в декодировщике. Верный смысл такой: при обучении сеть увидит слово, которое должна предсказать, и задача выродится в списывание. Если маску называют «фильтром нежелательных слов», модель путает её с совсем другим механизмом.
Для такого разговора подходит любая сильная модель — они уже доступны в чате GPThub. Как выбрать модель под задачу, рассказано в гайде «Как выбрать модель», как построить запрос, чтобы в ответе были ссылки на источник, — в гайде про промпты. Если хочется сравнить ответы двух моделей на один вопрос, есть практическое сравнение.
Типичные ошибки пересказов
Первая ошибка: называть трансформером конкретную программу. Трансформер — чертёж. GPT-2 — одна модель на этом чертеже, причём на его правой половине; BERT — другая, на левой.
Вторая: приписывать статье 2017 года обучение на «всём интернете». Там 4,5 миллиона пар предложений для немецкого и 36 миллионов для французского, а задача — перевод.
Третья: смешивать снимки статьи. 165 миллионов параметров и 27,5 BLEU взяты из ранней аннотации NeurIPS, 65 миллионов у базы и 28,4 BLEU у большой модели — из поздней версии на arXiv.
Четвёртая: считать, что внимание хранит знания. На одном шаге внимания склада фактов нет, есть только векторы текущего текста. Откуда модель «знает» столицу или дату — вопрос обучения на данных, и статья 2017 года его не касалась.
Пятая: «трансформер умнее рекуррентной сети». В 2017 году на двух конкурсах перевода он был точнее и учился в разы быстрее на указанном железе. Это измерение качества перевода и времени обучения, а не понимания. Таблица 1 той же статьи уже предупреждала, что на очень длинных текстах квадрат длины съедает выгоду.
Если в новости написано «новая архитектура, не трансформер», имеет смысл открыть технический отчёт и посмотреть, осталось ли внимание по всем позициям. Смена словаря, оптимизатора или числа экспертов чертёж не отменяет. Пока в отчёте есть запросы, ключи и значения, перед вами родственник статьи 2017 года — даже если слоёв уже не шесть, а много десятков. Ещё один простой ориентир — раздел о модели в техническом отчёте: если там описаны «декодировщик», «головы внимания» и «позиционное кодирование», это та же семья, сколько бы новых слов ни стояло в заголовке пресс-релиза.
Прочитать саму статью 2017 года полезно и тем, кто формул боится. Введение и раздел 4 («Почему самовнимание») написаны почти обычным языком, а таблица 3 показывает, как каждая деталь чертежа влияет на качество. Это редкий случай, когда первоисточник понятнее большинства пересказов.
Вопросы и ответы
Что является ключевым компонентом архитектуры трансформера?
Механизм внимания. В статье 2017 года сеть связывает позиции только им: запрос каждого слова сверяется с ключами остальных, и их значения складываются с полученными весами. Полносвязные подслои и остаточные связи в блоке тоже есть, но внимание не заменяют.
Как устроен трансформер?
Исходный трансформер — две стопки по шесть слоёв. Левая (кодировщик) читает вход целиком, правая (декодировщик) пишет выход по одному токену и не видит будущих позиций. В каждом слое — многоголовое внимание и небольшая полносвязная сеть. У базовой модели ширина 512, 8 голов и 65 миллионов параметров.
Что такое архитектура трансформера простыми словами?
Способ собрать нейросеть для текста, в которой каждый кусок смотрит на все остальные и берёт смесь их содержимого с разными весами. Порядок слов задаётся отдельным позиционным кодом, потому что само внимание порядка не видит.
Трансформер — это нейросеть или модель?
Трансформер — архитектура, то есть чертёж нейросети. Модель — уже обученные числа по этому чертежу. BERT и GPT-2 — разные модели, собранные из разных половин одного чертежа.
Трансформер и чат-модель — одно и то же?
Нет. Чат-модель обычно продолжает текст и устроена как декодировщик. Трансформер 2017 года ещё и читал фразу отдельным кодировщиком, потому что переводил. Современные чат-модели выросли из этого чертежа, но совпадают с ним не один в один.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.