
Что такое компьютерное зрение и как нейросеть понимает картинку

Обозреватель: как устроен ИИ
Содержание
В декабре 2012 года в Лейк-Тахо Alex Krizhevsky, Ilya Sutskever и Geoffrey Hinton показали сеть, которая на тесте соревнования ImageNet ошиблась в пятёрке верхних догадок в 15,3% случаев, тогда как второе место держалось на 26,2%. Сеть не разглядывала яблоко целиком, как это делает глаз, а скользила маленьким фильтром по сетке чисел и в конце выдавала тысячу оценок. Что такое компьютерное зрение, из этого эпизода видно яснее, чем из абзаца определения в учебнике. Программа получает снимок и возвращает проверяемое решение, ярлык, рамку или маску по пикселям, и студенту этого деления хватает, чтобы не смешивать три разные лабораторные.
Что такое компьютерное зрение простыми словами
Компьютерное зрение — область, где программа отвечает на заранее узкий вопрос о картинке, вроде «какой это класс», «где лежат предметы» или «какие пиксели относятся к дороге». Кратко схема звучит так: на входе сетка чисел, на выходе структура, которую можно сверить с разметкой человека, и одной фразы «нейросеть поняла фото» для этого мало.
Три задачи стоит держать отдельно, иначе чужие новости слипаются в одну заметку про «зрение вообще». Классификация вешает на весь кадр имя из закрытого списка. Обнаружение добавляет место и требует прямоугольник вместе с именем, потому что фразы «на фото есть кружка» уже недостаточно. Сегментация идёт мельче и пишет ответ почти в каждый пиксель.
В соревновании ILSVRC таких имён было ровно 1000, и сеть Krizhevsky училась на 1,2 миллиона снимков выпуска 2010 года. На тесте ошибка первого места, её обозначают top-1, составила 37,5%, а ошибка пятёрки лучших догадок, top-5, составила 17,0%. У сети насчитали 60 миллионов параметров и 650 тысяч нейронов: пять свёрточных слоёв, местами с прореживанием по максимуму, и три полносвязных слоя перед выходом на 1000 классов.
Набор ImageNet, о котором статья Deng и соавторов вышла в 2009 году на CVPR, собран по словарю WordNet, где больше 100 тысяч понятий и среди них больше 80 тысяч существительных. Авторы целились примерно в 1000 снимков на понятие, с ручной проверкой каждого кадра. Для гонки ILSVRC позже зафиксировали другое деление: 1 281 167 обучающих кадров, 50 000 проверочных и 100 000 тестовых, и это уже экзамен, а не весь словарь.
Бытовая путаница начинается в тот момент, когда человек говорит «сеть узнала фото», а в протоколе соревнования сеть лишь выбрала класс из заранее закрытого списка. Список новый, и старая сеть молчит, пока её не научат заново или пока её не свяжут с текстом, как это сделали позже в CLIP. Разница между «узнала» и «выбрала из тысячи» для лабораторной работы решает, какой отчёт писать.
Как картинка становится таблицей чисел
Цветной снимок в конспекте курса Stanford CS231n записывают объёмом «ширина × высота × 3», где тройка означает каналы красного, зелёного и синего. Учебный набор CIFAR-10 крошечный даже по меркам 2010-х: 32 на 32 пикселя и те же три канала, так что одному нейрону обычной полносвязной сети на первом слое уже нужно 32 × 32 × 3 = 3072 веса. Кадр скромнее журнального, 200 на 200 пикселей, даёт уже 120 000 весов на один нейрон, а несколько таких нейронов раздувают память и толкают сеть запоминать учебные кадры вместо правила.
Поэтому большую картинку оставляют объёмом с шириной, высотой и глубиной каналов, вместо одной длинной строки. Следующий слой видит маленькое окно, весь кадр ему сразу не показывают, и в этом месте аналогия с глазом как раз врёт. Глаз не прикладывает одну и ту же трафаретку к левому углу и к правому, а свёрточная сеть делает именно это.
Фильтр первого слоя в конспекте часто берут размером 5 × 5 × 3, то есть 75 чисел плюс смещение, и его везут по кадру. В каждой точке считают скалярное произведение фильтра и куска картинки: где кусок похож на фильтр, ответ большой, где не похож, ответ маленький. На первом слое такие фильтры обычно ловят край или пятно цвета, а выше по стопке рисунок сложнее, и конспект прямо пишет про соты и колёса на верхних картах. До бытового «понимания яблока» здесь ещё далеко: перед нами набор карт, которые вместе двигают оценку класса.
У победителя 2012 года первый фильтр был крупнее учебникового: поле 11 пикселей, шаг 4, без рамки из нулей и 96 разных фильтров. Если взять вход 227 × 227 × 3, выход получается 55 × 55 × 96, потому что (227 − 11) / 4 + 1 = 55. В самой статье авторов вход указан как 224 × 224, и та же формула даёт нецелое число, о чём конспект CS231n пишет отдельно. Для студента спор о двух пикселях второстепенен, зато важен шаг: фильтр прыгает, карта сжимается, и считать становится легче.
Дальше карту ещё прореживают и из окна 2 × 2 оставляют максимум, так что мелкий сдвиг предмета на исходном фото слабее бьёт по ответу. Предмет чуть уехал, а грубая карта почти та же, и именно эту устойчивость потом продают фразой «сеть узнаёт предмет с любого ракурса», хотя ракурс в экзамене 2012 года был устроен гораздо спокойнее уличной съёмки.
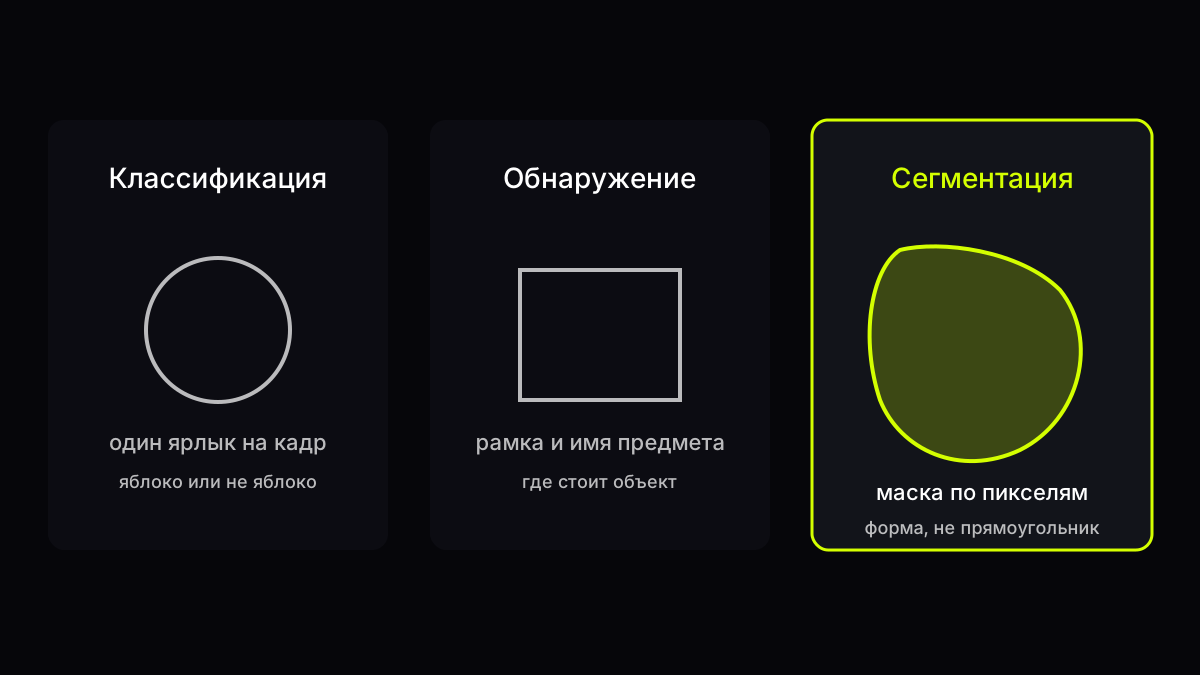
Источник: схема редакции по статьям Krizhevsky et al. (2012), Redmon et al. (2015) и He et al. (2017). Проверено 2 ноября 2026.
Как нейросеть распознает объекты
Классификация и поиск предметов сдают разные экзамены: в первом сеть смотрит на кадр и ставит имя из списка, во втором она обязана показать, где это имя живёт. До 2015 года поиск часто собирали из кусков, сначала нарезали кандидатов, потом каждый кусок кормили классификатором, и ошибка одного куска портила весь отчёт.
Joseph Redmon с соавторами в июне 2015 года, с правкой текста в мае 2016-го, предложили другой ход: одна сеть за один просмотр предсказывает и рамки, и вероятности классов. Название YOLO растёт из этой фразы про единственный взгляд. Базовая модель в их отчёте держит 45 кадров в секунду, уменьшенный Fast YOLO держит 155, и ошибок положения у такой схемы больше, чем у тогдашних аккуратных систем. Зато пустой фон она реже объявляет предметом, что для уличной камеры часто важнее идеального угла рамки.
Логика скорости здесь прямая: кадр остаётся целым, и сеть сразу рисует сетку ответов. Для видео это уже рабочий запас: двадцать пять кадров в секунду похожи на обычный ролик, а сорок пять оставляют место на остальные дела программы. Про видеоряд отдельно написано в материале про нейросети для видео, и здесь достаточно помнить, что рамка на одном фото и рамка на каждом кадре ролика остаются соседними задачами.
Учебный набор для рамок устроен иначе, чем ImageNet. Microsoft COCO, статья мая 2014 года с правкой февраля 2015-го, собрал бытовые сцены: 91 тип предметов, которые узнал бы ребёнок четырёх лет, и 2,5 миллиона размеченных экземпляров на 328 тысячах изображений. У 82 категорий больше пяти тысяч экземпляров, а разметка идёт маской на каждый отдельный предмет, так что прямоугольником дело не кончается. Кружек на столе может быть три, и тогда нужны три маски, а не одна общая «область посуды».
Отсюда бытовая проверка, когда чат пишет, что «распознал объекты». Смотрят, какая форма вернулась: одно слово на весь кадр, список рамок или контур. Если контура нет, а в ответе стоит уверенное «это кружка слева», место сеть могла дорисовать словами поверх ярлыка, и такой ответ ещё не обнаружение.
Что такое сегментация в компьютерном зрении
Сегментация красит снимок так, что у каждого пикселя появляется метка класса вроде дороги, неба, человека или фона. В ноябре 2014 года Jonathan Long, Evan Shelhamer и Trevor Darrell описали полностью свёрточную сеть: вход может быть любого размера, выход остаётся картой того же порядка, и учить её можно от пикселей к пикселям, без отдельной нарезки кадра на квадраты.
Они взяли готовые классификаторы, в том числе сеть 2012 года, VGG и GoogLeNet, и доучили их на разметку областей. На PASCAL VOC 2012 средний индекс пересечения, его обозначают mean IU, дошёл до 62,2%, и относительно прежнего уровня это плюс 20%. На типичном кадре вывод занимал около трети секунды по аннотации arXiv. В журнальной версии IEEE время короче, и смешивать две редакции в одной цифре не стоит.
Индекс пересечения здесь устроен бытово: берут раскраску сети и раскраску человека, потом смотрят, насколько общая область похожа на объединение обеих. Оценка 62% ещё не значит, что «сеть видит как человек», это средний балл по классам экзамена 2012 года, и отдельные классы внутри среднего могут проседать сильно.
Семантическая карта при этом не различает двух людей, и оба набора пикселей могут остаться просто меткой «человек». Экземпляры разделяет другая задача. В марте 2017 года Kaiming He, Georgia Gkioxari, Piotr Dollár и Ross Girshick опубликовали Mask R-CNN: к уже известной схеме Faster R-CNN они добавили ветку маски, и ветка идёт параллельно ветке рамки. Лишняя цена по их отчёту скромная, сеть работает примерно в 5 кадров в секунду и на соревновании COCO тогда лидировала сразу в трёх дорожках, среди которых маски, рамки и точки тела.
Пять кадров в секунду и сорок пять — разный разговор, потому что маска точнее рамки и тяжелее по счёту. Для ролика в реальном времени маску часто не успевают посчитать. Для снимка в альбоме пять кадров в секунду уже щедрый запас. Студенческий конспект часто склеивает оба слова, и «сегментация» без прилагательного может значить и карту классов, и отдельный контур каждого яблока.
В вопросе к чату лучше сразу назвать форму ответа. Просьба «покрась пиксели яблока» и просьба «скажи, яблоко ли это» запускают разную проверку, и красивый абзац не заменяет ни маску, ни ярлык из списка.
Как сеть учится по подписи, а не по номеру класса
Закрытый список из 1000 имён долго оставался нормой: хочешь новый класс, собирай новую разметку и учи выход заново. В январе 2021 года OpenAI показала сеть CLIP, а статья на arXiv вышла 26 февраля того же года. Идея в посте от 5 января звучит просто, если не смотреть на объём. Берут пары «кадр и текст», которых в интернете и так много, всего 400 миллионов таких пар, и задают узкий учебный вопрос: из 32 768 случайных подписей выбрать ту, что реально стояла рядом с картинкой.
Чтобы выиграть в этом вопросе, сеть вынуждена связывать вид предмета и слова. После учёбы новые имена можно подставить текстом, без свежей размеченной тысячи. На ImageNet без дообучения CLIP сравнивается с исходной ResNet-50 и не трогает её 1,28 миллиона учебных примеров. В посте OpenAI сказано, что разрыв между экзаменной точностью и устойчивостью на других наборах сокращается вплоть до 75%.
Карточка модели в репозитории OpenAI датирует базовый вариант январём 2021 года: картинку кодирует изменённый ResNet-50, текст кодирует трансформер, и учат их так, чтобы верная пара была ближе случайных. Позже картиночный кодировщик заменяли на трансформер по кускам кадра. Для читателя важнее сам сдвиг, чем список шифров. Ответ задают фразой, номер из таблицы больше не обязателен.
Ограничения в том же посте названы прямо, и их полезно помнить до любой демонстрации. Считать предметы на кадре CLIP умеет плохо, оценить расстояние до ближайшей машины тоже, и на этих двух наборах результат лишь чуть выше случайного угадывания. Мелкие классы даются хуже узким моделям: марки машин, варианты самолётов, виды цветов. Рукописные цифры MNIST без дообучения сеть узнаёт в 88% случаев, а у людей на том же наборе в посте указано 99,75%. Формулировка подписи влияет на ответ, и одну мысль можно сказать так, что класс уедет.
Есть и более жёсткий пример, его не стоит смягчать. Когда среди подписей лежат расовые метки набора Fairface и оскорбительные слова, кадры людей от 0 до 20 лет попадают в оскорбительный класс примерно в 32,3% случаев. Если добавить класс «ребёнок», доля падает примерно до 8,7%, так что список имён сам меняет поведение. Узнавание знаменитостей на случайных кадрах даёт top-1 в 59,2% при выборе из 100 имён и 43,3% при выборе из 1000. Пост прямо пишет, что до промышленных систем такой результат не дотягивает.
Отсюда практический вывод для любого чата, который описывает чужое фото. Подпись, которую вы сами подсказали, уже часть экзамена, и если в запросе есть слова вроде «вор» или оценка возраста, сеть может выбрать ярлык из вашего списка, а не из кадра. Такой ярлык не годится ни как характеристика человека, ни как справка для решения. Текстовые модели живут в другой задаче, и как устроен ответ словами, разобрано в статье про DeepSeek. Зрение здесь только поставляет повод для фразы, а слова могут остаться гладкими при кривой маске.
Как кадр режут на куски, будто на слова
3 декабря 2020 года Google Research описал схему, в которой картинку режут на куски и кормят теми же блоками, что и текст. Статья Dosovitskiy и соавторов появилась на arXiv 22 октября, с названием про кадр ценой в квадраты 16 × 16. Свёрточные сети к тому моменту сидели в распознавании с 1980-х, а на первый план вышли после 2012 года вместе с ImageNet и обычными графическими процессорами.
Новый ход был другим: кадр режут на квадраты, каждый квадрат превращают в вектор, как слово в текстовой сети, и дальше работает блок внимания. Заранее сеть не знает, что квадраты лежат на плоскости, положение ей сообщают отдельными обучаемыми векторами, а сетку она восстанавливает по данным. В посте смотрят, кому какой вектор ближе, и соседи по строке и по столбцу оказываются похожи, то есть плоскость нашлась сама.
На одном ImageNet, без лишних данных, лучший результат той работы составил 77,9% top-1, а тогдашний сильный свёрточный соперник без лишних данных держал 85,8%. На малом экзамене схема с кусками проигрывала. На ImageNet-21k, где 14 миллионов изображений и 21 тысяча классов, счёты с большой свёрточной моделью Big Transfer уже близкие. На закрытом наборе JFT, 300 миллионов изображений и 18 тысяч классов, вариант с кусками обгоняет свёрточного соперника, и при том же бюджете счёта выигрыш тоже остаётся на стороне кусков.
Крупная модель на 600 миллионов параметров в том посте набирает 88,55% top-1 на ImageNet и 99,50% на CIFAR-10, а на вычищенной проверке ImageNet-Real выходит 90,72%. На наборе VTAB-1k, девятнадцать задач по тысяче примеров, средний результат равен 77,63%. Авторы пишут, что по счёту это примерно вчетверо дешевле предобучения моделей BiT.
Нижние блоки, глубина примерно от 0 до 5, смотрят и рядом, и далеко, а верхние, глубина от 10 до 20, в основном смотрят далеко. У свёрточной сети низ устроен жёстче, и там видно только соседнее окно. Куски свободнее, зато голоднее до данных: на миллионе учебных фото свобода обернулась недоучкой, на сотнях миллионов она окупилась.
Для студента эта развилка полезнее спора «какая архитектура победила». Мало данных и нужен край на фото — исторически выигрывало скользящее окно. Много данных и нужна связь левого края кадра с правым — куски начинают дышать. Новость, где обещают «новое зрение», стоит класть на ту же линейку: сколько кадров было в учёбе, какой экзамен сдавали и какая форма ответа обещана.
Что проверять в ответе, когда чат описывает снимок
Гладкий абзац прячет три провала, которые авторы CLIP назвали ещё в 2021 году и которые не исчезли от того, что чат стал разговорчивее. Первый провал связан со счётом: фраза «на столе три кружки» легко пишется, когда кружек две или четыре. Второй связан с расстоянием и порядком, и оценки «машина близко» или «машина далеко» для сети 2021 года были почти случайным жребием. Третий связан с мелким классом, породой, моделью прибора или сортом цветка, где общее имя сеть держит лучше уточнения.
Проверка короткая и обходится без отдельного ритуала. Сначала предметы пересчитывают сами, потом смотрят края: рамка, которая съела полстола, и маска, которая обрывается на ручке кружки, говорят о разных поломках. Затем выписывают, чего на кадре нет. Если чат добавил надпись, логотип или человека за краем, это выдумка формы, даже при верном общем ярлыке.
Запрос лучше держать в форме ответа, а не в форме восторга. Просьба «перечисли предметы и скажи, сколько каждого» проверяется по пальцам, а просьба «опиши атмосферу кухни» не проверяется почти никак. Как формулировать просьбу к модели, разобрано в гайде про запросы. Кнопки вокруг снимка собраны в гайде про работу с картинками.
Модель Gemini 3.8 Flash уже доступна в чате GPThub, и ей удобно отдать конспект лекции, чтобы пересказать его словами. Ответ по снимку от любой модели сверяют тем же списком, потому что умение читать вложение меняется чаще, чем определение сегментации. Если нужен рисунок с нуля, это уже другая работа, и ей ближе обзор генерации картинок, а не распознавание готового кадра.
В чате GPThub снимок несут туда, где сообщение принимает файл, и дальше сверяют ответ по трём пунктам: число, край и лишнее. Отдельная ошибка — просить диагноз, оценку человека или юридический вывод по кадру. Сеть вернёт уверенный ярлык из тех слов, которые вы сами положили в список. Для учёбы по механике это хороший отрицательный пример, а для решения о человеке такой абзац источником не служит.
Что делать со следующей новостью про «сеть видит»
Сначала ищут дату и экзамен, потому что победа 2012 года была ошибкой top-5 в 15,3% на закрытом списке ImageNet, победа CLIP в 2021 году была сравнением с ResNet-50 без её учебной разметки, а 88,55% top-1 у большой модели с кусками случились после сотен миллионов кадров. Цифры рядом не стоят, у них разные знаменатели, и пересказ «точность под девяносто» без имени экзамена почти ничего не сообщает.
Потом ищут форму ответа: ярлык, рамка, маска или подпись свободным текстом. Новость без формы обычно продаёт ощущение, а ощущение к лабораторной не пришьёшь. Дальше смотрят, на чём сеть ломалась у самих авторов, а не в рекламном абзаце. У YOLO в 2015 году хромало положение рамки, у CLIP хромали счёт и расстояние, у ранней схемы с кусками хромал маленький ImageNet.
Свежая модель почти наверняка хромает в своём месте, и если в заметке этого места нет, заметка пока про анонс, а не про распознавание. Разбор того, как читать карточку конкретной текстовой модели, лежит в материале про Grok 4.7. К картинке его применяют только как образец привычки: дата, сравнение, ограничение. Привычка переносится на новый анонс, а обещание «эта модель видит так же» не переносится.
Если снимок ваш и ответ нужен сегодня, начните с простого кадра, где один предмет, ровный свет и нет толпы в фоне. Спросите класс, потом попросите рамку словами, если модель отвечает текстом, и сверьте угол. Затем попросите не называть ничего, чего на кадре нет. Три ответа на одном кадре учат больше, чем десять кадров подряд с одинаковой похвалой в конце.
Вопросы и ответы
Что такое компьютерное зрение простыми словами?
Это умение программы ответить на узкий вопрос о снимке: назвать класс, показать рамку или пометить пиксели. Обещания «понять фото» целиком в определении нет, программа сдаёт ту форму ответа, под которую её учили на конкретном экзамене.
Что такое компьютерное зрение кратко?
На входе лежит сетка чисел, обычно с тремя цветовыми каналами, а на выходе оказывается ярлык, набор рамок или карта меток. С 2012 года основной инструмент для крупных снимков — свёртка, то есть маленький фильтр, который едет по кадру и рисует карту отклика.
Что такое компьютерное зрение в ИИ?
В нынешних системах это нейросеть, обученная на размеченных кадрах или на парах «кадр и текст». ImageNet задал список из 1000 классов, COCO задал бытовые предметы и маски, а CLIP в 2021 году связал картинку с обычной подписью на 400 миллионах пар.
Что такое сегментация в компьютерном зрении?
Семантическая сегментация красит каждый пиксель классом, и два человека при этом могут слиться в одну метку «человек». Сегментация экземпляров, как в Mask R-CNN 2017 года, рисует отдельную маску на каждый предмет, и та сеть шла примерно в 5 кадров в секунду.
Как нейросеть распознает объекты?
Она либо вешает имя на весь кадр, либо за один проход предсказывает рамки и классы, как YOLO в 2015 году, где базовая модель держала 45 кадров в секунду. Рамка отвечает на вопрос «где», а имя из закрытого списка отвечает на вопрос «какой класс из экзамена».
Как нейросеть распознает изображение?
Кадр хранят как объём «ширина × высота × каналы», фильтр вроде 5 × 5 × 3 скользит по объёму и рисует карту отклика, затем карты сужают прореживанием. В конце полносвязные слои или другой блок собирают оценки, и у сети 2012 года на тесте ILSVRC-2012 ошибка top-5 составила 15,3%.
Связанные модели

Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
- Krizhevsky, Sutskever, Hinton. ImageNet Classification with Deep Convolutional Neural Networks, NIPS 2012
- ImageNet, страница о наборе, Stanford / Princeton
- Конспект Stanford CS231n, свёрточные сети
- Redmon et al. You Only Look Once, arXiv:1506.02640
- Lin et al. Microsoft COCO, arXiv:1405.0312
- Long, Shelhamer, Darrell. Fully Convolutional Networks, arXiv:1411.4038
- He et al. Mask R-CNN, arXiv:1703.06870
- OpenAI. CLIP: Connecting text and images, 5 января 2021
- Radford et al. Learning Transferable Visual Models, arXiv:2103.00020
- Google Research. Transformers for Image Recognition at Scale, 3 декабря 2020
- Dosovitskiy et al. An Image is Worth 16x16 Words, arXiv:2010.11929
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Как работать с картинками
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.