
Мультимодальный ИИ: как одна нейросеть видит текст, фото и звук
Обозреватель: как устроен ИИ
Содержание
13 мая 2024 года OpenAI показала GPT-4o и прямо написала, чем она отличается от прежнего голосового режима. Раньше разговор с чатом шёл через три отдельные модели. Одна переписывала звук в текст, вторая думала над текстом, третья читала ответ вслух. Средняя пауза была 2,8 секунды у более лёгкой модели и 5,4 секунды у старшей. Новая модель считала текст, картинку и звук одной сетью. Короткий ответ на голос у неё начинался от 232 миллисекунд, в среднем за 320. Мультимодальный ИИ в бытовом смысле — это как раз такой сдвиг. Одна нейросеть принимает несколько видов данных, а не эстафету из узких программ.
Что такое мультимодальный ИИ?
Слово собрано из двух частей. Модальность — вид сигнала: написанные слова, фотография, звуковая дорожка, последовательность кадров. Мультимодальная модель умеет работать больше чем с одним видом сразу. Мультимодальная нейросеть в разговоре студентов обычно значит то же самое. Мультимодальные системы ИИ бывают шире. В систему могут входить несколько программ, которые только обмениваются файлами. Модель — это одна обученная сеть, даже если снаружи к ней приставлены загрузчики файлов.
Привычная картинка «у модели появились глаза и уши» здесь врёт. Глаз собирает свет сам. Сеть не получает свет и не получает давление воздуха. До неё доходит уже нарезанный ряд чисел. Текст режут на куски слов и частей слов. Фото режут на лоскуты. Звук режут на короткие окна. Дальше одна и та же сеть предсказывает следующее число в этом ряду, а наружу его снова собирают в слова, и в этом весь общий ход. Разные реализации у OpenAI, Google и Anthropic расходятся в том, кто режет сигнал и сколько чисел отдаёт на секунду ролика.
Отдельный класс, который путают с разговором, — модели встраивания. 10 марта 2026 года Google выпустил Gemini Embedding 2. Она не пишет абзац про фотографию. Она кладёт текст, картинку, короткий ролик, звук и документ в одно пространство близости, чтобы потом искать «похожий кадр» по фразе. Текст у неё до 8192 токенов, картинок до шести, ролик до 120 секунд, звук она берёт без промежуточной расшифровки в слова. Это мультимодальная модель, но задача у неё другая. Поиск соседа, а не ответ на вопрос семинара.
Ещё одна путаница — порождение картинки или ролика. Сеть, которая по фразе рисует кадр, тоже связывает текст и изображение, только направление другое. Разбор чужого снимка и сборка нового кадра — разные изделия. Про второе есть отдельные материалы: как устроены нейросети для видео, генерация роликов Veo и гайд по работе с картинками. Ниже речь про чтение, про то, как модель смотрит на уже существующие фото, звук и ролик.
Почему раньше звук, фото и текст шли по очереди?
Для понимания текущих карточек полезно отступить на несколько лет. Зрение, слух и язык долго жили отдельными лабораториями. Классификатор картинок учили на фиксированном списке подписей: кошка, самолёт, цифра. Новый предмет означал новую разметку. В 2021 году на конференции ICML группа OpenAI в статье про CLIP показала другой ход. Модель училась на 400 миллионах пар «картинка и подпись» из интернета. Задача была простая и жёсткая. Среди пачки пар угадать, какая подпись стоит у какой картинки, и оттолкнуть чужие сочетания. После этого подпись на обычном языке заменяла список классов. На ImageNet такая модель без дообучения на его 1,28 миллиона размеченных фотографий сравнялась по точности с исходной ResNet-50, которую как раз на этих фотографиях и учили. Это ещё не чат. Это общий числовой язык для кадра и фразы.
28 апреля 2022 года DeepMind описала Flamingo. Одна зрительно-языковая модель принимала картинки или видео вперемешку с текстом и отвечала текстом. Итоговый размер — 80 миллиардов параметров, старт взяли с языковой модели Chinchilla на 70 миллиардов. На 16 задачах она обходила прежние методы уже при четырёх примерах на задачу, без отдельного дообучения под каждую. Архитектурная мысль, которую стоит унести, такая. Сильную языковую модель не выбрасывают. К ней пристраивают мост из зрения. Учили эту связку на смеси крупных данных из веба, без разметки, сделанной специально под машинное обучение.
Голосовой быт до мая 2024 года этот мост обходил. OpenAI честно расписал цепочку из трёх моделей. Простая сеть пишет расшифровку, большая текстовая модель видит только буквы, третья сеть говорит. Тон, перебивание, смех за кадром и шум улицы до «умной» части не доходят. Ответ тоже не может засмеяться или спеть, потому что говорящая сеть простая и отдельно обученная. Задержка складывается из трёх очередей, а GPT-4o учили иначе: одна сеть на тексте, зрении и звуке. В анонсе вход — любое сочетание текста, звука и изображения, выход — то же сочетание, и видео в этом перечне нет. В тот же день наружу отдали текст и картинки на входе и текст на выходе. Звук в ответе обещали ограничить готовыми голосами, а звук и видео в программном интерфейсе — отдать сначала узкой группе партнёров. То есть «одна сеть умеет всё» и «сегодня в продукте открыто всё» в анонсе стояли рядом и не совпадали, и это полезное чтение: карточка умения и кнопка в чате живут в разном календаре.
На схеме слева как раз та старая очередь. Справа один блок, куда текст, кадр и звук входят уже числами.
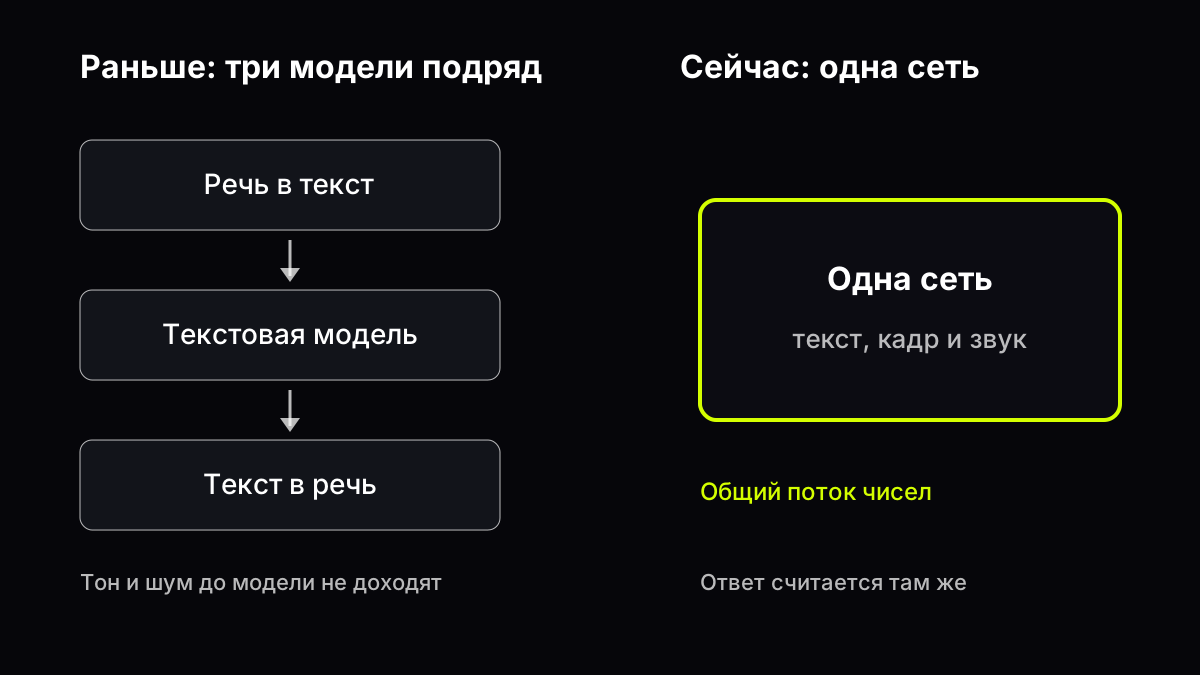
Источник: схема редакции по описанию голосового режима в анонсе OpenAI, 13 мая 2024
У той же GPT-4o в таблице токенизатора есть бытовая строка для русского. Фраза «Привет, меня зовут GPT-4o. Я — новая языковая модель, приятно познакомиться!» сжалась с 39 токенов до 23, в 1,7 раза. Это не про фото. Это про то, что даже внутри «текста» куски языка стоят по-разному, и русская фраза в том примере заняла заметно меньше места. Рядом в таблице гуджарати сжимается в 4,4 раза, английский лишь в 1,1. Когда позже считают, сколько токенов съела фотография доски, полезно помнить, что и слова в вопросе уже занимают место в том же окне.
Как фото становится рядом с текстом?
Токен — кусок, которым сеть шагает. Для текста это часто часть слова. Для картинки это лоскут, а не пиксель сам по себе. Окно — сколько таких кусков сеть держит вместе: вопрос, вложение и уже написанный ответ. Как токен и окно считаются в обычном текстовом чате, разобрано в материале про токены и контекстное окно. У Gemini 4 Argon в карточке от 13 октября 2026 общее окно входа и выхода до 1 миллиона токенов. У Gemini 3.8 Flash окно входа до 1 миллиона, а текст ответа до 64 тысяч токенов. Срез знаний Flash в той же карточке — март 2026, при этом по части областей знание остаётся на январе 2025, как у семейства Gemini 3. Окно при этом длинное, а память о мире внутри весов от этого длиннее не становится.
Anthropic описывает зрение Claude иначе, чем маркетинговая метафора «модель смотрит». Картинка режется на лоскуты по 28 на 28 пикселей, и каждый лоскут считается зрительным токеном, а не пикселем. Как кадр режут в классическом зрении, до разговорных моделей, разобрано в статье про компьютерное зрение. Форматы на платформенной странице — JPEG, PNG, GIF и WebP. У движущегося GIF берётся только первый кадр, анимация не идёт. На claude.ai в один ход кладут до 20 изображений. В программном интерфейсе предел 600 изображений на запрос, а у моделей с окном 200 тысяч токенов — 100. Длинную сторону, если она выше предела, уменьшают до обработки. У моделей Claude от поколения 4.7 и новее предел длинной стороны 2576 пикселей и до 4784 зрительных токенов. У остальных моделей 1568 пикселей и 1568 зрительных токенов. Если просить координаты таблицы или поля бланка, страница советует абсолютные пиксели, не доли от 0 до 1000. Ноль сидит в левом верхнем углу того изображения, которое сеть видит уже после уменьшения. Координаты с исходного снимка телефона без пересчёта поедут.
У Google на странице разрешения медиа, обновлённой 13 октября 2026, для моделей Gemini 3 и Gemini 4 задан потолок токенов на картинку. По умолчанию и на высокой ступени это 1120 токенов, на низкой 280, на средней 560, на сверхвысокой 2240, и сверхвысокая ступень есть только у картинок. Выше потолок — больше шанс прочитать мелкую подпись на графике и больше место в окне. Для обычного документа, по замечанию той же страницы, высокая ступень редко улучшает чтение текста. Мелкий чертёж и крупный слайд — разные случаи, одна «максимальная чёткость» на всё подряд окно только забивает.
Звук в той же таблице режется ровно, без ступеней разрешения: 25 токенов в секунду при любой из перечисленных ступеней. Слова вопроса садятся в то же окно рядом с этой дорожкой. Это ещё не видео. Видео на соседней странице считается своей формулой, и формулы двух страниц Google не совпадают. Об этом ниже, потому что студенческий ролик лекции почти всегда упирается именно в эту арифметику.
Смесь экспертов, которой подписана архитектура Argon, картинку не «понимает» отдельным экспертом-искусствоведом. Как и в текстовых моделях такого типа, на каждый кусок включается только часть блоков. Карточка называет Argon крупной разреженной смесью экспертов на основе трансформера и отдельно пишет, что перед нами новая модель, без дообучения предыдущей. Поддержка текста, зрения и звука на входе там названа изначальной, а выход в карточке ограничен текстом. Умение смотреть и умение рисовать в этом абзаце разведены специально: Argon в карточке смотрит, рисование живёт в других именах семейства.
Сколько места занимают фото и звук?
Документация понимания видео у Gemini обновлена 13 октября 2026. Модели с окном в 1 миллион токенов тянут ролик до 3 часов при низком разрешении медиа и до 1 часа при высоком. Дальше развилка на два режима.
Сплошной просмотр стоит по умолчанию. Кадры снимают с частотой 1 кадр в секунду, звук берут на 1 килобит в секунду одним каналом, метку времени ставят каждую секунду. Страница прямо предупреждает, что быстрое действие на такой частоте теряет детали. Рука на доске, которая за секунду дописала индекс, может попасть уже в следующий кадр или не попасть никак. Для короткого опыта, где важен каждый кадр, этот режим как раз и советуют. Для лекции на сорок минут он дорог по окну.
Подсчёт на той же странице такой. Кадр при низком разрешении — 66 токенов, иначе 258 токенов, частота всё та же, один кадр в секунду. Звук дорожки — 32 токена в секунду, и служебные поля, итого около 100 токенов на секунду ролика при низком разрешении и около 300 при высоком. Там же назван и предел длины: до трёх часов при низком разрешении и до часа при высоком, у моделей с окном в 1 миллион токенов.
Режим по запросу, в документации он подписан словом agentic, устроен иначе. Сеть не кладёт весь ролик в окно сразу. Она ходит по времени, подгружает расшифровку, нужный кусок кадров или звук. Для длинного материала Google пишет экономию до 88% токенов против сплошного просмотра. На ролике короче пяти минут и на вопросе вроде «расскажи всё» навигация может, наоборот, увеличить ожидание первого токена и общий расход. Токены хождения по ролику считаются токенами размышления, подгруженные кадры и звук — токенами инструментов. Режим указан для Gemini 4 Argon, Gemini 3.8 Flash, 3.6 Flash и 3.5 Flash Lite. Момент в вопросе просят писать как минуты и секунды, например 01:15. Если в запросе один ролик и текст, текст ставят после ролика.
Рядом лежит страница разрешения медиа, и числа на ней другие. Для видео низкая и средняя ступень совпадают и дают 70 токенов на кадр, высокая — 280. Звук там 25 токенов в секунду, а не 32. Высокую ступень страница советует, когда в кадре плотный текст или мелкая деталь. Для узнавания действия хватает низкой. Склеивать 66 и 70 в одну «официальную цену кадра» нельзя. Это две инструкции одного разработчика, обновлённые в один день, 13 октября 2026, и они расходятся. В статье обе оставлены как есть. Если ответ ссылается на «ровно столько-то токенов за ваше видео», он уже выдумал точность, которой нет даже у автора документации.
На LVBench, тесте понимания длинного видео, карточка Gemini 3.8 Flash за сентябрь 2026 даёт 87,8% в режиме по запросу и 87,1% при сплошном просмотре. Анонс Argon от 30 сентября 2026 называет 91,7% и говорит, что это лучший известный результат на этом тесте. Оба числа — замеры разработчика, не независимый экзамен и не обещание, что ваша лекция разберётся так же. На CharXiv, рассуждении по сложным графикам без инструментов, у Flash в той же карточке 86,2%. График из методички и мелко снятый график с проектора — разный вход, даже если название теста звучит близко.
Что умеют карточки ноября 2026 года?
Карточка Gemini 3.8 Flash от 2 сентября 2026 перечисляет входы коротко. Строки текста, изображения, звуковые файлы и видео, окно до 1 миллиона токенов. Выход — текст до 64 тысяч токенов. Модель продолжает линейку 3.7 Flash. В ограничениях названы выдумки, возможные задержки и привычка тратить больше токенов на высокой тщательности, и этот список стоит читать до первого снимка доски. Длинное окно не отменяет выдумку про то, чего на слайде не было.
Карточка Gemini 4 Argon от 13 октября 2026 описывает семейство Gemini 4 как изначально мультимодальные рассуждающие модели. Входы те же по видам: текст, изображения, звук, видео, общее окно входа и выхода до 1 миллиона токенов. Выход карточки снова текстовый. В анонсе 30 сентября предел ответа как раз и расширяли до 1 миллиона токенов с прежних 64 тысяч. Для визуальной работы Google отдельно пишет про профессиональные графики, детали длинных видео и действие по серии документов. Кибербезопасность и длинный код в том же анонсе занимают больше места, чем фотографии. Мультимодальность там средство для длинной работы, а не отдельный аттракцион «покажи, что на картинке».
Обе модели уже доступны в чате GPThub. Карточка на сайте есть у Gemini 3.8 Flash, разбор Argon лежит в отдельной статье. Выбор «какую звать на конспект, какую на длинный разбор» лучше сверять с гайдом, как выбирать модель, а не с лозунгом «мультимодальная значит умнее». Текстовая сила и умение читать доску в карточках измеряются разными таблицами.
Claude в этой компании смотрит картинки лоскутами и хорошо держит координаты, если их просить правильно. Звуковой вход в процитированной платформенной странице зрения не обещан, потому что страница говорит только про изображения. Путать «Claude видит фото» и «Claude слышит лекцию» по одному документу нельзя. У Gemini звук на входе в карточке назван прямо.
GPT-4o остаётся исторической точкой, а не текущей карточкой ноября. Её вклад в бытовое понимание слова «мультимодальный» большой. Одна сеть вместо трёх, и честное признание, что в день анонса открыта только часть умений. В том же анонсе оценки по кибербезопасности, опасным материалам (химия, биология, радиация и ядерное), убеждению и самостоятельности модели не выходят выше среднего уровня ни в одной категории. К чтению конспекта это относится косвенно. Модель, которая смотрит на фото, всё равно остаётся генератором правдоподобного текста.
Проверка каталога и карточек для этого текста — 2 ноября 2026 года.
Где мультимодальная нейросеть ошибается?
Первая ошибка сидит в частоте кадров. Сплошной режим смотрит один раз в секунду. Опыт с падающим шариком, быстрый вывод формулы, лист, который перевернули за долю секунды, в этот зазор проваливаются. Режим по запросу может поднять частоту на коротком куске, но только если вопрос этот кусок называет. Вопрос «что там вообще было» такого куска не называет.
Вторая ошибка — мелкий текст и дальний проектор. Потолок токенов на кадр ограничен. Снимок всей аудитории, где доска занимает десятую часть кадра, отдаёт на формулы крошечный лоскут. Карточка Flash прямо говорит, что модели этого класса выдумывают. Выдумка на фото выглядит увереннее, чем выдумка в абзаце. Буквы «похожи на греческие», индекс «наверное двойка», стрелка «куда-то вправо». Проверка здесь одна и короткая: переписать формулу своей рукой и сравнить со снимком, а не с пересказом.
Третья ошибка — звук без картины и картина без звука. Если отдать только дорожку, сеть не видит, что лектор показывает на нижний ряд. Если отдать только кадры без звука, она не слышит оговорку «это неверная запись, сейчас сотру». В статическом режиме звук ещё и сжат до 1 килобита в секунду и одного канала. Шёпот с задней парты и два голоса сразу для такого сжатия плохой материал. На странице разрешения медиа звук стоит 25 токенов в секунду, на странице видео — 32. В обоих случаях минута звука остаётся короткой полоской чисел. Смысл всей лекции в неё не помещается.
Четвёртая ошибка — координаты. Просьба «обведи долю от 0 до 1000» для Claude, по их странице, работает хуже абсолютных пикселей. И даже абсолютные пиксели относятся к уже уменьшенному кадру. Рамка, снятая с ответа и наложенная на исходный файл телефона без пересчёта, съезжает. Для бланка и для таблицы на слайде это ломает весь смысл просьбы.
Пятая ошибка — подмена задачи. Модель встраивания скажет, что два кадра близки, и не объяснит доказательство. Модель рисунка нарисует похожую схему и не обязана сохранить ваши обозначения. Текстовый ответ Gemini обязан остаться текстом, даже если очень хочется «перерисуй слайд». Перерисовка — другой маршрут, его лучше не смешивать с проверкой конспекта в одном запросе.
Шестая ошибка старше всех технических. Человек верит ответу, потому что рядом лежит его собственное фото. Снимок создаёт чувство улики. Сеть при этом по-прежнему продолжает ряд чисел. Срез знаний Flash местами заканчивается январём 2025. Формула с доски может быть вчерашней, а пояснение «это теорема такого-то из статьи 2026 года» — уже из весов, и веса про этот год молчат. Дата на слайде и дата в ответе сверяются отдельно.
Что проверить в ответе на учебном фото?
Ниже не инструкция по кнопкам. Это список того, что в ответе либо есть, либо ответ лучше выбросить. Готовые длинные запросы для картинок живут в гайде, здесь только смысл проверки.
Снимок доски с формулой. В вопросе имеет смысл попросить переписать выражение символ в символ и отдельно сказать, какой символ неразборчив. В ответе хорошо, когда неразборчивое названо неразборчивым, и плохо, когда каждый индекс заполнен «по смыслу». Сверьте три вещи сразу: число строк, имя переменной, которую вы сами написали, и знак, в котором чаще всего путают равенство и приближение.
Снимок графика из методички. Попросите назвать, что на осях, в каких единицах и где подпись серии, если она читается. Число 86,2% на CharXiv относится к графикам, которые собирали для теста, при хорошем разрешении и без инструментов. Ваш телефонный кадр под лампой в это число не входит. Если модель называет точку на кривой с точностью до третьего знака, а на фото сетки нет, цифра лишняя.
Короткий ролик опыта. Назовите интервал в виде минут и секунд и спросите, что изменилось между ними. Для сплошного режима помните про один кадр в секунду. Если шарик пролетел между двумя кадрами, честный ответ — «на этих кадрах его не видно», а не траектория из учебника. Траекторию из учебника модель и так помнит. Она не доказательство того, что произошло на столе.
Звуковая заметка с семинара. Попросите цитату и тайминг, а не «основные мысли». Мысли сеть соберёт из знакомого курса, даже если диктофон записал соседнюю тему, а цитату можно переслушать. Минута звука у Gemini по двум их страницам стоит либо 25, либо 32 токена в секунду. Место в окне съест не минута, а привычка приложить часовую запись целиком и спросить «конспект». На длинном ролике как раз и задуман режим по запросу, с экономией до 88% токенов на длинной форме. Короткий клип он может сделать дороже, это тоже написано у разработчика.
Чужой слайд с мелким нижним колонтитулом. Крупный кадр слайда лучше дальнего кадра экрана в аудитории. Высокая ступень разрешения у Google нужна именно для плотного текста и мелкой детали, и даже она, по их заметке про документы, не всегда добавляет точности обычному чтению. Если в ответе появился номер гранта или фамилия, которой на слайде нет, это выдумка, а не «модель догадалась по шрифту».
Серия из нескольких фото, например три доски подряд. Claude принимает пачку изображений, до двадцати на один ход на claude.ai. Порядок досок в вопросе лучше проговорить словами: первая, вторая, третья. Иначе сеть может склеить вывод со второй доски с условием с первой и получить гладкое доказательство, которого занятие не содержало.
Во всех этих случаях полезен один и тот же приём. Оставьте в вопросе место для отказа. «Если символ не читается, так и напиши». Карточки не обещают, что отказ сработает всегда. Flash в ограничениях пишет, что выдумки остаются. Приём хотя бы делает пустое место видимым, когда модель им пользуется.
Gemini 3.8 Flash для такого просмотра снимка уже открывается в чате GPThub. Длинный разбор ролика и спор двух моделей имеет смысл начинать с текста задачи, а не с веры в слово «мультимодальная» на витрине. Разбор самой Flash как раз про то, где у неё длинная работа, а где обычный ответ.
Что будет дальше с этим словом?
Слово в поиске живёт дольше, чем схема внутри сети. CLIP в 2021 году сводил кадр и подпись. Flamingo в 2022 году отвечала текстом на картинку и видео с несколькими примерами в запросе. GPT-4o в 2024 году собрала текст, зрение и звук в одной сети и одновременно показала, что продукт открывает умения по частям. Карточки сентября и октября 2026 года у Gemini снова ставят текст, изображение, звук и видео на один вход и оставляют ответ текстом. Рисунок и ролик на выходе существуют, но под другими именами и с другими пределами длины.
Практический вывод для учёбы короткий. Мультимодальная модель ИИ полезна там, где улика уже лежит файлом: доска, график, кусок записи. Она слабее там, где файл плохой, кадр редкий, а ответ хочется с точностью, которой на снимке нет. Если в новости написано, что новая сеть «видит и слышит как человек», откройте карточку и найдите три строки. Что перечислено на входе. Что обещано на выходе. Сколько кадров в секунду забирает просмотр ролика. Эти три строки обычно короче анонса и полезнее его.
Вопросы и ответы
Что такое мультимодальная модель?
Это обученная сеть, которая принимает больше одного вида данных за один проход. Обычно к тексту добавляют фото, звук или видео. Ответ может быть текстом, даже если вход был картинкой. Так устроены карточки Gemini 3.8 Flash и Gemini 4 Argon. Модель встраивания, которая только ищет похожие файлы, тоже мультимодальная, но она не пишет объяснение.
Что такое мультимодальный ИИ?
В быту так называют и одну сеть, и всю связку программ вокруг неё, и различие лучше держать явным. Область занимается несколькими видами сигналов, а мультимодальная нейросеть — уже конкретная модель. Система может снаружи выглядеть так же, а внутри по-прежнему гонять три отдельные сети, как голосовой режим до GPT-4o.
Чем мультимодальная модель ИИ отличается от обычного чата?
Обычный чат на тексте видит только символы, которые вы набрали или которые кто-то заранее расшифровал из речи. Мультимодальная модель получает ещё и числа из снимка или из звука и считает их вместе с вопросом. Если расшифровку сделала другая программа, тон и шум до чата не доходят. Это ограничение OpenAI описал на примере старого голосового режима.
Что такое мультимодальные системы ИИ?
Система — несколько частей. Загрузка файла, нарезка кадров, сама сеть, проверка ответа. Мультимодальной систему называют, когда части имеют дело с разными видами данных. Одна сеть внутри неё может быть мультимодальной, а может получать уже готовый текст от распознавателя речи. Снаружи оба варианта выглядят как «задал вопрос голосом».
Мультимодальная нейросеть понимает видео целиком?
Нет, если под «целиком» иметь в виду каждый кадр плёнки. Сплошной режим Gemini берёт 1 кадр в секунду. Час видео при высоком разрешении у моделей с окном 1 миллион токенов — верхний предел, три часа — при низком. Режим по запросу подгружает куски и на длинном ролике тратит до 88% меньше токенов. Быстрое движение между отобранными кадрами всё равно можно пропустить, если вопрос не указал момент.
Это то же самое, что генерация картинок?
Связь текста и картинки есть в обе стороны, но изделия разные. Разбор вашего фото отвечает текстом о том, что на фото уже есть. Генерация собирает новое изображение по описанию и легко меняет подписи и числа. Для учёбы их лучше не смешивать в одном запросе. Про сборку кадров отдельно написано в материале о нейросетях для видео.
Связанные модели

Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- Hello GPT-4o, OpenAI, 13 мая 2024
- CLIP, Learning Transferable Visual Models From Natural Language Supervision, arXiv, 2021
- Flamingo, блог Google DeepMind, 28 апреля 2022
- Карточка Gemini 3.8 Flash, Google DeepMind, 2 сентября 2026
- Карточка Gemini 4 Argon, Google DeepMind, 13 октября 2026
- Анонс Gemini 4 Argon, блог Google, 30 сентября 2026
- Понимание видео, документация Gemini, обновление 13 октября 2026
- Разрешение медиа, документация Gemini, обновление 13 октября 2026
- Gemini Embedding 2, блог Google, 10 марта 2026
- Зрение Claude, документация платформы Anthropic
- Координаты на изображениях Claude, документация платформы Anthropic
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.