
Нейросеть для научных статей: обзор без выдуманных источников
Обозреватель: ИИ в работе
Содержание
Объяснение у всех наготове. Нейросеть для научных статей будто уже читала полку и может собрать обзор за вечер. Я тоже так думала, пока не открыла письмо в The Lancet от 9 мая 2026 года. Там не спор о вкусе текста. Там счёт ссылок, которых нет ни в одном каталоге. Дальше речь о том, кому этот счёт мешает сдать рукопись, а кому можно спокойно просить модель только о языке.
Нейросеть для научных статей и где ломается обзор
Запрос «нейросеть для научных статей» обычно значит одну из трёх бытовых задач. Человек хочет найти, что уже написано. Хочет разложить чужой текст по полочкам. Хочет, чтобы черновик введения звучал ровнее.
С первой задачей модель справляется хуже, чем кажется по гладкому ответу. Она не листает вашу библиотеку, если вы не приложили файлы. Она продолжает фразу так, как похожие фразы продолжались в обучении. Название журнала, год и фамилия складываются в знакомую форму. Форма может совпасть с живой статьёй. Может и не совпасть.
Со второй задачей проще, если статья уже у вас на столе. Вы вставляете абзац и просите коротко сказать, что утверждают авторы и на каких данных. Здесь модель держится за ваш текст. Ошибка всё равно бывает. Цифра из соседнего предложения переезжает в вывод. Условие опыта выпадает.
С третьей задачей, с языком, журналы как раз спокойнее. Редакция Nature Methods 11 февраля 2026 года напомнила авторам семейства Nature. Помощь с написанием и с правкой читаемости допустима. Её надо указать в разделе методов. Модель при этом не может стоять в списке авторов. Ей не на кого повесить ответственность за текст.
Я сверила эти три задачи со страницами, которые открываются без подписки на полный текст. Письмо Topaz и соавторов в The Lancet. Новость Nature от 8 мая 2026 года об этом письме. Страница правил Nature Neuroscience про искусственный интеллект. Заметка OpenAI от 4 сентября 2025 года о том, почему модели выдумывают. И их же отчёт от 20 ноября 2025 года про ранние научные пробы GPT-5.
Обычно это объясняют двумя причинами
Модель «плохо обучена на науке». Так говорят, когда ссылка разваливается на узкой теме. Доля пустых ссылок и правда прыгает от темы к теме. В обзоре психиатрических запросов, о котором написал PsyPost 20 ноября 2025 года, проверяли GPT-4o. Работа вышла в JMIR Mental Health. Из 176 ссылок 35 были целиком выдуманы. По хорошо изученной депрессии выдумок было около 6 процентов. По более редким состояниям доля доходила почти до 30. Это одна модель, три темы и по одному ответу на запрос. Он показывает разброс, не закон природы.
Виноват только автор, который поленился. Лень встречается. Но письмо в Lancet описывает уже напечатанные статьи, а не черновики на кухне. С 1 января 2023 года по 18 февраля 2026 года авторы прогнали открытую часть PubMed Central. В выборке 2 471 758 статей и 125 615 773 оформленных ссылок. Проверяли те, у которых был идентификатор PubMed. Таких набралось 97,1 миллиона. Не нашлось 4046 ссылок в 2810 статьях. В 2023 году хотя бы одна такая ссылка была примерно в одной статье из 2828. В 2025 году уже в одной из 458. За первые семь недель 2026 года в одной из 277. Авторы оценивают рост примерно в 12 раз. У 91 процента затронутых статей таких ссылок одна или две. Причину авторы не сводят к одной: это могут быть выдумки моделей, фабрики статей или намеренная подтасовка.
Комментарий Howard Bauchner в том же номере уточняет метод. Ссылку сверяли с PubMed, Crossref, OpenAlex и Google Scholar. То, чего нет ни в одной из четырёх баз, пометили как выдуманное. Опечатку в фамилии старались не путать с пустым названием. Nature в новости от 8 мая 2026 года передаёт масштаб так. Почти 3000 биомедицинских статей с поддельными ссылками. 13 мая редакция поправила себя. Смотрели открытый набор PubMed Central, не всю базу PubMed.
Отдельно стоит работа в PNAS, вышедшая 26 октября 2026 года. Там другая выборка. Те же авторы из Колумбийского университета взяли полмиллиона статей по физике, химии, материаловедению, инженерии и информатике. Проверяли 21,6 миллиона ссылок с цифровым идентификатором. Автоматический разбор пометил 1135 ссылок в 619 статьях. На закрытой проверке экспертов точность метки была 85,8 процента. «Выдумано» здесь значит, что автоматическая сверка не нашла работу. Это про проверяемость, не про злой умысел. Доля затронутых статей выросла с 1 на 1600 в 2023 году до 1 на 650 в 2025 году и 1 на 435 в первом квартале 2026 года. По полям разброс большой. 25,6 на 10 000 статей в физике и 4,3 в химии. Авторы прямо пишут, что по времени это совместимо с разными причинами. Участие языковой модели из этих цифр само не следует.
Третья картина, уже из информатики. Препринт GhostCite на arXiv, вторая версия от 14 мая 2026 года. Авторы гоняли 13 моделей на выдумывании ссылок в 40 областях информатики. Доля галлюцинаций у моделей шла от 14,23 процента до 94,93 процента. Нижняя отметка в их таблице у DeepSeek. Верхняя у Hunyuan. По архиву конференций они смотрели 56 381 статью и 2 199 409 ссылок за 2020–2025 годы. После ручной проверки осталось 739 негодных ссылок в 604 статьях. Это 1,07 процента статей. В 2025 году темп негодных ссылок был на 80,9 процента выше среднего за 2020–2024 годы. Опрос в той же работе. Из 94 пригодных анкет, всего их было 97, 41,5 процента исследователей вставляют BibTeX, не открывая работу. 76,7 процента рецензентов не проверяют список тщательно.
Три замера нельзя сложить в одну «среднюю ложь модели». У них разные знаменатели. Письмо Lancet считает уже напечатанную биомедицину. PNAS считает другие поля и другую планку «не нашлось». GhostCite отдельно мерит сами модели и отдельно архив конференций. Для человека, который пишет обзор, хватает общего вывода. Гладкий список литературы ещё не список живых работ.
Что журнал просит от автора
Страница Nature Neuroscience сейчас устроена как светофор. Правила общие для авторов, рецензентов и редакторов. Ответственность за содержание на модель не переносится ни при каком цвете.
Зелёный уровень разрешён. Полировка языка, подсказка структуры разделов, перевод, чистка данных от дублей. Раскрывать такую помощь там советуют, потому что это добавляет доверия.
Жёлтый уровень требует осторожности. Сюда попали черновые пересказы, сравнение результатов с уже вышедшей литературой и обширная правка текста. Можно, но с проверкой человеком и с раскрытием.
Красный уровень запрещён. Выдуманные данные, ссылки или результаты. Модель в списке авторов. Рецензия, целиком отданная модели. Выводы модели, выданные за свои.
Рецензенту та же страница запрещает загружать рукопись в открытые сервисы и просит указать в отзыве, если инструмент помогал.
Редакция Nature Methods от 11 февраля 2026 года говорит то же человеческим языком. Семейство разрешает помощь с кусками текста и с правкой читаемости. Об этом пишут в методах. Текст модели нельзя брать как есть. Его проверяют и правят. Рецензенту нельзя загружать рукопись в такой инструмент.
Nature Computational Science 20 августа 2026 года добавляет две строки. Приписать авторство модели строго запрещено. Картинки, созданные моделью, не принимают из-за неясных прав и происхождения, кроме работ, где сама модель предмет исследования. Раскрытие использования просят класть в методы, с достаточной подробностью. Чтобы рецензент понял, какую роль инструмент сыграл и в исследовании, и в подготовке рукописи.
Это не юридическая консультация и не разбор вашего договора с конкретным журналом. У другого издателя формулировка может быть уже. Перед сдачей откройте страницу правил именно того журнала, куда идёт рукопись.
Как выглядит выдуманный источник
Живая ссылка ведёт на страницу. У страницы есть название, авторы, год и обычно цифровой идентификатор или номер в PubMed. Выдуманная ссылка выглядит так же. Фамилия настоящая. Журнал настоящий. Год правдоподобный. Страницы нет.
Письмо в Lancet как раз описывает этот вид ошибки. Ссылку не нашли после сверки с несколькими каталогами. Комментарий Bauchner честно ограничивает выборку. Смотрели открытый набор. Журналы вне него, с сильной редакцией, в этот счёт не попали. Значит, цифра не про «всю мировую науку». Она про большой открытый кусок биомедицины, и уже там рост виден.
OpenAI 4 сентября 2025 года объясняет механизм без научных украшений. Галлюцинация для них это уверенный ответ, который неверен. В обучении и в экзаменах угадывание часто выгоднее, чем честное «не знаю». Поэтому модель договаривает. Они же пишут, что у GPT-5 таких ошибок меньше, особенно когда она рассуждает дольше. Как устроен такой режим, объясняет статья рассуждающие модели. Ошибки при этом остаются. Это общая беда больших языковых моделей, не особенность одной кнопки.
20 ноября 2025 года та же компания выложила ранние научные пробы с GPT-5. Среди пользы они сами называют обзор литературы, ускорение тяжёлого счёта и новые наброски доказательств. Следом идёт ограничение, которое стоит процитировать по смыслу близко к тексту. Присмотр специалиста обязателен. GPT-5 иногда выдумывает ссылки, механизмы или доказательства, которые выглядят убедительно. Она чувствительна к тому, как её раскачали примерами. Она пропускает тонкости области. Она может долго идти по тупиковой линии, если её не поправить.
Почему модель вообще договаривает несуществующее, подробно разобрано в статье почему нейросеть выдумывает. Для обзора это значит простую вещь. Модель может помочь вспомнить, какие споры вообще бывают в теме. Список в ответе ещё не библиография. Его проверяют так же, как цитату из чужого конспекта.
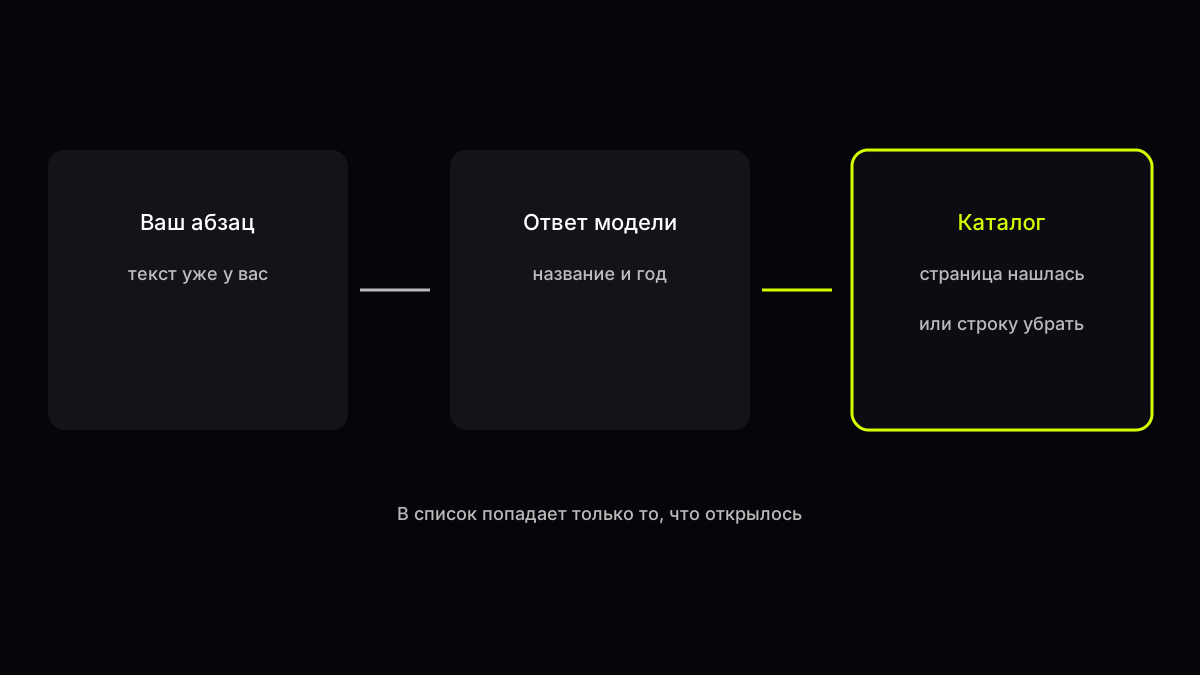
Источник: схема по письму Topaz и соавторов в The Lancet, 9 мая 2026, и по правилам Nature Neuroscience. Числа на схему не вынесены.
Что проверить до того, как ссылка попадёт в текст
Вам понадобится ответ модели и любой каталог, где статья обязана находиться. PubMed, страница издателя, Crossref. Хватит одного, если название и авторы совпали дословно. Если не совпали, смотрите второй.
- Выпишите из ответа только название, авторов и год. Адрес, который модель сама подставила, отложите. Его легко собрать из кусков.
- Вставьте название в кавычках в поиск каталога. Совпало целиком. Откройте страницу и прочитайте аннотацию.
- Сверьте год, журнал и порядок авторов. Одна неверная цифра в годе часто значит другую статью тех же людей.
- Проверьте, что фраза в вашем обзоре правда есть в аннотации или в открытом тексте. Модель любит усилить вывод.
- Если страницы нет, строку выбрасывайте. Не чините её «похожей» статьёй молча. Похожая статья говорит другое.
- В методах или в сопроводительном письме напишите, какую модель звали и зачем. Язык, структура, поиск формулировок. Конкретную форму сверит инструкция журнала.
Типичные сбои я видела прямо в описаниях этих аудитов, не в чужих байках.
Модель ставит реальную фамилию на выдуманное название. Поиск по фамилии что-то находит, и рука расслабляется. Искать надо по названию.
Модель даёт правильную статью и неверный вывод. Страница открывается. Смысл в обзоре уже уехал. Лечится чтением аннотации, не вторым запросом «подтверди».
Модель сужает тему так сильно, что живых работ мало, и она дописывает недостающее. В том психиатрическом замере узкий обзор по цифровым вмешательствам при переедании дал 46 процентов выдуманных ссылок. Общий обзор той же темы дал 17 процентов. Узкий запрос не делает ответ честнее.
Рецензент или соавтор вставляет файл BibTeX пачкой. GhostCite как раз фиксирует, что так делает заметная доля опрошенных. Пачка не освобождает от открытия хотя бы тех работ, на которых держится вывод.
Если рукопись нельзя выносить за пределы лаборатории, черновую работу с текстом можно делать на своём компьютере. Как это устроено, есть в статье локальная нейросеть. Ссылки она выдумывает так же, сверка остаётся.
Отдельная граница для России здесь бытовая. Многие журналы открывают аннотацию без оплаты. Полный текст часто закрыт. Для проверки «статья существует» аннотации и страницы издателя хватает. Для проверки «авторы правда так написали» нужен полный текст или честное сужение фразы до того, что видно в аннотации. Если полного текста нет, в обзоре так и пишите. Иначе вы пересказываете пересказ модели.
Как формулировать сам запрос, без пошагового учебника, разобрано в гайде как писать запросы. Коротко для этой задачи хватает четырёх ограничений в одном сообщении. Опирайся только на текст, который я вставил. Если работы не знаешь точно, напиши, что не уверен. Не добавляй список литературы, пока я не попрошу. Каждое утверждение помечай, из какого абзаца оно взято.
Сравнить два ответа на одном и том же абзаце удобнее в новом диалоге, чем в длинной переписке. Как не смешать модели в одной куче, есть в гайде сравнение моделей на практике.
Какая нейросеть лучше для написания научных статей
Фразы из поиска обещают одну победительницу. «Лучшая нейросеть для написания научных статей». «Какая нейросеть лучше для написания научных статей». По открытым замерам победителя нет.
GhostCite показывает разброс между моделями в разы. Нижняя доля выдуманных ссылок в их тесте всё ещё двузначная. OpenAI пишет, что у более новой модели ошибок меньше, и тут же оставляет обязанность человека. Значит, выбор кнопки не заменяет сверку.
Для бытового текста я бы смотрела на три разные работы, которые уже лежат в обычном чате.
Длинный аккуратный разбор абзаца, где важно не потерять оговорку, чаще просят у сильной модели с длинным ответом. В чате GPThub на 1 ноября 2026 года для этого открывается Grok 4.5. Карточка описывает саму модель. Она не обещает библиографию.
Короткий пересказ и черновой план, когда статья уже у вас в буфере, нормально отдать модели полегче и быстрее. Про семейство, которое как раз ставят на повседневный текст, есть разбор что такое DeepSeek. В том же чате для коротких заходов берут и Gemini 3.8 Flash. Чем эта ветка отличается по характеру ответа, видно в заметке Gemini 3.8 Flash.
Нейросеть для поиска научных статей в этом наборе не заменяет каталог. Просите её предложить поисковые слова, синонимы и слишком широкие формулировки, которые вы потом несёте в PubMed или на сайт издателя. Готовый список «вот десять главных работ» без страниц я бы не сохраняла.
Нейросеть для анализа научных статей полезна на другом шаге. Одна статья открыта. Вы просите разложить вопрос, данные, сравнение и ограничение. Потом сами смотрите, не приписала ли модель таблице то, чего в ней нет. Две модели на одном абзаце полезны именно здесь. Расхождение это повод открыть файл, а не повод голосовать большинством.
Нейросеть для написания научной статьи, если говорить честно, пишет черновик языка и структуры. Положение, которое вы защищаете, и список, на котором оно стоит, остаются вашими. Иначе вы попадёте в ту долю напечатанных статей, которую Lancet уже посчитал.
Что это значит на практике, если убрать догадки
Студенту, который учится читать обзор, беспокоиться стоит о списке в конце. Каждый пункт либо открывается, либо его нет в работе. Преподавателю обычно важнее второе. Гладкий язык при пустых ссылках читается как чужая пачка.
Исследователю, который уже ведёт свою полку в менеджере ссылок, модель безопаснее на краях. Синонимы для поиска. Черновик абзаца из ваших же тезисов. Проверка, не противоречит ли новый абзац предыдущему. Опасный край один. «Допиши литературу по образцу». Этот запрос как раз кормит выдуманные строки.
Человеку вне академии, который ищет разбор для работы или для врача, чужой обзор с неоткрываемыми ссылками не стоит основы решения. Клинические рекомендации собирают люди по живым исследованиям. Письмо в Lancet прямо связывает пустую ссылку с выводом, у которого нет исследования под ним. Это не замена совету врача и не разбор вашего диагноза.
Поможет ли привычка «сначала каталог, потом абзац» каждому журналу одинаково, честно, пока не знаю. Правила Nature я прочитала. У вашего издания может быть более узкий список разрешённых помощников. Если редакция опубликует новую общую формулу, этот текст придётся обновить.
Если повторять одну бытовую проверку, я бы оставила её такой. Название в кавычках. Страница открылась. Аннотация говорит то же, что ваша фраза. Только после этого строка живёт в рукописи.
Отдельный вечер уходит не на поиск кнопки, а на развилку внутри одного абзаца. Модель пишет три предложения подряд. Первое пересказывает ваш тезис и почти не врёт. Второе добавляет цифру, которой во вставленном фрагменте не было. Третье ставит ссылку на обзор с правдоподобным годом. Вычёркивать нужно второе и третье, даже если первое удачное. Иначе в рукопись уезжает смешанный абзац. Половина ваша, половина договорена моделью. Такой абзац труднее ловить, чем список целиком из воздуха. Рецензент видит знакомую фамилию и идёт дальше.
Полезный признак догадки простой. В предложении есть процент, название когорты или имя метода, а в вашем файле этих слов нет. Попросите модель показать, из какой строки вставленного текста взята фраза. Если она цитирует саму себя или «общеизвестный факт», фразу убирайте. Обзор литературы как раз собирается из таких фраз. Одна лишняя цифра в середине раздела методов потом цитируется следующими авторами уже как ваша.
Для поиска формулировок, а не работ, запрос можно сузить ещё сильнее. «Дай десять поисковых словосочетаний на русском и на английском для каталога. Без статей. Без годов. Без фамилий.» Английские слова здесь не украшение. Каталоги биомедицины индексируют их лучше, чем бытовой перевод. Готовый английский список статей по-прежнему не нужен. Нужны слова, которые вы вставите в строку поиска сами.
Если статья на иностранном языке, а вы читаете её через модель, оставьте рядом оригинальное предложение. Короткий перевод полезен. Пересказ на полстраницы уже добавляет выводы, которых в абзаце не было. Я бы сверяла хотя бы те места, где переводчик-модель поставила «доказано» вместо «авторы предполагают». Эта подмена тише выдуманной ссылки и портит обзор не меньше. Журнал увидит гладкий русский текст. Смысл чужой работы уже сдвинут.
Напишите в ответ, если у вашего журнала в 2026 году появилась отдельная форма про модели. Интересно, просят ли они имя модели или хватает фразы «помощь с языком».
Вопросы и ответы
Какая нейросеть лучше для написания научных статей?
Лучшей по открытым тестам нет. В замере GhostCite все проверенные модели выдумывали ссылки, просто с разной частотой. Берите ту, которая аккуратно держит вставленный вами текст, и сверяйте каждую работу по каталогу. Для длинного разбора в чате GPThub удобно открыть Grok 4.5. Для короткого пересказа рядом есть DeepSeek и Gemini 3.8 Flash.
Есть ли нейросеть для поиска научных статей?
Поиск живых работ остаётся у каталогов. PubMed, сайт издателя, Crossref. Модель годится на шаг раньше. Она предлагает слова запроса и отсекает слишком широкие формулировки. Список «главных статей» без открытых страниц в рукопись не кладут.
Чем полезна нейросеть для анализа научных статей?
Она раскладывает уже открытую статью. Вопрос, данные, сравнение, слабое место. Вы проверяете, что каждая строка разбора есть в тексте. Две модели на одном фрагменте полезны, когда они расходятся. Тогда вы открываете абзац ещё раз.
Можно ли сдать нейросеть для написания научной статьи как соавтора?
В правилах Nature Neuroscience и в редакционных заметках Nature Methods и Nature Computational Science модель автором не ставят. Помощь раскрывают, обычно в методах. Выдуманные ссылки Nature Neuroscience относит к запрещённому уровню. Точную форму вашего журнала читайте у него на сайте.
Нейросеть для работы с научными статьями заменяет обзор литературы?
Она заменяет часть черновой писанины. Она не заменяет чтение работ, на которых стоит вывод. Аудит Lancet показывает, что пустые ссылки уже доходят до печати. Значит, рецензия не всегда их ловит. Последняя проверка остаётся на авторе.
Связанные модели

Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
Ещё по теме
Источники
- Topaz и соавторы. Fabricated citations: an audit across 2.5 million biomedical papers. The Lancet, 9 мая 2026
- Bauchner. Fabricated references: a new threat to editorial integrity. The Lancet, 9 мая 2026
- Naddaf. Surge in fake citations. Nature, 8 мая 2026
- Artificial Intelligence (AI). Nature Neuroscience, editorial policies
- Using AI responsibly in scientific publishing. Nature Methods, 11 февраля 2026
- Responsible and transparent use of AI. Nature Computational Science, 20 августа 2026
- Why language models hallucinate. OpenAI, 4 сентября 2025
- Early experiments in accelerating science with GPT-5. OpenAI, 20 ноября 2025
- GhostCite. arXiv:2602.06718, версия 2 от 14 мая 2026
- Evaluation of possibly fabricated references. PNAS, 26 октября 2026
- PsyPost о замере выдуманных ссылок в психиатрических обзорах, 20 ноября 2025
Об авторе
Обозреватель: ИИ в работе
Пишет о том, как нейросети меняют работу и где без человека не обойтись.
Как собрать запрос к модели
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.