
Локальная нейросеть: что значит запустить модель на своём компьютере

Обозреватель: как устроен ИИ
Содержание
В июле 2024 года Apple опубликовала технический отчёт о языковых моделях, которые питают Apple Intelligence. Среди них названа компактная модель примерно на три миллиарда параметров: она рассчитана на чипы Apple silicon и должна работать прямо на телефоне или ноутбуке, без постоянной отправки текста на чужой сервер. Это один из видов локального запуска, но не единственный. Когда в поиске пишут «локальная нейросеть», обычно имеют в виду скачанную модель и программу вроде Ollama или llama.cpp. Веса лежат на вашем диске, каждый ответ считает ваш процессор или видеокарта.
Что обычно путают с локальной моделью {#chto-putaют}
Самое частое сравнение звучит так: «локальная нейросеть это ChatGPT, только без интернета». Оно неверное по двум причинам. Во-первых, ChatGPT это сервис с закрытыми весами: вы не скачиваете модель OpenAI на диск и не управляете её обновлениями. Во-вторых, локальный запуск не обязан быть офлайн навсегда. Программа может при первом старте скачать гигабайты весов из сети, потом проверять обновления и при этом отвечать на запросы без отправки текста наружу.
Ближе к делу другая картина. Нейросеть на компьютере складывается из трёх частей: файлы весов, движок, который из них считает ответ, и оболочка, куда вы вводите текст или картинку. Веса это огромный набор чисел, полученный при обучении; без них «нейросеть» не существует, остаётся только пустая программа. Движок это llama.cpp, Ollama, ComfyUI для картинок и десятки других. Оболочка это окно чата, плагин в редакторе кода или скрипт.
Отдельно живут встроенные модели производителя. Apple в отчёте июля 2024 года описывает встроенную модель примерно на 3 млрд параметров с оптимизациями вроде общего KV-кэша и обучения с учётом двухбитного квантования. Пользователь не выбирает файл на Hugging Face, не крутит ползунок контекста. Это другой договор с устройством. Статья дальше про «сам собрал» на Windows, macOS или Linux.
Локальная нейросеть на компьютере: что происходит при запросе
Общая схема короткая: вы вводите текст, программа режет его на токены, модель по очереди угадывает следующий токен, пока не сработает стоп. Вся цепочка может идти на GPU, на CPU или частично там и там. Механика та же: это та же большая языковая модель, что стоит за облачным чатом, только хостинг другой.
Промежуточные результаты внимания складываются в KV-кэш. На коротком вопросе он маленький, на переписке в двадцать экранов и вложенном PDF растёт и может «съесть» память раньше, чем сами веса. Именно поэтому локальный запуск на ноутбуке с 16 GB оперативной памяти иногда упирается не в «слабую модель», а в слишком длинный контекст.
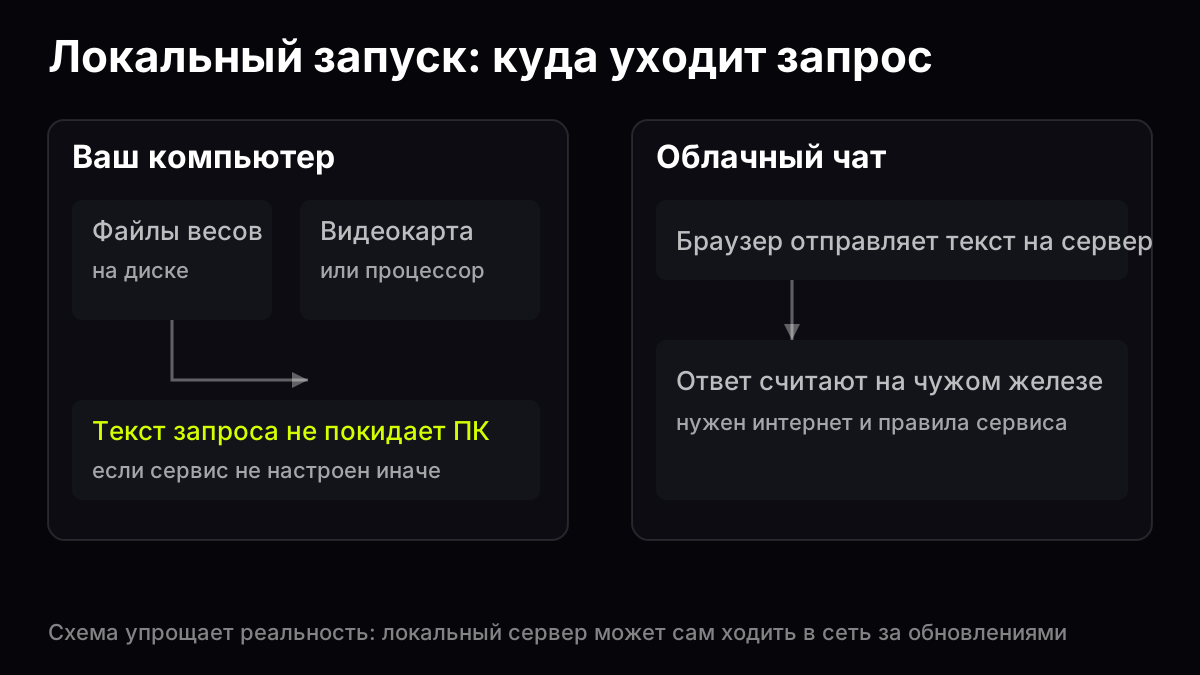
Схема локального и облачного запуска, иллюстрация GPThub
Параметр это одно число внутри модели. Токен это кусок текста в словаре модели. Окно контекста это сколько токенов учитывается за один запрос вместе с уже написанным ответом. Лимит ответа это сколько токенов модель может дописать за раз.
На диске важны и «размер модели в миллиардах параметров», и квантование, сжатие весов до меньшей точности, чтобы они поместились в память. В каталоге Ollama для Llama 3.2 у варианта 3B указаны загрузки порядка 2,0 GB и 1,3 GB. Это разные упаковки одной линейки, две отдельные программы тут ни при чём. На Hugging Face у Llama-3.2-3B в карточке указано около 3,21 млрд параметров в формате BF16; дома почти никто не хранит полный BF16, если цель обычный ноутбук.
Память — второе узкое место. Веса должны попасть в оперативную память или видеопамять, плюс растёт расход на длинный контекст. Поэтому фраза «скачал модель на 70 миллиардов параметров» без видеокарты с большим объёмом памяти часто заканчивается медленным ответом или ошибкой нехватки памяти — «мощный ChatGPT дома» так не появляется.
Типичные ошибки после установки
- Выбрали самую большую модель из списка «потому что лучше», не глядя на объём загрузки.
- Открыли длинный PDF в контекст и удивились падению скорости: память забрал KV-кэш внимания, размер файла на диске вторичен.
- Сравнили локальный черновик на 3B с облачной большой моделью и решили, что «локальные нейросети бесполезны». Сравнение было не по задаче.
- Забыли, что программа может слать телеметрию или тянуть обновления, даже если запросы не уходят на сервер модели.
Какие программы запускают текст локально
Три имени, которые стоит знать: Ollama, LM Studio и llama.cpp. README Ollama на GitHub описывает установку на macOS, Windows и Linux, Docker-образ и клиентские библиотеки; в первых строках сказано, что сервис даёт доступ к открытым моделям локально или в облаке, с акцентом на приватность локального режима. llama.cpp это проект с лицензией MIT, который в README называют «LLM inference in C/C++»: движок, на котором часто строят другие оболочки.
Ollama и LM Studio прячут детали: вы вводите короткую команду с именем модели, программа сама подтягивает веса. llama.cpp ближе к инженерному пути: скачать файл в формате GGUF, указать путь, настроить число потоков и слоёв на GPU. Для курсовой по развёртыванию второй путь поучительнее, для вечернего пересказа лекции первый обычно быстрее в старте.
Открытые веса лежат на Hugging Face и на сайтах разработчиков. У Meta в линейке Llama 3.2 есть компактные 1B и 3B; у DeepSeek открытые релизы описаны в статье про DeepSeek. Фраза «открытые веса» не означает «запустится на любом ПК». DeepSeek V4 Flash в карточке Hugging Face — 284 миллиарда параметров всего и 13 миллиардов активных на токен из-за смеси экспертов; MIT-лицензия разрешает скачивание, но домашнее железо всё равно отсеивает большинство машин.
Редактор кода и локальный сервер
Многие студенты ставят Ollama ради связки с редактором. Плагин шлёт запрос на 127.0.0.1, ответ возвращается в панель подсказок. Схема удобна для рефакторинга и генерации тестов, пока файлы не уходят наружу. Минус тот же, что у любого автодополнения: модель может предложить код, который компилируется, но делает не то. Локальность не заменяет прогон тестов.
Ещё один сценарий — домашний сервер в сети общаги или квартиры. Модель работает на старом системном блоке с видеокартой, а ноутбук только шлёт запросы по Wi‑Fi внутри квартиры. Текст формально не уходит к OpenAI, но уже живёт в домашней сети: запросы видит роутер, а при слабом пароле и сосед. Безопасность снова зависит от настройки роутера и паролей.
| Что выбираете | Плюс | Минус |
|---|---|---|
| Малая модель 1B–3B | часто хватает встроенной графики или CPU | слабее в рассуждении и фактах |
| Средняя 7B–8B в сжатии | баланс для текста на дискретной GPU | нужно следить за видеопамятью |
| Большая открытая MoE | качество ближе к облаку | серверная память, не ноутбук |
Требования к железу: что пишут сами разработчики
Единой таблицы «модель — видеокарта» нет, зато у программ есть официальные требования, и с них разумно начинать. Данные ниже взяты со страниц документации 1 ноября 2026 года; последняя версия Ollama на GitHub в этот день — 0.40.13, у LM Studio на странице загрузки — 0.4.28.
Ollama для Windows требует Windows 10 22H2 или новее (Home или Pro). Для видеокарт Nvidia нужен драйвер 551.61 или новее, для AMD — драйвер с ROCm v7 либо драйвер Radeon с поддержкой Vulkan. Сама установка занимает не меньше 4 ГБ, а модели, как прямо сказано в документации, могут весить от десятков до сотен гигабайт. Папку с моделями разрешено перенести на другой диск — полезно, если системный SSD маленький.
На Mac Ollama требует macOS Sonoma (14) или новее. На чипах Apple M считают и процессор, и графика, на старых Mac с Intel работает только процессор, то есть заметно медленнее. Под Linux есть скрипт установки, отдельный пакет для AMD и сборка для ARM64.
LM Studio — программа с привычным окном чата и встроенным поиском моделей. На Mac она поддерживает только Apple Silicon (M1–M4) и macOS 14.0 или новее; рекомендовано от 16 ГБ памяти, на 8 ГБ разработчики советуют брать маленькие модели и короткий контекст. Mac с Intel не поддерживаются. На Windows нужен процессор с инструкциями AVX2 (для x64), рекомендовано от 16 ГБ оперативной памяти и от 4 ГБ видеопамяти. Linux-версия выходит в формате AppImage и требует Ubuntu 20.04 или новее. Документация отдельно говорит, что после загрузки моделей программа работает полностью без сети.
Отсюда простой порядок проверки. Сначала версия системы и тип процессора, потом объём оперативной памяти, потом видеокарта и драйвер. Только после этого имеет смысл выбирать модель: на 8 ГБ — варианты на 1–3 млрд параметров в сжатом виде, на 16 ГБ и с дискретной картой — средние модели, дальше по возрастающей.
Пример: какую модель взять под конкретный ноутбук
Допустим, у вас MacBook на M1 с 8 ГБ памяти. LM Studio и Ollama на нём запустятся, но под модель останется лишь часть памяти: остальное займут система и браузер. Разумный старт — Llama 3.2 3B в сжатии (загрузка около 2 ГБ по каталогу Ollama) и контекст в несколько страниц. Попытка поднять модель на 70 млрд параметров закончится нехваткой памяти, сколько ни жди.
Другой случай — настольный ПК на Windows 11 с картой Nvidia на 8 ГБ видеопамяти и 32 ГБ оперативной. Здесь средние модели в сжатом виде обычно помещаются в видеопамять, и ответ идёт заметно быстрее, чем на процессоре. Первое, что стоит проверить, — версию драйвера: со старым драйвером Ollama посчитает всё на процессоре, и машина покажется медленной без видимой причины.
Китайские лаборатории выкладывают много открытых весов разного размера, от компактных до гигантских. Карта этих линеек есть в статье про китайские нейросети, а про семейство, где есть модели и под домашнюю машину, — в разборе что такое Qwen.
Что скачивают на диск
После команды «скачать модель» на диск попадают веса, один или несколько больших файлов. В мире llama.cpp их чаще всего хранят в формате GGUF: в одном файле лежат и параметры, и метаданные для загрузки. Ollama упаковывает по-своему, но смысл тот же. Папка может занимать больше места, чем кажется из названия «3B», потому что рядом лежат несколько квантований и служебные файлы.
Лицензия на веса отдельна от лицензии на движок. README llama.cpp на GitHub явно указывает MIT для самого движка. У Stable Diffusion XL Base 1.0 на Hugging Face указана openrail++. У DeepSeek-V4-Flash указана MIT, но лицензия не добавляет видеопамяти на вашем ПК. Перед использованием в проекте кафедры или стартапа текст лицензии читают целиком: там бывают ограничения на трафик, на медицину, на военное применение.
Обновление модели похоже на скачивание новой большой игры, а не на патч браузера на пять мегабайт. Вышла новая ревизия Llama или DeepSeek, и вы снова качаете гигабайты. Старый файл можно оставить для сравнения, но место на диске кончается быстро, если коллекционировать «лучшие локальные нейросети» без задачи.
Как понять, что модель действительно локальная
Признак первый: в диспетчере задач при генерации растёт нагрузка на ваш GPU или CPU, а не только трафик в браузере. Признак второй: можно отключить Wi‑Fi после загрузки весов и повторить тот же запрос. Признак третий: в настройках указан путь к файлам на диске или адрес локального сервера вроде 127.0.0.1, без обязательного входа на чужой сайт. Если запросы уходят на внешний домен, запуск уже не локальный, даже когда программа стоит на ПК.
Скорость, качество и честное сравнение
Локальный ответ измеряют словами «токенов в секунду», но публичной таблицы «ваш ноутбук против сервера» не существует. На CPU текст идёт медленно, зато без дискретной видеокарты. На GPU быстрее, пока модель помещается в видеопамять. При нехватке памяти движок переносит часть слоёв в оперативную память, и скорость падает резко.
Качество локальной малой модели на 1B–3B параметров на фактах и многошаговой математике обычно уступает большим облачным линейкам. Зато для черновика письма, перефразирования абзаца или проверки синтаксиса кода она может хватить. Сравнивать имеет смысл на одинаковой задаче и с одинаковой длиной контекста, иначе выводы будут про разное.
Память под длинный контекст растёт не линейно. Студент вставляет в запрос три лекции «на всякий случай», окно контекста забито, и модель начинает терять начало или отвечать медленнее. В облачном чате та же ловушка, но там хотя бы не ваш диск и не ваш блок питания шумит под нагрузкой.
Если нужна сильная модель без экспериментов с железом, проще открыть чат с Gemini 3.8 Flash или DeepSeek V4 Flash и прогнать те же три запроса из раздела практики. Разница станет видна за вечер.
Локальные нейросети для генерации картинок и видео
Локальная генерация изображений с открытыми весами началась с линейки Stable Diffusion. На Hugging Face у Stable Diffusion XL Base 1.0 указана лицензия openrail++. Схема та же: файл весов на диске, UI вроде Automatic1111 или ComfyUI, запрос текстом, результат в файл. Память снова ограничивает: кроме весов её съедают разрешение, пакетная генерация и увеличение картинки.
ComfyUI устроен как граф узлов: можно собрать цепочку «текст → картинка → апскейл → сохранить». Automatic1111 ближе к одному экрану с полями. Обе программы требуют времени на первую настройку — драйвер, версия CUDA или Metal, путь к файлу весов. Зато после настройки один и тот же запрос можно повторять, пока хватает терпения и электричества.
Для учебных постеров локальная картинка даёт контроль над повтором: тот же seed и тот же запрос дают близкий результат. Для баннера с точным логотипом бренда локальная модель чаще проигрывает — текст на вывеске ломается так же, как в облаке, только править дольше.
Локальная видеонейросеть в 2026 году для домашнего ПК остаётся отдельной историей. В материале про видеомодели разобрано, что облачные модели выдают клип из текста или картинки на чужом кластере. Локально те же идеи существуют в узких связках и экспериментальных сборках, но длина ролика, разрешение и время генерации на обычной GPU растут нелинейно. Практичный вывод: видео чаще генерируют в облаке, а локально держат текст и статичные картинки, если железо не игровое верхнего класса.
Если всё же пробуете видео дома, закладывайте время на охлаждение и на проверку кадров — руки, моргание, «плывущий» фон. Короткий клип на три секунды может считаться полчаса: так выглядит цена локального расчёта кадра за кадром.
Для картинок полезно заранее решить, что проверять в результате: пальцы и мелкий текст на вывесках, повторяющиеся паттерны. Метаданные съёмки не спасают: перед вами сгенерированная картинка. Советы по работе с генерацией в браузере собраны в гайде про картинки; локальную цепочку проверяют теми же глазами, только ждать дольше.
Когда локально, когда в чате
Локальный запуск выигрывает, если черновик нельзя отправлять наружу: медицинская тема в учебной работе, внутренний код, персональные данные в дипломе. Выигрывает, если интернет нестабилен, но модель уже скачана. Выигрывает, если вы учитесь инженерии вывода модели на своём железе и хотите понять, как квантование влияет на скорость.
Облачный чат выигрывает, когда нужна сильная модель без траты выходных на настройку драйверов и CUDA. Gemini 3.8 Flash и DeepSeek V4 Flash в GPThub закрывают большинство учебных задач: пересказ, код, подготовка к экзамену. Часто черновик гоняют локально на малой модели, финал отправляют в облако.
Практика: три запроса и что смотреть в ответе
Полная инструкция «как установить нейросеть локально» это формат гайдов, не этой статьи. Здесь мини-прогон, который показывает разницу качества и стабильности.
Запрос 1, факт без контекста. «В какой день недели было 29 февраля 2020 года в Москве? Покажи ход рассуждения в двух предложениях.» На малой локальной модели часто всплывает уверенный, но неверный день; в облачной Flash-линейке ошибка тоже возможна, но реже. Проверка: календарь вручную, не доверие к тону.
Запрос 2, код. «Напиши функцию на Python, которая проверяет, палиндром ли строка, если игнорировать пробелы и регистр. Без библиотек.» Смотрите на граничные случаи: пустая строка, один символ, unicode. Для кода локально удобна связка с редактором; критерии разбора задач в гайде для программирования.
Запрос 3, пересказ файла. Загрузите короткую лекцию на пять страниц и попросите список из семи тезисов без добавления фактов, которых нет в тексте. На локальной 3B модели чаще появляются «додуманные» тезисы; признак это формулировки, которых не было в файле. Проверка: поиск по PDF по ключевым словам из ответа.
Типичная ошибка практики это менять все три параметра сразу: модель, квантование и длину контекста. Меняйте одно, иначе не поймёте, что именно ускорило или испортило текст.
Российский контекст: железо, сеть, учёба
В России локальный запуск не запрещён сам по себе, но упирается в быт. Видеокарта с большим объёмом памяти — заметная покупка; на ноутбуке с интегрированной графикой остаются малые модели и терпение. Скачивание весов на десятки гигабайт через домашний интернет занимает часы — для общаги с лимитом трафика это аргумент в пользу облака.
Иногда выгоднее арендовать GPU в дата-центре на пару часов, чем покупать карту «на вырост». Схема уже не «нейросеть на вашем столе», зато для разового эксперимента с большой открытой моделью так делают и в курсовых по машинному обучению. Текст запроса при этом снова уезжает на чужую машину — под вашим аккаунтом, без привычного окна чата в браузере.
Учебные задачи редко требуют локального вывода модели на своём ПК. Чаще требуют аккуратного текста, ссылок на источники и умения проверить факт. Если преподаватель просит приложить скрин переписки с моделью, облачный чат проще воспроизвести. Если задание развернуть модель в Docker на сервере кафедры, там уже llama.cpp и открытые веса, а не браузер.
На практике студенту важнее правила вуза и здравый смысл, чем метка «локально». Черновик диплома с ФИО и данными опроса не стоит кидать ни в облако, ни в локальную модель, если политика запрещает. Анонимизированный текст для структуры глав можно гонять где угодно, но финальные цифры всё равно сверяют с первоисточником.
Законы о персональных данных и внутренние правила вуза могут запрещать загрузку анкет в любой внешний сервис. Тогда локальный или университетский хост оправдан, но ответственность за настройку несёт администратор. Фраза «локально значит безопасно» неверна: веса можно скачать с подменённого зеркала, а уязвимость в плагине оболочки никуда не делась.
Отдельный пласт — авторское право на сгенерированный текст и картинки. Локальная генерация не делает результат автоматически «вашим без ограничений»: лицензия весов (MIT, openrail++ и другие) накладывает свои условия на коммерческое использование и на датасеты. Для диплома это редко спорный пункт, для фриланса с заказчиком — уже да. Храните в README курсовой, какую модель и какую ревизию весов вы запускали: преподаватель или заказчик может спросить.
Что будет дальше
Линия встроенных моделей у производителей вроде Apple давит в сторону маленьких моделей, вшитых в систему. Линия открытых весов (DeepSeek, Meta Llama, Mistral) давит в сторону больших файлов для энтузиастов и серверов. Между ними Ollama и подобные оболочки упрощают старт, но не отменяют физику памяти.
Через год названия ревизий сменятся, а структура останется: файл весов, движок, оболочка, ваше железо. Имеет смысл один раз пройти путь на малой модели и запомнить, где у вас узкое место — диск, оперативная память или скорость ответа. Тогда новости про «ещё одну локальную нейросеть» читаются спокойно: вы смотрите на гигабайты загрузки и лицензию, а не на громкий заголовок.
Если завтра в новости обещают «идеальную локальную модель размером с телефон», откройте карточку модели: сколько параметров, какое квантование, какой контекст. Числа без источника в этой статье не повторяем, они быстро стареют. Для первого знакомства с механикой токенов и контекста полезно параллельно прочитать статью про большие языковые модели: там та же база, только без установки на диск.
Вопросы и ответы
Как запустить локальную нейросеть?
Нужны три вещи: файлы весов выбранной модели, программа-движок и достаточно памяти. На практике чаще всего ставят Ollama под свою систему, затем в терминале запрашивают имя модели из каталога, и программа сама скачает гигабайты. Альтернатива: скачать файл GGUF и запустить llama.cpp вручную. После установки первый запрос лучше короткий, чтобы проверить скорость, а не сразу загружать книгу. Запишите время ответа и длину текста: так проще сравнить ревизии модели, когда через месяц выйдет обновление. Если ответ идёт минутами, уменьшите контекст или возьмите более лёгкое квантование, прежде чем покупать новое железо.
Как установить нейросеть локально без лишних ошибок?
Проверьте свободное место на диске с запасом под будущие модели, обновите драйвер видеокарты, если используете GPU, и начните с малой модели из той же линейки, что интересна большая. Разделяйте шаги: сначала скачивание весов, потом запуск сервера, потом первый запрос. Частая ошибка — файл уже лежит на диске, а сервер не запущен, и кажется, что «модель сломалась». Документация Ollama и llama.cpp описывает платформы Windows, macOS и Linux; для учебного разбора выбора облачной модели параллельно смотрите гайд по выбору модели.
Работает ли локальная нейросеть без интернета?
После загрузки весов да, для самих ответов интернет не нужен, если программа не настроена иначе. Интернет может понадобиться при первой установке, при обновлении модели и если оболочка сама ходит за телеметрией. Полностью изолированный режим это отдельная настройка сети и политики обновлений.
Какие локальные нейросети для генерации изображений выбирают чаще всего?
В открытом сегменте до сих пор часто начинают со Stable Diffusion XL и связанных checkpoint на Hugging Face с лицензией openrail++. Интерфейсы это ComfyUI или Automatic1111. Критерии качества те же, что для облака: руки, текст, артефакты на краях.
Локальная видео нейросеть на обычном ПК — это реально?
Короткие клипы в экспериментальных сборках возможны, но время и память растут быстрее, чем у текста или одного кадра. Для учебного ролика или рекламного черновика чаще используют облачные видеомодели из разбора нейросетей для видео. Локально имеет смысл пробовать, если уже есть мощная GPU и готовность ждать.
Чем локальный запуск отличается от Apple Intelligence на iPhone?
Apple описывает встроенную ~3B модель с оптимизациями под свои чипы; пользователь не управляет файлами весов. Самостоятельный запуск Llama или DeepSeek через Ollama означает, что вы сами выбираете модель, несёте ответственность за обновления и память. Это разные уровни контроля, хотя оба варианта могут не отправлять текст на сторонний сервер во время ответа.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат с моделью
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.