Как задать вопрос нейросети, чтобы получить точный ответ
Обозреватель: как устроен ИИ
Содержание
30 мая 2024 года вице-президент Google по поиску Элизабет Рид объясняла в блоге компании, почему новый блок AI Overviews советовал людям есть камни. По её словам, до того как снимки экрана разошлись по сети, такой вопрос Google практически никто не задавал. Качественных страниц на эту тему не было, нашлась одна сатирическая заметка, и система добросовестно на неё сослалась. Google назвал это «пустотой данных». Ответ оказался ровно таким же точным, как вопрос и материал под ним. С вопросом нейросети в обычном чате происходит то же самое, только в меньшем масштабе: модель всегда что-то ответит, а точность зависит от того, что вы дали ей на входе и как потом проверили выход.
Как задать вопрос нейросети, чтобы ответ был точнее
Привычная картина такая: спросили искусственный интеллект, получили абзац, скопировали в работу. Неверна она в одном месте. Чат не достаёт ответ из справочника, как энциклопедия. Он дописывает текст по шагам, и каждый следующий фрагмент выбирается как правдоподобное продолжение уже написанного — в статье «Attention Is All You Need» 2017 года это описано для декодера, который на каждом шаге берёт свои прошлые выходы как дополнительный вход. Правдоподобное продолжение и верное — не одно и то же.
Отсюда следствие для формулировки. Вопрос «расскажи про налоговый вычет» модель понимает как «напиши типичный текст про вычет». Вопрос «перечисли условия социального вычета из статьи 219 НК РФ, которые есть в приложенном фрагменте, без пунктов вне текста» сужает пространство ответа. Чем уже рамку задаёте вы, тем меньше места для достройки по шаблону.
Ещё в анонсе ChatGPT 30 ноября 2022 года OpenAI записала в ограничения: на неоднозначный вопрос модель обычно не переспрашивает, а угадывает, что имел в виду человек. С тех пор модели стали аккуратнее, но угадывание никуда не делось. Неоднозначность в вопросе превращается в догадку в ответе, причём догадку, изложенную тем же уверенным тоном.
Anthropic в руководстве по запросам предлагает простой тест. Покажите формулировку коллеге, который не в курсе задачи, и попросите выполнить. Если он запутается, запутается и модель. Тот же принцип работает для Gemini 3.8 Flash, Claude Sonnet 5 и DeepSeek V4 Flash — все три уже доступны в чате GPThub. Модели разные, а правило «явная задача — меньше догадок» общее.
Три поля, которые стоит заполнить в голове до отправки сообщения.
Аудитория и формат. Кому предназначен ответ: вам для решения, преподавателю, клиенту. Нужен список, таблица, один абзац или пошаговый разбор. OpenAI в документации сравнивает обычную модель GPT с младшим коллегой, которому нужны явные инструкции и описание результата, а рассуждающую — со старшим, которому достаточно цели. Без описания результата даже старший коллега принесёт «что-то по теме».
Границы фактов. Разрешены только данные из файла, только общие знания с пометкой «нужна проверка» или только источники не старше определённой даты. Одна фраза «не используй информацию вне приложенного текста» для отчётов и договоров экономит часы.
Критерий остановки. Сколько пунктов, какая глубина, что считать ошибкой. «Если в документе нет ответа, напиши, что в документе этого нет» — уже критерий, и Anthropic прямо рекомендует разрешать модели ответ «у меня недостаточно информации».
Отдельный выбор — одно сообщение или цепочка. Длинное полотно удобно писать человеку, но модель может упустить условие из середины. Если условий много, нумеруйте их и повторите в конце коротким блоком: «итого — источник только PDF, формат таблица, нет данных — отказ». Последние строки запроса тогда работают как контрольный список.
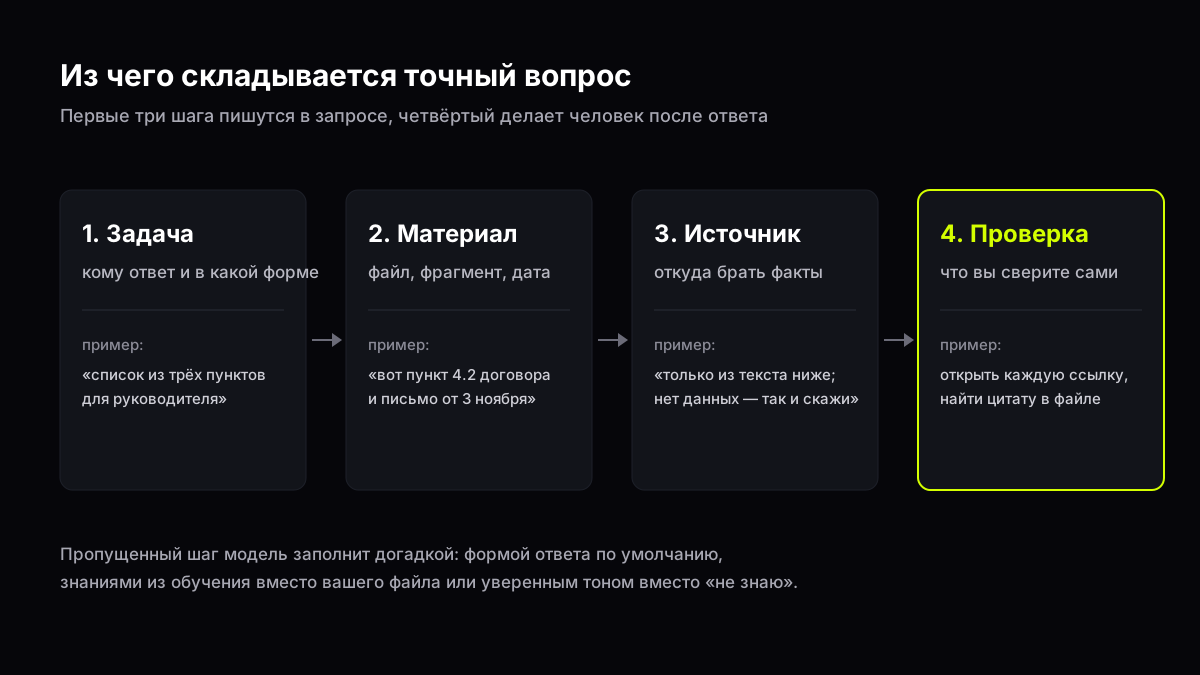
Схема точного вопроса, иллюстрация GPThub
Зачем нужен контекст и что влезает в окно
Контекст — всё, что модель учитывает вместе с вашим последним сообщением: предыдущие реплики, загруженный PDF, системные инструкции чата. Окно контекста — верхний предел этого объёма, он измеряется в токенах, кусках текста. У разных моделей предел разный, и актуальные числа стоит смотреть в документации разработчика, потому что лимиты меняются от поколения к поколению. Подробнее о токенах и окне — в статье про контекстное окно.
Самая частая ошибка: в один диалог кладут целую главу диплома, десять уточнений и просят «сослаться на введение». К концу переписки начало может оказаться за пределом окна, и чат не всегда об этом предупреждает — он отвечает из того, что ещё помещается. Лечение приземлённое: для длинного документа вырезайте нужный фрагмент и вставляйте его в сообщение или прикладывайте файл и указывайте раздел. Для серии вопросов по одному договору начинайте новый диалог, когда тема сменилась.
Порядок внутри сообщения тоже имеет значение. Anthropic советует ставить длинные документы в начало запроса, а сам вопрос — в конец, и пишет, что в её тестах вопрос в конце улучшал качество ответа до 30%, особенно на сложных наборах из нескольких документов. OpenAI в своей документации тоже рекомендует класть дополнительный контекст ближе к концу инструкции. Если вы пересказываете условие задачи, повторите его перед вопросом, а не только в первом сообщении неделю назад.
Контекст бывает двух родов, и смешивать их без пометки опасно. Статический — ваш файл, таблица, выдержка из закона. Динамический — новости, курсы, версия программы, вышедшая вчера. Для динамики знаний модели мало, сюда подключают поиск по интернету или свежую страницу, которую вы принесли сами.
Ещё один слой — прошлые ответы самой модели. Если вы десять раз уточняли формулировку, в контексте лежат и удачные, и неудачные черновики. Модель может принять собственную ошибку из третьего сообщения за согласованный факт и развить её в двенадцатом. Когда спорите с ответом, не пишите «ты ошибся» без указания, где именно. Лучше так: «в абзаце 2 стоит 2018 год; в файле на стр. 4 указан 2020; перепиши абзац, опираясь только на стр. 4». Так вы возвращаете модель к первоисточнику, а не к её же пересказу.
Для долгой работы полезно повторять контекст в каждом сообщении коротким блоком «напоминание»: тема, файл, запреты. Это тратит токены, зато спасает, когда вы возвращаетесь к диалогу через день.
Откуда модель должна брать факты
По умолчанию ответы идут из статистики обучения, а не из проверенной базы. Это не дефект конкретного бренда. OpenAI в том же анонсе ChatGPT объясняла, что при обучении с подкреплением у разработчиков нет «источника истины» для каждого возможного вопроса. Значит, источник нужно назначить в самом запросе.
| Ситуация | Что написать в запросе | Что проверить в ответе |
|---|---|---|
| Ответ только по вашему файлу | «Используй только текст между маркерами; если данных нет — так и скажи» | Каждый факт находится в файле, цитата дословная |
| Сравнение двух редакций документа | Приложить обе версии, попросить таблицу «было — стало» | Изменения совпадают с тем, что видно при сравнении вручную |
| Общий факт (дата, имя, закон) | «Дай ответ и укажи, что нужно проверить по официальному сайту» | Сайт открыт, цифра и формулировка совпали |
| Список литературы | «Только статьи с DOI; если в DOI не уверен — не включай» | Каждый DOI открывается |
Для документов длиннее 20 тысяч токенов Anthropic рекомендует два хода: сначала извлечь дословные цитаты, потом сделать вывод только по ним и ссылаться на номера цитат. Так «что написано в тексте» отделяется от того, что модель додумала при пересказе. Тот же документ предлагает ещё одну проверку: после ответа попросить модель найти подтверждающую цитату для каждого утверждения и убрать те, для которых цитаты нет.
Если задача — пересказ, а не цитирование, всё равно попросите указать, какие абзацы легли в основу. При проверке вы возвращаетесь к этим абзацам, а не спорите с гладким стилем.
Истории о выдуманных научных ссылках и судебных решениях подробно разобраны в статье о галлюцинациях нейросети. Здесь достаточно практического фильтра: любое имя собственное, число, дата, номер статьи закона и адрес страницы проходят через вашу сверку.
Подмешивание найденных фрагментов в запрос OpenAI называет генерацией с дополнением найденным (RAG) — так устроены поиск по загруженным файлам и базы знаний, подробнее в статье про RAG. В чате это выглядит проще: вы вставляете цитату или прикладываете файл. Смысл тот же — модель опирается на конкретный текст, а не на типичный абзац из обучения.
Если источник — несколько файлов
Пометьте файлы буквами «А» и «Б» и запретите смешивать: «сравни только А и Б, не добавляй факты вне них». В ответе просите ссылки вида «А, стр. 12» и «Б, абзац 3». При проверке вы идёте по этим меткам, а не по пересказу целиком.
Когда включать поиск по интернету
Спросить нейросеть без поиска можно, когда ответ следует из приложенного материала или когда нужен черновик идеи, а не справка. Поиск нужен, когда без свежих страниц ответ устареет или когда факт должен подтверждаться ссылкой. Чем чат вообще отличается от поисковой выдачи, разбирает статья про ИИ-чат онлайн.
Когда поиск нужен:
- версии программ, прошивок, моделей и даты их выхода;
- новости, статус сервиса, изменения правил платформ;
- редкие имена, малоизвестные организации, местные события;
- правовые и медицинские формулировки, если нужна действующая редакция документа, а не общий пересказ.
Когда достаточно файла или рассуждения:
- логика задачи, структура текста, перевод, стиль;
- математика и код, если примеры вы потом запускаете сами;
- анализ таблицы, которую вы уже загрузили.
Даже с поиском ответ не становится гарантией, и история с камнями из лида — лучшая иллюстрация. Google в том же посте признал, что часть странных ответов пришла с форумов, где пользователи шутили, — например, совет приклеить сыр к пицце клеем. Страница может не попасть в выдачу, устареть или оказаться шуткой, а модель может неверно пересказать заголовок. Поиск сужает догадку, но не избавляет от необходимости открыть ссылку.
Хуже всего поиск работает, когда вопрос смешивает «найди в сети» и «сделай вывод». Разделите их: первым сообщением «собери только цитаты и ссылки с официальных сайтов по теме X», проверьте список, вторым — «сделай вывод для аудитории Y, опираясь только на пункты 1–3 из прошлого ответа». Так модели сложнее подменить слабую страницу уверенным пересказом.
В чате GPThub поиск по интернету запускается сам, когда вопрос похож на запрос свежих фактов, а слова «найди», «погугли» или «дай источник» включают его явно. Для черновика письма или разбора приложенного договора он не нужен. Сравнить, как разные модели ведут себя на одной формулировке, поможет гайд по сравнению моделей на практике.
Как спросить о неуверенности
Модели склонны отвечать уверенно даже там, где не знают. В сентябре 2025 года исследователи OpenAI и Технологического института Джорджии в работе «Why Language Models Hallucinate» объяснили это так: и обучение, и большинство тестов награждают угадывание сильнее, чем честное «не знаю», — как экзамен, где пустая клетка в бланке гарантированно даёт ноль. Значит, право на отказ нужно дать прямо, намёка мало.
Фразы, которые работают в русском запросе:
- «Если данных в приложенном тексте недостаточно, ответь: в тексте этого нет».
- «Раздели ответ на два блока: факты из файла и предположения; предположения пометь отдельно».
- «Перед выводом перечисли, в чём ты не уверен и что нужно проверить человеку».
- «Если не можешь подтвердить дату или имя, не угадывай — напиши, что нужна проверка».
В документации Anthropic есть пример такой оговорки для разбора отчёта: если информации не хватает, модель должна прямо сказать, что её недостаточно для уверенной оценки. В русском чате смысл тот же, формулировка ваша.
Для чисел и дат попросите диапазон или пометку «по памяти модели, проверить». Для спорных тем — две позиции с пометкой, что это обзор мнений, а не вердикт. Юридические, медицинские и финансовые решения модель не заменяет. Точность здесь означает не выдавать догадку за норму, а консультацию специалиста она не заменит.
Полезный приём для учёбы: попросите модель сначала задать вам уточняющие вопросы, если задача неполная. Это прямой ответ на ограничение, которое OpenAI описала в 2022 году: модель не переспросит сама, пока вы её об этом не попросите. Пять коротких уточнений лучше одного длинного неверного абзаца.
Если ответ готовится для публикации, добавьте требование отметить места, которые нельзя утверждать без ссылки. Редактор или преподаватель увидит пометки сразу, а не после того, как спорный абзац попадёт на сайт.
Шкала уверенности в одном ответе
Попросите модель пометить каждый абзац меткой «высокая / средняя / низкая уверенность» и одной строкой объяснить, откуда уверенность: «цитата из файла», «общие знания», «догадка». Верить шкале на слово не обязательно — она не измерение, а самооценка модели, — но она быстро показывает, куда направить проверку. Абзацы с низкой уверенностью без открытого источника в работу не идут.
Типичные ошибки при вопросе нейросети
Слишком широкий вопрос. «Объясни квантовую физику» даст обзор; «объясни принцип суперпозиции на примере спина электрона в три абзаца для первого курса» даст проверяемую структуру.
Несколько задач в одном сообщении. «Переведи, сократи и проверь факты» — модель хорошо выполнит одно, остальное по остаточному принципу. Разбейте на сообщения.
Скрытый контекст. «Продолжи как в прошлый раз» без прошлого раза в новом диалоге. «Исправь ошибку» без указания, где ошибка.
Просьба о ссылках без запрета на выдумку. Добавьте условие про открывающиеся DOI или официальные сайты, иначе список литературы рискует выглядеть безупречно и не открываться.
Слепое доверие к таблице. Таблица выглядит аккуратнее списка, но ячейки никто не проверял. Сверяйте каждую цифру так же, как абзац.
Не та модель под задачу. На вопрос «кто и когда» без документа небольшие быстрые модели ошибаются чаще крупных. В карточке DeepSeek V4 это видно по тесту SimpleQA-Verified: Flash в максимальном режиме набирает 34,1, Pro — 57,9. Подробнее — в материале о DeepSeek и в гайде как выбрать модель. Пересказ приложенного файла быстрая модель при этом делает почти так же хорошо, потому что всё нужное уже лежит в окне.
Когда хватит одного уточнения
Иногда точность ломается из-за одного неясного слова в вопросе. «Срок» может означать дату подписания, дату оплаты или дату отгрузки. Прежде чем спрашивать снова, замените местоимение на имя: вместо «когда они обязаны» напишите «когда поставщик по пункту 4.2 обязан передать акт». Одно такое уточнение часто снимает полстраницы лишнего текста.
Когда лучше начать диалог заново
Новый диалог нужен, если в старом уже приняли неверную дату, если сменился файл, если задача поменялась с пересказа на проверку фактов. История тянет за собой старые допущения. Перенесите в новый чат только проверенные фрагменты и заново пропишите источник и формат.
Что проверить в ответе перед тем, как им пользоваться
Короткий список для ответа, который пойдёт в учёбу или работу:
- Имена и даты — по первоисточнику или официальной странице.
- Цитаты — слово в слово в вашем PDF, номер страницы совпал.
- Ссылки — страница открывается, заголовок относится к теме.
- Числа — единицы и порядок величины здравы, для законов действует нужная редакция.
- Логика — вывод следует из посылок, посылки не взяты из воздуха.
- Повтор — тот же вопрос в новом диалоге или другой модели. Anthropic советует сравнивать несколько ответов на один запрос: расхождение в фактах — сигнал проверить оба.
Если ответ пойдёт клиенту или в официальную переписку, сохраните экспорт диалога и список проверенных адресов. Это цепочка доказательств, что вы не приняли выдумку за факт.
Примеры: слабая и рабочая формулировка
Задача — понять, можно ли сдавать курсовую частями по правилам вуза; текст правил есть в PDF.
Слабый запрос: «Можно ли сдавать курсовую частями?» Модель ответит типичным «во многих вузах…» без привязки к вашему документу.
Рабочий запрос: «Ниже фрагмент Положения о курсовых из PDF. Ответь только по нему. Вопрос: предусмотрена ли поэтапная сдача? Если да — процитируй пункт дословно. Если нет — напиши, что во фрагменте этого нет. Не используй другие источники».
Проверка: нашли пункт в PDF и сравнили с цитатой.
Задача — узнать, выходили ли обновления моделей Gemini за последний месяц.
Слабый запрос: «Что нового у Google в моделях?»
Рабочий запрос с поиском: «Найди официальные анонсы Google DeepMind или Google о моделях Gemini за октябрь–ноябрь 2026 года. Перечисли только то, что подтверждено страницей разработчика, к каждому пункту дай адрес. Если данных нет — так и напиши».
Проверка: каждый адрес открыт, дата на странице попадает в период.
Вопрос про код или расчёт
Задача — понять, почему падает функция на входе из приложенного лога.
Слабый запрос: «Исправь код».
Рабочий запрос: «Ниже фрагмент лога и функция. Шаг 1 — перечисли три наиболее вероятные причины падения со ссылками на строки лога. Шаг 2 — предложи исправление. Шаг 3 — напиши, какие проверки мне запустить, чтобы подтвердить, что ошибка ушла. Не выдумывай строки лога, которых нет во фрагменте».
Проверка: вы действительно запускаете проверки из шага 3. Пока они не запущены, ответ остаётся гипотезой, пусть и аккуратной.
Вопрос про свежие правила
Когда нейросеть отвечает на вопросы о правилах, она опирается на обучение, а обучение заканчивается датой среза данных. Версия прошивки, статус сервиса, свежий приказ министерства живут вне модели, пока вы не принесёте текст или не включите поиск. Формулировка должна содержать дату, регион и тип источника. «Какие условия применения налога на профессиональный доход действуют сейчас по официальным материалам nalog.gov.ru, с адресами страниц» уже задаёт проверку; «какие правила для самозанятых» — нет.
Если поиска нет, честный путь один: вставить выдержку из документа и повторить запрет на догадки. Gemini 3.8 Flash и другие модели в чате по-разному держат фактологию, но правило источника одинаково: сначала материал, потом вопрос.
Три вопроса себе до отправки
- Что будет доказательством правильного ответа? Если ответ просто «звучит разумно», этого мало — нужен файл, адрес страницы или ваш тест.
- Где модель может заполнить пробел? Имена, даты, редкие термины, «типичные» цифры — пометьте их в запросе как «только с источником».
- Кто проверяет? Если вы сами, заложите время на сверку. Если преподаватель или клиент, заложите цитаты и ссылки в формат ответа заранее.
Оформление роли («ты методист»), разметка и тон — в гайде как писать промпты; в примерах выше менялись только источник и критерий точности.
Вопросы и ответы
Как задать вопрос нейросети, если тема мне незнакома?
Начните с рамки: «объясни для человека без специальной подготовки, три уровня — определение, пример, типичная ошибка новичка». Попросите перечислить термины, которые модель использует, и коротко их определить. Незнакомые термины проверьте по учебнику или энциклопедии, а не вторым сообщением той же модели.
Нейросеть отвечает на вопросы уверенно, но факты неверны. Что менять в запросе?
Сузьте источник, дайте право на «не знаю», потребуйте цитаты. Механизм выдумки описан в статье про галлюцинации; в запросе главное — не оставить модели пробела, который она заполнит красивым текстом.
Можно ли одним сообщением и перевести текст, и проверить факты?
Лучше разделить. Сначала перевод с пометкой «факты не проверялись», потом отдельный запрос «найди в переводе проверяемые утверждения и укажи, что сверить». Так ошибку поймать проще.
Когда достаточно модели без поиска?
Когда все факты уже в вашем файле или когда нужны структура, стиль, код, логика задачи. Когда факт живёт во внешнем мире и меняется со временем, нужен поиск или ваша ссылка.
Стоит ли просить модель перечислить источники в конце ответа?
Да, как черновик списка для проверки, но не как готовую библиографию. Каждый пункт откройте сами; то, что не открывается, вычеркните.
Чем вопрос в новом диалоге отличается от продолжения старого?
Новый диалог сбрасывает историю: модель не видит прошлых уточнений. Продолжение экономит время, но тянет за собой ошибки, если неверный факт уже принят. Для проверяемой справки чище новый диалог с тем же файлом.
Связанные модели


Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
Похожие статьи
- Галлюцинации нейросети
Что такое галлюцинации нейросети, почему чат пишет правдоподобную ложь и как проверять даты, имена и ссылки перед сдачей работы.
- ИИ-чат и поиск
Чем ИИ-чат отличается от поиска: где готовый ответ удобнее списка ссылок, где чат ошибается и когда включать веб-поиск в диалоге.
- Токены и контекстное окно
Токен — кусок текста, не слово. Окно контекста — сколько таких кусков модель держит за ответ и почему середина пропадает.
- Что такое RAG
Что такое RAG простыми словами: перед ответом ищут куски файла, и цитата пропадает, если кусок выбран мимо.
- Что такое DeepSeek
DeepSeek — китайская компания и семейство открытых моделей. Как они устроены, чем V4 Flash отличается от Pro и где открыть DeepSeek на русском.
- Что такое ИИ-ассистент
ИИ-ассистент отвечает на запросы и помогает с текстом, планами и файлами. Чем он отличается от поиска и агента и что проверять в ответе.
Источники
- Google: AI Overviews — about last week, 30 мая 2024
- OpenAI: Introducing ChatGPT, 30 ноября 2022 (раздел об ограничениях)
- OpenAI: Prompt engineering
- Anthropic: Reduce hallucinations
- Anthropic: Prompting best practices
- Kalai и др.: Why Language Models Hallucinate, 4 сентября 2025
- Карточка DeepSeek-V4-Flash на Hugging Face
- Vaswani и др.: Attention Is All You Need, 2017
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Проверить формулировку в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.