Нейросеть для решения задач: математика, физика и по фото
Обозреватель: как устроен ИИ
Содержание
В 2021 году в OpenAI собрали набор из 8500 школьных задач по математике и приложили к нему неожиданное признание: даже самые крупные модели того времени отвечали там плохо. Задачи простые, класс пятый. Ломались они на том, что решение требует нескольких шагов подряд, а не одной формулы. Сейчас такие задачи уходят в чат фотографией с телефона и возвращаются через несколько секунд. Вопрос уже не в том, справится ли модель. Вопрос в том, справится ли она правильно и как это проверить до того, как решение уйдёт учителю.
Как нейросеть решает задачу
Первое, что приходит в голову: модель внутри считает, как калькулятор, только быстрее. Это не так, и ошибка здесь мешает понять всё остальное.
Языковая модель предсказывает следующий кусок текста. Когда она пишет «120 + 240 =», следующий кусок с высокой вероятностью будет «360», потому что такие пары она видела миллионы раз. На простых числах это совпадает с арифметикой почти всегда. На числах, которых в обучающих данных не было, совпадение держится уже не так надёжно.
Понимания движения у неё тоже нет. Задачу про поезд она решает потому, что видела тысячи текстов про путь, скорость и время и выучила, как эти величины связаны.
Что изменилось в 2022 году. Команда Google показала в работе про цепочку рассуждений, что достаточно дать модели восемь примеров с расписанными шагами, и она начинает расписывать шаги сама. Модель на 540 млрд параметров после этого вышла на лучший результат на том самом наборе школьных задач. Авторы отдельно отметили: умение рассуждать появляется только у достаточно крупных моделей, у маленьких его просто нет.
У этого есть следствие для практики. Просить «покажи решение по шагам» имеет смысл: сам процесс записи шагов меняет то, что модель выдаёт дальше. Каждый записанный шаг становится частью условия для следующего.
Есть и обратная сторона. Чем длиннее рассуждение, тем больше в нём мест, где можно свернуть не туда. Модель может придумать лишнее условие, потерять знак минус на третьей строке или решить, что задача про двух рабочих, хотя в условии один. Длинная запись шагов увеличивает шансы на правильный ответ в среднем, но не гарантирует его в каждом конкретном случае.
Ещё одна деталь, о которой редко пишут. Одна и та же модель при одном и том же запросе может ответить по-разному в разные дни. Это не сбой, так устроен выбор следующего слова: он вероятностный. Для школьной задачи с одним правильным ответом это означает, что две попытки дают две независимые проверки. Совпали — вероятность ошибки резко падает.
Чем школьная задача отличается от вузовской
Разница в количестве скрытых договорённостей: чем их больше, тем чаще модель додумывает.
Школьная задача почти всегда замкнута. Все данные в условии, лишнего нет, ответ один, проверяется подстановкой. Модель на таких задачах сильна, потому что они массово встречаются в обучающих данных в похожих формулировках.
Вузовская задача часто открытая. Нужно выбрать модель явления, пренебречь трением, вспомнить, что происходит на границе. Часть этих решений в условии не прописана, их принимают по умолчанию — и вот тут модель начинает додумывать. Она может взять формулу, которая к этой задаче не относится, но выглядит уместно.
С задачами на доказательство отдельная история. Доказательство — это цепочка, где каждый шаг должен следовать из предыдущего. Правдоподобного вида недостаточно. Модель уверенно пишет «следовательно», когда логического перехода нет. Проверить это труднее всего: ошибка спрятана в слове «очевидно».
Практический вывод: для вузовской задачи просите список допущений. Модель перечислит, что она приняла без доказательства, — и это самый полезный кусок ответа. Учебная программа часто требует именно допущений, финальное число вторично.
Физика, химия, геометрия: где разное
Разные предметы ломаются по-разному, и приёмы проверки у них тоже разные.
Математика предсказуемее всех. Есть уравнение, есть ответ, есть подстановка. Если ответ подставляется и сходится, он верен с высокой вероятностью. Ошибки здесь чаще в счёте и в знаках.
Физика добавляет единицы и размерность. Половина провалов — это минуты, переведённые в часы неправильно, или граммы, оставленные граммами в формуле, которая ждёт килограммы. Проверка размерности ловит это почти всегда: если справа килограммы на метры в секунду, а слева джоули, что-то не так.
Химия добавляет баланс. Уравнение реакции должно быть уравнено по атомам, и это проверяется механически, без понимания химии. Модель иногда пишет красивую реакцию с несходящимся числом атомов кислорода. Пересчитать атомы вручную — дело минуты.
Геометрия добавляет картинку. Здесь модель сильнее всего ошибается в том, что не сказано: где точка лежит на отрезке, острый угол или тупой, пересекаются ли прямые. Просьба «нарисуй схему и подпиши» помогает: на схеме противоречие видно.
Общее правило для всех четырёх: проверяйте тот шаг, который проще всего проверить отдельно, — этого обычно хватает.
Как формулировать запрос к задаче
Разница между «реши» и рабочим запросом видна на первом же ответе.
«Реши задачу» даёт готовое решение без гарантии, что модель правильно поняла условие. Если в условии есть двусмысленность, модель выберет одно толкование молча.
Рабочий запрос состоит из трёх частей. Сначала условие дословно, без пересказа своими словами: пересказ теряет детали, а детали и решают. Потом требование — «реши и покажи каждый шаг с формулой». Третьим идёт проверка: «в конце подставь ответ обратно и покажи, что сходится».
Третья часть важнее, чем кажется: модель, которую попросили проверить, делает это в том же ответе и часто сама исправляется, потому что проверка стала частью её собственной записи.
Что не надо писать. Не надо просить «реши правильно», не надо угрожать, что ответ проверят, и не надо добавлять «это очень важно для моей карьеры». Такие фразы в исследованиях результата не улучшали и место в запросе занимают.
Для задач с условием на картинке запрос другой. Сначала «продиктуй условие с фото словами», потом сверка, и только затем решение. Двухступенчатый запрос надёжнее одного: на первой ступени видно, что модель прочитала.
Пошаговые калькуляторы и обычная модель
Кроме чата, есть отдельный класс инструментов, которые решают задачи по шагам: снимают фото и выдают разбор. Они устроены проще: распознают формулу и передают её в настоящий математический движок. Предсказания следующего знака там нет.
Разница принципиальная: движок считает по правилам, поэтому в арифметике почти не ошибается. Чат предсказывает текст, поэтому ошибается редко, но непредсказуемо. Зато движок не объясняет ход мысли и не отвечает на вопрос «почему здесь минус». Чат отвечает, и это его сила.
Для проверки это означает вот что. Если сомневаетесь в счёте, посчитайте вторым способом: вручную, в обычном калькуляторе или попросив модель посчитать заново другим путём. Если сомневаетесь в понимании задачи, счёт не поможет — нужен разбор шагов, и здесь чат сильнее.
Задачи по фото: что снимать и как
Качество чтения зависит от того, как снят кадр, и это самая управляемая часть всей цепочки.
Первое — снимите страницу сверху и целиком, чтобы условие попало в кадр без обрезков. Модель видит то, что видно на картинке, и если правая часть формулы ушла за край, она дорисует её по смыслу.
Второе — свет: ровный дневной или лампа сбоку читаются лучше, чем вспышка прямо в страницу, потому что при вспышке глянцевая бумага даёт блик, и цифры под ним пропадают.
Третье — почерк: печатный текст читается почти без ошибок, рукописный хуже. Если задача написана от руки, полезно перепечатать её самому и сравнить с тем, что выдаёт модель. Расхождение сразу покажет, где рукописные «7» и «1» слились.
Четвёртое — таблицы и графики: подписанный график модель читает, но не всегда правильно определяет масштаб осей. Если ответ зависит от графика, проверьте, ту ли шкалу она взяла.
Когда модель врёт уверенно
Самая неприятная ошибка выглядит так же, как правильный ответ. Тот же ровный тон, та же аккуратная выкладка, та же фраза «Ответ: 42». Нет ни запинки, ни оговорки, что здесь модель не уверена.
Причина в том, что у модели нет отдельного чувства уверенности, которое она могла бы сообщить отдельно от текста. Тон ответа она тоже предсказывает, и в обучающих данных решения задач писались утвердительно. Поэтому на верном и на неверном пути продолжение одинаково бодрое.
Исследование 2025 года про галлюцинации объясняет, откуда берётся привычка угадывать. Большинство тестов устроено так, что за пропуск ответа начисляют ноль, а за попытку есть шанс угадать. Модель, которая прошла через такие тесты, выучила: лучше ответить, чем признаться, что не знаешь. Это касается и задач с единственным верным ответом.
Что с этим делать: спрашивать прямо — «может ли эта задача не иметь решения», «какие у этого ответа слабые места», «что изменится, если одно из чисел я задал неправильно». На таких вопросах модель переключается в другой режим и начинает перечислять допущения. Не всегда, но часто.
Ещё один приём — попросить оценку уверенности числом. Он работает хуже, чем хотелось бы: цифра тоже предсказывается и бывает завышена. Зато если модель сама говорит «здесь я не уверен», это почти всегда честный сигнал. Такое признание в обучающих данных встречается редко, и модель выдаёт его, когда действительно сомневается.
Ошибки, которые делают чаще всего
Привычек, из-за которых даже верное решение модели превращается в неверное, набирается пять.
Первая — пересказать условие своими словами. Одна потерянная единица меняет весь ответ, а заметить это в пересказе трудно. Условие лучше копировать дословно, вместе с оговорками вроде «если пренебречь трением».
Вторая — доверять красивой записи. Аккуратные формулы выглядят убедительнее кривых, и ошибка в них заметна хуже. Ровный почерк у модели ничего не гарантирует.
Третья — проверять «по виду». Ответ 1,5 яблока смотрится странно, а он верный. Ответ 360 километров смотрится нормально, а может быть неверным. Внешний вид ответа не говорит ничего.
Четвёртая — отдавать всю задачу одним запросом. Сложная задача решается лучше, если разбить её на три части и проверить каждую отдельно.
Пятая — сдавать без разбора метода. Готовый ответ не переносится на следующую задачу, где условие чуть другое, и через неделю всё начинается заново.
Сколько это стоит по времени
Разговор про пользу нейросети в учёбе часто упирается в вопрос, не тратится ли больше времени на проверку, чем на самостоятельное решение.
По нашему опыту работы с задачами средней школы, разбор готового решения с проверкой занимает в полтора-два раза меньше времени, чем решение с нуля, если задача незнакомая. Если задача знакомая, модель почти не экономит: вы и так знаете метод, а проверять её запись дольше, чем записать свою.
Экономия появляется на другом — на понимании, почему метод работает именно так, и на разборе своей ошибки. «Вот моё решение, найди, где я ошибся» — запрос, который модель выполняет хорошо, потому что проверка чужой записи проще, чем решение с нуля.
Обратная сторона: если пользоваться моделью на каждой задаче, навык не растёт. Через месяц вы решаете медленнее, чем решали бы без неё. Это та же история, что с калькулятором: он не мешает считать, пока вы умеете считать без него.
Отсюда рабочая схема на семестр. Новые темы разбираете с моделью: она объясняет метод быстрее учебника. Знакомые темы решаете сами, а модель зовёте только проверить. Перед контрольной неделя без помощника: если за неделю не разучились, значит, метод действительно ваш.
Ещё одно наблюдение из практики. Самое полезное, что даёт модель в учёбе, — объяснение «а почему здесь так». Когда модель объясняет шаг, который в учебнике пропущен как очевидный, тема складывается. Ответ без объяснения такого эффекта не даёт.
Что модель делает с фото условия
Задача по фотографии — это две разные задачи подряд. Сначала картинку надо прочитать: найти строки, разобрать почерк, понять, где степень, а где индекс, не спутать «x» с знаком умножения. Потом уже решать.
Обе части делают разные механизмы. Чтение картинки — работа зрительной части модели, она переводит изображение в описание. Решение — работа текстовой части, и она получает уже текстовое условие.
Первое, что ломается, — именно чтение. Плохой свет, мятая страница, дробь, нарисованная от руки, — и в условии появляется лишняя цифра или пропадает знак. Дальше модель честно решает то, что прочитала, и ответ не имеет отношения к настоящей задаче.
Отсюда практическое правило: после загрузки фото попросите модель сначала продиктовать условие словами и только потом решать. Расхождение видно сразу. Это дешевле, чем искать ошибку в готовом ответе.
Как это устроено на замерах. На MathVista, наборе из 6141 задачи, где условие дано картинкой, диаграммой или графиком, лучшая модель на момент выхода работы в 2023 году набирала 49,9% и отставала от человека на 10,4 процентного пункта. Ошибки копились именно на сложных рисунках и на строгих рассуждениях. С тех пор модели выросли, но принцип остался: картинка — самое слабое звено в цепочке.
Что сейчас умеет читать фото в чате. По каталогу на 13 ноября 2026 года таких восемь: ChatGPT 6 Luna, ChatGPT 6.1 Sol, Claude Haiku 5.5, Grok 4.7, Gemini 3.8 Flash, Kimi K2.6, Kimi K3 и GPT-5 Nano. Claude Haiku 5.5, Grok 4.7, Gemini 3.8 Flash, Kimi K2.6 и GPT-5 Nano открываются с «Плюса», ChatGPT 6.1 Sol и Kimi K3 — с «Про», а ChatGPT 6 Luna есть и на бесплатном тарифе, и у гостя. Остальные модели в чате работают с текстом, и фотографию им надо переписать словами. Модель, у которой нет зрения, всё равно решит записанное условие — просто чтение берёт на себя человек.
Где модель ошибается
Ошибки делятся на три вида, и лечатся они по-разному.
Счёт. Модель верно составила уравнение и ошиблась в сложении. Это самый частый и самый заметный промах, потому что ответ получается аккуратным и правдоподобным. Хорошая новость: такой промах ловится пересчётом вручную за минуту.
Понимание. Модель решила не ту задачу: перепутала «на 20% дороже» с «в 20 раз дороже», приняла «за час до» за «через час после». Считать она может безупречно, а ответ будет неверным. Такой промах пересчётом не ловится, только сверкой с условием.
Выдумка. Задача сформулирована так, что честного ответа нет, а модель всё равно его выдаёт. Работа 2025 года объясняет механизм: во время обучения модель вознаграждали за угадывание в тестах с несколькими вариантами, и привычка угадывать вместо «не знаю» осталась. Поэтому вопрос «а существует ли такое решение» стоит задавать отдельно от «реши».
Самопроверка, о которой так часто советуют просить, работает хуже, чем принято думать. Работа 2023 года проверила это напрямую: если у модели нет внешнего сигнала — калькулятора, нового условия, подстановки, — собственные ошибки она находит редко и после «исправления» иногда отвечает хуже, чем до него.
Внешний сигнал здесь ключевое слово. Подстановка ответа обратно в условие — сигнал. Второй расчёт другим способом — тоже. А просьба «посмотри внимательно, всё ли верно» сигналом не является, это та же модель смотрит на тот же текст.
Как проверить ответ
Проверка занимает меньше времени, чем переписывание задачи, если знать, что именно смотреть.
Первое: подстановка. Нашли икс — верните его в исходное уравнение и посчитайте обе стороны отдельно. Нашли путь — умножьте скорость на время сами, на бумажке или в калькуляторе, и сравните с ответом модели.
Второе: единицы. В физике почти все провалы сводятся к минутам, которые остались минутами в формуле с часами, или к граммам вместо килограммов. Формула при этом бывает совершенно правильной.
Третье: порядок величины. Поезд за пять часов на 2400 километров — это 480 в час. Такая скорость бывает у самолёта, у поезда нет. Если модель выдала такой ответ, где-то потерян множитель, и дальше искать нечего.
Четвёртое: второй заход. Попросите решить ту же задачу другим способом — через пропорцию, если решали через уравнение. Совпало, значит, вероятность ошибки резко упала. Разошлось — разбирайте, какой путь врёт.
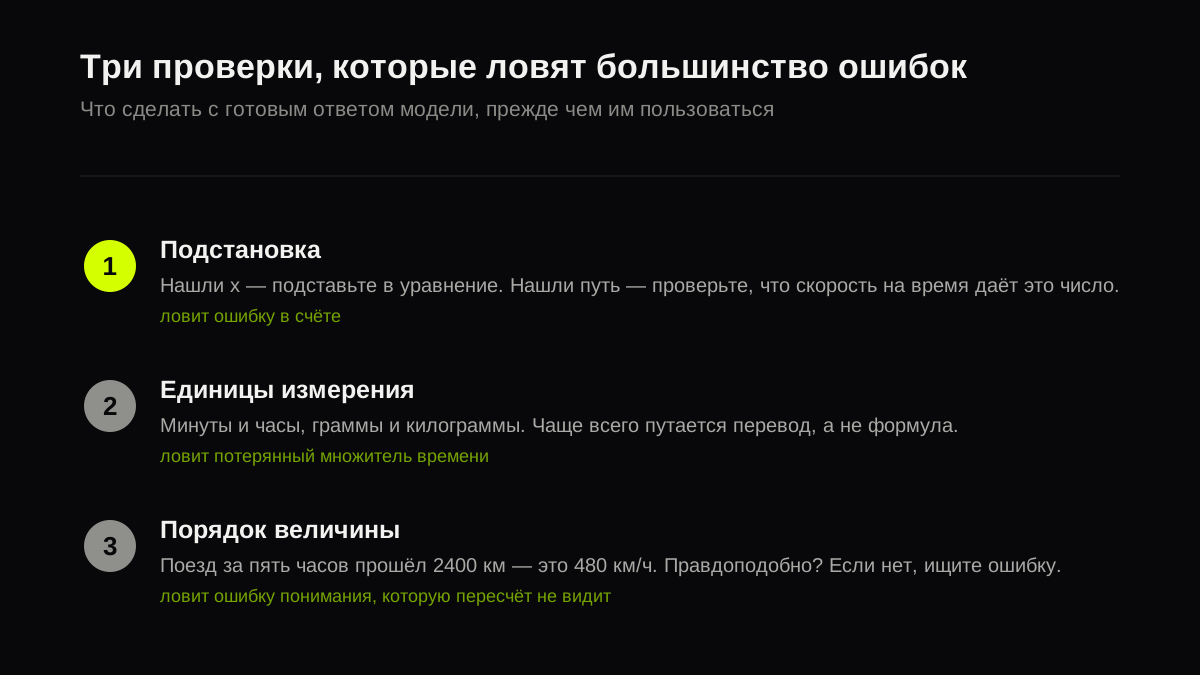
Схема GPThub, 14 ноября 2026
Пятое действие необязательное, но полезное: попросить модель назвать, где она не уверена. Честный ответ «здесь я предположил, что тело движется равномерно» часто важнее самого решения.
Свой прогон: три модели и задача с ловушкой
Вечером 13 ноября 2026 года мы задали трём моделям в чате GPThub по три вопроса. Учебный аккаунт на тарифе «Ультра», по одному запросу на модель, без подсказок и примеров.
Первый вопрос — простой: «Сколько будет 17 умножить на 23? Покажи вычисление». Все три ответили верно, 391, и все три показали разложение на 340 и 51. Разница только в записи: Grok 4.7 выстроил столбик в блоке кода, Claude Haiku 5.5 дал ответ первой строкой, а выкладку ниже.
Третий вопрос тоже без сюрпризов: «2 + 2 × 2». Все три назвали 6 и объяснили приоритет умножения. Grok 4.7 сослался на правило BODMAS, ChatGPT 6 Luna объяснил по-русски.
Интересным оказался второй вопрос, и он был с подвохом. Мы попросили: «У Ани было 3 яблока, она отдала половину. Сколько осталось? Если ответ не целый, скажи прямо, что условие сформулировано некорректно».
- ChatGPT 6 Luna ответил ровно по инструкции: «Если яблоки целые, условие сформулировано некорректно: половина от 3 — 1,5 яблока. Математически осталось 1,5 яблока». Обе части на месте.
- Claude Haiku 5.5 посчитал верно, но инструкцию выполнил с оговоркой: «Ответ нецелый. Но сказать, что условие некорректно, я мог…». То есть смягчил формулировку, хотя инструкция просила прямую.
- Grok 4.7 ответил одной фразой: «Условие сформулировано некорректно». Без числа вовсе.
Ответ 1,5 яблока математически правильный, и все три модели это понимают. Разошлись они в другом — насколько буквально выполнять прямую инструкцию. Именно эта разница и всплывает на контрольной: модель, которая смягчает формулировку, даёт ответ, который человек не сразу заметит.
Вывод из прогона скромный, но практичный. Один и тот же вопрос с одинаковой формулировкой не гарантирует одинакового поведения у разных моделей. Если в задаче есть условие «скажи прямо, если решения нет», стоит проверить, что модель его действительно выполнила, и не поверить мягкому пересказу.
Что делать сейчас
Если задача из школы или с первого курса, порядок такой: сфотографировать условие, попросить продиктовать его словами, сверить с оригиналом, решить по шагам, подставить ответ обратно. Пять минут, и вероятность сдать верное решение заметно выше, чем при одном запросе «реши».
Если задача сложная и модель путается, разбейте её на части. Не «реши всю задачу», а «составь уравнение», потом «реши уравнение», потом «проверь единицы». На каждом шаге видно, где именно пошло не так.
Готовые формулировки для учёбы собраны в гайде нейросеть для учёбы, а общие приёмы запроса — в гайде как писать промпты. Про то, почему модель уверенно выдумывает, разобрано в статье почему нейросеть выдумывает; про то, как формулировать вопрос, — в статье как задать вопрос нейросети.
В чате GPThub условие по фото прочитают ChatGPT 6 Luna, Claude Haiku 5.5, Gemini 3.8 Flash и Kimi K3, для длинных текстовых расчётов рядом открывается DeepSeek V4 Flash.
Вопросы и ответы
Может ли нейросеть решить задачу по фото?
Да, если модель умеет читать изображения. В каталоге на 13 ноября 2026 года таких восемь: ChatGPT 6 Luna, ChatGPT 6.1 Sol, Claude Haiku 5.5, Grok 4.7, Gemini 3.8 Flash, Kimi K2.6, Kimi K3 и GPT-5 Nano. Слабое место здесь чтение условия: почерк, дроби и степени распознаются с ошибками. Поэтому сначала попросите продиктовать условие словами и сверьте с фотографией.
Почему модель ошибается в простом счёте?
Она предсказывает следующий знак по вероятности, а не считает по правилам арифметики. На числах, которые часто встречались в обучении, это совпадает с настоящим ответом почти всегда. На редких комбинациях совпадение хуже. Ошибку ловит пересчёт вручную или подстановка ответа обратно в условие.
Помогает ли просьба «покажи ход решения»?
Да, и это подтверждено исследованием 2022 года про цепочку рассуждений: когда модель расписывает шаги, она ошибается реже, чем при ответе одной строкой. Каждый записанный шаг становится частью условия для следующего, и модель меньше «перескакивает».
Может ли модель проверить сама себя?
Плохо. Работа 2023 года показала, что без внешнего сигнала — калькулятора, нового условия, подстановки — модель находит собственные ошибки редко, а иногда после самопроверки отвечает хуже. Проверять надо снаружи: подставить ответ, сверить единицы, пересчитать другим способом.
Списывать ли готовое решение?
Решать с моделью и сдавать её ответ — разные вещи. Разбор шагов помогает понять метод, и это учёба. Готовый ответ без понимания подводит на первой же контрольной, где задача сформулирована иначе. Правила про использование нейросетей в учёбе разобраны в статье нейросеть в школе.
Связанные модели


Связанные гайды
- Нейросеть для учёбы
Как готовиться с GPThub: конспект, объяснение темы, проверка себя. Честные правила — не сдавать чужой текст за свой. Модели для старта и скринов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Похожие статьи
- ИИ в школе
Что меняется, когда нейросети приходят в класс и домой: правила UNESCO, планы Минпросвещения, ЕГЭ и как отличить помощь от списывания.
- Галлюцинации нейросети
Что такое галлюцинации нейросети, почему чат пишет правдоподобную ложь и как проверять даты, имена и ссылки перед сдачей работы.
- Точный вопрос нейросети
Как задать вопрос нейросети, чтобы ответ был точным: контекст, источник фактов, право на «не знаю», когда включать поиск и как проверить ответ.
- Песня нейросетью
Как написать песню нейросетью: слова в чате, музыка в Suno, ElevenLabs и Lyria, зачем нужны теги куплета и припева и кому принадлежат права на трек.
- Презентация с нейросетью
Как нейросеть собирает презентацию: план слайдов, текст и картинки, что умеют Gemini в Slides и Copilot в PowerPoint и что проверить до показа.
- Введение в ИИ
Что такое искусственный интеллект, чем он шире нейросети, какие бывают методы и с каких дат начинается история — для студентов и читателей из поиска.
Источники
- Cobbe и др.: Training Verifiers to Solve Math Word Problems, GSM8K
- Wei и др.: Chain-of-Thought Prompting Elicits Reasoning in Large Language Models
- Lu и др.: MathVista, математика в визуальном контексте
- Huang и др.: Large Language Models Cannot Self-Correct Reasoning Yet
- Kalai и др.: Why Language Models Hallucinate
- OpenAI: Prompt engineering
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат GPThub
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.