
"Нейросеть для песни и музыки: как модель собирает мелодию и текст"

Обозреватель: как устроен ИИ
Содержание
29 июля 2026 года Google выпустила Lyria 3.5 в сервисе Flow Music. В документации к модели сказано, что она рассчитана на песни целиком — с несколькими куплетами, припевами и бриджем, а не на короткий зацикленный фрагмент. 4 сентября ту же модель подключили к приложению Gemini и к Gemini API. Человек, который вводит в поиск «нейросеть для песни», обычно хочет примерно этого: описать настроение и услышать готовый трек. Ниже — из чего такая песня складывается внутри модели, почему слова и мелодия часто рождаются в разных системах и как подготовить русский текст так, чтобы его потом можно было спеть.
Почему песня — не одна кнопка
Для пользователя всё выглядит просто: описал настроение, через минуту звучит композиция с голосом. Внутри почти всегда работают разные блоки. Текстовая модель хорошо держит сюжет, рифму и пересказ смысла своими словами. Аудиомодель хорошо держит тембр, ритм и гармонию, но длинный сценарий без специальной разметки понимает плохо.
Напрашивается аналогия «это чат-бот, который ещё и поёт». Она неверна. Текстовая модель предсказывает следующий фрагмент слова. Музыкальный генератор предсказывает следующий кусок звука в своей таблице кодов. Ошибка в слове видна сразу. Ошибка в звуке часто прячется под реверберацией и плотной аранжировкой, и слушатель скажет «что-то не так», не сумев показать пальцем, где именно.
Отсюда два контура, о которых пойдёт речь дальше. Контур слов — куплет, припев, название, язык. Контур звука — темп, жанр, инструменты, голос, длина. Продукты вроде Lyria 3.5 стараются закрыть оба контура одним запросом. Исследовательские модели вроде MusicGen отвечают только за звук, а слова человек приносит сам.
Для понимания стоит отступить назад. Google ведёт музыкальные эксперименты с 2016 года, когда стартовал проект Magenta. Тогда речь шла скорее о помощи музыканту и инструментальных идеях, чем о готовой песне. В апреле 2025 года появились Lyria 2 и Lyria RealTime в Music AI Sandbox, летом 2026-го — Lyria 3.5. Поэтому под словами «нейросеть для песен» сегодня понимают вокал и форму, хотя несколько лет назад так называли генератор короткого лупа. Читая старый обзор, смотрите на дату: «не умеет петь» могло быть правдой для версии, которой давно нет.
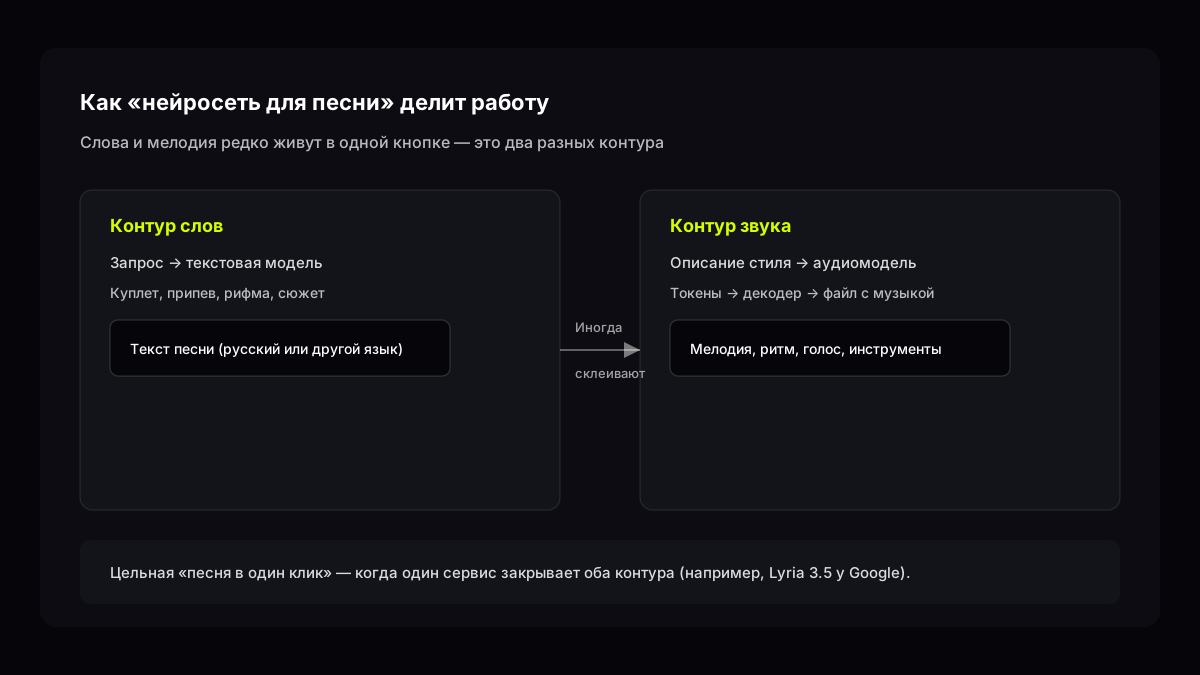
Схема двух контуров песни, иллюстрация GPThub
Что люди просят у нейросети для песен
По формулировкам из поиска видно три разных желания, и они часто путаются.
Первое — файл. «Нейросеть для генерации песен» ищут, когда нужен трек под ролик, для заказчика или для доработки в редакторе. Здесь важны длина, структура, чистота вокала и отсутствие посторонних шумов.
Второе — слова. «Текст для песни нейросеть» — это рифма, размер, русский язык, иногда пересказ истории клиента. Задача текстовой модели, и проверяется она чтением вслух, а не прослушиванием.
Третье — смесь первых двух плюс язык: «русская нейросеть для песен», «нейросеть для создания песен на русском». Русский текст современные языковые модели пишут уверенно. Вокал и произношение зависят уже от аудиогенератора, и акцент может выдать себя на первом же припеве.
Цель определяет объём работы. Для демо себе хватит короткого инструментала и черновика слов. Для релиза понадобятся отдельные дорожки, правки секций и юридическая проверка: кто автор текста, кто автор мелодии, на каких условиях сервис отдаёт права.
Как звук превращают в токены
Модель не хранит нотный стан, как нотный редактор. Она работает с числами. Сначала кодек режет непрерывную волну на короткие отрезки и заменяет каждый отрезок кодом из таблицы. Потом генератор угадывает следующие коды. В конце декодер снова собирает из них волну.
Несколько терминов подряд. Токен — номер в кодовой книге, а не слово из словаря. Кодовая книга — таблица типовых отрезков звука, которую кодек выучил на записях. Частота дискретизации — сколько раз в секунду измеряют амплитуду волны. В статье Meta о MusicGen отмечено, что музыку обычно записывают с частотой 44,1 или 48 кГц, а для речи хватает около 16 кГц. Полоса шире, и ошибки в гармонии слышнее.
У MusicGen (Meta, библиотека AudioCraft) кодек EnCodec кодирует звук на 32 кГц четырьмя кодовыми книгами с частотой 50 кадров в секунду. Каждая следующая книга уточняет то, что не смогла передать предыдущая, — это называется остаточным квантованием. Сама модель — авторегрессионный трансформер: на каждом шаге она смотрит на уже выбранные коды и добавляет следующие. Чтобы не перебирать четыре потока строго по очереди, авторы сдвигают книги относительно друг друга и предсказывают их параллельно. На секунду звука уходит порядка 50 шагов.
Окно контекста для аудио измеряют в секундах или в числе токенов. Длинная песня — длинная цепочка, и если модель «забыла» начало, припев может сменить тональность или темп. Звучит это так: первый куплет в одной тональности, припев уезжает на полтона выше без всякого художественного замысла. Такой дубль проще выбросить, чем спасать эквалайзером.
Как модель слушается описания? При обучении она видит записи и с подписью («рок, девяностые, гитарный рифф»), и без неё. При генерации её подталкивают в сторону подписанного варианта — по-английски этот приём называют classifier-free guidance. Слишком сильный толчок даёт пластиковый звук, слишком слабый — песню, которая на запрос не похожа.
Самих авторов MusicGen интересовало, насколько результат нравится людям. В слепом тесте слушатели оценили его в 84,8 балла из 100, лучшая модель для сравнения получила 80,5. Это данные самой Meta на её собственной выборке, поэтому воспринимать их стоит как ориентир, а не приговор.
Как модель держит форму песни
У поп-песни есть скелет: вступление, куплет, припев, иногда бридж и финальный припев. Слушатель узнаёт припев с первых тактов. Модели, которые выдают тридцать секунд лупа, этот скелет соблюдать не обязаны. Lyria 3.5 в документации Google заявлена именно под форму с куплетами, припевами и бриджем.
Текстовая модель понимает скелет словами: «куплет восемь строк, припев четыре, припев повторяется дословно». Аудиомодель понимает его звуком: в описании пишут, что в куплете редкие барабаны, а в припеве плотный многоголосный вокал и широкий синтезатор. Если описать только «грустная песня», припев может не выделиться, потому что модель не получила контраста.
Ещё один малоизвестный факт — темп и тональность занимают место в том же контексте, что и сами звуки. Резкая смена темпа на стыке куплета и припева для генератора так же трудна, как смена размера посреди строфы для поэта. Поэтому в описании звука темп лучше задавать числом, например «около 92 ударов в минуту», а не словом «медленно».
Язык текста и язык вокала должны совпадать. Смешанные данные обучения иногда дают русский куплет и английский припев. Для русскоязычного трека проще держать весь текст на одном языке и проверять дикцию на каждом дубле.
Как Google Lyria собирает песню целиком
Если MusicGen в публичном описании опирается на последовательное предсказание токенов, то Lyria 3.5 в карточке DeepMind описана иначе: латентная диффузия на временных аудиолатентах. Латент — сжатое представление звука, его «черновик» в пространстве меньшей размерности. Диффузия — процесс, при котором модель начинает с шума и за много шагов убирает его, пока не проявится структура. Тот же подход давно работает в генераторах картинок, только здесь ось времени заменяет одну из осей изображения.
По документации Gemini API модель lyria-3.5 выдаёт стерео 44,1 кГц в формате MP3. На вход принимает текст или изображение, на выход отдаёт аудио и отдельно текст песни. Контур слов и контур звука здесь связаны в одном продукте, хотя внутри задачи разные. В анонсе 29 июля Google перечисляет улучшения в музыкальности, тексте, вокале и управлении результатом.
Предшественники показывают, как менялась задача. В апреле 2025 года в Music AI Sandbox вышли Lyria 2 и Lyria RealTime. RealTime позволяет менять музыку на лету и смешивать жанры в потоке. Для Lyria 2 Google заявила водяной знак SynthID в сгенерированном аудио, а в карточке Lyria 3.5 он упомянут среди мер безопасности. Это пригодится, если площадка спрашивает о происхождении звука.
Русский запрос Lyria стоит проверять на слух. Документация не обещает одинаковой дикции на всех языках. Текст припева модель может выдать грамотно, а вокал проглотит окончание — такую ошибку обычно ловят только на втором прослушивании.
Сервисы, которые делают песню целиком
Кроме Google, существуют отдельные музыкальные платформы. Самая известная — Suno: в официальном описании продукт подан как генерация целой оригинальной песни из текста, с вокалом и аранжировкой. Разбирать интерфейс таких платформ здесь не будем, важнее понять, что у них общего.
Все они прячут два контура за одним полем ввода. Человек пишет «песня о ночном автобусе в стиле инди», сервис сам сочиняет слова, сам подбирает стиль и сам поёт. Это удобно для быстрого черновика и неудобно, когда текст важен: поправить одну строку в готовом треке сложнее, чем написать её правильно заранее.
Обучение аудиомодели требует огромных массивов записей, отдельных вычислительных мощностей и тщательной правовой фильтрации данных. Поэтому музыкальных генераторов меньше, чем текстовых и графических, а их условия использования заметно строже. Про то, как похожим образом устроены генераторы роликов и где они ошибаются, — в материале «Нейросети для видео».
Текст для песни: что спросить у модели в чате
Если нужен русский текст, начинать удобнее с текстовой модели. Композитора она не заменит, но снимет страх пустого листа. В чате GPThub для этого подходят, например, Gemini 3.8 Flash для быстрых черновиков и Claude Sonnet 5 для сложной рифмы и сюжета.
Пример запроса: «Напиши текст песни: два куплета и припев. Тема — ночной автобус из области в город, настроение — усталость и тихая надежда. Рифма перекрёстная, без мата, строки короткие, чтобы их можно было пропеть. В конце дай название и пометь, где припев».
Что проверять в ответе:
- Просодию. Прочитайте припев вслух быстро и медленно. Скопления согласных не должны ломать язык.
- Один образ на строку. Если в каждой строке новая метафора, припев не запомнится.
- Сюжет. В куплете должно что-то происходить, одной эмоции мало.
- Повтор. Припев повторяется дословно или почти дословно, иначе исчезает крючок, за который цепляется слушатель.
Типичные ошибки модели: ответ на английском, хотя просили русский; однообразная рифма на «-ать»; куплет на шестнадцать строк без причины; имена реальных артистов и брендов, которые лучше убрать сразу.
Второй проход часто полезнее первого. Попросите укоротить припев на две строки, убрать затёртые образы вроде «сердца» и «огня внутри» или переписать куплет от первого лица. Сохраняйте оба варианта: из проигравшего черновика иногда пригождается одна удачная строка.
Формулировать такие запросы помогает гайд «Как писать промпты» — те же правила «роль, ограничения, формат», только объект другой.
Сравнить, как разные модели держат рифму и смысл, можно по схеме из гайда «Сравнение моделей на практике»: один сюжет, три ответа, таблица слабых мест.
Разбор одного запроса: от сюжета до строк
Посмотрим, как черновик превращается в текст, который можно петь. Первый запрос из примера выше почти всегда даёт что-то приличное, но с типовыми проблемами. Частая из них — строки разной длины: в одной шесть слогов, в соседней одиннадцать. Читать такое можно, петь трудно, потому что мелодия повторяется, а слоги не помещаются.
Второй запрос: «Посчитай слоги в каждой строке припева и выровняй их до восьми-девяти. Ударные слоги поставь на одни и те же позиции». Языковая модель считает слоги не идеально, поэтому результат стоит проверить вручную. Зато после такого прохода припев уже ложится на простую мелодию.
Третий запрос касается ударений. В русском много слов, где ударение плавает в живой речи или где генератор вокала может ошибиться: «звонит», «красивее», «включит». Попросите модель отметить ударение знаком в спорных словах или заменить их синонимами. Знак ударения полезен и самому человеку: на записи сразу видно, где певец или синтезатор промахнулся.
Четвёртый запрос — описание звука отдельным абзацем. Например: «инди-поп, около 100 ударов в минуту, мужской вокал, акустическая гитара и мягкие барабаны в куплете, в припеве добавляется синтезатор и бэк-вокал, длина около трёх минут». Этот абзац не смешивают с сюжетом песни. Если в одной фразе стоят и «ночной автобус», и «синтезатор восьмидесятых», генератор может уделить внимание только одному слою.
В итоге получается пакет из трёх частей: текст с разметкой секций, ударения в спорных словах и описание звука. С ним можно идти в любой музыкальный сервис, а результат проще сравнивать, потому что от прогона к прогону меняется только сам генератор.
Когда нужна именно мелодия
Запрос «генерация музыки нейросетью» без слов обычно про инструментал, джингл или фон для монтажа. Текстовая модель здесь помогает составить техническое задание: темп, инструменты, длительность, «без ударных в первые восемь секунд».
У MusicGen в открытой документации есть генерация по описанию, продолжение уже загруженного фрагмента и подсказка-мелодия. Последний режим ближе всего к тому, что люди называют «нейросеть собирает мелодию»: человек даёт мотив, модель достраивает аранжировку. У Lyria 3.5 акцент на вокале и форме песни, и если нужен чистый бит под рэп, иногда проще получить инструментал и записать голос отдельно.
Параллель с разбором DeepSeek здесь прямая: там модель предсказывает токены текста, здесь — токены звука. Механизм «следующий шаг из таблицы кодов» тот же, алфавит другой.
Поисковые запросы про песни и про музыку стоят рядом, а задачи различаются. Подложке под подкаст или фону для игры не нужны ни форма, ни голос. Если монтируете ролик и нужны пятнадцать секунд без слов, просить полную песню с куплетами избыточно — короче описать инструментал и длину.
Если сравниваете несколько сервисов, заведите таблицу из трёх колонок: что просили, что услышали, где сломалось (дикция, темп, повтор мотива). Через пять прогонов станет видно, какой инструмент подходит вашему жанру.
Как слушать черновик от нейросети
У сгенерированной песни свой список проверок. Текст проверяют глазами, аудио — ухом: хочется ли кивать в такт, не режет ли слух дикция.
Начало и конец. Обрыв на середине фразы часто значит, что модель упёрлась в лимит длины. Плавное затухание качества не гарантирует, но резкий обрыв почти всегда повод перегенерировать.
Вокал. Слушайте согласные в конце строк: «т», «к», «п» выдают роботизированную дикцию раньше, чем гласные. Если сервис показывает текст рядом с треком, сравните его с тем, что слышите. Одно перепутанное слово в припеве портит запоминание.
Ритм. Простучите темп пальцами по столу. Если удар сбивается каждые четыре такта, монтажёр не исправит это одним фильтром — придётся резать или генерировать заново.
Гармония. Диссонанс уместен в джазе, в поп-припеве редко. Если тональность плывёт к середине, модель потеряла нить в длинном контексте. Короткий фрагмент на 30–60 секунд иногда звучит чище, чем полная песня с первой попытки.
Шум. Цифровое «дыхание» между словами, металлический призвук на «с» и «ш», бульканье в басу. На телефоне это маскируется, в студийных наушниках нет. Если трек пойдёт в рекламу, проверка на двух устройствах обязательна.
Отдельные дорожки. Если сервис отдаёт вокал, барабаны и бас по отдельности, прослушайте только барабаны на первой минуте. Ровная сетка ударов облегчит монтаж под видео. Тот же приём описан для роликов в материале про видео, только вместо рук в кадре слушаете ударные.
Права и публикация
Музыка — область, где об авторстве спорят годами. У открытых весов MusicGen лицензия CC-BY-NC, то есть коммерческое использование ограничено, и для выпуска на стриминговых площадках это критично. Google маркирует аудио Lyria водяным знаком SynthID.
Три вопроса перед публикацией:
- Текст. Если слова писала модель, сохраните запрос и ответ. При споре это не заменит юриста, но покажет, как шла работа.
- Мелодия. Сгенерированный припев может случайно напомнить известную песню. Если ставки высокие, сравните на слух и через поиск по мелодии.
- Голос. Просить «спой как такой-то артист» не стоит: это сомнительно этически и часто прямо запрещено правилами сервиса.
Порядок работы над песней
| Задача | С чего начать | Что проверить |
|---|---|---|
| Русский текст, рифма, структура | Текстовая модель в чате | Чтение вслух, один крючок в припеве |
| Полная песня с вокалом | Lyria 3.5 в Gemini или музыкальная платформа | Дикция, длина, водяной знак |
| Инструментал или мотив | MusicGen или музыкальные платформы | Лицензия, повторы, обрыв в конце |
| Подложка под видео | Короткий фрагмент и монтаж | Совпадение темпа с монтажом |
Последовательность, которая редко подводит:
- Сюжет одной фразой, без жанра.
- Текст в чате: два куплета и припев, правки руками.
- Ударения и выравнивание слогов в припеве.
- Описание звука отдельным абзацем: жанр, темп, инструменты, тип голоса, язык.
- Генерация аудио, если нужен файл.
- Прослушивание на телефоне и на большой колонке: артефакты слышны по-разному.
Если ведёте блог или канал, заранее решите, что показать зрителю: только готовый трек или весь процесс. Второй вариант дольше, зато снимает вопрос «откуда взялась песня». Записывайте номер дубля и текст запроса: через неделю память о «лучшем» варианте редко совпадает с тем, что вы услышите в наушниках снова.
Дальше стоит следить за тем, как развиваются модели, которые отдают слова и звук вместе. Lyria 3.5 уже выдаёт текст песни отдельным полем, и если такая связка станет нормой, править строки можно будет прямо в треке. Пока же надёжнее готовить слова заранее.
Вопросы и ответы
Можно ли сгенерировать песню целиком одним запросом?
Да, это умеют Lyria 3.5 в приложении Gemini и музыкальные платформы вроде Suno. Но если текст важен, надёжнее сначала написать и выверить слова в текстовой модели, а потом отдавать их генератору звука.
Какая нейросеть лучше для текста песни на русском?
Зависит от задачи. Для черновика подойдёт быстрая модель вроде Gemini 3.8 Flash, для сложной рифмы и сюжета — более сильная модель, а лучше сравнение двух-трёх ответов на один запрос. Как выбирать, разобрано в гайде «Как выбрать модель». Проверка всегда одна — чтение вслух.
Чем генерация песен нейросетью отличается от генерации музыки?
Песня добавляет вокал, язык и форму с куплетами и припевом. Музыка без слов — это гармония, ритм и тембр. MusicGen в базовом виде ближе ко второму, Lyria 3.5 заявлена как модель для песни целиком с текстом на выходе.
Почему вокал звучит как каша, хотя текст нормальный?
Чаще всего модель не совместила фонетику с мелодией: мало данных на вашем языке, слишком длинная строка или описание стиля противоречит тексту, например «шёпот» при плотном тексте. Помогает укоротить строки, расставить ударения, перегенерировать секцию или записать голос поверх инструментала.
Есть ли русская нейросеть для песен?
Отдельного генератора уровня Lyria, сделанного именно под русский язык и с открытой документацией, на ноябрь 2026 года мы не нашли. На практике русскую песню собирают из двух частей: текст на русском в языковой модели и генератор звука, где русский вокал проверяют на слух.
Связанные модели


Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
Ещё по теме
Источники
- Introducing Lyria 3.5 in Google Flow Music
- Lyria 3.5 in Gemini
- Карточка модели Lyria 3.5 (Google DeepMind)
- Документация Lyria 3.5 в Gemini API
- Music AI Sandbox, Lyria 2 и Lyria RealTime (Google DeepMind)
- MusicGen в AudioCraft (Meta)
- Simple and Controllable Music Generation, arXiv:2306.05284
- Описание возможностей Suno (llms.txt)
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Написать текст песни в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.