
Что такое открытые веса и чем они отличаются от чата
Обозреватель: как устроен ИИ
Содержание
18 июля 2023 года Meta выложила семейство Llama 2: модели от 7 до 70 миллиардов параметров и текст лицензии с той же датой. Через десять дней компания написала, что за первую неделю пришло больше 150 тысяч запросов на скачивание. Люди качали не «чат». Они качали файл, в котором лежат числа обученной сети. Именно этот файл и называют открытыми весами. Окно, куда вы печатаете вопрос, к файлу отношения не имеет: оно только пересылает текст туда, где файл уже запущен.
Откуда взялась фраза
До лета 2023 года сильные языковые модели почти не отдавали. 24 февраля 2023 года Meta представила первую LLaMA, от 7 до 65 миллиардов параметров, и сразу оговорила условия: некоммерческая лицензия, доступ по заявке, академическим и отраслевым лабораториям решают точечно. Файл существовал. Забрать его с полки, как программу, было нельзя.
Llama 2 этот замок сняла не до конца, но сдвинула. В лицензии от 18 июля 2023 года прямо сказано, что материалы включают обученные веса. Коммерческое использование разрешено, пока у продуктов получателя на дату выхода не было больше 700 миллионов активных пользователей в месяц. Выше порога нужна отдельная лицензия, и Meta вправе её не дать. В том же пункте запрещено использовать результаты Llama 2, чтобы улучшать чужую большую языковую модель. Открытая полка и свободная лицензия на код — разные вещи, и в тексте соглашения это видно без комментатора.
27 сентября 2023 года, в заметке про экосистему, Meta насчитала больше 30 миллионов скачиваний моделей на базе Llama через Hugging Face, из них больше 10 миллионов за последние 30 дней, и больше 7 тысяч производных, которые сообщество дообучило и выложило само. Цифры компании, не независимый аудит. Для сюжета важно другое: за два месяца файл начал жить отдельно от сайта Meta. Его копировали, доучивали и клали обратно.
Рядом, 27 сентября 2023 года, парижская Mistral выпустила Mistral 7B на 7,3 миллиарда параметров под Apache 2.0 и написала, что модель можно использовать без ограничений, в том числе локально. Маленькая модель под старой лицензией кода оказалась убедительнее громкого слова «открытый». Её можно было форкнуть в том же смысле, в каком форкают библиотеку: взять, поменять, отдать дальше, не спрашивая разрешения на каждый запуск.
Дальше фраза «открытые веса» прилипла к любому анонсу, где есть ссылка на скачивание. 5 апреля 2025 года Meta назвала Llama 4 Scout и Llama 4 Maverick первыми открытыми по весам штатно мультимодальными моделями семьи и первыми у себя на смеси экспертов. У Scout 17 миллиардов активных параметров и 16 экспертов, окно 10 миллионов токенов, в анонсе сказано, что при четырёхбитном сжатии модель помещается на одну видеокарту Nvidia H100. У Maverick те же 17 миллиардов активных и уже 128 экспертов. Слова «открытые веса» стоят в первом абзаце поста. Лицензия при этом снова своя, Llama 4 Community License, с датой вступления 5 апреля 2025 года, и в ней снова порог в 700 миллионов пользователей в месяц.
Что такое веса нейросети
Сеть угадывает следующее слово не по правилу из учебника, а по огромной таблице чисел. Как устроена сама сеть, без разговора про файл, разобрано в материале что такое нейросеть. Обучение — это долгое подкручивание таблицы на текстах, пока угадывание не становится терпимым. Веса — и есть эта таблица. Open Source Initiative в определении от 28 октября 2024 года формулирует короче: веса — набор выученных параметров, который ложится на архитектуру и из входа делает выход.
Параметр — одно число в этой таблице. Архитектура — чертёж: сколько слоёв, как они связаны, что считается на каждом шаге. Токен — кусок текста, который сеть берёт за один шаг. Окно контекста — сколько токенов она держит сразу: вопрос, файл и уже написанный кусок ответа.
Аналогия с рецептом пирога здесь врёт в одну сторону. Рецепт — это код: порядок слоёв, формулы, скрипт запуска. Испечённый пирог — не веса. Веса ближе к памяти пекаря, который испек тысячу пирогов и больше не смотрит в карточку: рука сама кладёт соль. Память можно записать и отдать. Карточка при этом может остаться при себе, и наоборот.
Пустой чертёж ответа не даёт. Одни числа без чертежа тоже: программа не знает, в какой слой какое число класть. Поэтому в комплекте к файлу почти всегда идёт код запуска, хотя бы короткий. Это ещё не «весь исходный код обучения». Это инструкция, как включить уже готовую таблицу.
Размер таблицы пишут в миллиардах параметров, и у смеси экспертов их два. Общий — все числа на диске. Активный — сколько чисел считает один токен. В техническом отчёте DeepSeek-V3, репозиторий компании, общий размер 671 миллиард, на токен включается 37 миллиардов. Хранить приходится большую таблицу. Считать каждое слово можно как модель заметно меньше. Когда в новости одна цифра, стоит спросить, какая из двух. Иначе «маленькая открытая модель» и «файл на много видеокарт» оказываются одним и тем же объявлением.
Числа в файле ещё и разной точности. DeepSeek для V3 выложила веса в формате FP8: на число уходит меньше бит, чем в привычном обучении. В том же репозитории написано, что полные веса BF16 они не публиковали, зато дали скрипт перевода из FP8. Открытый файл бывает в сжатой записи. Это не другой ум. Это другая упаковка тех же параметров, и для части программ её сначала надо развернуть.
Копия на полпути обучения называется контрольной точкой. В определении OSI среди примеров параметров прямо названы точки с ключевых промежуточных стадий и состояние оптимизатора. Их публикуют редко. Финальный файл, с которым уже можно разговаривать, и журнал того, как до него дошли, — разные степени открытости. В пресс-релизе их склеивают в одно слово.
Чем открытые веса отличаются от чата
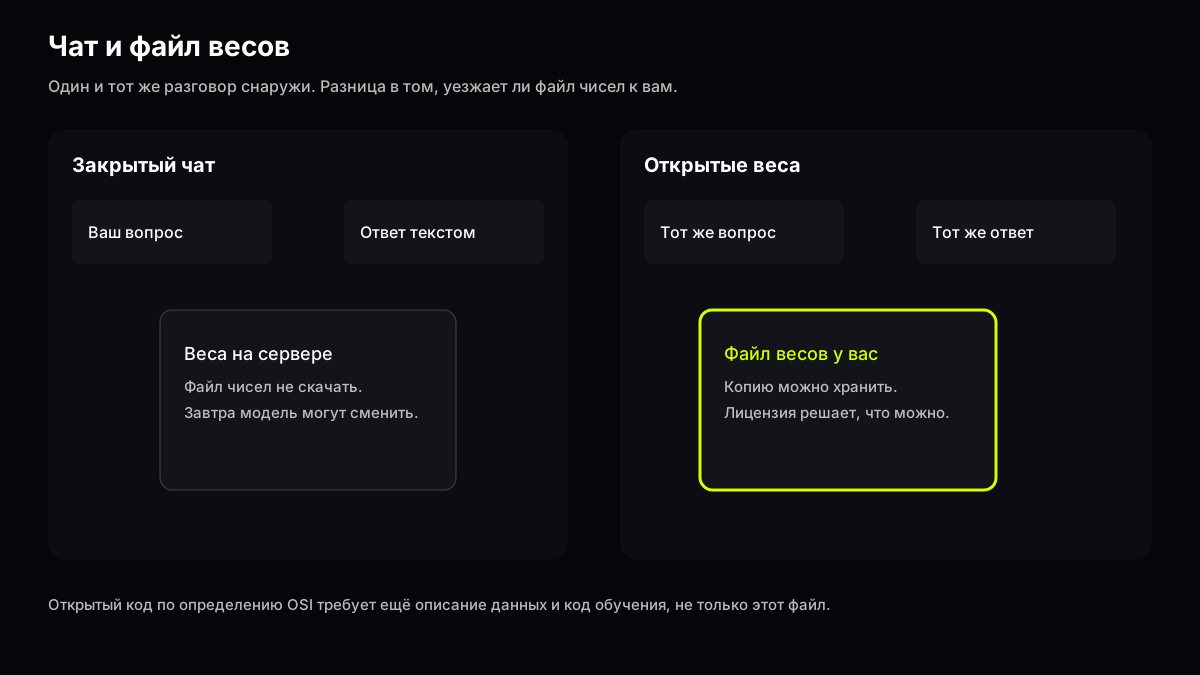
Схема чата и файла весов, иллюстрация GPThub
Чат — окно. Вы отправляете текст, на чужом сервере программа прогоняет его через веса, назад приходит текст. Где лежит таблица чисел, из окна не видно. Закрытая модель устроена так же, как открытая, на уровне разговора: вопрос, следующее слово, ответ. Разница в том, можно ли забрать таблицу и запустить её без этого окна.
Технический отчёт GPT-4, первая версия 15 марта 2023 года, последняя правка 4 марта 2024-го, описывает модель как трансформер, который учится предсказывать следующий токен. К странице отчёта не приложен файл весов. Архитектуру, размер, железо и состав данных отчёт в открытый доступ не кладёт тем способом, каким кладут скачиваемую модель. Чат при этом работал у миллионов людей. Продукт и файл — разные публикации. Одну сделали, вторую нет.
Обратная сторона тоже обычная. У DeepSeek есть и сайт chat.deepseek.com, и репозитории с весами. Окно не доказывает, что веса закрыты. Ссылка на скачивание не доказывает, что у компании нет своего чата. В январе 2025 года рассуждающая R1 вышла так, что оба канала существовали сразу: на сайте кнопка глубокого обдумывания, в репозитории файл и лицензия MIT на код и на веса. Статья о ней подана 22 января 2025 года. В сопроводительном тексте компания пишет, что коммерческое использование разрешено, правки и производные тоже, включая обучение других моделей на следах R1.
Поэтому фраза «мы поговорили с открытой нейросетью» почти пустая. Вы говорили с окном. Открытость проверяется не качеством ответа, а тем, есть ли файл, на каких условиях и совпадает ли он с тем, что отвечает в окне. Последнее как раз часто не совпадает. Сайт могут обновить ночью, а выложенный в январе архив останется январским. Хороший ответ в браузере не означает, что у вас на диске та же таблица.
Есть и третья сборка: веса открыты, но разговаривать с ними без своего железа тяжело. V3 в репозитории требует связку из нескольких машин с видеокартами, если не резать точность и не звать чужой сервер. Для человека, которому нужно письмо или конспект, это не преимущество. Для лаборатории, которая хочет дообучить модель на своих документах и не отправлять их наружу, это и есть весь смысл файла. Одна и та же «открытость» для этих двоих означает разное.
Дообучение — отдельная операция. Берут чужие веса и крутят их дальше на своём наборе. 27 сентября 2023 года Meta писала о тысячах таких производных Llama. У R1 компания сама выложила шесть плотных моделей поменьше, от 1,5 до 70 миллиардов, доученных на примерах большой R1. Четыре стоят на Qwen 2.5, две на Llama. В лицензионном разделе репозитория прямо сказано: у маленьких Qwen исходная лицензия Apache 2.0, у Llama-вариантов — лицензии Llama 3.1 и Llama 3.3. Файл можно отдать. Условия исходной модели к нему прилипают.
Чем это отличается от открытого кода
Слово «открытый код» люди переносят с программ. Там исходный текст — та форма, в которой программу правят. У сети правят в основном не текст, а числа, и числа получаются из данных. 28 октября 2024 года Open Source Initiative, организация, которая с 1998 года ведёт определение открытого кода, выпустила первую стабильную версию определения открытого ИИ. Повод они сами формулируют так: пункт классического определения требует исходный код в предпочтительной для правок форме, а что считать такой формой у обучаемой системы, до этого не было договорено.
Определение требует четыре свободы: пользоваться в любых целях без спроса, изучать устройство, менять, в том числе чтобы менялся ответ, и передавать дальше с правками или без. Для машинного обучения предпочтительная форма собрана из трёх пачек.
Первая — сведения о данных. Настолько подробные, чтобы умеющий человек собрал существенно похожую систему. В списке полное описание всех данных обучения, включая те, которыми нельзя поделиться: откуда они, какой охват, как отбирали и размечали, как фильтровали. Плюс перечень общедоступных наборов и где их взять. Плюс перечень платных. Вторая пачка — код: обработка данных, обучение с аргументами запуска, проверки, токенизатор, код вывода ответа, архитектура. Третья — параметры, то есть веса и настройки. Все три пачки должны быть на условиях, которые OSI считает открытыми.
Дальше в том же тексте отдельный абзац, из-за которого спорят до сих пор. «Открытые модели» и «открытые веса» в смысле этого определения тоже должны включать сведения о данных и код, из которых параметры получились. Одного файла чисел мало, даже если файл отдают и разрешают коммерцию. OSI не навязывает конкретный юридический инструмент: параметры могут быть свободны по своей природе или по лицензии. Организация пишет, что право ещё не успело это устаканить.
В обзоре итогов 2024 года, 17 декабря, OSI перечисляет, кого уже сверяли с черновиком критериев. По их оценке, под определение подходили OLMo института AI2, Pythia от Eleuther AI и ещё две исследовательские системы. Не подходили Llama 2 от Meta, Phi-2 от Microsoft, Mixtral от Mistral и Grok. Это оценка OSI, не приговор суда. Она полезна как линейка: компании называют модели открытыми по другой линейке, обычно по наличию файла весов.
Путаница держится потому, что обе линейки отвечают на разные вопросы. Линейка «можно ли скачать числа» важна тому, кто хочет запустить копию. Линейка OSI важна тому, кто хочет повторить обучение или проверить, на чём сеть выросла. Новость, которая ставит знак равенства, склеивает два вопроса в один заголовок.
Данные — самая частая недостача. Веса R1 лежат под MIT, а полный перечень текстов обучения к ним не приложен так, как требует OSI. Код V3 тоже под MIT, модель при этом на отдельном соглашении от 23 октября 2023 года: в нём есть запреты по способу применения, и военное использование названо прямо. Соглашение разрешает коммерческий запуск, репозиторий это подтверждает отдельной фразой. Разрешённый магазин и свободная лицензия кода снова не одно и то же. Повторить обучение V3 по публичным материалам нельзя ещё и по деньгам: в репозитории полное обучение оценено в 2,788 миллиона часов видеокарт H800. Часы — не смета в валюте. Это размер работы, который компания сама поставила рядом с файлом.
Три лицензии, три разных «открыто»
Имеет смысл разложить три живых комплекта, не выбирая победителя. Победителя нет: у каждого комплекта свой замок, и замок написан до скачивания.
Llama 2 и Llama 4. Файл весов есть, код запуска есть, лицензия авторская. Порог в 700 миллионов активных пользователей в месяц отсекает крупнейшие продукты на дату выхода версии. Для мастерской, университета и обычного сервиса порог далеко. Для компании масштаба поисковика или соцсети он как раз про них, и без отдельного «да» от Meta лицензия не включается. У Llama 2 добавлен запрет улучшать чужие большие языковые модели выходами Llama. У Llama 4 в соглашении другие формулировки распространения и обязательная пометка в уведомлении: модель лицензирована по Llama 4 Community License, права у Meta. Скачивание свободное в бытовом смысле. Свобода в смысле OSI — нет, и сама OSI это про Llama 2 уже записала.
Mistral. 27 сентября 2023 года Mistral 7B вышла под Apache 2.0, лицензией, которую OSI для кода принимает давно. 2 декабря 2025 года то же сделали с поколением Mistral 3: три плотные модели на 14, 8 и 3 миллиарда параметров и Mistral Large 3, смесь экспертов, 41 миллиард активных при 675 миллиардах общих. В посте сказано, что все они под Apache 2.0, базовые и дообученные на инструкции. 6 октября 2026 года компания показала Mistral Large 4 и написала, что веса откроет до конца месяца. 29 октября 2026 года веса вышли. В заметке модель названа триллионной, лицензия — Mistral Ecosystem Open-Weight, изменённый MIT. Пользоваться, менять, дообучать и продавать продукты можно. Отдельное условие одно: кто сдаёт саму модель как услугу, то есть чужим людям по сети, перед коммерческим запуском берёт у Mistral отдельную лицензию. Справка компании от 12 августа 2026 года описывает похожую развилку у части моделей: изменённый MIT, и при месячной выручке выше определённого уровня либо коммерческая лицензия, либо их студия. Порог выручки в той справке лучше читать в оригинале, в статью сумму не тащу. Для сюжета достаточно развилки. Apache 2.0 на маленьких моделях и особая лицензия на флагмане 2026 года живут у одного разработчика одновременно.
DeepSeek. Код V3 — MIT. Веса V3 — модельное соглашение с запретами: нельзя нарушать закон, нельзя военное применение, нельзя вредить несовершеннолетним, нельзя автоматизированно решать так, чтобы у человека менялись юридические права, и ещё несколько пунктов в приложении. Производные модели должны тащить те же запреты. R1, вышедшая следом, на этот шаблон не встала: репозиторий помечает и код, и веса как MIT и отдельно разрешает дистилляцию. Кто читает «у DeepSeek всё под MIT», смешивает два репозитория. Подробный разбор семьи, включая более поздние версии, лежит в материале что такое DeepSeek. Про флагман Mistral осени 2026 года — в разборе Mistral Large 4.
| Что выложили | Когда | Файл весов | Лицензия, коротко |
|---|---|---|---|
| Llama 2, 7–70 млрд | 18 июля 2023 | да | своя, порог 700 млн пользователей |
| Mistral 7B, 7,3 млрд | 27 сентября 2023 | да | Apache 2.0 |
| DeepSeek-V3, 671 / 37 млрд | репозиторий к отчёту | да | код MIT, модель — соглашение с запретами |
| DeepSeek-R1, 671 / 37 млрд | репозиторий, январь 2025 | да | MIT, дистилляция разрешена |
| Llama 4 Scout и Maverick | 5 апреля 2025 | да | своя, снова порог 700 млн |
| Mistral Large 3, 675 / 41 млрд | 2 декабря 2025 | да | Apache 2.0 |
| Mistral Large 4 | веса 29 октября 2026 | да | изменённый MIT, услуга «модель по сети» отдельно |
Таблица не ранжирует качество ответов. Она ранжирует только щеколду. Модель под Apache 2.0 может отвечать слабее модели под авторской лицензией, и для письма это важнее щеколды. Для архива, который должен пережить смену настроения компании, щеколда важнее гладкости абзаца.
Что из этого следует дома
Домашняя развилка простая, и она не про идеологию. Если задача — написать, перевести, разобрать учебный текст, окно чата уже содержит чужие веса на чужом сервере. Скачивание файла этого не улучшает: файл ещё надо где-то запустить, а сильные комплекты считаются на машинах, которых дома нет. Scout в анонсе Meta помещается на одну H100 только при том же четырёхбитном сжатии. Это серверная карта, не ноутбук. V3 по инструкции репозитория и вовсе про несколько машин.
Файл начинает иметь смысл в трёх случаях. Первый: вы храните тексты, которые нельзя отправлять в чужое окно, и готовы платить за свои машины или за чужие, где крутится именно ваш экземпляр. Второй: вам нужно дообучить модель на своих примерах, а не надеяться, что общий чат «запомнит стиль». Третий: вы сверяете новости и хотите копию, которая не изменится завтра вместе с кнопкой на сайте. Во всех трёх случаях следующим документом идёт лицензия, не таблица бенчмарков.
Для России отдельная бытовая деталь — размер. Сотни миллиардов параметров не приезжают «в телеграм за минуту» и не встают на обычный диск рядом с фильмом, если говорить о полной точности. Сжатые записи и модели на несколько миллиардов живут легче. Модели Ministral на 3, 8 и 14 миллиардов из того же выпуска вышли 2 декабря 2025 года под Apache 2.0. Маленький открытый файл и большой открытый файл — одна идея и разная жизнь. Путать их в совете «поставьте себе открытую нейросеть» безответственно, поэтому такого совета здесь нет.
Чат при этом не становится хуже от того, что где-то лежит файл. Он становится другим продуктом: его обновляют, к нему прикручивают поиск, ограничения, память диалога. Открытые веса этих надстроек не включают. Вы получаете таблицу чисел и код, который умеет в неё постучать. Всё, что в окне кажется «самой нейросетью» — кнопки, история, фильтр, — к файлу часто не прилагается. Ждать от скачанной копии поведения сайта наивно.
Если хочется просто увидеть, как отвечает модель из семьи, которая веса публиковала, достаточно окна. Карточка DeepSeek V4 Flash ведёт в такой разговор. Как выбирать между окнами, когда моделей несколько, написано в руководстве как выбрать модель: там критерии задачи, здесь только устройство файла.
Проверка, которую имеет смысл сделать один раз, короткая. Спросите в окне, под какой лицензией вышли веса и сколько у модели параметров, общих и активных. Потом откройте пост разработчика, не ответ сети. Сеть охотно называет чужую лицензию и чужой размер: она дописывает правдоподобный текст, а не читает соглашение. Совпадение с постом — хорошая примета аккуратности. Расхождение — обычная работа генератора, не повод цитировать её в учебном реферате. Сверять стоит три вещи: дату файла, имя лицензии дословно, две цифры размера, если модель на смеси экспертов.
Вторая проверка — на подмену окна и файла. Если сервис пишет «у нас открытая модель», найдите ссылку на архив и текст лицензии рядом. Нет ссылки — это рассказ о чужом файле или о своём закрытом. Есть ссылка, но в окне не названа дата сборки — вы не знаете, тот ли архив отвечает. Для бытового письма хватает и так. Для решения «оставить ли документы на этой стороне» даты уже мало, нужна ещё политика хранения, и она к весам не приклеена.
Как читать новость про открытую модель
Шаблон заголовка уже устойчивый. «Компания открыла модель и догнала закрытых». Внутри обычно пять разных утверждений, и они выживают по отдельности.
Первое: появился чат или доступ по интерфейсу программиста. Это продукт. Веса могли остаться на их сервере, как у GPT-4 в публичном отчёте.
Второе: выложили финальные веса. Это файл. Смотрите размер в параметрах и, для смеси экспертов, активную долю. Смотрите формат чисел, если собираетесь запускать, а не читать новость.
Третье: назвали лицензию. Ищите порог по пользователям, запрет способов применения, запрет обучать чужие модели, отдельное правило для тех, кто сдаёт модель как услугу. «Почти MIT» и «MIT» различаются одним абзацем, и абзац как раз про вас, если вы не читатель, а получатель файла.
Четвёртое: приложили код обучения и описание данных. Вот здесь включается линейка OSI от 28 октября 2024 года. Без этих двух пачек честный заголовок — «открытые веса», не «открытый код» и не «открытая система» в их смысле. Компании слово всё равно ставят. Читателю полезнее подставить то, что лежит по ссылке.
Пятое: обещают веса позже. Mistral 6 октября 2026 года так и написала про Large 4: предварительный показ есть, файл будет к концу месяца. Файл приехал 29 октября. До этой даты «открытая модель» в заголовке была обещанием. После — файлом на особой лицензии. Обещание и файл в одну строку не ставят, даже если оба от одной компании и оба сбылись.
Бенчмарки в том же посте — заявление разработчика о своих измерениях, пока нет независимой таблицы с датой. У R1 в репозитории на AIME 2024 указано 79,8% с первой попытки против 79,2% у OpenAI o1-1217 в их столбце. Это их таблица, температура и длина ответа заданы ими же, максимум генерации 32 768 токенов. Цифра годится как ориентир из первоисточника. Она не годится как вечная медаль: экзамен, сборка и способ подсчёта живут меньше, чем файл на диске.
Дальше по рынку будет то же трение. Кто-то продолжит отдавать маленькие модели под Apache 2.0, а большие — под именной лицензией с одним коммерческим замком. Кто-то оставит чат и перестанет обновлять файл. Кто-то, как OSI, будет настаивать на данных. Если в заметке есть только слово «открытая», имеет смысл открыть лицензию и список файлов. Два экрана текста экономят больше, чем абзац восторга.
На ближайшие годы спор, похоже, останется про данные, не про сам файл. Файл весов компании уже научились отдавать: с 2023 по 2026 год это сделали и Meta, и Mistral, и DeepSeek, при разном размере и разной щеколде. Повторить обучение «существенно похожей системы», как требует OSI, почти никто из больших выпусков не предлагает. Пока так, точное имя для большинства громких новостей — открытые веса. Открытый код в старом смысле слова к ним подходит только кусками: код запуска да, журнал данных нет.
Вопросы и ответы
Что такое открытые веса?
Это файл чисел, которые языковая или другая сеть подогнала во время обучения, если файл можно забрать и запускать у себя в рамках лицензии. Архитектура задаёт, куда числа класть. Сами числа и есть выученное. Определение OSI от 28 октября 2024 года называет веса набором параметров поверх архитектуры. «Открытые» добавляет условие публикации. Без файла слово не работает.
Веса нейросети что это, если коротко?
Одно число — параметр. Все параметры вместе — веса. Сеть не хранит правила русского языка отдельным списком. Она хранит миллиарды чисел, по которым из куска текста получается следующее слово. До обучения числа случайны или взяты из другой модели. После обучения это и есть модель в бытовом смысле, если рядом лежит код запуска.
Открытая нейросеть что это?
В разговоре так называют сразу три вещи: чат без оплаты, модель с публичными весами и систему, которая проходит определение открытого ИИ. Это разные объекты. Чат может быть закрыт по весам. Веса могут быть публичны и при этом на лицензии с запретами. Определение OSI от 28 октября 2024 года требует свободы пользования, изучения, изменения и передачи, а к ним сведения о данных, код и параметры. Пока в новости не сказано, какой из трёх смыслов имеется в виду, фраза «открытая нейросеть» ничего не обещает.
Модели ИИ с открытым кодом и открытые веса — одно и то же?
Нет. Открытый код в определении OSI для ИИ включает данные, код обучения и веса. Открытые веса — только третью пачку, иногда с коротким кодом запуска. Llama 2, по оценке OSI в обзоре от 17 декабря 2024 года, под полное определение не попала, хотя файл с 18 июля 2023 года скачивали. Mistral 7B под Apache 2.0 ближе к привычному открытому коду по лицензии на модель, но и там публикация всех данных обучения — отдельный вопрос, его пост от 27 сентября 2023 года не закрывает.
ИИ модели с открытым исходным кодом: что смотреть в лицензии?
Четыре пункта, до бенчмарков. Можно ли коммерчески пользоваться. Есть ли порог размера компании или числа пользователей, как 700 миллионов в месяц у Llama 2 и Llama 4. Нельзя ли обучать на выходах чужую модель. Обязаны ли производные тащить те же запреты, как в модельном соглашении DeepSeek от 23 октября 2023 года. Если сдаёте чужим саму модель по сети, проверьте, не вынесено ли это в отдельную лицензию: у Mistral Large 4 с 29 октября 2026 года вынесено.
Какие открытые модели сильнее?
Сила зависит от задачи и от даты замера, а единой вечной полки нет. Имеет смысл читать таблицу того, кто мерил, и не склеивать столбцы разных лет. Для письма и учёбы разница между верхними файлами часто меньше, чем разница между «есть окно» и «надо поднимать сервер». Для своего архива документов решают лицензия и то, уедут ли тексты наружу. Сравнение по задаче, а не по званию, как раз про выбор окна, и оно живёт в руководстве по выбору модели.
Связанные модели

Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- Llama 2: публикация и лицензия, 18 июля 2023
- Заметка Meta о первых запросах на скачивание, 28 июля 2023
- Экосистема Llama: скачивания и производные, 27 сентября 2023
- Первая LLaMA, некоммерческий доступ по заявке, 24 февраля 2023
- Llama 4 Scout и Maverick, 5 апреля 2025
- Mistral 7B под Apache 2.0, 27 сентября 2023
- Mistral 3 и Large 3 под Apache 2.0, 2 декабря 2025
- Анонс Mistral Large 4, веса обещаны до конца месяца, 6 октября 2026
- Веса Mistral Large 4 и лицензия, 29 октября 2026
- Справка Mistral о лицензиях открытых моделей, 12 августа 2026
- Определение открытого ИИ, версия 1.0, 28 октября 2024
- Итоги года OSI: кого сверяли с определением, 17 декабря 2024
- Репозиторий DeepSeek-V3: размеры, лицензии, часы обучения
- Репозиторий DeepSeek-R1: MIT, дистилляции, таблица AIME
- Технический отчёт GPT-4, arXiv, 15 марта 2023
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.