
"Водяной знак нейросети: что это за метка на картинке и видео"

Обозреватель: как устроен ИИ
Содержание
7 октября 2026 года Google открыл SynthID Detector для всех: загрузить картинку, ролик или запись и спросить, нет ли в файле метки генератора, теперь может любой человек, пока только в английском интерфейсе. Раньше портал выдавали журналистам и редакциям. Новость быстро пересказали как «у нейросетей появился водяной знак», и в этой фразе смешались три разных механизма. Один виден глазом, второй лежит в служебных данных файла, третий спрятан в самих пикселях. Живут они по-разному, и пересылку переживает далеко не каждый.
Водяные знаки нейросетей: три слоя вместо одного
Первое, что представляет себе почти любой, — полупрозрачный логотип фотобанка в углу кадра. Аналогия верна только на треть. Такой слой у генераторов действительно встречается: приложение рисует плашку поверх готовой картинки или подписывает её в интерфейсе. Человек видит его сразу, и он же исчезает первым — достаточно обрезать край кадра.
Второй слой — Content Credentials, их же называют метаданными C2PA. Это подписанный пакет данных внутри файла, поверх изображения ничего не рисуется. В пакете (его называют манифестом) записаны издатель, программа, время и пометка о том, что результат синтетический. Стандарт ведёт коалиция C2PA (Coalition for Content Provenance and Authenticity), и камеры, агентства и генераторы пользуются одной схемой, чтобы историю файла читали одни и те же инструменты. В версии спецификации 2.4 от 1 апреля 2026 года есть отдельное утверждение о раскрытии участия ИИ, а для чистой генерации коалиция рекомендует тип источника trainedAlgorithmicMedia и действие c2pa.created.
Третий слой — невидимая метка в пикселях, в звуковой дорожке или в статистике текста. Вариант Google называется SynthID. Сигнал встраивают в момент создания, глаз его не замечает, а отдельный детектор находит шаблон и после обрезки, и после сжатия. Причём SynthID теперь не только про Google: OpenAI ставит эту метку на картинки из ChatGPT, Codex и своего API поверх Content Credentials. В справке OpenAI роли разведены так: метаданные дают контекст, а метка в содержимом переживает шаги, на которых манифест уже потерян.
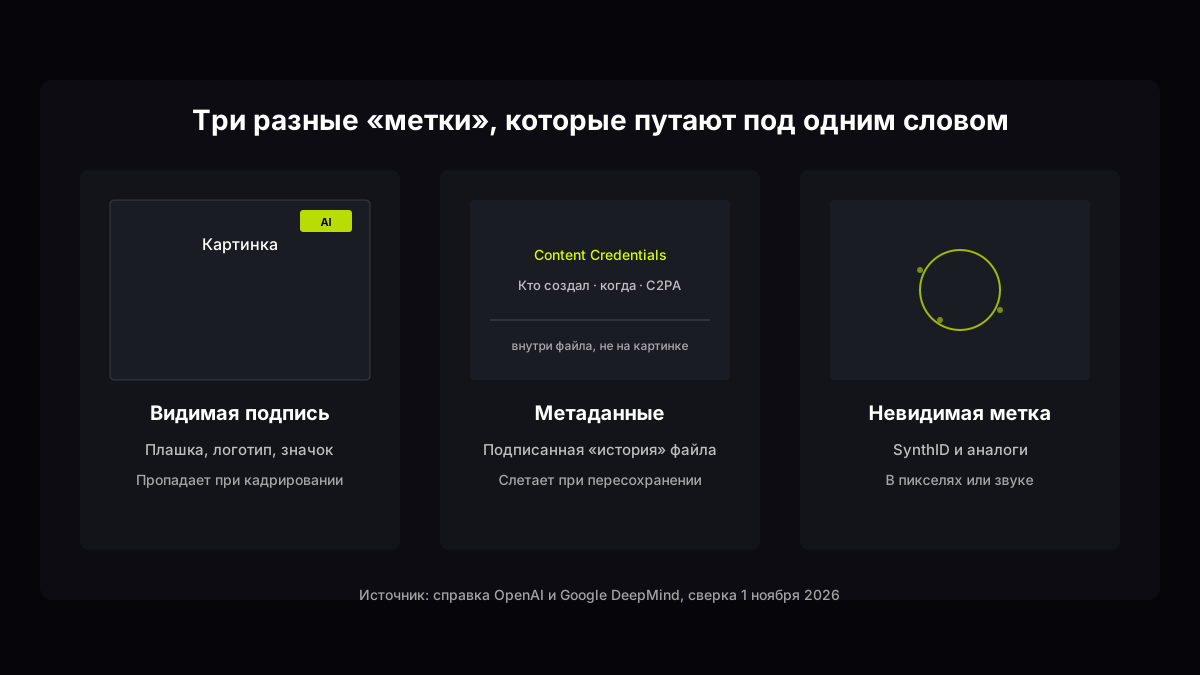
Схема трёх слоёв метки, иллюстрация GPThub
Термины удобно держать связкой. Видимая метка — то, что заметно без программ. Content Credentials — подписанный «паспорт» файла. Невидимый водяной знак — изменения в самих данных картинки, звука или текста, которые адресованы детектору.
Почему логотип в углу объясняет только часть
Разработчики редко ограничиваются одной плашкой. В документации OpenAI для разработчиков прямо сказано, что видимые водяные знаки и подписи существуют отдельно от сигналов происхождения, которые проверяет сервис verify. Файл может прийти без всякой заметной надписи и при этом нести и C2PA, и SynthID. Бывает и наоборот: плашка видна в приложении, а после «Сохранить как» на диске оказывается файл без метаданных.
Adobe Firefly обходится вовсе без логотипа. На файлы, где все пиксели созданы Firefly, компания автоматически добавляет Content Credentials. В Photoshop и Lightroom такая подпись включается по выбору пользователя и может нести дополнительные поля. Прочитать историю можно в инструменте Inspect на сайте Content Authenticity — если файл по дороге не прошёл через программу, которая срезает метаданные.
Вывод неудобный, но простой. Превью в приложении и файл на диске — разные объекты. Кнопка «Поделиться» часто отдаёт уже пересжатую копию. Сервис доставки картинок, который на лету уменьшает ширину, заодно стирает C2PA. Руководство на docs.c2pa.design перечисляет типичные потери: изменение размера, сохранение через canvas в браузере, перекодирование ffmpeg, загрузка в соцсеть, скриншот. Сохраняют подпись только побайтовое копирование и отдача оригинала без преобразований.
Как устроены Content Credentials
Content Credential — криптографически привязанный к файлу манифест, по сути журнал действий: «создано», «открыто в редакторе», «обрезано», «опубликовано». Когда генератор впервые выпускает картинку, в журнал попадает действие c2pa.created с временем, именем программы и типом источника. Если потом файл открыли в редакторе с поддержкой C2PA, новая запись добавляется к цепочке, старая не затирается. По такой цепочке видно, где закончилась генерация и началась ручная правка.
OpenAI называет себя генератором, соответствующим требованиям C2PA (conforming generator), так что площадки, которые читают стандарт, могут проверить подпись при передаче файла дальше. Google пишет, что в ряде продуктов использует и SynthID, и Content Credentials. А смартфон Pixel 10 стал, по словам Google, первым телефоном, камера которого сама записывает Content Credentials при съёмке, — стандарт вообще задумывался шире, чем подпись нейросетей.
Слабое место — момент, когда подпись умирает. Типичная история: из генератора скачали PNG с полным манифестом, прогнали через онлайн-сжималку, получили лёгкий WebP, и проверка уже ничего не находит. Это не значит «рисовал человек». Это значит, что след в файле стёрли, и остаётся только невидимый слой, если он пережил перекодирование.
| Действие | Content Credentials |
|---|---|
| Сохранить оригинал из генератора | обычно на месте |
| Обрезать или уменьшить в редакторе без C2PA | пропадают или ломаются |
| Отправить скриншот в чат | пропадают |
| Перекодировать видео через ffmpeg | пропадают |
| Отправить через мессенджер со сжатием | часто пропадают |
Невидимая метка: как работает SynthID
Google DeepMind описывает SynthID как водяной знак для картинок, видео, аудио и текста. В изображение сигнал добавляют при генерации, и по описанию DeepMind он рассчитан пережить обрезку, фильтры, смену частоты кадров и сжатие с потерями. Для текста в Gemini схема другая: модель слегка меняет вероятности выбора следующего токена — минимального кусочка слова, — так что текст читается как обычно, а детектор узнаёт статистический рисунок. Для звука DeepMind обещает устойчивость к добавленному шуму, сжатию в MP3 и изменению скорости.
Масштаб уже заметный. К 7 октября 2026 года Google пометил SynthID больше 180 миллиардов изображений и видео и 240 000 лет аудио в пересчёте на длительность. Для сравнения, в мае компания называла 100 миллиардов изображений и видео и 60 000 лет аудио — за пять месяцев счёт почти удвоился. Детектор находит метки не только Google: в партнёрах названы OpenAI, NVIDIA и Kakao, а Apple на странице DeepMind значится как «скоро». Проверить файл можно и без портала: в Gemini, Поиске Google и Chrome достаточно загрузить его и спросить, сделан ли он с помощью ИИ Google. Такие проверки, по данным Google, обрабатывают больше миллиона запросов в день.
У OpenAI собственный инструмент: страница openai.com/verify и метод API content_provenance_checks, которые ищут C2PA и SynthID в её форматах. Ответ различает «сигнал найден» и «сигнал не найден». Второе означает только одно — поддерживаемых следов в этом файле нет.
Нейросеть и водяные знаки на видео
Видео — поток кадров плюс звук, и метка ложится на оба. DeepMind для роликов Veo описывает схему так: сигнал встраивается в пиксели каждого кадра по тому же принципу, что и в статичную картинку. Если ролик обрезали по длине или сменили частоту кадров, часть меток всё ещё читается. А вот Content Credentials в контейнере MP4 при типичном перекодировании пропадают так же, как у JPEG.
OpenAI в своей справке относит к видео Content Credentials и отдельно упоминает, что Sora снята с поддержки, так что старые обзоры про метки на роликах Sora уже мало что говорят о текущих продуктах. Google в мае 2026 года обещал «в ближайшие недели» распространить Content Credentials на видео с камер Pixel 8, 9 и 10.
Если вы путаетесь, где генерация, а где монтаж, начните с разбора нейросетей для видео: там разведены «сделать кадр из текста» и «склеить снятое». Метка генератора не появится на материале, снятом на камеру, пока вы сами не прогоните его через генератор или редактор с C2PA.
Что проверять в готовом ролике
Прежде всего — какой файл вы проверяете. Короткий клип из генератора обычно приходит в MP4; если его сразу нарезали в монтажной программе без поддержки C2PA, проверять стоит исходный экспорт, а не финальную версию для вертикальной ленты. Второе — звук: портал SynthID Detector принимает и видео, и аудио, так что дорожку можно проверить отдельно. Третье — склейка: ролик из нескольких кусков может нести смешанные следы, и детектор покажет только то, что осталось именно в этом файле.
Что изменилось в правилах ЕС
Со 2 августа 2026 года в Евросоюзе действует статья 50 Закона об ИИ (AI Act). Поставщики систем, которые выдают синтетические аудио, изображения, видео или текст, обязаны помечать результат в машиночитаемом виде и давать средства его обнаружения. Водяной знак — лишь один из допустимых способов; в разъяснениях Еврокомиссии рядом названы метаданные, криптографическое подтверждение происхождения, цифровые отпечатки и их комбинации.
Для дипфейков — материала, который выглядит как реальный человек, место или событие и может ввести зрителя в заблуждение, — обязанность ложится и на того, кто его показывает. Раскрытие должно быть заметно человеку при первом показе: видимая или слышимая пометка. Одного машиночитаемого следа внутри файла для такого распространителя мало.
Переходный срок короткий. Системы, выведенные на рынок до 2 августа 2026 года, должны внедрить маркировку по пункту 50(2) к 2 декабря 2026 года. Контент, созданный раньше 2 августа, задним числом помечать не требуют. В России прямого аналога в одном документе нет, и на практике авторы упираются в правила площадок и в то, переживёт ли файл пересылку.
Что делает с меткой площадка
Генератор отвечает за первый слой, автор — за то, какой файл он хранит, а зритель почти всегда видит уже переупакованную копию. В посте Google от мая 2026 года описан именно этот разрыв: SynthID встроен в модели Google, Content Credentials ставятся и на съёмку с Pixel, и на генерацию, а дальше файл уходит в ленту, мессенджер или на видеохостинг, и каждый узел сам решает, сохранить ли манифест.
YouTube в том же тексте упомянут как площадка, которая помечает ролики, созданные или существенно изменённые ИИ. Это подпись для зрителя под видео; байты внутри загруженного файла остаются прежними. Для автора здесь два независимых вопроса: есть ли след в моём исходнике и как площадка покажет ролик зрителю. Ответы могут расходиться, и это нормально.
Соцсети и мессенджеры почти не публикуют таблиц «что мы делаем с C2PA». Руководство c2pa.design здесь надёжнее любых обещаний: загрузка в ленту и скриншот почти всегда оставляют файл без подписи. Поэтому спор «в архиве метка была, в Telegram нет» обычно описывает пересылку. Генератор тут ни при чём. Если кадр может стать предметом разбирательства, храните оригинал экспорта отдельно от превью в чате.
Чем больше файлов помечено согласованно, тем чаще детектор что-то находит. Но универсального детектора любого ИИ по-прежнему нет: каждый инструмент видит только свои и партнёрские метки.
Привычка, которая экономит споры
Когда над картинкой работают несколько человек, один скачивает кадр из генератора, второй кладёт его в макет, третий выгружает файл для заказчика. На каждом шаге полезно знать, сохраняет ли программа Content Credentials. Photoshop и Lightroom умеют дописывать историю, если подпись включена; простой экспорт «для сайта» в стороннем редакторе часто оставляет только пиксели. Первый экспорт с манифестом имеет смысл класть в папку с датой и названием модели, даже если заказчику уходит другая копия.
Ещё полезнее один раз прогнать тестовый файл через свою обычную цепочку «генератор — монтаж — публикация» и сохранить промежуточные версии. Тогда при претензии можно показать, на каком шаге след исчез. Если вы отдаёте работу ссылкой на облако, договоритесь заранее, какой файл считается оригиналом. Заказчик, который открыл ссылку на телефоне и сохранил картинку долгим нажатием, почти наверняка получил копию без C2PA, хотя генератор отработал правильно.
Как проверить файл, не гадая на глаз
Порядок действий без всякой магии:
- Сохраните первый экспорт из генератора, до мессенджеров и сервисов сжатия.
- Загрузите его в подходящий инструмент: openai.com/verify для следов OpenAI, SynthID Detector для меток Google и партнёров, Inspect на сайте Content Authenticity для подписей Adobe и других генераторов с C2PA.
- Прочитайте формулировку результата. «Не обнаружено» значит, что поддерживаемый сигнал не найден, и не больше.
- Если нужна цепочка правок, проверяйте каждый промежуточный файл: стоит одной программе без C2PA вмешаться, и история оборвётся.
Про форматы и экспорт подробно написано в гайде по работе с картинками. Здесь важно одно добавление. Снимок экрана с превью почти всегда хуже кнопки «Скачать»: браузер рисует новую растровую копию без манифеста. Тот же риск у команды «Копировать изображение» — в буфер попадают пиксели, а не исходный PNG с историей. Для проверки берите файл с диска.
Разбор одного случая
Возьмём ситуацию, которая встречается постоянно. Коллега присылает в рабочий чат эффектную картинку и спрашивает, настоящая ли она. Что можно сделать по шагам.
Сначала — понять, что у вас в руках. Картинка из мессенджера почти наверняка пересжата, Content Credentials в ней, скорее всего, уже нет. Проверка на сайте Content Authenticity, скорее всего, ничего не покажет, и это ничего не доказывает.
Дальше — невидимый слой. Его шансы выше: SynthID рассчитан на сжатие с потерями. Загрузите файл в SynthID Detector или задайте вопрос в Gemini. Если метка найдена, у вас есть сильный довод, что картинку сделала модель Google или партнёра. Если нет, вариантов остаётся три: картинку сделал человек, её сделала модель без SynthID, или метку разрушила обработка.
Третий шаг — источник. Попросите у коллеги ссылку на исходную публикацию или оригинальный файл. Оригинал из генератора с подписью C2PA снимет вопрос сразу. Если оригинала нет и метки нет, честный ответ звучит как «не знаю», и этого ответа не стоит стесняться.
Чего делать не нужно: судить по «странным пальцам» и «слишком гладкой коже». Свежие модели давно рисуют руки без ошибок, а живые фотографии после обработки в телефоне бывают глаже любой генерации. Подробнее о том, как вообще устроены генераторы и откуда у них характерные огрехи, — в статье о нейросетях для картинок.
Где метки нет совсем
Всё сказанное относится к крупным разработчикам, которые сами решили ставить метки. Открытые модели, которые люди запускают на своём компьютере, ничего подобного делать не обязаны: что окажется в файле, решает тот, кто собрал программу. Поэтому отсутствие метки в файле говорит о нём очень мало. Его могла сделать открытая модель, сервис без поддержки C2PA или живой фотограф.
Есть и обратная сторона. Content Credentials не мешают человеку просто переснять экран другим телефоном, и тогда в новом файле окажется подпись камеры, а не генератора. Стандарт защищает подлинность записи о файле, но не может запретить сделать новый файл. Невидимый слой в такой ситуации иногда выживает, иногда нет — DeepMind описывает устойчивость SynthID словами «рассчитан выдержать», без процентов.
Отсюда практичная позиция. Метку стоит воспринимать как доказательство в одну сторону: найденная метка многое говорит о происхождении файла, а её отсутствие почти ничего не говорит. Этого достаточно, чтобы в спорной ситуации проверить первым делом именно её, и недостаточно, чтобы на ней одной строить вывод.
Что спросить у модели в чате
Языковая модель не видит метки в вашем файле, но хорошо объясняет, что с ними происходит. Ниже примеры формулировок; смысл важнее букв.
После генерации: «Какие метки происхождения должны быть в оригинале этой картинки по документации разработчика? Какие действия при сохранении их сотрут?» В хорошем ответе будут скачивание оригинала и предупреждение о скриншоте.
Перед публикацией: «Я выкладываю картинку в такую-то соцсеть через телефон. Что из этого сотрёт Content Credentials и останется ли невидимая метка?» Модель должна назвать изменение размера, перекодирование и скриншот и не обещать, что «всё сохранится».
Для ролика: «Где проверять водяной знак на видео — в исходном MP4 или в обрезке для вертикальной ленты?» Сверьте ответ с тем, что детектор принимает только файл; ссылка на видеохостинг не подойдёт.
Для сравнения генераторов полезно сделать по одному файлу в двух моделях на один запрос, например в Nano Banana 2.1 и FLUX 3 Image Klein, — обе уже доступны в чате GPThub. Затем проверьте оба файла теми инструментами, которые подходят под разработчика. Иногда разница между «скачал из браузера» и «сохранил из чата» заметнее разницы между моделями.
Три типичные ошибки. Первая — спрашивать «есть ли тут водяной знак» про скриншот из галереи телефона. Вторая — путать видимую плашку в интерфейсе с содержимым файла. Третья — просить модель гарантировать, что файл пройдёт чужой детектор: инструменты обновляются, а путь файла после чата не контролирует ни генератор, ни вы. О том, как формулировать задачу точнее, — в гайде про промпты.
Текст и звук: метки без картинки
У водяного знака есть и «немые» форматы. OpenAI заявляет SynthID для аудио из ChatGPT и своего API: слух его не ловит, а проверка может найти. С текстом сложнее. По справке OpenAI, ответы ChatGPT в ЕС могут нести метку textGrain, а в API её включают в настройках проекта. Google помечает SynthID текст из приложения Gemini, меняя статистику выбора слов. К C2PA это отношения не имеет: у абзаца нет файла, в котором мог бы лежать манифест.
Для автора вывод скучный. Текст, скопированный через буфер обмена и переписанный своими словами, такую метку практически наверняка теряет, как скриншот теряет C2PA. Если важна прозрачность публикации, её обеспечивает подпись площадки («создано с ИИ») или ваш собственный текст.
Вопросы и ответы
Что такое водяной знак нейросети простыми словами?
Любой след, который связывает файл с генератором: видимая плашка, подписанные метаданные C2PA или невидимые изменения в пикселях и звуке. При пересылке эти три слоя ведут себя по-разному.
Чем водяной знак ИИ отличается от логотипа на фото?
Логотип лежит поверх картинки и исчезает при обрезке. Content Credentials живут внутри файла и несут его историю. Невидимая метка встроена в данные кадра и находится программой, а не глазом.
Ставят ли нейросети водяные знаки на видео?
Да. Google для Veo ставит метку в каждый кадр, OpenAI указывает Content Credentials для видео. После монтажа или перекодирования подпись в контейнере обычно пропадает, а невидимый слой может сохраниться.
Можно ли узнать, что картинка от ChatGPT или Gemini, после пересылки в Telegram?
Иногда. Метаданные C2PA мессенджер чаще всего снимает, у SynthID шансов выжить больше. Надёжнее всего проверить оригинал через openai.com/verify или SynthID Detector, а не сжатую копию из чата.
Обязаны ли сервисы в Европе помечать картинки, созданные ИИ?
Да, со 2 августа 2026 года поставщики генеративных систем обязаны машиночитаемо помечать синтетические изображения, видео, аудио и текст. Тех, кто показывает дипфейки людям, ждёт ещё и видимое или слышимое раскрытие.
Говорит ли водяной знак, можно ли использовать картинку в рекламе?
Нет. Метка сообщает только о происхождении. Права на коммерческое использование задают условия сервиса и ваш договор с заказчиком.
Связанные модели

Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
- Provenance signals in OpenAI-generated content
- Verify OpenAI-generated content
- Advancing content provenance
- Content provenance (API)
- SynthID
- Watermarking AI-generated text and video with SynthID
- SynthID Detector для всех
- Identifying AI-generated media online
- C2PA Specification 2.4
- Use of Content Credentials to identify synthetic and non-synthetic content
- Generated images
- Content Credentials in Adobe Firefly
- Transparency obligations under Article 50 of the AI Act
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат для генерации
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.