
"Kimi: что это за нейросеть Moonshot"

Обозреватель: как устроен ИИ
Содержание
16 июля 2026 года пекинская компания Moonshot выложила описание модели Kimi K3: 2,8 триллиона параметров, окно в один миллион токенов и открытые веса, которые обещали довезти до 27 июля. К этой дате веса действительно появились в открытом хранилище. Для читателя из поиска важнее другое. Kimi — это и чат, и целое семейство моделей, и набор отдельных программ. Kimi K2.6 и Kimi K3 уже доступны в чате GPThub.
Что такое Kimi как нейросеть?
Начать придётся с путаницы в самом слове. В поиске «Kimi нейросеть» и «Kimi AI» ведут на одну и ту же полку, а на ней лежат разные вещи.
Компания — Moonshot AI, юридически Beijing Moonshot AI Technology Co., Ltd. Основатели — Ян Чжилин, Чжоу Синьюй и У Юйсинь, однокурсники по университету Цинхуа. Ян, он же генеральный директор, до этого работал в исследовательских группах Google и Meta и участвовал в модели PanGu компании Huawei. Имя Moonshot и китайское «тёмная сторона Луны» отсылают к альбому Pink Floyd, который вышел за пятьдесят лет до регистрации фирмы.
Kimi — имя помощника и имя линейки моделей. В справке для прессы компания просит формулировку простую: помощник, которого разработала Moonshot. У сервиса два адреса, kimi.com и kimi.ai. Отдельного продукта с табличкой «Kimi AI» нет. Так поисковики склеивают чат, приложение и модели.
Первый чат вышел в октябре 2023 года. Его тогдашняя редкость была в длине, а не в громких оценках. За один разговор он принимал до 200 тысяч китайских иероглифов. 16 ноября того же года чат открыли всем на модели Moonshot с окном 128 тысяч токенов. Весной 2024 года в закрытой пробе окно довели до двух миллионов иероглифов. Иероглиф и токен — не одно и то же. Токен — кусок текста, который модель берёт за один шаг, и китайский знак часто занимает больше одного токена. Поэтому «два миллиона знаков» и «128 тысяч токенов» нельзя складывать в одну линейку.
Дальше компания перестала продавать только длинное окно. В июле 2025 года вышла Kimi K2 с открытыми весами и размером около триллиона параметров. В январе 2026 — K2.5, в апреле — K2.6. 16 июля 2026 — K3. Каждое имя — новая модель, а не тема внутри одного чата.
Рядом по смыслу стоит история DeepSeek: тоже китайская лаборатория, тоже открытые веса, тоже смесь экспертов. Совпадает приём. Не совпадают ни окно, ни то, какие программы компания повесила поверх модели. Третья китайская линейка с открытыми весами, Qwen от Alibaba, разобрана в статье что такое Qwen; здесь повторять её не будем.
Откуда взялась репутация «длинного текста»?
Для понимания нынешних K2.6 и K3 полезно отступить к 2023 году. Тогда почти все чаты держали в голове короткий кусок: вопрос, абзац ответа, и начало беседы уже выпадало. Moonshot поставила на обратное. Длинный документ можно было положить целиком и спрашивать по нему, не нарезая вручную.
Окно контекста — сколько токенов модель держит одновременно: вопрос, вложенный файл и уже написанный ответ. Токен — учётная единица текста, не слово и не буква. Лимит ответа — сколько новых токенов модель имеет право дописать, и он сидит внутри того же окна, а не рядом с ним.
У K2.6 в карточке модели указано 256 тысяч токенов. У K3 окно ровно в четыре раза длиннее, один миллион с небольшим. В документации программного интерфейса серия K3 так и подписана: один миллион токенов. K2.7 Code, отдельная модель для программирования, осталась на том же окне, что и K2.6.
Длинное окно не делает ответ верным. Оно только позволяет не терять начало. На миллионе токенов модель всё равно может перепутать абзац в середине договора или уверенно досочинить сноску, которой в файле не было. Проверка — сверка с исходником, а не вера в длину.
Сама Moonshot в 2026 году уже не продаёт «самое длинное окно в мире» как главный лозунг. В блогах K2.6 и K3 на первом месте код, многошаговая работа и документы. Окно осталось, но перестало быть единственной историей.
Как устроена смесь экспертов?
Схема, на которой стоят и K2.6, и K3, называется смесью экспертов. Её часто рисуют как консилиум: физик, юрист и программист голосуют за ответ. Аналогия врёт в двух местах. Эксперты не разложены по школьным предметам, и никто не голосует. Модель состоит из множества одинаковых по роли блоков. На каждый токен маленькая сеть-маршрутизатор включает несколько блоков. Остальные в этот момент не считают.
Поэтому у каждой такой модели два размера. Общий — все блоки, их надо хранить. Активный — те, что работают на один токен, от них зависит, сколько вычислений уходит на слово. Хранить приходится большую модель, считать — заметно меньшую.
У K2.6 общий размер один триллион параметров, активный 32 миллиарда. Слоёв шестьдесят один, из них один плотный, без смеси. Экспертов несколько сотен, на токен выбирают восемь, плюс один общий эксперт, который участвует всегда. Словарь на сто шестьдесят тысяч кусков. Внимание — многоголовое латентное (в карточке оно подписано MLA): промежуточное состояние сжимают, чтобы длинный текст ел меньше памяти. Функция активации — SwiGLU. Рядом висит зрительный кодировщик MoonViT на четыреста миллионов параметров. Он нужен, чтобы в тот же контур попали картинка и, в официальном интерфейсе, видео.
У K3 цифры другие, и архитектура уже не та же. Общий размер 2,8 триллиона, активный 104 миллиарда. Слоёв девяносто три. Экспертов почти девятьсот, на токен включают шестнадцать, общих экспертов два. Компания называет эту обвязку Stable LatentMoE и пишет, что по эффективности масштабирования K3 примерно в два с половиной раза лучше K2. Это их собственная оценка способа обучения, не независимый экзамен «кто умнее».
Внимание в K3 тоже разрезали на два механизма. Большая часть слоёв — Kimi Delta Attention, приём, которым компания хочет удешевить очень длинную последовательность. Меньшая часть — вариант того же латентного внимания с управляющим затвором (Gated MLA). Активация называется SiTU-GLU. Зрительный кодировщик сменился на MoonViT-V2 и стал чуть крупнее прежнего. Веса хранятся в формате MXFP4, активации — в MXFP8, и модель учили уже с учётом этого огрубления, а не сжимали готовую. В сводной таблице карточки модальности указаны текст и изображение, хотя в списке возможностей рядом упомянуто и видео. У K2.6 видеовход описан отдельно и помечен как экспериментальный даже в официальном интерфейсе.
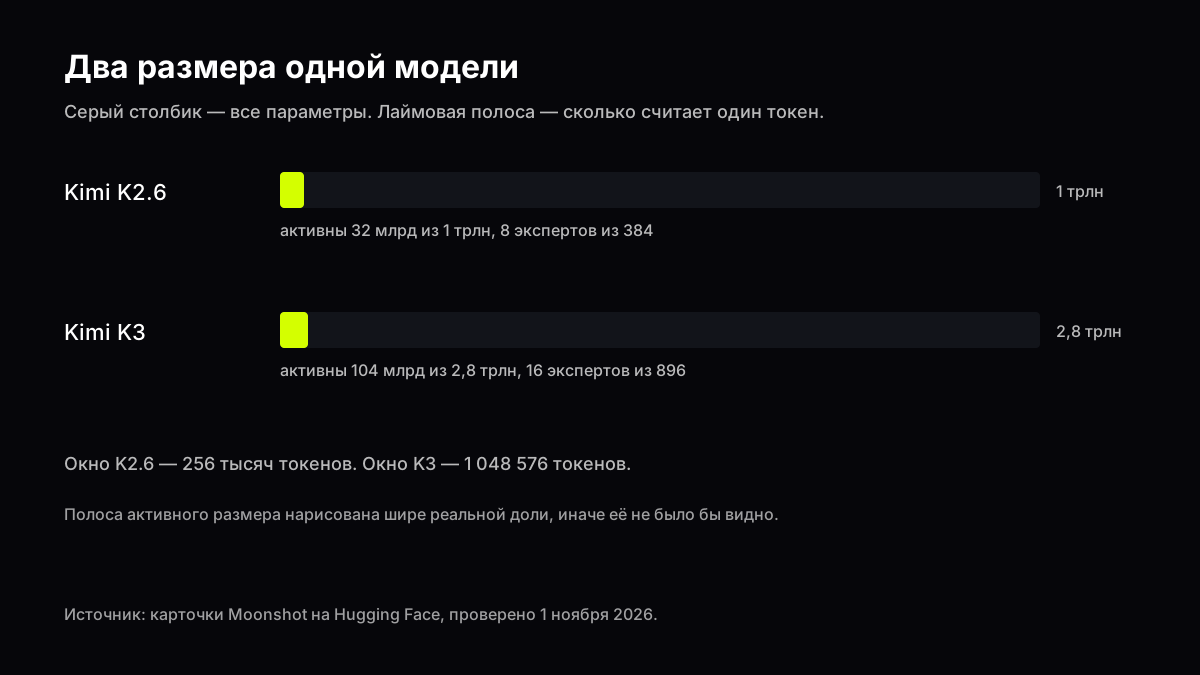
Источник: карточки Moonshot на Hugging Face, 1 ноября 2026. Доля активных параметров нарисована шире реальной, иначе полоску не разглядеть.
Словарь у обеих моделей один и тот же, на 160 тысяч кусков. Выросло число блоков и сменился способ внимания. Поэтому K3 не становится «понятливее к языкам» от одной только таблицы символов. Она дольше держит уже начатый текст и включает больше блоков на шаг.
Чем K2.6 отличается от K3?
На практике развилка выглядит так.
K2.6 — модель апреля 2026 года. В блоге её представили как открытую модель для длинного программирования и для роя помощников. Рой в материалах компании называется Agent Swarm. Это способ поручить одной модели нарезать задачу и вести много параллельных кусков. У K2.5 потолок был сто таких кусков и полторы тысячи шагов. У K2.6 потолок вырос втрое по кускам и почти втрое по шагам. Шаг здесь — действие: открыть файл, вызвать поиск, поправить строку. Четыре тысячи шагов — предел оркестровки в описании Moonshot, не обещание, что бытовой вопрос потребует четыре тысячи действий.
В том же блоге есть два внутренних прогона, их стоит читать как витрину, не как норму. В одном K2.6 больше полусуток и за тысячи вызовов инструментов подняла небольшую чужую модель на компьютере Mac и разогнала скорость ответа больше чем на порядок. В другом за полсуток с лишним перекроила старый открытый движок биржевых заявок, затронув тысячи строк. Повтор у вас дома с тем же итогом никто не гарантирует. Железо, обвязка и удача прогона в блог не вложены. Точные числа витрины лежат в блоге, в этот пересказ они не переехали специально: без протокола они выглядят точнее, чем есть.
K3 — модель июля 2026 года, и компания сама называет её первой открытой моделью класса трёх триллионов. В блоге прямо сказано, что по сумме испытаний она всё ещё позади закрытых Claude Fable 5 и GPT 5.6 Sol. Это редкая оговорка, её лучше не терять за словом «флагман».
Рассуждение устроено по-разному. У серии K3 его нельзя выключить. В запросе к программному интерфейсу есть уровень усилия: низкий, высокий и максимальный, по умолчанию максимальный. Температура, то есть степень случайности следующего куска, зафиксирована на 1,0. У K2.6 рассуждение включено по умолчанию, но его можно отключить. Температура тогда рекомендуется 0,6, а с рассуждением — 1,0. В бытовом чате это ощущается так: K3 почти всегда сначала думает, K2.6 можно попросить ответить короче и сразу.
Лицензии тоже разные. У K2.6 на карточке стоит изменённая лицензия MIT (modified-mit). У K3 — отдельная лицензия kimi-k3. Для человека, который просто пишет в чат, текст лицензии ничего не меняет. Он важен тому, кто скачивает веса и встраивает модель в свой продукт.
Карточки обеих моделей лежат рядом: Kimi K2.6 и Kimi K3. Как выбирать между окном, кодом и быстрым ответом, разобрано в гайде как выбрать модель.
Что показывают чужие экзамены
Бенчмарк — публичный набор задач с известными правилами подсчёта. Цифра без имени набора и без даты ничего не значит. Ниже только те числа, которые Moonshot сама поставила в карточки, с их же сносками. Чужие столбцы из разных лабораторий в одну таблицу здесь не склеены.
На карточке K2.6, режим с рассуждением, замеры самой компании стоят рядом с чужими отчётами там, где отчёт существовал. SWE-Bench Verified, задачи на починку реальных программных ошибок, — 80,2. GPQA-Diamond, вопросы уровня аспирантуры, — 90,5. Остальные клетки той же таблицы (поиск, олимпиадная математика, картинки, длинный экзамен Humanity's Last Exam) лучше смотреть в карточке, а не в пересказе. Часть соседних клеток помечена звёздочкой. Это пересъём Moonshot в своих условиях, а не чужой отчёт. Сравнивать такую клетку с официальной цифрой конкурента как одну линейку нельзя.
На карточке K3 усилие рассуждения максимальное. GPQA Diamond поднимается до 93,5. Terminal-Bench 2.1 показывает 88,3, но в обвязке Kimi Code. У конкурентов в сноске взят лучший результат среди разных обвязок, так что это не забег в одинаковых ботинках. На наборе DeepSWE итог чуть меняется, если сменить обвязку на mini-SWE-agent. Разница в доли балла. Это цена обвязки, не ошибка в арифметике.
У набора SWE-Marathon сноска честно говорит, что прогон шёл на ветке задач, перекалиброванной под видеокарты H20, до финальной версии набора. Цифру из той клетки можно цитировать только вместе с этой оговоркой, поэтому здесь её нет.
Отдельная витрина блога K3 к экзаменам не относится. За пару часов модель, по словам компании, собрала астрофизический расчёт I–Love–Q: сверила десятки статей, прогнала сотни уравнений состояния, нашла расхождения в опубликованных формулах и написала тысячи строк на Python. Другой абзац описывает монтаж ролика из десятков клипов и проект чипа за двое суток на открытых инструментах проектирования, библиотека Nangate сорок пять нанометров. Это рассказ разработчика о собственных прогонах. Повторяемого протокола рядом нет.
Что такое Kimi Slides?
Запрос «Kimi Slides нейросеть» ищет режим презентаций внутри продуктов Kimi. Отдельной модели с таким именем в карточках нет. В справке Moonshot прямо написано: Slides работает на модели K2.6. Человек даёт тему одной фразой, вставляет текст или прикладывает файл. Подходят PDF, Word, PPTX, Excel, TXT и картинки. Программа собирает структуру, подбирает сетку и отдаёт файл, который можно править и скачать как PPTX, то есть как обычную презентацию.
На странице K2.6 к этому добавлено ещё немного. Модель умеет вставлять в слайды таймлайн, блок-схему и воронку так, чтобы блоки оставались фигурами, а не одной нередактируемой картинкой. Можно приложить чужой слайд как образец оформления. Насколько точно образец повторится, справка не измеряет. Имеет смысл открыть результат и посмотреть, не поехала ли сетка и не выдуманы ли подписи к цифрам, которых в исходном файле не было.
Slides не заменяет проверку фактов. Если в исходнике не было выручки, доли рынка и имён клиентов, а на слайде они появились, это домысел модели, не «находка в документе». Типичная ошибка — попросить «сделай убедительную презентацию» без цифр в приложении. Убедительность тогда собирается из гладких формулировок.
Короткий запрос, который показывает характер режима, звучит так: «Собери десять слайдов по этому конспекту лекции. На каждом слайде не больше шести строк. Цифры бери только из конспекта. Если цифры нет, оставь место и подпиши, что её нет». Смотреть в ответе нужно три вещи. Совпали ли заголовки с реальными разделами конспекта. Не появилась ли диаграмма с числами из воздуха. Можно ли поправить одну фразу, не перегенерируя всю колоду.
Это не инструкция «нажми сюда». Как вообще формулировать просьбу к модели, чтобы она не досочиняла рамку, разобрано в гайде как писать запросы.
Что такое Kimi Work и Kimi Code?
Kimi Work — настольная программа. В описании продуктов на сайте компании она подключается к файлам на компьютере и к открытому вебу, гоняет исследования и канцелярские задачи через тот же рой. Рядом перечислены Kimi Code (агент в терминале и в редакторе кода), расширение браузера, которое само ходит по страницам, и Kimi Office внутри редактора WPS. Имена разные, модель под ними меняется со временем. В июле 2026 года блог K3 прямо писал, что эта модель включена и в Work, и в Code, и в обычный чат на kimi.com.
Work путают с чатом в браузере. Разница в том, куда модель тянется руками. В чате она видит то, что вы вставили. В Work, если программа это разрешила, она видит папку на диске и может разложить туда результат. Отсюда и риск. Просьба «наведи порядок в документах» без границы папки — просьба трогать всё, до чего дотянется доступ.
Code — про проект из многих файлов. Модель читает репозиторий, правит файлы и запускает команды. В блоге K2.6 это и есть «длинный горизонт»: сессия на много файлов, где модель сама возвращается к ошибке, а не одна короткая функция. В карточке NVIDIA тот же тезис: Rust, Go, Python, интерфейсы, эксплуатация. Обещание «починит любой проект» из этих абзацев не следует. Следует, что модель учили не бросать задачу на втором файле.
Уровни усилия, которые есть у K3, в быту читаются так. Низкий — короче думает, быстрее отвечает, чаще промахивается на многошаговой задаче. Максимальный — дольше молчит и пишет больше черновика рассуждения. Для опечатки в одном абзаце максимальный уровень избыточен. Для «разберись, почему падает сборка» как раз он.
С 31 октября 2026 года программный интерфейс Moonshot закрыл серию K2 для новых регистраций. Уже заведённым пользователям модели пока оставляют. Полностью убрать K2 из своего интерфейса компания планирует к концу декабря 2026 года. K2.5 и старое семейство moonshot-v1 сняли ещё 31 августа 2026 года, исходную K2 — 25 мая 2026 года. На сайте флагманом в списке моделей к концу октября названа уже K3.1 Pro, а K3 подписана как предыдущее поколение. Чату на сайте это не мешает: имена в интерфейсе разработчика и имена в разговоре живут с разной скоростью.
Что такое K3.1 и почему её не стоит путать с K3?
В конце октября 2026 года Moonshot выпустила Kimi K3.1 Pro. В блоге это прежняя K3 после дополнительного обучения на очень большом числе разных задач. Новой схемы блоков компания не объявляла. Окно то же, миллион токенов. Рядом вышла ускоренная версия, K3.1 Pro Highspeed: компания пишет, что она отвечает в два-три раза быстрее при той же заявленной силе. Обе сразу включили на kimi.ai, в Work, в Code и в программный интерфейс.
Полные веса K3.1 Pro обещаны к 4 ноября 2026 года. На 1 ноября, когда собран этот текст, дата ещё впереди. Путать «уже можно вызвать у разработчика» и «веса уже лежат в открытом архиве» здесь легко, и это разные факты.
В том же блоге есть один публичный счёт, который компания сравнивает сама. На Terminal-Bench 4.0, задачи в терминале с жёсткой автоматической проверкой, K3.1 Pro набирает 65,7%. В том же абзаце Claude Opus 5.5 чуть впереди, 66,4%, а GPT-6 Astra позади, 58,2%. Прогон шёл в обвязке Claude Code. Это таблица Moonshot, не общий зачёт независимой лаборатории. Пересказ China Daily от 27 октября добавляет чужую линейку: на индексе Artificial Analysis Intelligence Index модель встала четвёртой и прибавила к предшественнику заметную пачку баллов. Индекс — сводная оценка чужого сайта на конкретный день. Через неделю места обычно едут.
Для человека, который открывает чат, развилка на 1 ноября проще. Рабочие открытые карточки поколения, о котором имеет смысл читать устройство, — K2.6 и K3. K3.1 — уже следующий шаг у самой компании, и его веса ещё не стали публичным файлом.
Про Grok 4.7 полезно помнить тот же жест. Новая ступень не отменяет предыдущую в тот же день, и сравнивать их имеет смысл по задаче, а не по номеру версии.
Kimi на русском
Отдельной «русской Kimi» компания не выпускала. Интерфейс kimi.com по умолчанию китайский, у международного сайта есть английские страницы справки и блогов. Модель при этом не привязана к языку кнопок.
Токены русского текста она видит так же, как токены любого другого: куски букв попадают в тот же словарь на 160 тысяч позиций. Словарь общий, не «русский» и не «китайский». Качество ответа на русском зависит от того, сколько русского было в обучении, а долю языков Moonshot не публикует. Поэтому честный способ проверить — дать одну и ту же фактическую просьбу на русском и посмотреть, не соскользнёт ли рассуждение на английский или китайский в середине.
В чате GPThub вопрос к K2.6 и к K3 можно написать по-русски сразу, без отдельной оболочки. Имеет смысл в первом сообщении прямо сказать язык ответа: «Отвечай по-русски, термины в скобках можно оставить латиницей». Иначе модель, которую в карточках замеряют на английских экзаменах, охотно остаётся в английском.
Типичные срывы на русском предсказуемы. Имена собственные она может транслитерировать туда и обратно, и «Ян Чжилин» в одном абзаце станет другой латиницей. Длинная цитата из русского закона или договора иногда пересказывается гладко, но с подменой номера статьи. На просьбу «переведи и сократи» она сокращает сильнее, чем вы просили, и теряет оговорку. Проверка одна: число, имя и отрицание («нельзя», «кроме») сверить с исходником глазами.
Китайская прописка компании важна и для документов. Юридическую оценку трансграничной передачи документов эта статья не даёт. Договор и медицинскую карту в любой чат кладут только если вы сами понимаете, куда уходит текст.
Что проверять в ответе и где модель промахивается
Три отказа, которые видны уже на коротком диалоге.
Первый — лишняя уверенность на пустом месте. Вопрос «сколько параметров у Kimi K3» модель часто знает: цифра 2,8 триллиона повторена в блоге и в карточке. Вопрос «какая доля русского в обучающей выборке» честного ответа не имеет, выборку не публиковали. Хороший ответ здесь — «компания это не раскрывала». Плохой — ровная цифра процентов без ссылки. Если цифра появилась, её нет в источниках этого текста, и верить ей не стоит.
Второй — путаница окон. 200 тысяч иероглифов образца 2023 года, 256 тысяч токенов у K2.6 и миллион токенов у K3 — три разных факта. Модель иногда склеивает их в «Kimi всегда держала миллион». Не держала. Миллион появился у K3 в июле 2026 года.
Третий — чужие экзамены без сноски. Фраза «K3 лучше всех в терминале» выдёргивает 88,3 на Terminal-Bench 2.1 и прячет обвязку Kimi Code. Фраза «K3.1 обошла Opus» прячет, что 65,7 и 66,4 — это K3.1 чуть позади Opus 5.5, а не впереди. Модель любит круглые победы. Рядом с числом должен остаться набор задач.
Практический набор, который отделяет карточку от пересказа, выглядит так.
- Попросите назвать два размера K2.6 и два размера K3. Верные пары: 1 триллион и 32 миллиарда, 2,8 триллиона и 104 миллиарда.
- Попросите не смешивать иероглифы и токены на примере запуска октября 2023 года. Верный ответ держит 200 тысяч знаков и 128 тысяч токенов как разные формулировки разных дат.
- Дайте абзац с одной нарочной ошибкой, например «K3 вышла в апреле 2026», и попросите проверить. K3 вышла в июле, в апреле вышла K2.6.
- Приложите короткую таблицу из пяти строк и попросите сумму одного столбца. Сверьте калькулятором. Длинное окно арифметику само не чинит.
- Попросите презентацию на три слайда по этому же абзацу и посмотрите, не выросли ли на слайдах числа, которых в абзаце не было.
Если на пунктах 1–3 модель путает даты, это не «плохо повезло с температурой». Для фактического вопроса лучше повторить его с просьбой опираться только на названные вами источники. Как устроен выбор модели под задачу, а не под имя в рекламе, снова упирается в гайд про выбор.
Даже верные даты не делают ответ справочником. Карточки обновляют, блог K3.1 уже отодвинул K3 на роль предыдущего поколения в списке интерфейса, а открытые веса K3.1 на день этой статьи ещё впереди. Текст выше зафиксирован на 1 ноября 2026 года. Через месяц число на индексе Artificial Analysis будет другим. Размеры K2.6 и K3, пока веса те же, останутся.
Часть громких абзацев блога проверить нечем. Двенадцать часов автономной работы, чип за двое суток, ролик из пятидесяти шести клипов — единичные прогоны на стороне компании. Они показывают, какого класса задачи авторы считают достижимыми. Они не показывают, какая доля таких задач заканчивается успешно у постороннего человека. Логика в таком разрыве есть. Витрина продаёт потолок, карточка с бенчмарком продаёт средний зачёт, и это разные полки.
Для бытового вопроса потолок не нужен. Конспект, сверка цитаты, черновик слайдов по готовому тексту, разбор незнакомой функции в коде. Здесь как раз виден характер смеси экспертов. Модель отвечает быстро, потому что на каждое слово включается тонкий срез большой сети. Маленькой при этом она не становится. Ошибка, если она случается, выглядит уверенно. Тонкий срез не ставит на поля знак «я не уверен».
Кому какая Kimi подходит
Студенту, которому нужно уложить лекцию в слайды и не выдумать литературу, ближе режим в духе Slides на K2.6: короче окно, чем у K3, зато справка прямо связывает презентации с этой моделью. Условие прежнее. В запросе запрет на новые цифры.
Тому, кто несёт в чат один толстый файл, договор или подшивку статей, ближе окно K3. Миллион токенов вмещает то, что 256 тысяч уже режут. Резать файл всё равно полезно, если нужен один раздел, а не весь том. Иначе внимание размазывается, и ответ цитирует приложение, о котором вы не спрашивали.
Тому, кто правит программу из многих файлов, блог Moonshot предлагает и K2.6, и K3, и отдельную K2.7 Code. В чате из этой тройки прямо открыты две первые. K2.7 Code в этом тексте — имя из документации разработчика, не обещание отдельной кнопки. Смотреть стоит, бросает ли модель задачу после первой ошибки компиляции и не переписывает ли соседние файлы «заодно».
Тому, кто сравнивает лаборатории, полезнее держать в голове развилку открытых весов. K2 и K3 скачивать можно, у K3 лицензия своя, не привычная MIT. K3.1 на 1 ноября ещё живёт как услуга самой Moonshot, без выложенных весов. Это временно, если компания сдержит срок 4 ноября, но статья не выдаёт будущую дату за прошедшую.
Если вы видите новость «вышла новая Kimi» и в ней нет двух чисел, общего размера и активного, новость почти ничего не сказала. Эти два числа плюс длина окна отличают поколение сильнее, чем прилагательное в заголовке. Дальше имеет смысл открыть карточку и задать модели один вопрос, ответ на который вы уже знаете. Сошёлся — можно нести свой текст. Не сошёлся — сначала другой запрос, потом уже другая модель.
Вопросы и ответы
Что такое Kimi простыми словами?
Kimi — чат и семейство моделей пекинской компании Moonshot. С 2023 года чат умеет принимать длинные тексты. С 2025 года основные модели выходят с открытыми весами. В 2026 году в ходу K2.6 и K3, а у самой компании с конца октября уже есть следующая ступень, K3.1 Pro.
Kimi Slides — это отдельная нейросеть?
Нет. В справке Moonshot Slides — режим презентаций на модели K2.6. На вход идут фраза, текст или файл, на выходе правленая презентация, которую можно скачать как PPTX. Цифры, которых не было в файле, туда лучше не пускать: модель допишет их без спроса.
Есть ли Kimi на русском?
Отдельной русской версии компания не объявляла. Сайты kimi.com и kimi.ai — китайский и английский. Сами модели принимают русский текст как обычные токены. В чате GPThub K2.6 и K3 можно спросить по-русски и сразу попросить ответ на русском.
Чем Kimi K3 отличается от K2.6?
K3 больше и длиннее. 2,8 триллиона параметров против 1 триллиона, на один токен считают 104 миллиарда против 32 миллиардов, окно около миллиона токенов против 256 тысяч. У K3 другое внимание (Kimi Delta Attention) и рассуждение, которое нельзя выключить, только ослабить уровнем усилия. K2.6 умеет отвечать и без длинного рассуждения.
Что такое Kimi Work?
Настольная программа Moonshot. Она видит локальные файлы и открытый веб и собирает из этого исследования и канцелярские задачи через рой параллельных поручений. Это не то же самое, что вкладка чата в браузере: доступ к папке шире, и границу папки лучше задать явно.
Kimi K3 уже с открытыми весами?
Да. Анонс 16 июля 2026 года обещал веса к 27 июля, и карточка в открытом хранилище с тех пор на месте. Лицензия называется kimi-k3, это не стандартная MIT. У следующей модели, K3.1 Pro, на 1 ноября 2026 года веса ещё только обещаны, срок в блоге — 4 ноября.
Связанные модели

Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть Kimi в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.