
Что такое RAG: почему нейросеть отвечает по вашему файлу

Обозреватель: как устроен ИИ
Содержание
22 мая 2020 года Патрик Льюис с коллегами из Facebook AI Research отправил в архив препринтов статью про генерацию, к которой сбоку прикручен поиск. Работа вошла в программу конференции NeurIPS 2020. С тех пор короткая подпись RAG висит на любой кнопке «ответь по моему файлу», хотя в статье механизм был узкий, а в чате под тем же именем часто живёт дальний родственник: перед ответом программа достаёт из файла несколько кусков и подкладывает их в запрос. Человек, который прикрепил методичку, обычно ждёт другого. Ему кажется, что модель прочитала документ и теперь его помнит, как помнит столицу Франции. Память модели и поиск по файлу устроены по-разному, и путаница здесь стоит неправильной цитаты на зачёте.
Почему файл не становится памятью?
Привычная картинка выглядит так: вы положили в чат PDF, модель его «проглотила», и дальше можно спрашивать что угодно, как у человека, который только что дочитал. Картинка удобная, и в бытовом смысле проглотить здесь некуда. У модели есть числа, которые подстроили на обучении задолго до вашего файла. Это параметрическая память из статьи Льюиса: знание сидит в весах, его нельзя открыть на нужной странице и поправить одну строку.
Ваш файл в эти числа не вписывается. Дообучение на одном конспекте ради одного вечера никто не запускает. Файл либо целиком попадает в текущий запрос (окно, в которое модель смотрит прямо сейчас), либо лежит рядом, в хранилище, и оттуда по вопросу вытаскивают несколько абзацев. Второй путь в разговоре и называют RAG.
Льюис с соавторами как раз и писали, зачем плодить второй путь. Чисто параметрическую модель трудно пополнить, когда мир изменился: придётся учить заново, трудно показать, откуда взялась фраза, и модель охотно договаривает то, чего в источниках не было. Авторы называют такие договаривания галлюцинациями, подробнее о них в статье о том, почему нейросеть выдумывает. Поиск сбоку меняет доступ к тексту, индекс можно заменить, а найденные куски можно показать человеку. Если в куске ошибки нет, шанс честного ответа выше, чем у голой памяти. Если поиск принёс не тот кусок, модель уверенно перескажет чужой абзац.
Ещё одна путаница сидит в слове «база»: база RAG — склад кусков, дневник диалога туда сам не пишется. То, что вы сказали вчера в другом чате, само туда не переезжает. То, что написано на странице 40, попадёт в ответ только если поиск сочтёт страницу близкой к сегодняшнему вопросу.
Что такое RAG простыми словами?
Для понимания полезно отступить к опыту 2020 года, оставив кнопку в интерфейсе на потом. Авторы взяли уже обученный генератор и уже обученный искатель. Генератор — BART-large на 400 миллионов параметров, модель, которая по входу пишет выход слово за словом. Искатель — Dense Passage Retriever, две сети BERT базового размера: одна превращает кусок текста в набор чисел (вектор, о нём отдельно в статье про эмбеддинги), вторая так же превращает вопрос, а близость считают скалярным произведением этих наборов. Чем произведение больше, тем кусок «похож» на вопрос.
Дальше шаги идут друг за другом: вопрос кодируют, по индексу находят несколько ближайших кусков, кусок склеивают с вопросом, и генератор пишет ответ, глядя на эту склейку. В статье индекс назван непараметрической памятью: текст лежит снаружи весов, его можно вынуть и подложить другой.
Общий контур с тех пор почти не изменился, хотя размеры моделей выросли на порядки. Сначала режут собрание текстов, потом ищут, и только затем генератор пишет, видя найденное и вопрос. Меняются нож, способ сравнения и то, учат ли искатель вместе с генератором.
В опыте Льюиса нож был грубый и честный. Один дамп английской Википедии за декабрь 2018 года резали на непересекающиеся куски ровно по 100 слов, и вышло 21 миллион кусков. Индекс строили библиотекой FAISS, с приближённым поиском ближайших соседей, чтобы не сравнивать вопрос с каждым из 21 миллиона в лоб. На обучении брали 5 или 10 ближайших кусков. Сколько брать на проверке, выбирали по отложенной выборке, не «на глаз в бою».
Искатель к началу работы уже умел находить абзацы с ответами на вопросы из наборов TriviaQA и Natural Questions. Разметки «для этого вопроса достань вот этот абзац» при дообучении RAG не было. Учили так, чтобы итоговый ответ совпадал с правильным. Кодировщик самих документов заморозили: пересчитывать 21 миллион векторов на каждом шаге дорого, и авторы решили, что без этого качество уже достаточное. Двигались при этом только кодировщик вопроса и BART.
Отсюда практический вывод, который легко пропустить в пересказах. В той работе «модель RAG» — это пара, которую доучили вместе. Бытовая кнопка в чате чаще устроена иначе. Готовую большую модель не учат на вашей методичке. Программа ищет куски и дописывает их к запросу. Anthropic в заметке про контекстный поиск описывает именно такую схему: достали из базы, приклеили к запросу, генератор отвечает. Называть обе вещи одним словом ещё можно, ждать от кнопки поведения статьи 2020 года уже не стоит.
Из чего собрана система поиска
Система собирается из трёх частей, и любая из них ломается отдельно.
Нарезка устроена так: документ делят на куски заранее, до вопроса. В 2020 году кусок был 100 слов без перекрытия. В заметке Anthropic куски обычно не длиннее нескольких сотен токенов. Токен — кусок текста, которым модель шагает: часто это часть слова, иногда слово целиком. Как токены складываются в окно, подробно описано в статье о токенах и контекстном окне. Граница в 100 слов и граница в несколько сотен токенов — разный масштаб, но идея одна. Слишком длинный кусок тащит в ответ лишнее и сам плохо ищется, слишком короткий теряет подлежащее.
Поиск сравнивает вопрос со складом: сравнение по смыслу (векторы, как у DPR) находит абзац, где те же мысли другими словами, а сравнение по буквам находит редкую строку. Anthropic приводит пример с кодом ошибки TS-999. Вектор может увести в общие страницы про ошибки. Поиск по совпадению слов, функция BM25, ищет саму строку. В их схеме оба списка потом смешивают и убирают повторы.
Генерация получает в окно вопрос и отобранные куски, после чего модель пишет связный текст. Она видит куски, даже если в интерфейсе файл один и кажется, будто открыт он целиком. Сколько кусков класть, решают заранее: Льюис пробовал 5 и 10. В замерах Anthropic из наборов 5, 10 и 20 лучше всего вёл себя набор из 20. Это их домены и их модели, не универсальный закон. На чужой задаче лишний десяток кусков легко становится шумом.
Есть четвёртый шаг, которого в статье 2020 года в таком виде не было, — пересортировка. Сначала достают много кандидатов, потом отдельная модель заново раскладывает их по близости к вопросу и оставляет короткую верхушку. У Anthropic в опыте брали 150 кусков и оставляли 20. Доля провалов на двадцати верхних позициях падала сильнее, чем от одной только нарезки с пояснениями. Цена шага — лишнее время на каждый вопрос. Для студенческого конспекта на сорок страниц это часто избыточно. Для базы на тысячи страниц без этого шага верхушка поиска слишком грязная.
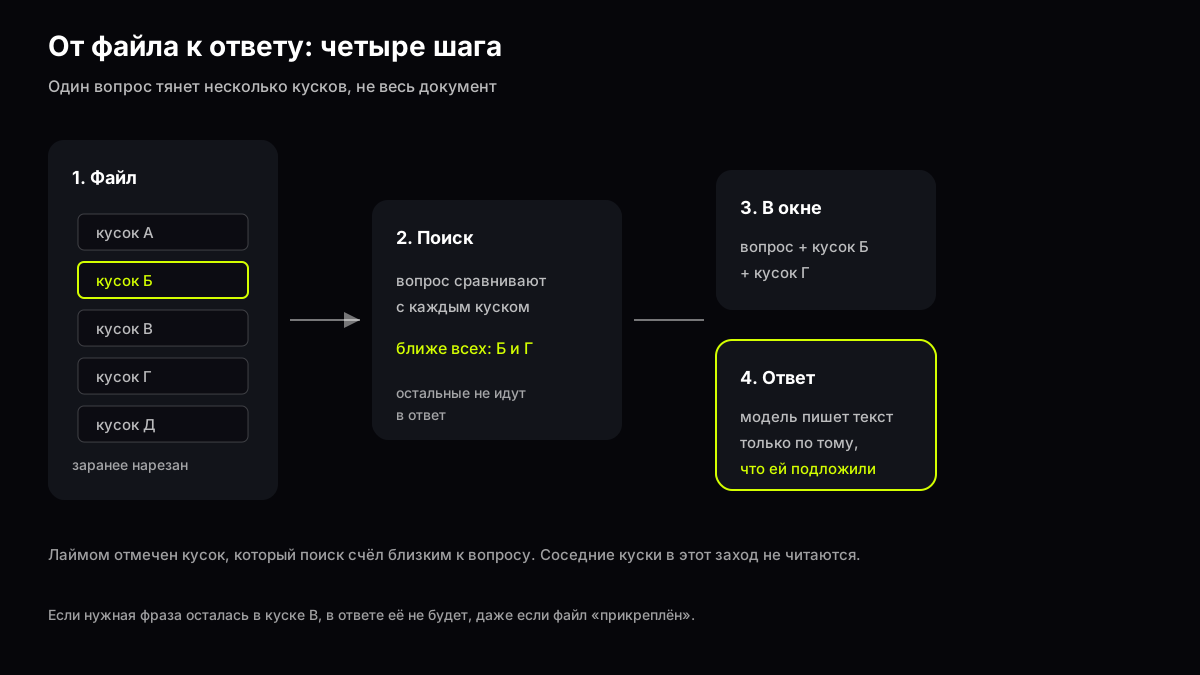
Источник: схема по статье Lewis и др., arXiv:2005.11401, и по описанию нарезки в заметке Anthropic о контекстном поиске. Проверено 1 ноября 2026
Длинный файл и окно контекста
Окно контекста — сколько текста модель держит перед глазами в одном заходе: вопрос, приложенное и уже написанный кусок ответа. Пока файл короче окна, поиск не обязателен. Его можно вставить целиком, и тогда пропадает целый класс ошибок нарезки. Anthropic прямо пишет порог, ниже которого они советуют обходиться без RAG: база меньше 200 тысяч токенов, по их прикидке около 500 страниц. Порог относится к их продуктам и к их оценке страницы. Чужое окно может быть короче, и «500 страниц» туда не переносятся сами.
Длинное окно другую беду не отменяет. В 2023 году группа Нельсона Лю (Стэнфорд, Беркли, Samaya AI) измерила, пользуется ли модель тем, что уже лежит внутри окна. Препринт вышел 6 июля 2023 года, журнальная версия — в Transactions of the Association for Computational Linguistics в 2024 году, страницы 157–173. Задача на вид простая: дают пачку документов и вопрос, ответ есть ровно в одном документе. Документ с ответом ставят в начало, в середину или в конец. Меняют и длину пачки: 10, 20 или 30 документов.
Кривая получилась в форме буквы U: начало пачки модель использует лучше (это эффект первенства), конец тоже лучше (эффект недавности), а середина проседает. У GPT-3.5-Turbo просадка бывала больше 20 процентных пунктов. В худшем случае при 20 и 30 документах точность оказывалась ниже, чем в закрытой книге, где документов не давали вовсе. Закрытая книга у этой модели на их наборе — 56,1%. Если дать один правильный документ и ничего лишнего, оракул, точность 88,3%. Текст с ответом модель прочитать умеет и теряет его уже среди соседей.
Удлинённое окно само по себе середину не спасало. Пока 10 и 20 документов влезали и в обычный GPT-3.5-Turbo (окно 4 тысячи токенов, версия интерфейса 0613), и в вариант на 16 тысяч, кривые по позиции почти лежали друг на друге. Claude-1.3 с окном 100 тысяч токенов на той же задаче тоже заметно не выигрывал у версии с окном 8 тысяч. Отдельный синтетический тест, найти значение по ключу в длинном списке, Claude проходил почти без ошибок. GPT-3.5 и открытая MPT-30B-Instruct снова проваливали середину. Умение «вместить» и умение «найти в середине» в той работе разошлись.
Для поиска по Википедии авторы посмотрели и другую развилку. Полнота искателя ещё росла, а качество ответа уже нет. Пятьдесят документов вместо двадцати прибавили GPT-3.5-Turbo около 1,5%, Claude-1.3 около 1%. Лишние страницы в окне почти ничего не стоили по смыслу и добавляли места, где модель может зацепиться не за то.
Отсюда две бытовые развилки, и их полезно не смешивать. Первая спрашивает, влезет ли файл в окно: если влезет, нарезка становится лишним риском отрезать подлежащее. Вторая спрашивает, не утонула ли нужная страница в середине простыни, даже когда файл влез. Поиск как раз пытается вытащить нужное ближе к вопросу, чтобы оно не сидело сороковым абзацем. Плохой поиск приносит похожий, но чужой кусок и ставит его на почётное место в начале запроса, после чего модель цитирует его охотно, а середина исходного файла даже не открывается.
Как устроено окно у конкретной линейки, удобно смотреть на живом примере, оставив абстрактный «миллион» в стороне. В разборе DeepSeek как раз разобрано, что окно — это одновременный взгляд на вопрос, файл и уже написанный ответ, и почему длинный текст упирается в память видеокарты. Выбор, какую модель зовут на длинный файл, — отдельный практический текст: какая модель для аналитики. Здесь остаётся механизм.
Как устроены база и поиск
База собирается раньше первого вопроса: документы режут, каждому куску считают представление и кладут его в индекс. Пока индекс старый, ответы тоже старые. Льюис отдельно показал, что непараметрическую память можно подменить, когда мир изменился: веса генератора те же, склад текстов другой. Для методички вывод прямой. Заменили PDF на версию после правки преподавателя — пока нарезку не пересчитали, поиск носит цитаты из прошлой редакции, и модель говорит уверенно, не зная, что склад протух.
Кусок без шапки врёт поиском ещё до генерации. В заметке Anthropic есть финансовый обрывок: выручка компании выросла на 3% к прошлому кварталу. Внутри абзаца нет ни компании, ни квартала. Вектор такого куска похож на тысячи других «выручка выросла». Их лечение — дописать к куску короткое пояснение, 50–100 токенов, кто это и откуда абзац, и уже пояснение вместе с абзацем класть в индекс. Пояснения писала модель Claude 3 Haiku по целому документу. Приём назван контекстным поиском. На их усреднении по четырём доменам (код, проза, статьи arXiv, научные статьи) доля провалов среди двадцати верхних кусков была 5,7%. Одни контекстные векторы снизили её на 35%, до 3,7%. Векторы вместе с таким же пояснением в индексе BM25 — на 49%, до 2,9%. С пересортировкой — на 67%, до 1,9%. Цифры относятся к их стенду и показывают масштаб беды обрывка, без обещания, что любая кнопка «по файлу» уже так умеет.
Два способа близости стоит держать в голове отдельно, потому что студенческий вопрос прыгает между ними.
Смысловая близость устроена так: «когда сдавать эссе» может найти абзац «срок итоговой работы — пятница третьей недели», хотя общие слова почти не совпали. Так устроен DPR, где вопрос и абзац живут в одном пространстве чисел.
Буквенная близость ловит номер пункта, шифр дисциплины, формулу с редким индексом, фамилию в списке, и здесь побеждает совпадение строки. BM25 как раз про частоту слова в куске и про то, насколько слово редкое во всей базе. Длинный кусок он ещё и придерживает, чтобы простыня не побеждала только числом слов.
Хорошая система гоняет оба способа и смешивает списки, слабая оставляет один. На вопросе «что сказано в пункте 4.2» чисто смысловой поиск легко приносит пункт 4.1, потому что темы рядом, а цифры для вектора — почти шум. На вопросе «объясни мысль автора» чисто буквенный поиск цепляется за случайное повторение союза и пропускает пересказ другими словами.
Порядок кусков в индексе — не порядок страниц. Соседние абзацы после нарезки друг о друге не знают, если их не склеили перекрытием или пояснением. Перекрытие — когда конец одного куска повторяют в начале следующего. В статье 2020 года перекрытия не было: куски по 100 слов стояли встык. Фраза, разрезанная границей, ни в одном документе индекса не лежала целиком. Искатель физически не мог её достать.
Две схемы из статьи 2020 года
Льюис сравнивал два способа учесть несколько найденных кусков внутри одного ответа, оставив спор «поиск или память» за скобками.
RAG-Sequence на весь ответ выбирает один документ. Вероятность ответа считают так: для каждого из верхних кусков генератор оценивает всю фразу целиком, оценки складывают с весом того, насколько кусок был близок к вопросу. На практике это близко к «оперся на один абзац и дописал».
RAG-Token на каждый следующий токен ответа может опереться на свой кусок из той же верхушки: фамилию берут из одного абзаца, дату из другого. Склейка получается тоньше и опаснее, потому что красивое предложение собирается из несовместимых мест, и ни одно место в отдельности такую фразу не содержит.
На открытых вопросах, где ответом служит короткая строка, разница небольшая, но по таблице её видно. Точное совпадение, Natural Questions: RAG-Sequence 44,5, RAG-Token 44,1, извлекающий DPR 41,5, закрытая книга T5 на 11 миллиардов параметров 34,5. WebQuestions: 45,2 и 45,5 против 37,4 у T5-11B и 41,1 у DPR. CuratedTrec: 52,2 у RAG-Sequence против 50,6 у DPR. Авторы заявляют лучший на тот момент результат на этих трёх наборах. На стандартном TriviaQA картина другая: RAG-Sequence набирает 56,8, DPR — 57,9, и поиск с генерацией там не обогнал поиск, который просто вырезает ответ из текста. Напоминание полезное, прибавка есть не на каждой полке.
На проверке фактов FEVER модель должна сказать, поддерживает ли Википедия утверждение, опровергает или сведений мало. Разметки «вот правильный абзац» модели не давали, в отличие от систем, которые учили именно на таких абзацах. RAG-Token на трёх классах получил 72,5% верных меток, голый BART — 64,0%, сильный опубликованный результат с размеченным доказательством — 76,8%. В тексте статьи это укладывают в формулу «в пределах 4,3%» от тех систем, которым доказательство разметили руками. Для бытового файла вывод спокойный: даже аккуратный поиск не дотягивает до человека, который заранее ткнул в нужный абзац, и при этом он заметно выше модели, которой не показали ничего.
| Набор | RAG-Sequence | RAG-Token | DPR | T5-11B, без поиска |
|---|---|---|---|---|
| Natural Questions | 44,5 | 44,1 | 41,5 | 34,5 |
| TriviaQA, обычный тест | 56,8 | 55,2 | 57,9 | — |
| WebQuestions | 45,2 | 45,5 | 41,1 | 37,4 |
| CuratedTrec | 52,2 | 50,0 | 50,6 | — |
Человеческая проверка в той же работе смотрела генерацию, а короткие тестовые ответы оставила таблицам. На вопросах в стиле телевикторины Jeopardy люди чаще признавали формулировки RAG более фактичными и более конкретными, чем формулировки голого BART. «Чаще» здесь — итог попарного сравнения, не абсолютная честность. Модель с поиском всё ещё может собрать гладкую ложь, если верхние куски сами по себе мимо.
Где ответ по документу врёт?
Ошибки повторяются, и у каждой свой адрес в схеме.
Чужой кусок выглядит так. Вопрос про срок в пункте 4.2, в окне оказался пункт 4.3 про оформление титульного листа, и модель аккуратно пересказывает титульный лист, называя это сроком. Проверка одна: в ответе должен быть тот номер пункта, который вы спрашивали, а слова вокруг номера должны говорить о сроке, не о полях страницы.
Разрезанная фраза начинается в конце куска и кончается в следующем. В индексе без перекрытия целого условия нет. Ответ звучит правдоподобно и обрывается на полуслове логики: «работа считается сданной, если файл загружен», а продолжение «до 23:59 по московскому времени, иначе ноль» осталось за бортом. Лечит это другая нарезка, более строгий вопрос тут почти ни при чём. Со стороны чата это выглядит как дыра в документе.
Протухший склад случается после замены файла, когда индекс живёт со вчерашней нарезки. Цитата дословная и при этом неверная относительно того PDF, который лежит у вас на столе. Сверять надо с файлом, который вы считаете текущим, а ощущение «я же его прикрепил» лучше отложить.
Середина простыни — отдельный случай: файл влез в окно целиком, поиск не включался, нужный абзац сидит в середине шестидесяти страниц. Опыт Лю говорит, что для моделей 2023 года это был худший адрес. Новые модели обещают лучше, и часть синтетических проверок они правда проходят. Пока вы не увидели цитату своими глазами, обещание остаётся обещанием, и положение абзаца по-прежнему имеет значение.
Склейка из двух кусков даёт гладкий ответ, где каждая половина по отдельности в документе есть, а вместе их нет. Это родственно схеме RAG-Token: разные токены опираются на разные места. На вопросе «сколько баллов и в какой срок» модель легко берёт баллы из одного пункта и срок из другого, хотя в документе такая пара не соседствует.
Память сильнее файла там, где вопрос широко известный, а в методичке оговорка местная. Модель отвечает по тому, что выучила на обучении, и вежливо игнорирует приложенный абзац. В статье 2020 года закрытая книга T5 на Natural Questions отставала от RAG на десять пунктов (34,5 против 44,5), но не молчала. Память при этом всегда что-то говорит. Если в ответе нет ни одной формулировки, которую можно найти в файле поиском по редкому слову, перед вами память, а файл остался декорацией.
Справка Claude про проекты описывает бытовой предохранитель с другой стороны. Когда собрание файлов упирается в окно, включается поиск, и в запрос попадает не вся полка. Ёмкость они оценивают примерно в десять раз выше прежнего предела. Точных порогов в токенах на той странице нет, и переносить «в десять раз» на чужой чат нельзя. Смысл переносится спокойно: режим «по документам» может незаметно сменить полный просмотр на верхушку поиска. Ответ станет короче и увереннее как раз в тот момент, когда база переросла окно.
Что смотреть в ответе?
Пошагового рецепта по кнопкам здесь нет, кнопки у чатов разные, а проверка ответа одна и та же. Ниже четыре вопроса к уже готовому тексту модели, и их имеет смысл задавать себе, не дописывая в запрос ради магии.
Первый вопрос к ответу: есть ли в нём опора, которую можно найти в файле за десять секунд. Фамилия, номер пункта, редкое слово, цифра с единицей измерения. Если опора есть, откройте файл и найдите её обычным поиском по документу, без нейросети. Совпало окружение — кусок пришёл верный, совпало одно слово при других соседях — перед вами склейка или соседний пункт.
Второй вопрос к ответу проверяет, не подменился ли тип вопроса. Вы спросили срок, вам описали цель курса. Так бывает, когда смысловой поиск принёс «похожий» раздел введения. Похожесть для вектора и нужность для зачёта — разные шкалы.
Третий: не отвечает ли модель так, как ответила бы без файла. Задайте тот же вопрос в пустом диалоге, без вложения. Если абзацы почти совпали, прикреплённый документ в первый ответ не вошёл. Либо поиск ничего не нашёл и смолчал, либо нашёл и модель это отбросила. Повтор с более узкой формулировкой, с номером пункта и редким словом из файла, обычно показывает, какой из двух случаев у вас.
Четвёртый: не слишком ли гладко там, где в источнике сухо. Методички пишут рублеными пунктами, и если в ответе появилась причина, которой в пункте не было, это достройка из памяти. Для пересказа главы она бывает уместна, для условия допуска к экзамену она опасна. Юридическую и учебную силу имеет формулировка документа, не пересказ.
Условный пример, не история из чьего-то чата. В методичке есть пункт 4.2: эссе сдают до 18:00 пятницы третьей недели, файл в формате PDF, имя файла — фамилия латиницей. Вопрос «когда сдавать работу по курсу» может принести введение, где написано «работы сдаются в течение семестра». Ответ выйдет добрым и при этом неверным. Вопрос с номером пункта и словом «PDF» ближе к буквенному поиску и чаще достаёт сам пункт. В ответе всё равно стоит проверить три вещи: время 18:00, «третья неделя» и требование к имени файла. Выпала любая из трёх — кусок обрезан или смешан с соседним.
Второй условный пример лежит в конспекте лекции: на странице 12 формула, на странице 13 оговорка «формула не работает при нулевом знаменателе». Нарезка по 100 слов, как в опыте 2020 года, легко разводит формулу и оговорку по разным документам индекса. Вопрос «запиши формулу» приносит страницу 12, а оговорка в ответ не входит, потому что её не искали. Хороший признак беды — ответ, в котором есть равенство и нет ни одного ограничения. Имеет смысл отдельно спросить про условия, при которых формула не применяется, и сверить оба ответа с обеими страницами.
Где здесь заканчивается объяснение и начинается ремесло запроса, лучше смотреть в гайде о том, как писать запросы. Там пошаговая работа с формулировкой, здесь достаточно списка того, что в ответе считается уликой, а что гладкостью.
Кому хватает поиска?
Поиск окупается, когда собрание больше одного захода. Папка статей на семестр, положение о практике на сто страниц, несколько методичек разных лет. Тащить всё в окно значит повторить опыт с двадцатью документами: лишние почти не поднимали точность, середина при этом проваливалась. Нарезка плюс верхушка здесь честнее полного проглатывания, даже если полное ещё влезает по счётчику токенов.
Поиск вреден на коротком и важном тексте: билет на одну страницу, лист с критериями оценки, таблица дедлайнов. Сто слов Льюиса или несколько сотен токенов Anthropic здесь избыточны как единица хранения, потому что страница и есть кусок. Её место — целиком в запросе, рядом с вопросом, лучше ближе к концу или к началу, без пряток между длинной инструкцией и вежливым послесловием. Эффект первенства и эффект недавности из работы 2023 года как раз про этот адрес.
Поиск бесполезен, если вопрос не про текст файла. «Сделай из этого мотивационное письмо» использует документ как сырьё для нового текста. Цитата тут не цель, и проверка по номеру пункта ничего не ловит. Путаница начинается, когда письмо должно соблюдать ограничение из файла («не больше 2000 знаков», «без названия компании»). Ограничение стоит достать отдельным узким вопросом и уже потом просить текст. Иначе модель напишет хорошее письмо мимо правила, которое лежало в куске, не попавшем в верхушку.
Смешивать годы документов в одной базе тоже стоит сознательно. Дамп Википедии в статье 2020 года был один, декабрь 2018. Две методички, старая и новая, в одном индексе дают две правдоподобные верхушки. Модель не обязана предпочесть ту, у которой в шапке более поздний год, если год не попал в кусок или если вопрос не про дату. Пояснение к куску, то самое на 50–100 токенов, как раз про это: в индексе должно быть написано, из какого файла абзац.
В чате GPThub файл прикладывают к сообщению, и дальше решает связка окна и поиска. Сам факт вложения ничего не гарантирует. Какую модель звать, когда файл длинный и его всё-таки хочется видеть целиком, разобрано отдельно, в тексте про выбор модели и в уже названном разборе для аналитики. Механика от выбора имени не меняется: либо страница лежит в окне, либо в окне лежит то, что поиск счёл похожим.
Если в новости обещают, что модель «помнит ваши документы», проще открыть свой файл с редким номером пункта в середине, спросить этот номер и найти ту же строку в исходнике. Совпало — в этот раз поиск или окно сработали. Не совпало — перед вами гладкий пересказ соседнего места или память, которая была у модели до вашего файла. Третьего устройства у кнопки при этом нет.
Вопросы и ответы
Что такое RAG простыми словами?
Перед ответом программа ищет в ваших текстах несколько близких кусков и подкладывает их модели, которая пишет уже по ним. Веса модели ваш файл при этом не переписывает.
Что такое RAG-система?
В системе три части: нарезка документов на куски, поиск ближайших кусков по вопросу и генерация ответа по вопросу вместе с этими кусками. Иногда сверху добавляют пересортировку длинного списка кандидатов.
Что такое RAG в контексте длинного файла?
Окно — текст, который модель видит за один заход. Если файл длиннее окна или сидит неудобно в середине, в заход попадает верхушка поиска, а сам файл остаётся снаружи. В опыте 2023 года середина длинного входа была слабым местом даже у моделей с расширенным окном.
Что такое технология RAG и что такое RAG-модель?
В статье Льюиса и соавторов от 22 мая 2020 года RAG-модель — это BART и искатель DPR, дообученные вместе на вопросах и ответах. Технологией сегодня называют и более простой приём: куски ищут отдельно и приклеивают к запросу уже готовой модели. Общее у них одно: ответ опирается на найденный текст рядом с опорой на веса.
Нейросеть отвечает по документу. Откуда ошибка в цитате?
Чаще всего в ответ попал соседний кусок, фразу разрезали нарезкой или модель достроила строку из собственной памяти. Цитату стоит найти в исходном файле обычным поиском по редкому слову. Нет строки — документ в этот ответ не вошёл.
Связанные модели


Связанные гайды
- Модель для аналитики
Как выбрать модель GPThub для саммари, таблиц, отчётов и длинного контекста: Gemini 3.8 Flash, DeepSeek, GLM 5.2, GPT-6.1 Sol, Claude, Kimi. Без API-прайсов.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- Lewis и др. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv:2005.11401, текст v4
- Карточка той же работы на arXiv, даты версий и пометка NeurIPS 2020
- Liu и др. Lost in the Middle, arXiv:2307.03172
- Журнальная версия Lost in the Middle, TACL 2024
- Anthropic, Contextual Retrieval
- Справка Claude: RAG в проектах
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Какую модель взять для длинного файла
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.