
Что такое промпт — запрос к нейросети и чем он отличается от вопроса

Обозреватель: как устроен ИИ
Содержание
30 ноября 2022 года OpenAI выложила короткий пост «Introducing ChatGPT». Среди описаний и примеров в нём есть раздел об ограничениях, и одно из них звучит почти бытово: модель чувствительна к формулировке. Спросите одним способом — она ответит, что не знает. Чуть перефразируйте тот же вопрос — и она ответит верно. Для поисковика такое поведение выглядело бы поломкой. Для языковой модели это нормальное свойство, и из него вырастает всё, что сегодня называют промптами. Там же OpenAI объясняет происхождение модели. ChatGPT — родственник InstructGPT, которую обучали следовать инструкции в промпте и давать развёрнутый ответ. Ключевое слово здесь — инструкция. Модель получает задание и выполняет его настолько хорошо, насколько ясно оно сформулировано.
Что такое промпт простыми словами
Слово пришло из английского prompt — «подсказка», «реплика суфлёра», «приглашение к действию». В разговоре о нейросетях промпт — это входной текст, на который языковая модель пишет продолжение. Google в документации Gemini API называет подбор таких текстов «дизайном промптов»: процессом создания запросов на естественном языке, которые дают точные и качественные ответы.
Определение кажется узким, пока не посмотреть, что именно считается входным текстом. Это не только фраза, которую вы набрали. В типичном чате к ней добавляются правила сервиса, предыдущие реплики, прикреплённые файлы. Всё это склеивается в один пакет и уходит в модель. Её ответ — продолжение этого пакета целиком.
Здесь полезна связка из нескольких терминов. Токен — кусок текста, с которым модель работает за один шаг: слово, часть слова или знак препинания. Окно контекста — сколько токенов модель учитывает одновременно, включая ваш промпт, вложения и уже написанный ответ. Генерация — выбор следующего токена с учётом всего, что лежит в окне. Подробнее о том, как это устроено внутри, — в статье «Что такое LLM».
Из этой связки следует простой вывод. Модель не «слышит» вашу фразу отдельно от остального. Она видит весь текст в окне, и ваша последняя строка — только его хвост. Поэтому второе сообщение в диалоге («сократи вдвое», «перепиши для девятого класса») тоже промпт, просто короткий: всю работу за него делает история, которая уже лежит выше.
Чем запрос к нейросети отличается от вопроса
Привычная аналогия — нейросеть как очень умный поисковик. Вы спрашиваете, она находит ответ. Аналогия удобная, но неверная в главном.
Поисковик работает с документами, которые уже существуют. Короткий запрос сопоставляется с индексом, алгоритм возвращает ссылки, а вывод делаете вы сами, открывая страницы. Языковая модель ничего не находит, если у неё не включён поиск и вы не приложили файл. Она пишет новый текст по закономерностям языка, которые усвоила при обучении, и по заданию, которое получила.
Google в той же документации даёт более точное сравнение: генеративные модели во многом работают как продвинутое автодополнение. Получив начало текста, модель продолжает его так, как продолжил бы правдоподобный документ. Вопрос — лишь один из видов такого начала. Google перечисляет четыре вида входа:
- вопрос — «Почему небо голубое?»;
- задание — «Составь план доклада о фотосинтезе на пять пунктов»;
- сущность, с которой нужно что-то сделать, — «Раздели эти пять растений на однолетние и многолетние: …»;
- незаконченный фрагмент, который нужно продолжить, — например, начало таблицы с двумя заполненными строками.
Вопрос в этом списке — самый неопределённый вариант. Он не говорит модели, сколько писать, для кого, в каком виде и что считать хорошим ответом. Всё это модель достраивает сама, опираясь на то, как обычно отвечают на похожие вопросы. Иногда угадывает, иногда нет.
| Вопрос в поиске | Промпт в чате | |
|---|---|---|
| Что происходит | Поиск готовой страницы | Генерация нового текста |
| Что учитывается | Строка запроса | Правила сервиса, история, файлы, ваш текст |
| Формат результата | Список ссылок | Тот, который вы задали, или угаданный моделью |
| Как проверять | Открыть источник | Сверить с фактами и с собственным заданием |
| Повтор | Похожая выдача | Другие слова могут дать другой ответ |
Из таблицы видна последняя важная разница. Поисковик не выдумывает: если страницы нет, её нет и в выдаче. Модель, получив задание без нужных данных, заполняет пробел правдоподобным текстом. Почему так происходит и как с этим жить — отдельная статья «Почему нейросеть выдумывает». Для разговора о промптах достаточно запомнить: хороший запрос уменьшает пространство для догадок, но не убирает его совсем.
Из чего состоит запрос к нейросети
Разработчики, которые подключают модели к своим продуктам, видят промпт без обёртки, и там он заметно сложнее одного сообщения. OpenAI в руководстве по промптам описывает роли сообщений. Роль developer — правила от создателя приложения. Роль user — то, что пишет человек. Роль assistant — предыдущие ответы модели. Отдельно у OpenAI есть параметр instructions для высокоуровневых правил: тона, целей, ограничений. По документации, эти инструкции имеют приоритет над текстом, который приходит от пользователя.
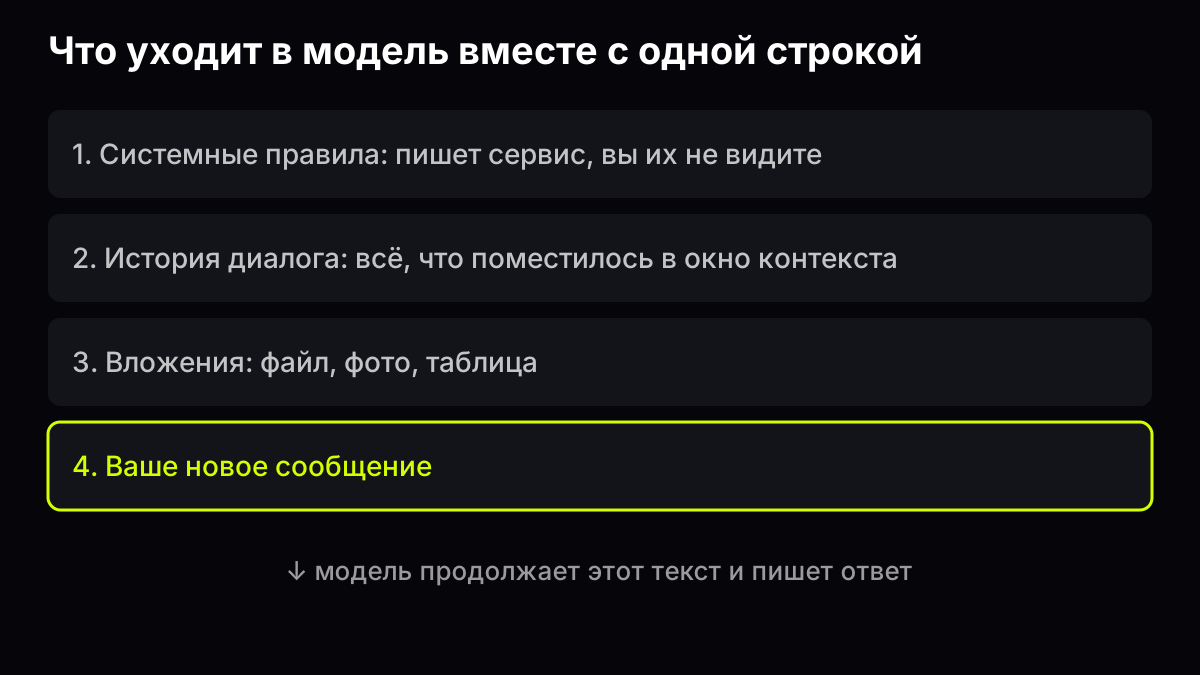
Схема слоёв запроса, иллюстрация GPThub по документации OpenAI
Обычный чат собирает эти слои за вас. Порядок примерно такой.
- Системные правила сервиса. Их пишет команда продукта, вы их не видите.
- История диалога — столько реплик, сколько помещается в окно контекста.
- Вложения: фотография задачи, PDF с лекцией, таблица.
- Ваше новое сообщение.
У каждого слоя свои последствия. Если диалог длинный, ранние реплики выпадают из окна, и договорённость «отвечай без вступлений» из начала разговора модель просто перестаёт видеть. Если вложения нет, вопрос «что на слайде?» лишён смысла. С файлом та же фраза становится полноценным заданием. Если системные правила требуют краткости, просьба написать развёрнутый текст может закончиться компромиссом, и виновата будет не ваша формулировка.
Что такое системный промпт
Системный промпт — инструкции, которые сервис подставляет до вашего текста. В них обычно описана роль помощника, тон, язык по умолчанию, запреты, иногда правила оформления. В обычном окне чата пользователь их не редактирует и чаще всего не видит.
Системный промпт объясняет загадку, с которой сталкивается почти каждый. Одна и та же модель в двух разных сервисах отвечает по-разному: в одном коротко и сухо, в другом подробно и с оговорками. Модель та же, а пакет, в который завернут ваш текст, разный. Причём системный промпт может быть длиннее любого вашего сообщения в несколько раз.
Кроме главного системного промпта, в продуктах бывают служебные. Отдельная инструкция придумывает название чата, другая решает, отправить запрос в генератор картинок или в текстовую модель, третья пересказывает длинный диалог, чтобы он поместился в окно. Их вы тоже не видите, но они участвуют в цепочке.
Практическое следствие одно. Если ответ упорно получается «не тем», иногда дело в рамке, а не в вашей фразе. Тогда помогает смена режима, другой чат или другая модель. Как выбирать модель под задачу, разобрано в гайде «Как выбрать модель».
Что такое текстовый промпт
Текстовый промпт — часть пакета, которую пишете вы. Это может быть одно слово «продолжи», если задача уже описана выше, или страница с подробным заданием. В разговорах о генерации картинок так же называют текстовое описание кадра, в отличие от картинки-образца.
Большинство удачных текстовых промптов отвечают на четыре вопроса, даже если автор об этом не думал.
- Что сделать: пересказать, сравнить, проверить, написать код.
- На основе чего: только приложенный текст, общие знания модели или и то и другое.
- В каком виде: список, абзац, таблица, для кого и каким языком.
- Где остановиться: объём, число пунктов, что делать, если данных не хватает.
Anthropic в справке по промптам предлагает простую проверку. Покажите свой промпт коллеге, который почти ничего не знает о задаче. Если он запутается, модель запутается тоже. Тест хорош тем, что не требует никаких знаний о нейросетях: вы проверяете ясность обычного человеческого задания.
Сравните две формулировки одной задачи. Первая — «Напиши про блокаду Ленинграда». Вторая — «Тема — блокада Ленинграда. Около 800 слов для старшеклассника: введение, три причины, почему блокада была такой тяжёлой, абзац о повседневной жизни, вывод без новых фактов. Если не уверена в цифре, не пиши её, а отметь „проверить по учебнику“». Во втором варианте модели почти не приходится гадать, и вам проще понять, выполнено ли задание.
Что такое промпт-инжиниринг
Промпт-инжиниринг — русская калька с prompt engineering. OpenAI в руководстве определяет его как процесс написания эффективных инструкций, при которых модель стабильно выдаёт нужный результат. Слово «стабильно» тут главное. Один удачный ответ с третьей попытки — ещё не результат; промпт, который даёт нужное раз за разом, — уже да.
Google добавляет к этому вторую мысль: промпт-инжиниринг итеративен, и любые рекомендации — отправная точка, а не готовая формула. Цикл выглядит скучно и именно поэтому работает. Черновой запрос, ответ, вы отмечаете, чего не хватает и что лишнее, правите формулировку, снова смотрите на ответ.
Громкое название создаёт ложное впечатление, будто существуют секретные слова, открывающие скрытые способности модели. На деле приёмы довольно приземлённые: ясная задача, пример нужного результата, явный формат, критерий проверки. Если модель путает стиль, ей показывают абзац в нужном тоне. Если путает структуру, просят таблицу с заданными столбцами.
Для разработчиков это отдельная профессиональная работа: промпт в продукте должен выдержать тысячи разных пользователей. Для человека, который просто пишет в чат, хватает привычки задавать задачу целиком. Конкретные приёмы, шаблоны и разбор ошибок собраны в гайде «Как писать промпты». Эта статья отвечает на вопрос «что это», гайд — на вопрос «как».
Промпт для картинки и для видео
Слово закрепилось не только за текстовыми чатами. В генераторах изображений промпт описывает кадр. Логика та же: чем меньше неопределённости, тем ближе результат к задуманному. Проверять же результат приходится глазами.
Короткий ярлык вроде «красивый закат» оставляет генератору всё: формат кадра, стиль, точку съёмки, наличие людей. Описание для оператора работает лучше: «закат над морем, вид с балкона, без людей и надписей, спокойные тона, горизонт в нижней трети кадра». Такой промпт длиннее, зато по нему видно, какая часть описания не сработала. Подробнее — в гайде «Работа с картинками».
Видеопромпт добавляет движение: что происходит в кадре и как ведёт себя камера. «Камера медленно приближается к чашке, над ней поднимается пар, текста в кадре нет». Длинный сюжет одним запросом обычно не получается, его собирают из коротких сцен, и у каждой свой промпт. Чем генерация ролика отличается от монтажа отснятого, разобрано в статье «Нейросети для видео».
Почему одни и те же слова дают разные ответы
Вернёмся к наблюдению из первого поста OpenAI о ChatGPT: небольшая перефразировка вопроса может превратить «не знаю» в верный ответ. Если помнить, что модель продолжает текст и не ищет готовую запись в базе, в этом нет ничего загадочного — разные слова в начале ведут к разным правдоподобным продолжениям, и каждое из них модель достраивает по своей логике.
Причин у такой изменчивости несколько, и полезно различать их, потому что лечатся они по-разному. Первая причина — сама формулировка: слово «объясни» тянет за собой учебный тон, слово «перечисли» — список, а слово «докажи» — рассуждение с выводом, хотя тема во всех трёх случаях одна и та же. Вторая причина — контекст, который лежит выше вашего сообщения: в новом чате и в чате, где вы полчаса обсуждали другую тему, одна и та же фраза попадает в разные пакеты. Третья причина — рамка сервиса, то есть системный промпт и настройки, которые у разных продуктов разные. Четвёртая — сама модель: разные семейства обучены на разных данных и по-разному понимают, что считать хорошим ответом.
Кроме того, многие чаты при генерации оставляют модели некоторую свободу выбора следующего слова, поэтому даже два одинаковых запроса подряд в одном и том же месте могут дать немного разные тексты. Для сочинения это скорее плюс, для проверки фактов — повод насторожиться: если от повтора к повтору меняются даты и числа, значит, модель их не знает и подбирает правдоподобные.
Отсюда практический вывод, который пригодится в любой работе с нейросетью. Если ответ важен, полезно отправить запрос дважды или переформулировать его и сравнить результаты; то, что совпадает, скорее всего держится на данных, а то, что расходится, требует проверки по внешнему источнику.
Разбор одного запроса по частям
Чтобы связать всё сказанное, возьмём один реальный по форме запрос студента и разберём, из каких частей он состоит и что каждая часть делает с ответом. Пусть задача такая: к семинару по экономике нужно коротко объяснить, что такое инфляция, опираясь на страницу из учебника.
Первый вариант, который пишут чаще всего, — «что такое инфляция». Это чистый вопрос в терминах Google: в нём нет ни задачи, ни исходных данных, ни формата. Модель ответит определением из общих знаний, вероятно правильным, но не обязательно совпадающим с формулировкой вашего учебника, и объём ответа она выберет сама.
Второй вариант добавляет задачу и сущность: «Ниже страница из учебника. Объясни по ней, что такое инфляция, для выступления на семинаре». Теперь у модели есть материал, на который нужно опираться, и понятная цель, хотя объём и форма по-прежнему остаются на её усмотрение.
Третий вариант закрывает оставшиеся вопросы: «Ниже страница из учебника. Объясни по ней, что такое инфляция, для выступления на семинаре на две минуты: определение одним предложением, две причины и один пример из текста. Используй только то, что есть на странице; если чего-то не хватает, напиши, чего именно». Здесь есть всё из списка выше — что сделать, на основе чего, в каком виде и где остановиться, — и, что важнее, по такому заданию легко проверить ответ: определение либо совпадает со страницей, либо нет, пример либо взят из текста, либо придуман.
Обратите внимание, что третий вариант не содержит никаких особых слов, ролей или хитрых конструкций. Он просто написан так, как написал бы задание преподаватель, который хочет получить проверяемую работу. В большинстве случаев именно в этом и состоит хороший промпт, а более тонкие приёмы вроде примеров ответа или пошагового рассуждения разобраны в гайде.
Примеры промптов и что смотреть в ответе
Три учебные ситуации. Они показывают, как промпт меняет ответ; шаблоны для копирования лежат в гайде.
Пересказ. Слабо: «Перескажи». Лучше: «Ниже абзац из учебника биологии. Перескажи его в пяти предложениях, сохрани термин „митохондрия“, не добавляй ничего, чего нет в абзаце». В ответе проверьте, не появились ли факты, которых не было в исходнике, и не раздулся ли текст.
Проверка решения. Слабо: «Где ошибка?» без самой задачи. Лучше: «Вот задача и моё решение. Проверь только алгебру, назови строку, где появилась первая ошибка, не решай заново целиком». Проверьте, указано ли конкретное место и сходится ли исправление с вашим пересчётом.
Подготовка к зачёту. Слабо: «Спроси меня по истории». Лучше: «Тема — реформы Александра II. Задавай по одному короткому вопросу, жди моего ответа, потом скажи, что я упустил. Всего десять вопросов». Проверьте, держит ли модель формат и совпадают ли даты с учебником.
Хороший способ увидеть чувствительность к формулировке своими глазами — отправить одну задачу дважды, разными словами, и сравнить ответы. В чате GPThub это удобно делать на разных моделях: например, Gemini 3.8 Flash и DeepSeek-V4-Flash уже доступны в чате GPThub. Разница между ответами покажет, насколько ваш запрос оставляет модели свободу.
Как проверить ответ модели
Промпт задаёт работу, но не гарантирует правду. Проверка остаётся за вами.
- Факты с датами и числами — по учебнику, энциклопедии или первичному документу.
- Формат — совпало ли число пунктов, есть ли таблица, тот ли язык.
- Границы задачи — не добавила ли модель того, что вы просили не добавлять.
- Повторная отправка — если ответы на один и тот же промпт расходятся в фактах, формат нужно ужесточить или проверить факты внешним источником.
- Ссылки — если модель назвала источник, откройте его сами.
Код проще всего проверить запуском, хотя бы на примерах из условия. Гуманитарный текст полезно прочитать вслух: сбивчивые места слышны раньше, чем видны.
Типичные ошибки
Задавать вопрос там, где нужно задание. «Кто такой Пушкин?» даст биографию, но не разбор одного стихотворения и не план сочинения, пока вы об этом не попросите.
Забывать об окне контекста. В длинном диалоге условия из начала выпадают, и их приходится напоминать или начинать новый чат с коротким резюме.
Складывать в один запрос пять задач. «Переведи, сократи, сделай презентацию и проверь факты» обычно выполняется наполовину. Цепочка коротких сообщений работает надёжнее.
Ждать свежих новостей без поиска. Модель знает мир на момент обучения, если у сервиса не включён поиск и вы не вставили текст сами.
Копировать чужой промпт без контекста. Автор мог писать его под другую модель, другие системные правила или файл, которого у вас нет.
Как формулировать запрос под учёбу
Учебное задание почти никогда не сводится к теме. В методичке указаны объём, структура, список литературы. Если перенести в чат только заголовок, модель заполнит пробелы сама, и как раз там появляются «лишние» факты и непроверяемые даты.
Рабочий приём — переписать условие почти дословно и добавить критерий проверки: «опирайся только на текст ниже», «если в тексте нет цифры, не добавляй её». Если нужен черновик, так и скажите. Фраза «черновик для правки» снимает с модели задачу написать идеальный текст и обычно уменьшает количество украшательств.
При групповой работе полезно договориться об одном общем запросе с форматом и запретами. Иначе у одного получится список, у другого сплошной текст, и части не сойдутся. А если вы пользовались чатом при подготовке проекта, сохраните исходный промпт вместе с ответом: так проще показать, где модель помогла со структурой, а где вы сами проверили факты.
Последний совет практичный. Удачные промпты стоит хранить в заметках с пометкой, на какой модели они сработали. Через месяц станет видно, какие формулировки переживают проверку, а какие приходится переписывать каждый раз.
Вопросы и ответы
Что такое промпт для нейросети?
Это входной текст, на который модель пишет ответ: ваше сообщение вместе с историей диалога, вложениями и скрытыми правилами сервиса.
Что такое промпт простыми словами?
Задание для нейросети, сформулированное словами: что сделать, на основе чего и в каком виде вернуть результат.
Что такое системный промпт?
Инструкции, которые сервис добавляет перед вашим текстом: роль помощника, тон, язык, ограничения. Пользователь их обычно не видит и не редактирует.
Что такое текстовый промпт?
Часть запроса, которую пишете вы сами. В генераторах картинок так называют словесное описание кадра.
Что такое промпт-инжиниринг?
Правка формулировок до тех пор, пока модель не начнёт стабильно давать нужный результат. Это итерации и проверка ответов.
Что такое хороший промпт?
Тот, по которому можно проверить ответ: в нём понятна задача, указаны исходные данные, формат и что делать, если данных не хватает.
Связанные модели


Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Как собрать хороший запрос шаг за шагом — в гайде
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.