
Оживить фото нейросетью: как из одного снимка получается движение

Обозреватель: как устроен ИИ
Содержание
25 февраля 2021 года генеалогический сервис MyHeritage добавил на сайт функцию Deep Nostalgia: загружаешь старый семейный снимок, и прабабушка на нём моргает, поворачивает голову и улыбается. За первые 48 часов так оживили больше миллиона фотографий. С тех пор «оживить фото нейросетью» превратилось из фокуса в обычную задачу, только устроена она теперь совсем иначе. Ниже — как модель достраивает движение из одного кадра, что дают режимы с первым и последним кадром и откуда берутся странности на готовом ролике.
Как нейросеть оживляет фото: общий принцип
Первое, что приходит в голову, — аналогия с кукловодом. Будто нейросеть находит на фотографии руку, глаза и волосы, привязывает к ним ниточки и начинает за них дёргать, а снимок деформируется, как резиновый. Для части старых сервисов это почти правда. Для современных генераторов видео — уже нет, и разница объясняет почти все их сильные и слабые стороны.
Правильнее думать о художнике-мультипликаторе, которому дали первый рисунок и сказали: «нарисуй ещё сто сорок таких же, только пусть девочка повернётся к окну». Исходная фотография в этом случае — образец и опора. Каждый следующий кадр рисуется заново, и в нём нет ни одного пикселя, перенесённого из оригинала напрямую. Модель лишь следит, чтобы лицо, одежда и свет совпадали с образцом настолько, насколько получается.
Несколько терминов, без которых дальше будет тяжело. Кадр — одна картинка ролика, обычно их 24–30 на секунду. Генерация из картинки (в английских описаниях image-to-video) — режим, где снимок задаёт сцену, а текст описывает, что в ней должно произойти. Первый и последний кадр — режим, где задаются оба края клипа. Ключевые кадры — промежуточные опорные картинки внутри ролика. Опорные изображения — снимки персонажа или предмета, по которым модель держит внешность, но которые не обязаны стоять в ролике целиком.
В общих чертах модель смотрит на фотографию, читает описание и выдаёт пачку кадров, которые вместе выглядят как движение. Как именно это происходит, за пять лет поменялось полностью.
Первая волна: ключевые точки и чужое движение
Deep Nostalgia работала на технологии израильской компании D-ID, которая называла её Live Portrait. Что любопытно, само движение там было позаимствовано у людей: мимику записали по видео сотрудников MyHeritage, а нейросеть переносила эти кивки и улыбки на лицо с фотографии. Выбор у пользователя был небольшой — набор готовых «сценариев» движения, а не произвольное описание.
Научная основа таких систем хорошо видна по работе First Order Motion Model, которую Алиаксандр Сярохин и соавторы представили на конференции NeurIPS в 2019 году. Задача там поставлена так: есть неподвижный снимок и есть «ведущее» видео с другим человеком или предметом той же категории. Нужно, чтобы снимок повторил движение из видео. Модель сама, без ручной разметки, учится находить на изображении набор ключевых точек — условно, уголки глаз, кончик носа, линию подбородка — и описывает движение каждой точки вместе с небольшим поворотом и растяжением окрестности (в статье это называется локальными аффинными преобразованиями).
Дальше генератор берёт внешность с фотографии, движение с ведущего видео и склеивает одно с другим. Отдельно он учится дорисовывать то, что на исходном снимке было закрыто: если голова повернулась, у неё внезапно появляется ухо, которого на фото не видно. Обучали такие модели на видео одной категории — лица, тела, иногда что-то совсем экзотическое, вроде роботов-манипуляторов — и после этого они работали на любом объекте той же категории.
У подхода были понятные пределы. Модель знает только то, что видела в своей категории, поэтому кошка на «лицевой» модели превращается в нечто неприятное. Движение всегда чужое: придумать, что человек на фото встаёт и уходит, система не может, если такого нет в ведущем ролике. И фон почти не участвует — он либо стоит, либо растягивается вместе с головой. Тем не менее зрелище получилось впечатляющее: 10 миллионов лиц к 4 марта 2021 года, 72 миллиона анимаций за пять недель и около 100 миллионов к ноябрю того же года.
Диффузия: кадры, которых не было
Вторая волна началась с моделей, которые учились рисовать картинки из шума, и довольно быстро перекинулась на видео. Диффузионная модель — нейросеть, которую учат на огромном числе примеров постепенно убирать шум из изображения. В начале генерации у неё есть только случайная «рябь», и шаг за шагом из неё проступает картинка, подходящая под описание. Подробнее о том, как это работает для отдельных изображений, мы писали в статье нейросети для картинок.
Видео отличается тем, что шум убирается сразу из целой стопки кадров. Модель видит их все одновременно и учится не только тому, как выглядит каждый кадр, но и тому, как кадры меняются один относительно другого. Тут нужна огромная коллекция роликов: движение воды, походку, складки ткани на ветру модель должна где-то подсмотреть.
Хорошо задокументированный пример — Stable Video Diffusion от Stability AI, статья вышла 25 ноября 2023 года. Обучение в ней шло в три этапа: сначала модель учили на картинках, затем на видео, затем дообучали на небольшом наборе качественных роликов. Исходный набор назывался Large Video Dataset и насчитывал около 580 миллионов клипов (примерно 212 лет непрерывного просмотра, средний клип — около 11,6 секунды). После фильтрации осталось 152 миллиона. Отсеивали, среди прочего, ролики, где почти ничего не двигается: для этого считали оптический поток, то есть оценку того, куда смещаются точки изображения от кадра к кадру. Модель, которая насмотрелась слайд-шоу, оживлять фото не научится.
Как снимок попадает внутрь модели
Самая интересная часть — то, как именно исходная фотография управляет генерацией. В Stable Video Diffusion она подаётся двумя путями одновременно. Во-первых, снимок превращают в компактный числовой вектор (эмбеддинг) — сжатое описание «что тут изображено», и это описание ставят на место, где у обычной модели стоял бы текстовый запрос. Во-вторых, саму картинку, слегка зашумлённую, приклеивают к каждому кадру будущего ролика как дополнительный слой входных данных. Авторы прямо пишут, что ничего не маскируют: кадр просто копируют вдоль оси времени.
Получается, что каждый кадр ролика «видит» оригинал рядом с собой. Шум добавляют специально: если дать модели идеально чистую копию, она соблазнится просто повторить её и движения не будет. Ещё одна деталь — сила, с которой модель следует подсказке, в этой работе растёт от первого кадра к последнему. С постоянной силой ролик либо расходился с исходным снимком, либо становился пересвеченным, с кислотными цветами.
Модели из той статьи выдавали 14 или 25 кадров — меньше секунды при обычной частоте кадров или около секунды-двух при пониженной. Это немного, но с этого размера поколение и стартовало. Нынешние генераторы делают клипы в 8 секунд и длиннее, в 1080p и 4K, а принцип «снимок как условие для каждого кадра» в той или иной форме сохранился.
Откуда модель знает, как двигаться
Движение модель берёт из двух мест. Первое — описание: «камера медленно наезжает», «девушка поворачивается к окну», «ветер шевелит траву». Второе — её собственная статистика: если на снимке водопад, вода почти наверняка поедет вниз, даже если в тексте об этом ни слова. Именно поэтому снимок с очевидным сюжетом оживает лучше, чем портрет на однотонном фоне: на портрете модели приходится угадывать, что человеку «положено» делать.
Отсюда и практическое следствие для тех, кто пишет запрос. Описывать стоит движение и камеру, а не внешность — внешность уже есть на снимке. Об этом подробнее — в гайде как писать промпты.
Камера и объект — два разных движения
В описаниях генераторов движение почти всегда делят на две части, и для оживления фото это деление важнее, чем кажется. Первая часть — движение камеры: наезд, отъезд, панорама, облёт. Вторая — движение внутри сцены: человек поворачивается, вода течёт, флаг развевается.
Движение камеры для модели проще. По сути, ей нужно показать ту же сцену с чуть другой точки, и большая часть изображения остаётся узнаваемой — сдвигается перспектива, меняется масштаб, слегка открывается то, что было за краем кадра. Поэтому медленный наезд на старую фотографию почти всегда выглядит прилично, даже если сам снимок плохой.
Движение внутри сцены сложнее, потому что модель должна понять, что на снимке является отдельным предметом, где у него суставы и как он устроен с невидимой стороны. Человек, который поднимает руку, — это десятки решений подряд: где плечо, как ляжет рукав, что окажется за рукой. Причём каждое из них модель принимает заново в каждом кадре.
Когда в описании просят и то и другое сразу — «камера облетает героиню, а она поворачивается и машет рукой», — ошибки складываются. Скорее всего, именно поэтому самые удачные примеры на страницах разработчиков обычно показывают либо подвижную камеру и спокойную сцену, либо неподвижную камеру и живой сюжет. Совместить оба движения можно, но вероятность получить лишний палец растёт ощутимо.
Первый и последний кадр: зачем задавать оба края
Если один снимок — это начало истории, то два снимка — начало и конец. В режиме «первый и последний кадр» модель получает обе картинки и должна придумать, как сцена перейдёт из одного состояния в другое. Логика в таком решении есть — у модели меньше свободы, а значит, и меньше шансов уйти не туда.
Этот режим сейчас есть у большинства крупных генераторов. Google в описании Veo 3.1 обещает плавные переходы между заданными начальным и конечным изображением. У Kling 4.0, судя по странице разработчика, кроме двух краёв можно расставить до 10 промежуточных ключевых кадров (в тех режимах, где это поддерживается), а клип бывает от 3 до 30 секунд; предыдущая версия, Kling 3.0, ограничена 15 секундами. Сам разработчик советует брать для перехода два похожих снимка одной темы — иначе модели приходится изобретать слишком много.
Важная тонкость — последний кадр не всегда вклеивается в ролик буквально. Модель стремится к тому, чтобы финальный момент был на него похож, но пиксель в пиксель совпадение никто не гарантирует. Для обычного ролика это незаметно, для склейки двух клипов встык — бывает заметно.
Зацикленный ролик
Частный случай — когда первый и последний кадр одинаковые. Тогда ролик начинается и заканчивается одной и той же картинкой, и его можно крутить бесконечно без видимого шва: огонь в камине, качающиеся ветки, дым над чашкой. В чате GPThub так и устроена просьба «зациклить»: картинка уходит в модель сразу и первым, и последним кадром.
Работает это хорошо для сцен, где движение возвращается само: волна, маятник, дыхание. Хуже — там, где движение направленное. Если человек на снимке идёт вперёд, то вернуться в исходную точку за пять секунд ему придётся довольно странным способом.
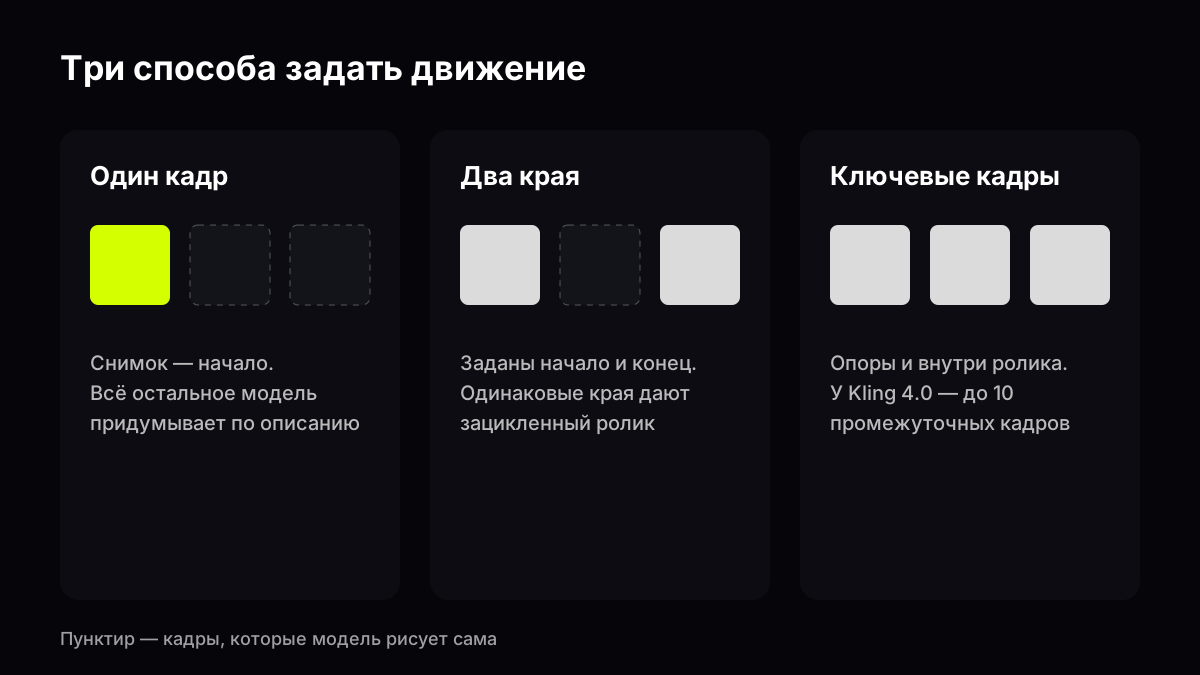
Схема GPThub по описаниям Veo 3.1 и Kling 4.0, ноябрь 2026
Почему оживлённое фото выглядит странно
Почти каждый, кто пробовал оживить снимок, видел одно из трёх: лицо к концу ролика становится чуть другим, руки обрастают лишними пальцами, предметы на заднем плане «тают» и сливаются. У всех трёх эффектов одна причина. Чем дальше кадр от исходного снимка — по времени или по углу обзора, — тем меньше у модели опоры и тем больше она угадывает.
- Лицо «плывёт». На снимке видна одна сторона лица. Когда голова поворачивается, вторую сторону модель рисует по своей статистике о лицах вообще, и та может оказаться чужой. Чем сильнее поворот, тем заметнее.
- Руки и пальцы. Пальцы на фотографии часто перекрывают друг друга, и модель не всегда понимает, сколько их. В движении ошибка, незаметная на одном кадре, становится очевидной.
- Тающий фон. Мелкие детали — надписи, узоры, листья — модель держит хуже, чем крупные формы. Если камера движется, детали фона перерисовываются в каждом кадре немного по-разному.
- Физика. Вода, ткань и волосы обычно получаются правдоподобно, потому что их в обучающих роликах много. Предметы, которые в жизни взаимодействуют сложно (руки, завязывающие шнурок, или жонглёр), — хуже.
С длительностью проблема та же. Продление сцены у Veo 3.1 устроено так: следующий клип продолжается от последней секунды предыдущего. Опорой для продолжения служит уже сгенерированный кадр, исходный снимок остаётся далеко позади, и ошибки начинают накапливаться. Поэтому длинный ролик из одной фотографии почти всегда хуже, чем несколько коротких, склеенных монтажом. Про то, где проходит граница между генерацией и монтажом, есть отдельный текст — нейросети для видео.
Параллакс и синемаграф: оживление без генерации
Задолго до диффузионных моделей фотографии «оживляли» вручную, и эти приёмы до сих пор встречаются в приложениях под той же вывеской. Полезно их различать — результат у них другой, и ожидания тоже.
Параллакс (иногда его называют эффектом 2,5D) — самый старый трюк. Снимок разрезают на слои: передний план, человек, фон. Потом слои сдвигают с разной скоростью, и камера будто плывёт мимо сцены. Нейросеть здесь если и участвует, то только на подготовительном этапе — она оценивает глубину, то есть решает, какой пиксель ближе к зрителю, и дорисовывает кусок фона, который открылся за сдвинутой фигурой. Сам человек на снимке не шевелится ни на миллиметр. Если прищуриться, это всё та же плоская фотография, только поставленная в театральные кулисы.
Синемаграф — снимок, в котором движется одна деталь: пар над чашкой, волосы на ветру, вода в фонтане, а всё остальное застыло. Раньше его делали из короткого видео, закрашивая маской всё, кроме одного участка. Генеративные модели научились делать нечто похожее из одной фотографии, если в описании прямо попросить «движется только вода, камера неподвижна». Впрочем, удержать остальную сцену полностью неподвижной им удаётся не всегда — где-нибудь на краю кадра обязательно шевельнётся лист.
Разница между этими приёмами и генерацией видео в том, сколько нового появляется в кадре. Параллакс не добавляет ничего, кроме небольшого куска фона. Синемаграф добавляет движение одного участка. Генератор видео в пределе может нарисовать всё: новый ракурс, новую позу, предметы, которых на снимке не было. Чем больше нового, тем эффектнее ролик и тем выше шанс, что модель ошибётся в деталях. Это довольно точное правило для выбора: если хочется, чтобы бабушка на фото осталась именно бабушкой, лучше просить минимум движения.
Что получается лучше всего
Если собрать опыт разработчиков и примеры из их же описаний, складывается довольно устойчивая картина. Лучше всего оживают снимки, где движение «подразумевается» сюжетом и не требует от модели изобретать невидимое.
| Что на снимке | Как оживает | Почему |
|---|---|---|
| Пейзаж с водой, облаками, деревьями | Хорошо | Движение очевидно, таких роликов в обучении много |
| Портрет анфас, лёгкая мимика | Хорошо | Лицо почти не поворачивается, опора сохраняется |
| Портрет с поворотом головы на профиль | Средне | Вторую половину лица модель придумывает |
| Группа людей, все двигаются | Средне и хуже | Много лиц и рук, ошибки множатся |
| Мелкий текст, вывески, документы | Плохо | Буквы перерисовываются в каждом кадре |
| Старое размытое фото | Зависит от снимка | Модель дорисует резкость, но лицо может стать чужим |
Отдельно о старых фотографиях, ради которых многие и ищут «нейросеть оживи фото». Снимок 1930-х годов обычно маленький, зернистый и с потерями. Модель, получив такое лицо, вынуждена достраивать черты, и результат может выглядеть убедительно и при этом не быть похожим на реального человека. Для семейного архива это стоит держать в голове: ролик — это интерпретация модели, а не восстановленная запись.
Ещё одно наблюдение касается освещения. Если на снимке жёсткий свет из одного окна, а в описании просят «камера облетает героя», модели придётся решать, как свет ляжет с другой стороны. Обычно она справляется, но тени иногда ведут себя так, будто источник света переехал вместе с камерой.
Оживить фото нейросетью на русском
Запрос «оживить фото нейросеть на русском» обычно означает две вещи: можно ли писать описание по-русски и не нужно ли ради этого куда-то ехать. По первому пункту ответ скорее положительный: большие модели понимают описание на русском, хотя у некоторых генераторов видео точность выше на английском. Короткое конкретное описание движения («медленно поворачивает голову к окну, камера неподвижна») работает на любом языке лучше длинного литературного.
По второму пункту — в GPThub генерация видео из картинки встроена прямо в чат: можно оживить и загруженный снимок, и картинку, которую модель только что нарисовала, у неё для этого есть кнопка «Оживить». Как подготовить снимок и что делать с картинками в чате, разобрано в гайде работа с картинками, а если непонятно, какую модель взять под задачу, — в гайде как выбрать модель.
Причём ограничения у таких функций есть и они разумные. Генераторы обычно отказываются оживлять снимки известных людей в компрометирующих сценах, а Google ставит на все ролики Veo невидимый водяной знак SynthID. Оживлять фотографию другого человека без его согласия и выдавать ролик за настоящую запись — плохая идея с любой точки зрения, и юридической тоже. Это не юридическая консультация, но здравый смысл здесь подсказывает то же, что и закон.
Что посмотреть дальше
За пять лет задача прошла путь от переноса чужой мимики по десятку точек к моделям, которые придумывают движение, звук и движение камеры сами. Следующий заметный шаг уже виден по описаниям разработчиков: длинные клипы и больше управляющих кадров внутри ролика. Kling 4.0 с его 30 секундами и десятью ключевыми кадрами — один такой пример.
Вторая линия — модели, которые умеют вести разговор о ролике. Google, например, 22 октября 2026 года отключила предварительные версии Veo 3.1 в своём интерфейсе для разработчиков и предлагает вместо них модель Gemini Omni Flash, которая принимает текст, картинки, звук и видео одновременно и правит результат в несколько реплик. Практически наверняка следующее поколение «оживления» будет выглядеть как диалог, где после первой попытки можно сказать «то же самое, только пусть не улыбается».
Если вы видите новость, что какой-то сервис «оживляет фото как живое видео минутами», разумнее всего открыть страницу разработчика и посмотреть, сколько секунд длится один клип и как он продлевается. Обычно ответ — несколько секунд и склейка, и это честный предел нынешнего поколения.
Вопросы и ответы
Как нейросеть оживляет фото?
Современная модель рисует новые кадры, используя снимок как образец для каждого из них, а описание — как подсказку о движении. Исходные пиксели она не двигает: каждый кадр создаётся заново и только похож на оригинал.
Можно ли оживить старое фото с плохим качеством?
Можно, но модели придётся дорисовывать черты лица и детали. Ролик может выйти убедительным и при этом не совсем похожим на реального человека, поэтому для семейного архива его стоит воспринимать как интерпретацию.
Что такое первый и последний кадр в генерации видео?
Это режим, в котором задаются обе картинки — начало и конец клипа, — а движение между ними модель достраивает сама. Если обе картинки одинаковые, получается зацикленный ролик без шва.
Почему лицо на оживлённом фото меняется?
Чем сильнее поворот головы и чем дальше кадр от исходного по времени, тем больше модель угадывает. Невидимую на снимке сторону лица она рисует по общей статистике и может ошибиться.
Можно ли писать описание для оживления фото на русском?
Да, крупные модели понимают русский. Лучше всего работает короткое описание движения и камеры, без перечисления внешности: внешность модель и так берёт со снимка.
Чем оживление фото отличается от параллакса?
Параллакс только сдвигает слои снимка с разной скоростью, люди на нём не двигаются. Генератор видео рисует новые кадры, поэтому может изменить позу, ракурс и мимику, но и ошибается чаще.
Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- First Order Motion Model for Image Animation, NeurIPS 2019
- Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets, 2023
- Veo — Google DeepMind
- Генерация видео в Gemini API — уведомление об отключении Veo 3.1 Preview
- Kling: генерация видео из картинки
- Kling: первый и последний кадр
- MyHeritage: Deep Nostalgia Goes Viral, февраль 2021
- MyHeritage: Deep Nostalgia is an Internet Sensation, март 2021
- D-ID: Deepening Our Relationship with MyHeritage, ноябрь 2021
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Оживить картинку в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.