
"ИИ для программиста: как меняется работа и какие модели брать"
Обозреватель: ИИ в работе
Содержание
Объяснение у всех наготове: нейросеть для программирования пишет код вместо человека, а программист только жмёт «принять». Я тоже так думала, пока не прочитала, что в опросе Stack Overflow 2025 года 66% разработчиков злятся на ответы, которые выглядят верными, но не сходятся. Скорость в лаборатории растёт. В обычном дне растёт доля проверки. Если вы ищете «ии для программиста» и хотите понять, что поменялось в работе, без таблицы моделей, этот текст для вас.
Обычно работу объясняют скоростью
Популярная картинка простая. Модель дописывает функцию. Модель переводит SQL в другой диалект. Модель объясняет стек-трейс новичку. В рекламе IDE это выглядит как конвейер: вы описали задачу, получили файл, отправили в репозиторий.
В контролируемом эксперименте GitHub и Microsoft Research разработчики с GitHub Copilot собрали HTTP-сервер на JavaScript в среднем за 1 час 11 минут, без Copilot — за 2 часа 41 минуту. Разница около 55%. Доля тех, кто вообще довёл задачу до конца, тоже выше у группы с Copilot: 78% против 70%. Это лабораторная задача с тестами, не год жизни продукта.
Полевые эксперименты крупнее, но шумнее. В работе по трём компаниям, Microsoft, Accenture и ещё одной, выборка 4867 разработчиков. Рост числа завершённых задач у тех, кто пользовался подсказками Copilot, составил 26%, стандартная ошибка 10,3%. Цифру считают по пользованию. Выдача доступа без пользования в неё не входит. Эффект меньше, чем в лаборатории, где ту же задачу закрывали примерно на 55% быстрее. Обычный день включает созвоны и ревью, лабораторный час их не измеряет.
Что это значит на практике, если убрать догадки. Новичку ИИ часто помогает стартовать. Ответственному за прод выигрыш в минутах на черновике легко съедается часом отладки, если черновик «почти верный». Опытному разработчику выгоднее отдавать модели скучные куски и оставлять себе архитектуру и границы риска.
ИИ для программиста: что сдвигается в рабочем дне
Под «нейросеть для программирования» люди имеют в виду разные вещи. Автодополнение в редакторе. Чат, куда вставляют ошибку. Агент, который сам ходит по файлам. В опросе Stack Overflow 2025 года агенты ещё не массовы: 38% не планируют их внедрять, около 31% пользуются хотя бы раз в месяц. Простые подсказки и чаты при этом живут каждый день у половины профессионалов.
Сдвиг первый: меньше чистого набора, больше чтения чужого текста. Даже если «чужой» текст сгенерировала модель, глаз всё равно ищет крайние случаи, стиль команды и скрытые зависимости. В том же опросе 45% жалуются, что отладка сгенерированного кода отнимает больше времени, чем ожидали.
Сдвиг второй: вопросы к людям не исчезают. В разделе про точность 46% активно не доверяют выводу, доверяют 33%, «полностью доверяю» — около 3%. В разборе того же опроса на блоге Stack Overflow: когда ответ кажется ненадёжным, 75% всё равно спрашивают человека.
Сдвиг третий: граница «сложно» двигается медленно. Доля профессионалов, которые считают, что ИИ плохо тянет сложные задачи, упала с 35% в 2024 году до 29% в 2025-м, но три десятых всё ещё большая группа. При этом 76% не планируют отдавать ИИ развёртывание и мониторинг, 69% — планирование проекта. Работа сместилась внутри реализации; она никуда не делась.
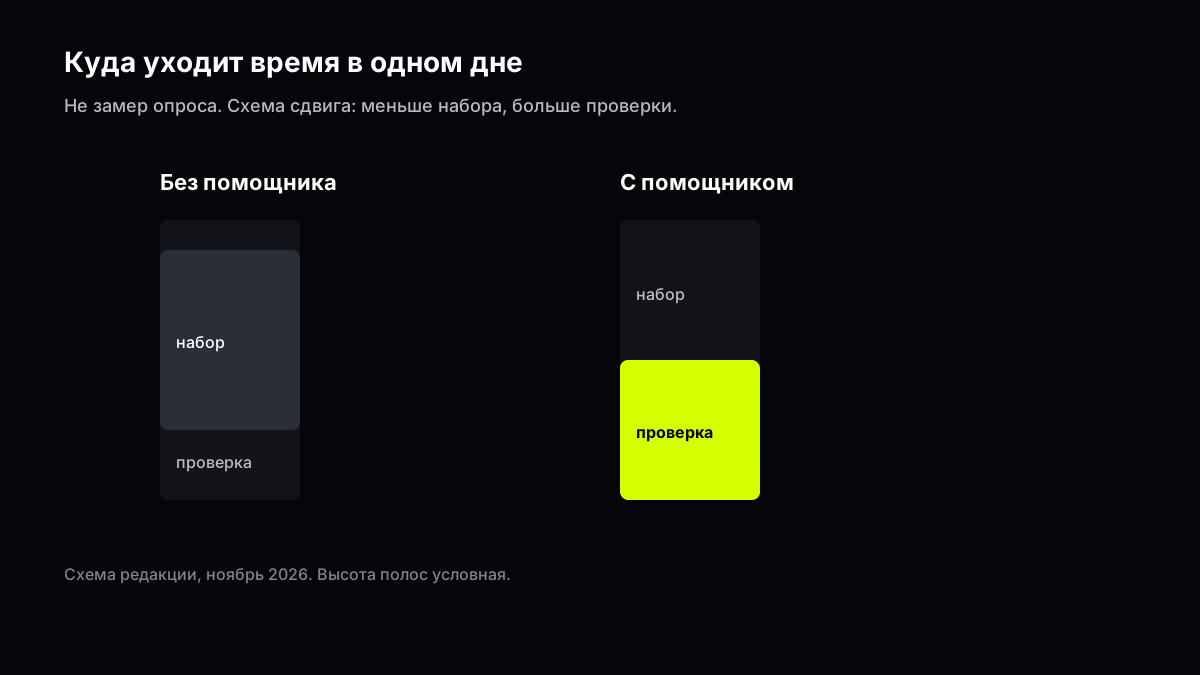
Иллюстрация редакции, ноябрь 2026. Сдвиг ролей, не цифры опроса.
Четвёртый сдвиг — инструменты вокруг редактора. В пресс-релизе Stack Overflow по опросу 2025 года впервые отдельно считали Cursor, около 18% респондентов, Claude Code около 10%, Windsurf около 5%. Visual Studio Code и Visual Studio по-прежнему вверху списка. Работа программиста всё чаще складывается из редактора и чата, не только из редактора и документации.
Пятый сдвиг касается обучения. В материале Stack Overflow по опросу 2025 года 44% использовали ИИ, чтобы учиться, а 36% начали программировать из-за ИИ. Первый вопрос всё чаще задают модели, потом сверяют по документации.
На собеседованиях это уже видно. Кандидат быстро приносит рабочий прототип, но плохо объясняет, почему выбран именно такой способ хранения данных. Ход мысли без автодополнения показывает, что голова на месте.
Нейросеть для программирования: какие куски отдают
Популярных советов пять. Ниже — бытовой смысл каждого, без обещания, что модель заменит команду.
Шаблон и повтор. Генерация типовых операций с данными, перевод структур между слоями, рутинные тесты на очевидные случаи. Модель хорошо держит форму, если вы дали пример из вашего репозитория. Плохо держит, если форма в каждом файле своя, а пример не вставили.
Объяснение чужого кода. «Что делает этот фрагмент» и «где может упасть на null». Ответ нужно читать как конспект, не как ревью архитектора. Если модель не видела весь репозиторий, она додумывает связи.
Перевод между языками и библиотеками. Старый скрипт на Perl в Python, запрос SQL из диалекта в диалект. Здесь удобна проверка тестами: прогнали — увидели расхождение.
Черновик документации. Описание параметров API по коду, черновик README. Факты сверяют по коду руками. Модель уверенно пишет несуществующие поля. Откуда берётся такой тон, разобрано в статье про выдумки модели.
Поиск направления при ошибке. Сообщение компилятора, короткий лог. Полезно, когда вы уже знаете предмет, но устали. Опасно, когда предмет новый: модель подберёт правдоподобную, но чужую причину.
Шестой пункт, который редко называют вслух: короткие сообщения коммита и описания запроса на слияние. Модель умеет сформулировать «что сделано» по вашему патчу. Это экономит пять минут и помогает ревьюеру, если текст правдивый. Если модель приукрасила, ревьюер читает ложную историю. Сверьте текст с патчем построчно и выкиньте прилагательные, которых нет в коде.
Что обычно оставляют себе: выбор границ сервиса, схема данных под нагрузку, права доступа, контракты между командами, решение «удаляем или чиним» в проде. Это совпадает с тем, что в опросе Stack Overflow разработчики не планируют отдавать ИИ.
Ещё один слой, о котором редко спорят вслух: чтение чужого кода после генерации. Раньше автор и ревьюер хотя бы видели ход мысли по мелким коммитам. Теперь один коммит может принести двести строк «как будто всегда так было». Попросите автора коротко пройти три ветки: где ошибка, где успех, где неочевидное допущение. Если человек путается в собственном файле, слияние рано, даже если тесты зелёные.
ИИ для написания кода и ловушка «почти верно»
Запрос «ии для написания кода» часто означает надежду на готовый файл. На практике файл приходит с мелкими несоответствиями: другая версия библиотеки, лишний await, тест, который проходит только на моках.
В опросе Stack Overflow 2025 года это названо главной жалобой: 66% сталкивались с решениями «почти верно, но не совсем». На втором месте отладка сгенерированного кода, её назвали 45% респондентов. Картина спорит с рекламой «нажми таб и забудь». Набор ускоряется, ответственность остаётся на человеке.
Типичные поломки, которые стоит проверить первыми.
- Границы и ошибки. Функция заточена под основной сценарий, без веток на пустой ввод, таймаут, отмену.
- Безопасность. SQL-склейка, подстановка строк в shell, секреты в примере «для наглядности».
- Зависимости. Пакет, которого нет в вашем lock-файле, или API, снятое два года назад.
- Тесты, которые не ловят смысл. Тест проверяет, что мок вызван, а не что контракт соблюдён.
- Стиль команды. Имена, слои, запрет на «удобную» глобальную переменную.
Пример запроса для разбора, не для слияния: «Вот функция и текст ошибки. Не переписывай файл. Назови три возможные причины и какую проверку сделать для каждой. Код не предлагай.» Запрос, который перед релизом лучше разбить: «Сделай микросервис целиком по этому абзацу.» Прочитайте просьбу вслух перед отправкой. Если она звучит как заказ готового продукта, режьте её на шаги.
Как формулировать короткие жёсткие запросы под код, разобрано в гиде промпты для кода. Кнопки там. Здесь их не повторяю.
Почему «быстрее набросок» не равно «быстрее релиз»
В лаборатории GitHub задача была ограничена: один сервер, один язык, автоматические тесты. В продукте добавляются согласования, регрессия по смежным модулям, проверка лицензий на фрагменты, которые модель могла подсмотреть в обучении. Поэтому личный выигрыш в пятницу легко превращается в коллективный проигрыш в понедельник, если черновик попал в общую ветку без пометки.
В команде полезно одно простое правило. Любой кусок больше двадцати строк, где участвовал чат, в описании запроса на слияние помечается одной фразой: «черновик от модели, проверено тестами X и руками Y». Так ревьюер знает, куда смотреть пристальнее. Без пометки время уходит на стиль, а не на риск.
Старт карьеры и «вайб-кодинг»
В опросе Stack Overflow 2025 года отдельно спрашивали про код по описанию без разбора строк, когда человек принимает ответ, не проверяя каждую строку. Большинство так не работает: 72% ответили «нет», ещё 5% ответили резко. На первой стажировке ошибка без проверки бьёт по репутации.
Если вы учитесь, модель полезна как собеседник, который не устаёт объяснять. Если вы уже отвечаете за прод, модель полезна как черновик, который вы обязаны разобрать. Граница проходит там, где ошибка становится дорогой. На собеседовании ход мысли на доске без автодополнения всё ещё спрашивают. Работодателю важна ваша голова, не средний ответ модели.
Программисты 1С и узкие платформы
Отдельный поток поиска — «ии для программистов 1с». Специфика в том, что язык и метаданные платформы живут в своей экосистеме. Обучающие тексты в открытом доступе смешаны: переводы, форумы, фрагменты без контекста конфигурации.
Модель может уверенно написать код, который похож на 1С, но опирается на несуществующий метод или смешивает управляемые и обычные формы. Человек, который не работал с вашей конфигурацией, и так не увидит подвох. Модель добавляет уверенность, не добавляя доступ к вашему хранилищу.
Что здесь разумно. Отдавать модели описание ошибки на русском и просить гипотезы, не готовый модуль. Вставлять выдержку из синтакс-помощника, если она у вас уже есть. Не отдавать целиком обработку с правами и проводками без ревью бухгалтерии и без прогона на копии базы.
Если нужна именно модель под язык, а не общий чат, смотрите гид какая модель для кода. Там сравнение по задачам, здесь — предупреждение про платформенный риск.
Какие модели брать, если работа уже сдвинулась
Заголовок обещает и модели. Коротко, без таблицы победителей.
Для длинного файла и связного рефакторинга смысл имеют модели с большим окном контекста. В линейке DeepSeek у V4 Flash заявлено окно в 1 миллион токенов; устройство семейства разобрано в материале что такое DeepSeek, карточка DeepSeek V4 Flash. Разбор Claude Sonnet 5.5 и Grok 4.7 лежит в отдельных статьях. DeepSeek V4 Flash, Claude Sonnet 5.5 и Grok 4.7 уже доступны в чате GPThub.
«Лучший ии для программистов» в поиске — маркетинговая формулировка. В пресс-релизе по опросу 2025 года за год чаще называли модели OpenAI GPT, 81% респондентов. Claude Sonnet назвали 43% профессионалов. Это «что пробовали», не вердикт качества на вашем репозитории.
Практичнее выбрать две модели под две роли: одну на быстрый набросок и короткие вопросы, вторую на длинный контекст и аккуратное ревью. Как не ошибиться с выбором по типу задачи — в какая модель для кода. Общие правила смены модели — в как выбрать модель.
ИИ чаты для программистов и IDE: где вы работаете
«Ии чаты для программистов» и «ии инструменты для программистов» в подсказках поиска — про форму, не про магию. Чат в браузере удобен, когда нельзя поставить плагин. Плагин в редакторе кода удобен, когда нужен поток дополнений. Агент в редакторе удобен, когда готовы отдать ему дерево файлов и принять, что он пойдёт не туда.
В опросе 2025 года агенты используют меньшинство, но среди использующих 69% согласны, что выросла продуктивность. Это субъективные ответы, не замер вашего продукта.
Чужой репозиторий из статьи не проверить. Если вы пробуете агент впервые, начните с копии ветки и задачи, где ошибка не трогает пользователей. Пусть агент перечислит файлы, которые собирается менять, до того как меняет.
Веб-чат с несколькими моделями удобен, когда нужно сравнить формулировки ответа или прогнать один и тот же фрагмент без смены аккаунта у пяти сервисов. Это не замена вашему редактору и не доступ к закрытому репозиторию.
Работа программиста и ИИ: что не исчезает
Запрос «работа для программиста ии» часто звучит как страх или как надежда, что найм схлопнется. В опросе Stack Overflow 2025 года 64% не считают ИИ угрозой своей работе; в 2024 было 68%. Цифра чуть просела, паники в данных нет.
Исчезает монотонный слой внутри профессии. Остаются согласование требований, компромисс между скоростью и долгом, объяснение решения младшему коллеге, разбор инцидента в три ночи, когда логов больше, чем терпения. ИИ может набросать гипотезу по логу. Он не несёт ответственность перед клиентом.
Ещё одна линия, о которой редко пишут в рекламе: собеседования и онбординг. Компании всё чаще просят на живом интервью показать ход мысли, а не только результат. Если кандидат привык принимать дополнение модели не глядя, это видно на первой же задаче с нестандартным ограничением. С другой стороны, умение быстро проверять черновик становится таким же навыком, как умение читать документацию на английском десять лет назад.
Для руководителя команды меняется контроль качества. Ревью нужно смотреть на «слишком гладкий» код: без лишних веток, но и без защиты. У младшего разработчика растёт риск ложной уверенности: тесты зелёные, а смысл мимо. У старшего растёт ценность короткого точного ревью, потому что поток черновиков стал толще. На созвоне имеет смысл отдельно спросить: «что именно проверили руками после генерации», а не только «успели ли».
В удалённых командах из России картина та же, что в глобальном опросе, только доступ к IDE с встроенным ИИ иногда упирается в политику компании, а не в железо. Тогда остаётся браузерный чат для коротких вопросов и локальный редактор без отправки кода наружу. Смешивать «секретный фрагмент в чат» и «открытый учебный пример» в одной вкладке опасно: рука привыкает вставлять всё подряд.
Что проверять перед слиянием
Список без магии. Нужны ваш патч, тесты, которые команда реально гоняет, и пять минут на вопрос «что модель не могла знать».
- Прогоните тесты локально, не только те, что модель предложила добавить.
- Прочитайте патч глазами на строки, которые вы не просили менять. Лишние правки — частый симптом «почти верно».
- Сверьте версии зависимостей с вашим lock-файлом или аналогом.
- Поищите в патче секреты, адреса внутренних сервисов, персональные данные в примерах.
- Если код трогает права и роли, проверьте сценарий «обычный пользователь пытается лишнее» отдельно от основного сценария.
- Спросите автора в ревью одним предложением: «какую часть писал ты, какую модель». Если человек не может ответить, слияние рано.
Когда в команде появился общий чат с моделью
Командные правила меняются медленнее, чем личные привычки. Пока один разработчик экономит десять минут на функции, другой уже злится на странный стиль в общем модуле. Без разговора это выглядит как «кто-то стал хуже писать», хотя просто изменился инструмент.
Три договорённости, без которых общий чат быстро становится проблемой. Первое: секреты и персональные данные не идут в облачный чат, даже «на минутку». Второе: сгенерированный код проходит те же тесты и то же ревью, что и ручной. Третье: лицензии на зависимости и фрагменты из ответа модели проверяет тот, кто нажимает «слить», потому что модель не отвечает перед заказчиком.
На практике это означает скучные вещи. Отдельный учебный репозиторий для проб с моделью, не прод. Запрет вставлять ключи в запрос даже в виде «я заменил буквы». Список разрешённых сервисов нужен, если безопасность компании этого требует. Какая формулировка подойдёт вашему юристу, из статьи не видно, и я его не подменяю. Без первого пункта остальные два не спасают.
Если команда маленькая, формальный документ не обязателен. Достаточно договорённости в общем чате команды: «не кидаем прод-код в публичные сервисы» и «помечаем большие куски от модели». Когда команда растёт, устные правила забываются, и тогда уже нужен текст.
Что показал опрос осени 2026 года
Опрос 2025 года остаётся лучшим источником про «почти верный» код. К ноябрю 2026 вышел следующий, шестнадцатый опрос Stack Overflow. Его разобрали 6 октября 2026 года. Ответов больше тридцати тысяч, сбор шёл семь недель.
Картина сдвинулась к ежедневной привычке. Среди тех, кто пользуется помощниками и агентами для кода, 73% делают это каждый день. Сами помощники и агенты назвали 66% респондентов, обычные чаты — 63%.
Куда отдают работу, тоже видно. На странице опроса код в знакомой области назвали около 69%, отладку и рефакторинг — около 64%. В разборе на блоге развёртывание, эксплуатация и разбор инцидента — 20%. Рутина внутри файла ушла к модели раньше, чем ответственность за прод.
Предпочтения по агентам не стоит смешивать с долями редакторов годичной давности. В опросе 2026 года среди агентов чаще называли Claude Code, 66%, и GitHub Copilot, 59%. Цифры Cursor из опроса 2025 года отвечали на другой вопрос.
Ещё две цифры для руководителя. 62% всех респондентов смотрят на ИИ хотя бы скорее положительно. 16% делают лишний заход, чтобы перепроверить ответ модели, и это меньше, чем годом ранее. Доверие выросло. Слепоты в этих цифрах нет.
Вопросы и ответы
Подойдёт ли нейросеть для программирования на моём стеке?
Зависит от того, насколько ваш стек представлен в открытых текстах и насколько у вас есть тесты, а не от красивого названия языка. Для распространённых языков модель обычно даёт черновик. Для редкой платформы или старой версии черновик нужно проверять жёстче. Конкретный выбор модели — в гиде какая модель для кода.
Чем ии для написания кода отличается от автодополнения в редакторе?
Автодополнение подсказывает следующие строки в файле, который вы уже открыли. Чат и агент принимают описание задачи, куски логов, несколько файлов. Агент может менять дерево проекта сам. Чем шире инструмент, тем больше времени уходит на проверку, даже если набор ускорился.
Есть ли лучший ии для программистов?
Готового «лучшего для всех» нет. В опросе Stack Overflow 2025 года чаще пробовали модели OpenAI GPT и Claude Sonnet, но это статистика опроса, не результат на вашем коде. Имеет смысл держать две модели под разные задачи и сравнивать на одном фрагменте, а рейтинг из опроса брать только как подсказку.
Поможет ли ии программистам 1С?
Как помощник для гипотез и перефразирования ошибки — да, с осторожностью. Как автор готовой обработки без ревью — рискованно: модель путает версии платформы и конфигурации. Сверяйте синтаксис с вашей документацией и гоняйте на копии базы.
Меняет ли ии работу программиста в найме?
Меняет состав дня: меньше чистого набора, больше ревью, тестов и объяснений. В опросе 2025 года большинство не видят прямую угрозу роли, но доверие к автоматическому коду падает, хотя использование растёт. Похоже на смену инструмента, не на исчезновение профессии.
Где пробовать ии чаты для программистов без установки плагина?
Подойдёт любой веб-чат с сильными моделями, если вы не отправляете секреты и не вставляете закрытый код без политики компании. В одном окне чата удобно сравнить ответы разных моделей на одном фрагменте; выбор модели под задачу кода описан в гиде, не здесь.
Связанные модели


Связанные гайды
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
- Промпты для кода
Как просить нейросеть чинить баги, писать патчи, ревьюить код и тесты в GPThub. Готовые шаблоны и выбор модели под задачу.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- Stack Overflow Developer Survey 2025, раздел AI
- Пресс-релиз Stack Overflow о Developer Survey 2025
- GitHub: исследование продуктивности Copilot
- Microsoft Research: The Impact of AI on Developer Productivity
- MIT: The Effects of Generative AI on High-Skilled Work (черновик, три полевых эксперимента)
- Страница Microsoft Research по тем же трём экспериментам
- Разбор опроса 2025 года на блоге Stack Overflow
- Итоги опроса 2026 года, 6 октября 2026
- Опрос 2026 года, раздел AI
Об авторе
Обозреватель: ИИ в работе
Пишет о том, как нейросети меняют работу и где без человека не обойтись.
Открыть чат и проверить свой фрагмент
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.