
Большая языковая модель: что это и чем она не «просто чат»

Обозреватель: как устроен ИИ
Содержание
30 ноября 2022 года OpenAI выложила в открытый доступ ChatGPT и в анонсе описала его скромно: модель ведёт диалог, отвечает на уточняющие вопросы и умеет признать ошибку. Тем же текстом компания предупредила, что ответы иногда выглядят правдоподобно, но оказываются неверными или бессмысленными. Обе фразы полезно держать в голове, когда разбираешься, что такое большая языковая модель. Окно с полем ввода — только оболочка. Под ней лежит обученная сеть из миллиардов чисел, которая умеет одно: угадывать, каким будет следующий кусок текста.
Что такое большая языковая модель
Первое, что обычно приходит в голову, — сравнить модель с огромной энциклопедией, в которой ищут нужную страницу. Сравнение неверное. Страниц внутри нет. Есть параметры — числа, которые настраивались во время обучения и вместе задают, как сеть реагирует на уже увиденный текст. Слово «большая» как раз про их количество. GPT‑3, которую OpenAI описала 28 мая 2020 года, содержала 175 миллиардов параметров — примерно в десять раз больше, чем любая предыдущая плотная языковая модель того времени.
Ближе к правде другое сравнение: модель похожа на человека, который прочитал невероятно много и теперь по первым словам фразы чувствует, как она обычно продолжается. Модель читает начало текста и оценивает, какой фрагмент вероятнее всего идёт дальше. Потом добавляет выбранный фрагмент к началу и повторяет. Этот приём называется авторегрессией: в описании Transformer декодер выдаёт результат по одному символу за шаг и на каждом шаге использует всё, что уже сгенерировал, как дополнительный вход. Ответ не появляется целиком — его дописывают кусок за куском, и каждый следующий кусок зависит от предыдущих.
Теперь несколько терминов подряд. Токен — кусок текста из словаря модели: короткое слово, часть длинного слова или знак препинания. Токенизация — разбиение текста на такие куски. Окно контекста — сколько токенов модель учитывает за один запрос. Лимит ответа — сколько токенов она может выдать в одном сообщении.
В документации Gemini API Google пишет, что для моделей Gemini один токен примерно равен четырём символам, длинные слова режутся на несколько токенов, а 100 токенов соответствуют примерно 60–80 английским словам. Для русского соотношение другое — слова длиннее, окончаний больше, — но принцип тот же. Модель не видит букв по отдельности и не видит слов целиком, она видит последовательность номеров из своего словаря. Отсюда, кстати, классическая слабость: просьба посчитать буквы в длинном слове даётся модели хуже, чем пересказ целой главы.
Сокращение LLM — английское large language model, то есть та же «большая языковая модель». Когда в новостях пишут «LLM», «языковая модель», «нейросеть для текста», речь об одном классе систем. Это не бренд и не конкретная программа: свои линейки выпускают OpenAI, Google, Anthropic, xAI, DeepSeek и десятки других разработчиков.
Как модели учились: от рекуррентных сетей к Transformer
Чтобы понять, почему всё устроено именно так, нужно отступить на десяток лет назад. До 2017 года языковые модели в основном были рекуррентными: читали текст слово за словом, по цепочке, и передавали дальше сжатое «впечатление» от прочитанного. У такого подхода две беды. Длинный текст приходится обрабатывать строго по порядку, поэтому обучение плохо распараллеливается. А к концу длинной фразы начало успевает размыться.
В июне 2017 года группа исследователей Google выложила на arXiv статью «Attention Is All You Need» — «Внимание — всё, что вам нужно». Название звучало почти как шутка, но содержание было серьёзным. Авторы предложили архитектуру Transformer без рекуррентных слоёв вовсе. Её главный механизм — внимание: каждое слово напрямую «смотрит» на все остальные слова фрагмента и решает, какие из них важны для его смысла. Связь между первым и сотым словом устанавливается за фиксированное число операций, без пробега по всей цепочке.
Результаты оказались убедительными уже на переводе. На наборе WMT 2014 с английского на немецкий Transformer набрал 28,4 балла BLEU и обошёл прежний лучший результат, включая ансамбли из нескольких моделей, больше чем на 2 балла. На паре английский — французский одна модель получила 41,8 BLEU после обучения в течение 3,5 суток на восьми видеокартах P100. По меркам нынешних обучений, которые идут месяцами на тысячах ускорителей, это до смешного скромный бюджет.
С тех пор архитектуру много раз меняли в деталях, но скелет остался прежним. Окна контекста выросли с нескольких страниц до целых книг. Появились смеси экспертов — схема, при которой на каждый токен работает лишь часть параметров, хотя общий размер модели огромен. Появились режимы рассуждения, когда модель сначала пишет внутренний черновик и только потом ответ. Подробный разбор одной открытой линейки со смесью экспертов и цифрами по параметрам есть в статье про DeepSeek: там хорошо видно, как большой общий размер сочетается с небольшой активной частью на каждое слово.
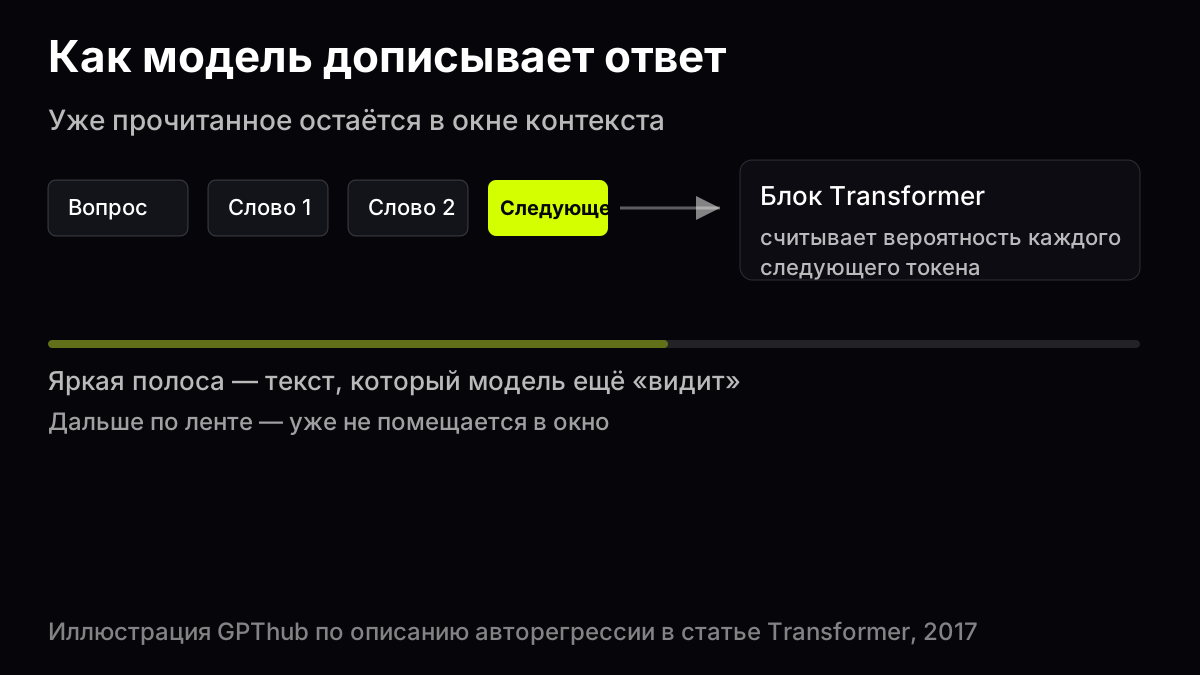
Схема авторегрессии по описанию Transformer 2017 года, иллюстрация GPThub
Для экзамена по информатике полезно запомнить цепочку: токенизация → Transformer с вниманием → авторегрессия → дообучение под ассистента → интерфейс чата. Если в билете спрашивают о принципе работы больших языковых моделей, ждут именно предсказание следующего токена и механизм внимания.
Как устроено обучение
Прежде всего идёт предобучение. Модели показывают огромные массивы текста — книги, статьи, код, страницы сайтов — и учат угадывать следующий токен. Никто на этом этапе не размечает правильные ответы на вопросы, задача одна — предсказание. Из неё вырастают умения, которым модель никто специально не учил: пересказ, перевод, решение коротких задач. Полный список источников для предобучения публично почти никто из разработчиков не раскрывает.
Уже на GPT‑3 OpenAI показала важную вещь. Модель можно было применять к новой задаче без дообучения весов: инструкцию и несколько примеров просто писали в тексте запроса, и модель продолжала по образцу. Этот приём называют обучением на нескольких примерах (few-shot). Им пользуются и сейчас, когда в запрос вставляют образец нужного формата.
После предобучения получается мощный, но неудобный инструмент. Он продолжает любой текст: на вопрос может ответить ещё тремя вопросами, потому что в интернете вопросы часто идут списком. Чтобы получился ассистент, нужен второй этап — дообучение. Для ChatGPT OpenAI описала метод обучения с подкреплением на основе обратной связи от людей (RLHF), тот же, что у предшественницы InstructGPT. Люди сначала сами писали образцовые диалоги за обе стороны. Затем сравнивали несколько ответов модели и ранжировали их по качеству. На этих сравнениях обучали отдельную модель награды, а основную модель дополнительно оптимизировали так, чтобы её ответы получали высокую оценку. Сама ChatGPT была дообучена из модели серии GPT‑3.5, обучение которой завершилось в начале 2022 года.
Anthropic описывает похожий слой у своей линейки. В тексте от 8 июня 2024 года компания пишет, что Claude 3 стала первой моделью, в дообучение которой добавили «тренировку характера». Само дообучение там названо частью обучения, которая идёт после основного и превращает модель, предсказывающую текст, в ассистента. Цель тренировки характера — дать модели черты вроде любопытства, открытости к другим взглядам и вдумчивости.
Среди черт, которые Anthropic перечисляет, есть и практичная для пользователя. Модель должна понимать о себе, что не может запоминать прошлые разговоры, учиться на них и обновлять собственную базу знаний. То есть «вчера мы обсуждали параграф 3» сама модель не вспомнит. Если сервис хранит память отдельно, это его функция, а не свойство весов.
| Этап | Что происходит | Что получает пользователь |
|---|---|---|
| Предобучение | угадывание следующего токена на огромных текстах | общие языковые навыки, знания из корпуса |
| Дообучение | образцовые диалоги, сравнение ответов, правила поведения | ассистент, который отвечает на вопрос и держит формат |
| Настройки сервиса | скрытая инструкция, фильтры, выбор модели | одни и те же веса, но разное поведение в разных чатах |
Почему на один вопрос приходят разные ответы
Модель на каждом шаге получает не одно слово, а список вариантов с вероятностями. Сервис может всякий раз брать самый вероятный вариант, и тогда ответы почти одинаковые. Чаще он выбирает с небольшой долей случайности: так текст звучит живее, но на повторный вопрос приходит другая формулировка, а иногда и другой вывод. Насколько сильна эта случайность, задаёт настройка, которую обычно называют температурой. В чатах её, как правило, выставляет сам сервис.
Практический вывод простой. Если два ответа на одинаковый вопрос расходятся в факте, это сигнал: модель сама не уверена, и проверять нужно оба варианта. Если совпадают — это ещё не доказательство правоты, просто модель последовательна в своей ошибке или в своей правоте. Сверка с источником остаётся единственной надёжной проверкой.
Почему модель не похожа на поиск
Поисковик отвечает списком ссылок, и каждая страница в этом списке существовала до вашего запроса. Языковая модель устроена иначе: готового текста под каждый вопрос у неё нет. Она каждый раз заново собирает последовательность токенов, опираясь на закономерности, выученные при обучении.
Из этого следуют две вещи. Модель может связно объяснить тему, которая ни в одном документе не изложена именно так, — примерно как хороший конспект по нескольким учебникам, только без ссылок на них. И она же может уверенно написать неверную дату, несуществующую цитату или ссылку, которая выглядит настоящей. Для модели правдоподобное продолжение и верное продолжение — не одно и то же, хотя чаще всего они совпадают.
Поисковая выдача ранжирует страницы, модель ранжирует продолжения текста. Если в обучающих текстах часто встречалась устаревшая версия стандарта или программы, модель воспроизведёт её спокойным уверенным тоном, хотя на сайте разработчика давно лежит обновление. У каждой модели есть дата, после которой она ничего не видела при обучении, и о событиях позже этой даты она может знать только из того, что ей передали в запросе.
Модель и вложенный файл понимает по-своему. Она получает последовательность токенов, извлечённую из документа. Таблица в текстовом виде и та же таблица на фотографии страницы для неё — задачи разной сложности, и во втором случае ошибок в цифрах заметно больше. Если от точности чисел зависит оценка, лучше скопировать фрагмент текстом и проверить каждую цифру.
Окно контекста: что модель видит прямо сейчас
Окно контекста удобно представить как стол, на котором помещается ограниченное число листов. На него кладут скрытую инструкцию сервиса, всю вашу переписку, вложенный файл и оставляют место под ответ. Всё, что на стол не влезло, модель в этом запросе не видит вообще. У разных моделей окно разное, и сравнивать их по этому параметру удобнее через гайд по выбору модели, чем по рекламным заголовкам.
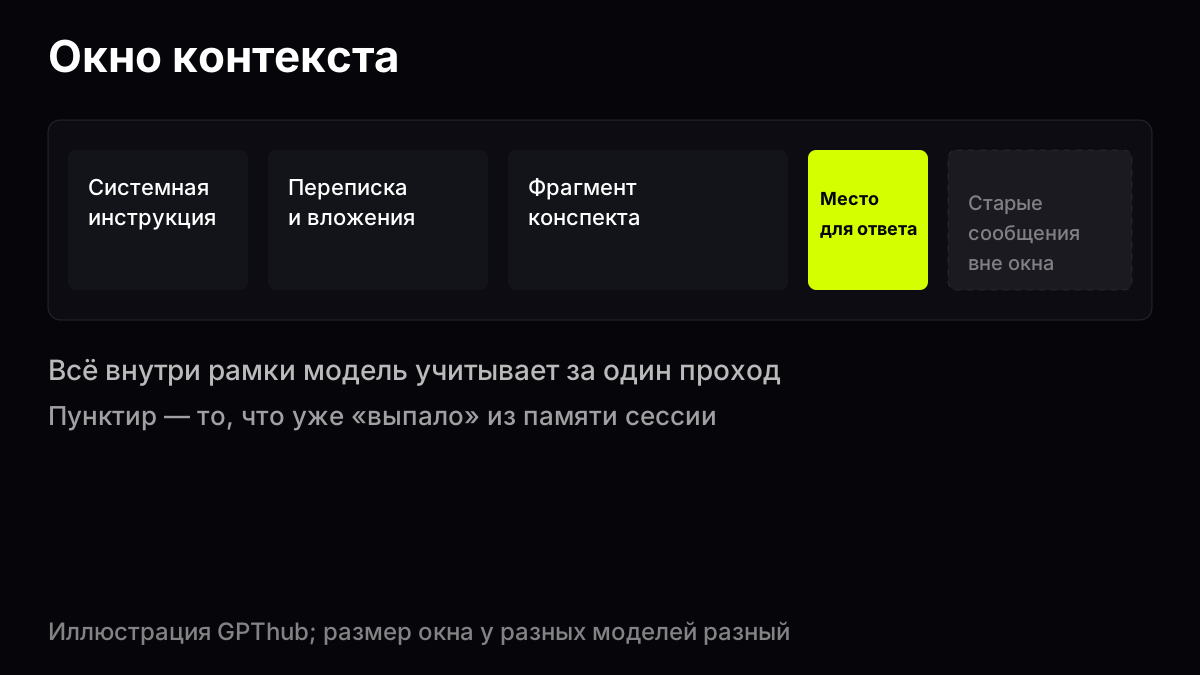
Схема окна контекста, иллюстрация GPThub; размер окна зависит от модели
Отсюда несколько практичных наблюдений. Длинный диалог из двадцати уточнений постепенно занимает место, и первые сообщения с условием задачи могут оказаться за краем. Модель начинает отвечать так, будто условия были другими. Помогает начинать новый диалог при смене темы или кратко повторять условия в конце длинной переписки.
Кнопка «остановить генерацию» обрывает только вывод. Уже напечатанный текст остаётся в контексте и влияет на следующий ответ. Если модель ушла в сторону, проще написать «не учитывай предыдущий черновик, ответь только по пунктам 1–3 из первого сообщения», чем спорить с каждым неверным абзацем.
Порядок материала тоже имеет значение. Контекст — часть входа, поэтому два запроса с одинаковыми абзацами в разном порядке могут дать ответы с разными акцентами, хотя веса модели те же. Обычно лучше сначала дать материал, а вопрос задать в самом конце.
Чем модель отличается от чата
Новостная формула «нейросеть ответила пользователю» склеивает три слоя. Нижний — веса, обученные на текстах. Средний — программа, которая собирает запрос, режет его на токены, добавляет инструкции и отправляет на сервер. Верхний — сайт или приложение с перепиской. Сбой бывает на любом уровне: модель в порядке, но файл обрезали при загрузке; интерфейс работает, но выбрана быстрая облегчённая версия модели.
Скрытая системная инструкция задаёт тон — кратко или развёрнуто, с таблицами или без, на «вы» или на «ты». Фильтры отсекают часть запросов. Поэтому наблюдение «в одном месте спросил — там умнее» часто сравнивает не модели, а настройки оболочек.
Имя в заголовке новости тоже обманчиво. GPT‑3 в 2020 году была одной моделью фиксированного размера. ChatGPT 2022 года — дообученный диалоговый вариант модели из серии GPT‑3.5. Ждать от них одинакового поведения — всё равно что сравнивать учебник с конспектом лекций по тому же предмету.
Поиск в интернете, распознавание фотографии доски, калькулятор и запуск кода — отдельные модули, которые чат подключает по своим правилам. Сама языковая модель может предложить формулу, но посчитать интеграл точнее калькулятора не обязана. Путаница между «умеет язык» и «умеет всё» — главный источник разочарования после первой недели работы с нейросетью.
В GPThub в одном чате можно переключать модели разных разработчиков — например, Gemini 3.8 Flash, Grok 4.7 или Claude Sonnet 5.5 — и смотреть, как меняется ответ на тот же вопрос. Все три уже доступны в чате.
Как работать с ответом модели
Главное правило — заставить модель опираться на ваш текст, а не на собственные знания о мире. Подробнее о формулировках — в гайде по запросам; ниже три типичных сценария с тем, что проверять.
Пересказ параграфа. Вставьте фрагмент учебника целиком, если он помещается в окно, и попросите: «Перескажи этот фрагмент в пяти предложениях простым языком, не добавляй фактов, которых нет в тексте». Проверка: каждое имя и каждая дата из ответа должны найтись в исходнике. Если модель добавила «исторический фон», которого не было, вычеркните его.
Разбор задачи по шагам. Запрос: «Реши задачу, после каждого шага напиши, какое правило используешь. Если данных не хватает — перечисли, чего не хватает, ничего не додумывай». Проверка: подставьте ответ обратно в условие. Если модель пропустила шаг, попросите расписать его отдельно.
Сравнение двух понятий. Запрос: «Составь таблицу из трёх строк — определение, пример, типичная ошибка. Если не уверен в определении, напиши „нужна проверка по учебнику“». Проверка: сверьте определения с конспектом. Строка про типичную ошибку чаще других получается красивой и выдуманной.
Разбор одного запроса
Возьмём плохой запрос: «Объясни тему 5». Модель не знает, какой у вас предмет, какой учебник и что такое «тема 5». Она выдаст общий текст на угаданную тему, и он может оказаться совсем не про то.
Тот же запрос, исправленный: «Я студент второго курса, предмет — теория вероятностей. Ниже параграф из учебника про условную вероятность. Объясни его своими словами, приведи один пример с игральными костями и в конце задай мне два вопроса для самопроверки. Не используй формулы, которых нет в параграфе». Здесь есть контекст, материал, формат ответа и запрет на лишнее. Проверить такой ответ легко: пример с костями можно пересчитать вручную, а формулы — сверить с параграфом.
Типичные ошибки
Со стороны пользователя ошибки повторяются одни и те же. Короткий вопрос без контекста. Просьба дать «точную цитату» без первоисточника в запросе. Ожидание, что модель помнит прошлую неделю, хотя переписку никто не вставил. Просьба «напиши реферат на десять страниц»: модель заполнит объём вероятными фразами, текст выйдет гладким и местами пустым, и преподаватель заметит это по однообразным связкам и отсутствию ссылок.
Со стороны модели — уверенный тон при неверном факте, смешение похожих терминов, устаревшие сведения о версиях программ и аккуратные, но несуществующие ссылки на статьи. Против всего этого работает одно и то же: давать материал в запросе, ограничивать ответ и проверять конкретику.
Полезно завести единый порядок проверки. Любое число из ответа ищется в лекции или учебнике. Любое определение сравнивается с глоссарием. Любой пример кода запускается, даже если выглядит рабочим. Для лабораторных по программированию отдельные советы собраны в гайде про модели для кода.
Если преподаватель разрешает пользоваться нейросетью, сохраняйте исходный запрос и ответ вместе с черновиком работы. Через месяц легко увидеть, где модель убедила вас в неверной трактовке. И уточните правила кафедры о данных: текст запроса уходит на сервер разработчика. Для учебных тем это обычно допустимо, для персональных данных или закрытых отчётов — может быть запрещено.
Какие модели имеет смысл сравнить
На ноябрь 2026 года в чате GPThub доступны большие языковые модели нескольких разработчиков. Gemini 3.8 Flash удобна для быстрых черновиков и коротких объяснений; подробнее о ней — в обзоре Gemini 3.8 Flash. Grok 4.7 и Claude Sonnet 5.5 по-разному обращаются с длинными вложениями и спорными вопросами, и эту разницу проще увидеть самому, чем прочитать о ней.
Смысл сравнения — понять, какая модель стабильнее на ваших предметах, а не найти «самую умную». Один и тот же подход по-разному работает на истории и на линейной алгебре: в первом случае нужен пересказ с опорой на документ, во втором — пошаговое решение с проверкой.
Перед сессией имеет смысл один раз прогнать на каждой модели короткий набор: вопрос на определение, пересказ вложенного абзаца и задачу на логику с лишними данными. Сразу видно, где модель срывается именно в вашем предмете. Ни одна из них не заменит конспект семинара, зато хорошо пересказывает ваш текст другими словами и находит пробелы в формулировках.
Вопросы и ответы
Что такое большая языковая модель LLM?
Это нейросеть с миллиардами параметров, обученная предсказывать продолжение текста. LLM — английское сокращение от large language model. В чате вы работаете с сервисом, который передаёт модели ваш текст и показывает сгенерированный ответ.
Что представляют собой большие языковые модели?
Это класс систем на основе Transformer, которые проходят предобучение на больших массивах текста и дообучение под диалог. Их выпускают разные компании: OpenAI, Google, Anthropic, xAI, DeepSeek и другие. Общее у всех одно — текст превращается в последовательность токенов, сеть оценивает вероятности продолжения, сервис показывает результат. Различаются размер, данные обучения, окно контекста и правила поведения.
Что такое контекст большой языковой модели?
Контекст — все токены, которые модель учитывает в одном запросе: инструкции, переписка, вложенный файл, уже написанная часть ответа. Если переписка или документ не помещаются, старые куски отбрасываются. Простая проверка — вставить длинный конспект и спросить о первом абзаце. Если модель путает детали, начало, вероятно, выпало из окна: сожмите текст или разбейте работу на части.
Что такое LLM простыми словами?
Программа, которая прочитала огромное количество текстов и научилась продолжать любой текст правдоподобно. Ответ на вопрос для неё — тоже продолжение текста, только после дообучения оно выглядит как ответ ассистента.
Большая языковая модель искусственного интеллекта — это только текст?
Это класс моделей искусственного интеллекта, заточенный под язык. Сама по себе она не видит камеру и не управляет роботом, но её встраивают в системы с поиском, распознаванием картинок и запуском кода.
Можно ли доверять ответу без проверки?
Для структуры и формулировок — часто да. Для дат, имён, чисел и цитат — нет, пока вы не сверились с источником. OpenAI предупреждала об этой проблеме ещё в анонсе ChatGPT.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат с моделью
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.