
Что такое датасет и зачем нейросети дообучение

Обозреватель: как устроен ИИ
Содержание
21 октября 2026 года фонд Common Crawl выложил очередной срез интернета. В архиве CC-MAIN-2026-43 лежит 2,16 миллиарда страниц, собранных с 5 по 18 октября. Несжатый текст занимает 371,19 ТиБ. Среди адресов 830,1 миллиона таких, которых в прежних обходах фонда не было. Эту гору ещё предстоит фильтровать, прежде чем из неё получится учебный текст. Сам по себе архив нейросетью не стал. Это сырой датасет, то есть пачка страниц, из которой лаборатория потом вырезает примеры. Датасет в разговоре про нейросети — пачка примеров в одном формате, где у картинки рядом стоит подпись класса, а у текста рядом стоит продолжение или ответ, который считают удачным. Без такой пачки модель не на чем учить, и гладкий ответ в чате этого факта не отменяет. Слово путают с таблицей в Яндекс DataLens и с файлом, который просто приложили к сообщению в чате. Ниже — чем эти три вещи отличаются и что именно меняют, когда говорят про дообучение.
Что такое датасет простыми словами
Привычная картина — лист Excel, где строка кажется примером, столбец признаком, а последняя ячейка ответом, и для таблицы продаж эта картина честная. Для нейросети она часто врёт. Пример бывает фотографией, куском звука или диалогом. Правильный выход бывает подписью папки, следующей фразой или пометкой «этот ответ лучше соседнего». Общее у всех этих пачек всё же есть. Примеры собраны вместе, формат у них общий, и заранее известно, что считать правильным выходом.
Связка терминов здесь короткая, и её лучше держать рядом. Пример — одна карточка в пачке, метка — то, что написано на обороте, класс или эталонный ответ, разбиение — способ поделить пачку на учёбу, проверку и экзамен. Эпоха — один полный проход по учебной части, а заучивание — случай, когда модель помнит карточки и спотыкается на новой.
Студенческий эталон, который до сих пор показывают на первом курсе, описан на странице Яна Лекуна. База MNIST хранит 60 000 обучающих образцов рукописных цифр и 10 000 тестовых. Цифры приведены к одному размеру и взяты из более старых баз NIST. Карточка тут и правда карточка, на лице рисунок, на обороте цифра от 0 до 9, и никакой скрытой таблицы за этим файлом нет.
Другой масштаб — фотографии предметов, и на странице загрузки ImageNet самый ходовой кусок назван прямо. Это набор соревнования ILSVRC 2012–2017 на 1000 классов, где 1 281 167 обучающих снимков, 50 000 проверочных и 100 000 тестовых. Страница самого соревнования 2012 года добавляет бытовую деталь. Проверку и тест собирали из фотографий Flickr и других поисковиков и размечали руками. 50 000 снимков с метками отдали участникам как проверку. Остальные на время оценки шли без меток. Обучающая пачка при этом была подмножеством ImageNet на те же 1000 категорий, около 1,2 миллиона снимков, и дубли с проверкой организаторы обещали убрать.
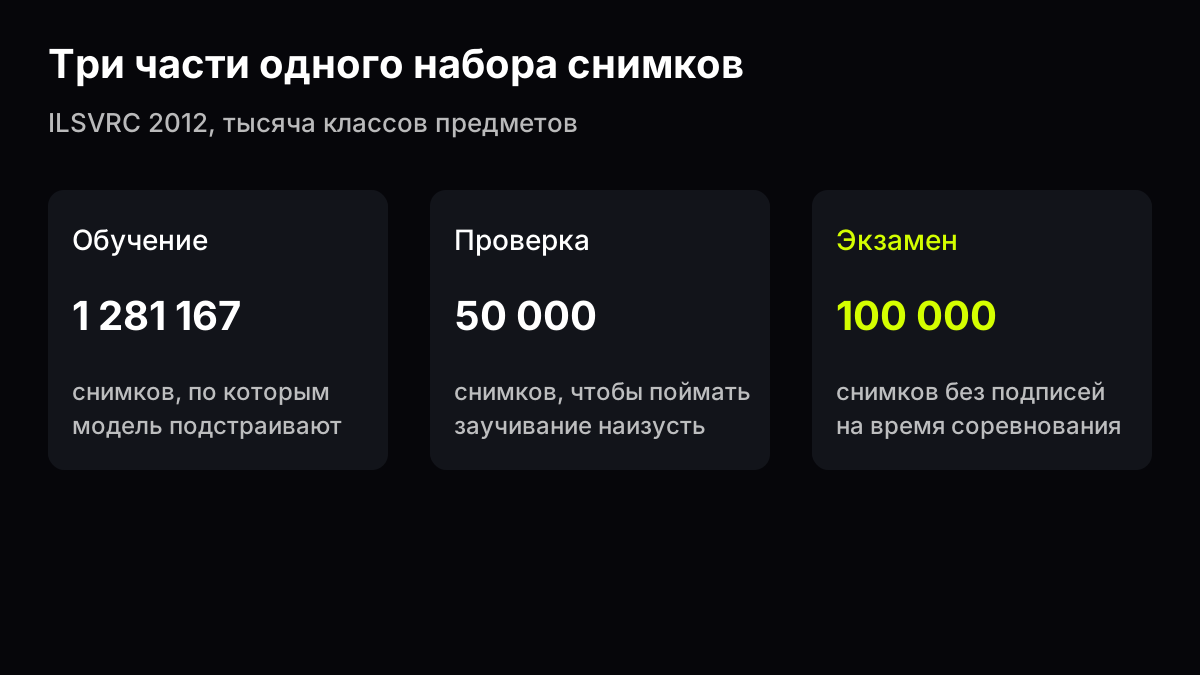
Источник: страница загрузки ImageNet, сверка 2 ноября 2026
Схема выше про одну мысль. Три числа относятся к одному и тому же списку классов, но роли у них разные. Учить можно только на первой куче. Хвастаться точностью честно только на той, которую при подборе не подсматривали.
Английское dataset в статьях и в документации — то же самое слово, его пишут латиницей в названиях файлов и в заголовках работ, а в русской речи уже прижилось «датасет», так что отдельного перевода не требуется. Путаница начинается там, где тем же словом называют совсем другой объект, и об этом следующий раздел, про DataLens.
Что такое датасет для нейронной сети
Нейросеть на входе ждёт объекты одной формы, слово «данные вообще» тут слишком рыхлое. У MNIST форма жёсткая. Каждый образец — цифра одного размера, метка — одно из десяти чисел. У снимков ILSVRC форма другая, картинка плюс один класс из тысячи. У текстовой модели форма снова другая. Кусок текста и то, какой кусок должен идти следом, либо пара «запрос человека и ответ, который хотели бы видеть».
Метка бывает явной, когда на обороте карточки написано «семёрка» или «самолёт», и бывает спрятанной в самом тексте, когда модель языка учат угадывать продолжение, а продолжение уже лежит в документе и отдельный человек его не подписывал. Оба случая всё равно датасет, и отличается только то, откуда взялся эталон.
Разметку руками делают там, где эталона в сырье нет, и страница ILSVRC 2012 прямо говорит, что фотографии проверки и теста размечены людьми по наличию категорий, а такая работа тянется долго. Поэтому большие языковые модели сначала учат на сыром тексте, где эталон — соседнее слово, а людей зовут позже, уже на короткую пачку ответов.
Пачка без описания формата почти бесполезна, потому что нужно знать, что считается одним примером, какие поля обязательны и чего в примере быть не должно. В документации OpenAI по дообучению с учителем учебный файл устроен так, что каждая строка — цельная запись с перепиской внутри, а в файле не меньше десяти таких строк. Человеку, который видел только таблицу, строка файла кажется бедной, хотя для чат-модели это полная карточка: есть реплика и есть желаемый ответ.
Хороший пример в той же документации описан бытово: он похож на то, что модель потом правда увидит, вопрос конкретный и ответ конкретный, а берут историю реальных диалогов, записи специалистов и журналы. Выдуманная «идеальная» фраза, которой в жизни не бывает, учит модель жизни, которой нет.
Отдельный вид карточки — сравнение двух ответов, и в описании прямого предпочтения у OpenAI у примера три части: запрос, ответ, который нравится больше, и ответ, который нравится меньше. Метка здесь — выбор из пары, а не класс предмета, и для студента это ближе к работе ассистента на кафедре, где лежат два решения одной задачи и преподаватель подчёркивает одно.
Что такое датасет в DataLens
Запрос «что такое датасет в DataLens» приходит из другой двери. Яндекс DataLens — сервис графиков и сводок. Документация, обновлённая 31 августа 2026 года, определяет датасет как описание набора и его структуры. Набор показан полями и построен поверх источника с уже готовым подключением.
Дальше расхождение с нейросетью становится резким: датасет DataLens работает в режиме прямого доступа, запросы выполняет источник, база или файл на той стороне, а сами данные через DataLens поменять нельзя. На уровне сервиса запрос к источнику обрывается через 80 секунд, и никакого многодневного обучения сети в этом определении нет.
Поля бывают двух ролей, это уже модель данных в той же документации. Измерение описывает характеристику вроде города, даты покупки или категории товара. Агрегацию на него не вешают. Показатель хранит число, которое сворачивают суммой, количеством или средним. В одном датасете не больше 1200 полей, и новые поля можно посчитать формулой из старых.
На странице про работу с датасетом, тоже с отметкой 31 августа 2026 года, есть ещё один предел: таблиц в одном датасете не больше 32, данные берут из таблиц источника или из SQL-запроса к нему, а связь между таблицами сервис предлагает сам, по первому совпадению имени и типа. Это конструктор витрины для графика, а не архив для обучения.
Поверх датасета в DataLens собирают чарт, график или таблицу на экране, и затем дашборд, причём один датасет может кормить много чартов, что аналитику удобно. Человеку, который ищет, на чём учится нейросеть, тот же экран легко сбивает с толку, потому что слово одно, а работа другая.
Короткий способ не перепутать выглядит так. Если в конце получается график продаж, перед вами датасет DataLens, а если в конце получаются новые числа внутри модели, перед вами учебный датасет. Общие файлы CSV встречаются в обоих мирах. Роль решает дальнейшая работа с файлом, а не буквы в его имени.
Студенту, которому задали и отчёт в DataLens, и работу про сеть, полезно держать два конспекта. В одном — поля, измерения, показатели, лимит 80 секунд. В другом — примеры, метки, разбиение на учёбу и экзамен. Смешивать абзацы этих конспектов в одном ответе — типичная ошибка чата, к ней вернёмся ниже.
На чём учится базовая модель
Базовая модель — та, которую уже выучили на огромной общей пачке, до вашей задачи (как устроена сама сеть, разобрано в статье что такое нейросеть), и её имеют в виду, когда говорят «просто спросить чат». Веса, внутренние числа, уже стоят, и ваш вопрос их не переписывает.
Откуда берётся общая пачка, по открытым следам видно лишь частично. Common Crawl с 2008 года копит обходы веба и прямо пишет, что после фильтрации сторонними группами эти архивы были основным сырьём для многих больших языковых моделей. Октябрьский срез 2026 года — 2,16 миллиарда страниц с 41,4 миллиона хостов. Весь архив фонд оценивает больше чем в 10 петабайт. Это сырьё, а не готовый курс. На странице фонда есть и круглая плашка про долю моделей, которые учились на этих данных, но методики рядом нет, поэтому долю здесь не повторяем.
Фильтр решает больше, чем объём, потому что в сыром обходе соседствуют инструкция, реклама, случайный форум и страница на языке, которого в задаче не будет. Лаборатория выкидывает дубли, режет слишком короткие документы и отделяет текст от разметки страницы, хотя публичный отчёт о составе есть не у всех и у части моделей смесь так и остаётся закрытой. Число «сколько слов она видела» без ссылки на отчёт лучше не цитировать.
Картинки устроены нагляднее, потому что соревнования публиковали правила, и ILSVRC просил цитировать две работы: базу ImageNet с конференции CVPR 2009 года (авторы Дэн, Дун, Сочер, Ли, Ли и Фей-Фей) и разбор самого соревнования, препринт 2014 года, Ольга Руссаковская и соавторы. Тысяча классов и три кучи снимков из этого разбора до сих пор самый понятный чертёж, где есть на чём учить, есть на чём остановиться и есть экзамен, метки которого участник во время игры не видел.
Текстовые модели почти все построены на одной схеме, о ней отдельный разбор трансформера. Маленькая база вроде MNIST учит одному навыку, узнать цифру, а большая текстовая пачка учит другому — продолжать текст так, чтобы продолжение было правдоподобным. Правдоподобие ещё не делает ответ верным на ваш вопрос, и модель может гладко продолжить миф, если миф часто встречался в архиве. Поэтому после базового обучения почти всегда идёт второй этап, уже на других карточках.
В чате это выглядит как готовый характер: модель отвечает связно, держит тему и иногда признаётся, что не знает, хотя характер собран чужим датасетом, а не вашим файлом во вложении. Вложение на один раз лежит в окне разговора, веса от него не меняются, и путаница этих двух режимов — главная бытовая ошибка, о которой стоит сказать прямо, пока речь не зашла про дообучение.
Дообучение нейросети: зачем второй набор
Дообучение — ещё один проход учёбы, уже по маленькой пачке, когда большая модель готова, и смысл пачки в том, чтобы показать, какой ответ в этой задаче считают хорошим: формат, тон, выбор класса, привычку звать нужную функцию. Общие знания о мире второй набор почти не приносит, их принёс первый.
Документация OpenAI по дообучению с учителем, как она читалась 2 ноября 2026 года, делит работу на четыре шага. Собрать набор и решить, что такое «хорошо». Загрузить его. Запустить дообучение выбранной базовой модели. Сравнить результат с базовой на заранее заготовленной проверке. Проверку просят завести раньше, чем тратить силы на учёбу, иначе нечем доказать, что стало лучше.
Про размер там же сказано без романтики: минимум 10 примеров, сдвиг замечают на 50–100, но нужное число сильно зависит от задачи, а старт, который они рекомендуют, — 50 аккуратных демонстраций и сразу оценка. Если от 50 штук ничего не меняется, копить сотни рано, и сначала меняют саму задачу или формулировку запроса.
Тот же текст честно описывает поломку, когда модель улучшается в начале, а потом заучивает набор вместо правила, которое переносится на новые вопросы. Для этого в конце каждой эпохи сохраняют полный снимок, и сейчас оставляют снимки только трёх последних эпох, где эпоха — очередной проход по учебной пачке. Если поздний снимок на новых вопросах хуже раннего, берут ранний, потому что пачка, которой хватило, чтобы заучить, оказалась слишком узкой или слишком долго крутилась по кругу.
Полное дообучение переписывает все числа модели, и на больших размерах это тяжело, поэтому 17 июня 2021 года Эдвард Ху и соавторы отправили статью про LoRA, а вторая версия вышла 16 октября того же года. Приём замораживает уже выученные веса и добавляет в каждый слой небольшие матрицы, которые как раз учат, и в аннотации пример — GPT-3 на 175 миллиардов параметров. По сравнению с полным дообучением методом Adam обучаемых параметров становится меньше в 10 000 раз. Памяти видеокарты нужно примерно втрое меньше. На проверках для RoBERTa, DeBERTa, GPT-2 и GPT-3 качество было не хуже полного прохода, без дополнительной задержки при ответе. Код и часть снимков авторы выложили отдельно.
Бытовая поправка к аналогии «модель дочитали книжкой» состоит в том, что книжка в окне чата — контекст одного разговора, а дообучение — отдельная работа, после которой появляется новая версия модели. Десять примеров в сообщении не запускают LoRA и не создают снимок эпохи, они помогают только текущему ответу, и это другой механизм, хотя сам по себе приём полезен.
У самого OpenAI этот контур для новых пользователей уже закрывают. Документация говорит, что платформа дообучения новым недоступна. Прежние заказчики могут ставить работы до 6 января 2027 года, если базовую модель не отключат раньше. Готовые дообученные модели живут, пока жива база. Для читателя вывод практический. Чужие лаборатории дообучают модели у себя, а в обычном разговоре вы приносите вопрос и, если нужно, несколько образцов прямо в текст, без кнопки «доучить на моей пачке».
В чате GPThub уже можно спросить DeepSeek V4 Flash или Gemini 3.8 Flash, как разложить свою пачку и чего в ней не хватает: модель опишет риски и не перепишет себя вашими строками. Как выбирать, кого звать под задачу, разобрано в гайде про выбор модели. Как держать сам запрос коротким и проверяемым — в гайде про запросы.
Как выглядит маленькая пачка и где она врёт
Возьмём задачу, которую узнает любой студент: модель по короткой реплике ставит одну из трёх пометок, «вопрос по условию», «просьба проверить решение» или «разговор не про учёбу». Базовая модель и так что-то ответит, а дообучение имело бы смысл, если пометки должны быть стабильными и в точных словах.
Карточка тогда выглядит так. На лице лежит реплика, которую правда писали, без придумки «для красоты». На обороте одна пометка из трёх и, если формат жёсткий, готовая фраза ответа. Пятьдесят таких пар — тот старт, о котором пишет документация, десять — нижний край, с которого работу вообще принимают в том контуре, а меньше десяти строк файл там учебным не считается.
Пачка врёт несколькими тихими способами, и первый из них — перекос, когда сорок восемь карточек про проверку решения и только две про болтовню, так что модель честно выучит, будто почти всё на свете есть просьба проверить решение. Второй — утечка экзамена, когда один и тот же диалог попал и в учёбу, и в проверку, и точность на проверке выходит красивой и пустой. Третий — чужая метка: двое размечали по-разному, в файл ушли оба варианта, модель осредняет противоречие и становится неуверенной ровно там, где люди сами не договорились.
Четвёртый способ ближе к тексту: эталонный ответ длиннее и вежливее любого живого, и после учёбы модель раздувает каждую реплику, хотя документация прямо просит класть в набор такие запросы и ответы, какие ждут в настоящей работе. Исторические переписки для этого честнее выдуманного идеала.
Пятый способ — слишком узкая тема, когда пятьдесят карточек про один предмет, а спрашивают про соседний: базовая модель соседний предмет ещё помнила, узкая пачка помнит его хуже, потому что все поправки весов тянули в одну сторону. Отсюда совет со снимками эпох, ведь ранний снимок иногда полезнее финального.
Проверка, которую можно сделать даже без своего обучения, простая: отложите десять реплик, которых нет в примерах для чата, и попросите модель разметить и отложенные, и учебные. Если учебные идеальны, а отложенные сыплются, перед вами заучивание, только в миниатюре одного окна, и тот же приём на большом дообучении называют отложенной выборкой. В документации просят, чтобы отложенная часть была так же разнообразна, как учебная.
На картинках соревнования разнообразие устроено жёстче: в ILSVRC классы не пересекаются, снимок экзамена не лежит в учебной куче, это оговорено отдельно, и дубли между кучами обещали убрать. Для студенческой пачки из пятидесяти строк такое обещание приходится выполнять руками, потому что один повтор уже сдвигает маленькую долю.
Что смотреть в ответе чата
Модель легко говорит слово «датасет» уверенно и мимо, поэтому имеет смысл принести ей конкретную пачку, хотя бы списком из десяти строк, и смотреть на четыре конкретные вещи. Гладкость ответа в этот список не входит.
Сначала смотрят, делит ли она учёбу и проверку так, чтобы проверка не повторяла учёбу: если в ответе одни и те же строки в обеих кучах, разбиение сломано. Затем смотрят, замечает ли она перекос, и если девять строк одного класса, а десятая другого, хороший ответ назовёт перекос, а не «сбалансированную выборку». Дальше смотрят, не путает ли ответ DataLens и обучение сети, потому что вопрос «что такое датасет» без уточнения часто даёт кашу из полей, графиков и эпох, а слова «для нейросети» или «в DataLens» должны увести в одну сторону. В конце смотрят, не обещает ли она, что вложение файла перепишет её веса: честный ответ скажет, что файл влияет на этот разговор.
На моделях вроде DeepSeek полезно отдельно спросить, публиковали ли авторы состав своего учебного архива, и в разборе DeepSeek как раз видно, насколько разные вещи компания описывает подробно, а какие оставляет у себя. Если модель в ответе выдумывает точный объём своего обучения, попросите ссылку на отчёт, и без ссылки этого числа нет.
Тот же приём годится для новостей про свежие модели: разбор Grok 4.7 показывает, как читать заявление разработчика, где таблица качества — их таблица, а состав датасета часто умещается в одну фразу. Фраза без состава не говорит, на каких примерах модель стала такой.
Типичная ошибка человека, а не модели, — приложить к вопросу сто строк и попросить «дообучись»: модель вежливо продолжит разговор и местами повторит ваши формулировки, веса останутся прежними, и завтра в новом чате этих ста строк уже не будет. Если задача и правда требует новой версии модели, это работа лаборатории, с отдельным набором, с отложенной проверкой и со снимками эпох, а в разговоре вы можете только отрепетировать, как такая пачка должна выглядеть.
Ещё одна ошибка — мерить успех на тех же карточках, которые только что показали, потому что модель их перескажет, и пересказ экзаменом не становится. Экзамен в духе ILSVRC — снимки, которые в учёбу не входили. Для текста экзамен — вопросы, которых не было в десяти примерах сообщения. Пока эта разница не видна на ваших строках, спорить о «качестве нейросети» рано.
На мой взгляд, пятьдесят честных карточек с живыми формулировками учат ожидание лучше, чем пятьсот прилизанных. Документация OpenAI говорит то же самое короче. Если пятьдесят хороших примеров не сдвинули проверку, дело не в нехватке строк.
Если вы увидели слово в новости
Новости про модели любят одну связку, «обучена на огромном датасете», и сразу ставят рядом цифру параметров. Параметры — числа внутри модели. Датасет — то, что ей показывали. Одно другого не заменяет. Модель с меньшим числом параметров на узкой честной пачке иногда аккуратнее огромной на грязном архиве, а иногда наоборот, и без состава пачки и без экзамена фраза ничего не решает.
Вторая связка — «дообучили, и она стала экспертом», и тут смотрят, на чём дообучили и что случилось с навыками рядом, потому что узкая пачка тянет веса к себе, а соседние навыки могут просесть. Статья про LoRA как раз про то, как добавить маленький обучаемый кусок и не тащить за собой полную копию на 175 миллиардов параметров, и она не обещает, что любая добавка делает эксперта.
Третья связка — «открытый датасет», и открытость бывает разной. Common Crawl открывает обход. ImageNet открывает правила куска ILSVRC и просит цитировать две статьи, а полную базу отдаёт по запросу и соглашению. MNIST много лет лежала как учебный файл на странице автора. Фраза «открытые данные» без адреса файла ещё не даёт датасет, с которым можно повторить опыт.
Если в новости есть только прилагательное «огромный», откройте первоисточник: для обхода веба это блог фонда и таблица архивов, для картинок — страница соревнования, для приёма дообучения — аннотация статьи с датой версии. Пересказ в ленте обычно теряет разбиение на учёбу и экзамен, а это как раз то, из-за чего число точности что-то значит.
Дальше имеет смысл смотреть на три вопроса. Что было одним примером. Кто поставил метку. Какая часть пачки не участвовала в подборе. Прилагательное из заголовка к этим вопросам ничего не добавляет. На эти три вопроса отвечает почти любой честный отчёт, а если не отвечает ни на один, отчёт про датасет ещё не начался.
Вопросы и ответы
Что такое датасет простыми словами?
Это пачка примеров одного формата, по которой учат модель или на которой её проверяют. У рукописных цифр MNIST в пачке 60 000 учебных образцов и 10 000 экзаменационных. У каждого на лице рисунок, а на обороте цифра.
Что такое датасет для нейронной сети?
Для сети пример должен быть одной и той же формы: картинка и класс, кусок текста и его продолжение, реплика и желаемый ответ или запрос и пара ответов, где один предпочтительнее. Форма записана заранее, иначе сеть не видит, где в пачке кончается одна карточка.
Что такое датасеты и чем они отличаются друг от друга?
Один набор отличается от другого составом примеров, способом метки и тем, как его разрезали. Обход Common Crawl — сырые страницы, и октябрь 2026 года дал 2,16 миллиарда штук. ILSVRC — размеченные фотографии тысячи классов. Маленький файл для дообучения — десятки пар «запрос и ответ». Путать их по слову «датасет» легко, а по работе нельзя.
Что такое датасет в DataLens?
В Яндекс DataLens это описание полей поверх подключения к источнику: запросы выполняет сам источник, данные через сервис не меняют, один запрос длиннее 80 секунд сервис обрывает, полей не больше 1200, таблиц не больше 32. График строится сверху, и нейросеть этим датасетом не учат.
Что такое дообучение нейросети?
Это второй этап учёбы, уже на небольшой пачке, после большой базовой модели: полный проход меняет все веса, приём LoRA веса замораживает и учит добавку. В документации OpenAI нижний край файла — 10 примеров, рабочий старт — около 50, и отдельно держат отложенные примеры, чтобы заметить заучивание.
Чем dataset отличается от слова «датасет»?
В работах на английском dataset — тот же учебный или проверочный набор, а по-русски говорят «датасет», тогда как в интерфейсе DataLens слово означает описание полей для графиков. Латинская строчка в поиске чаще ведёт к статьям про обучение, русская «в DataLens» — к документации Яндекса от 31 августа 2026 года.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Спросить модель про свой набор
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.