
Китайские нейросети: DeepSeek, Qwen, Kimi и соседние лаборатории
Обозреватель: модели и релизы
Содержание
К ноябрю 2026 года китайские нейросети перестали быть одной громкой фамилией. Рядом стоят четыре лаборатории с открытыми весами и длинным окном: DeepSeek, Qwen у Alibaba, Kimi у Moonshot и GLM у Z.ai. Собрали то, что сами лаборатории написали в карточках и блогах, и разложили по задаче. Это сравнение рядом: подробный рассказ о каждой линии лежит в отдельных разборах DeepSeek, Qwen и Kimi, а место Китая среди американских и европейских лабораторий показано на карте нейросетей 2026. Пять моделей из этой карты уже открываются в чате GPThub: DeepSeek V4 Flash, Kimi K2.6, Kimi K3, GLM 4.7 Flash и GLM 5.2.
Какие китайские нейросети открыть под задачу
Запрос «какие китайские нейросети» обычно прячет три разных вопроса. Кто пишет текст. Кто тянет длинный код. Кто делает картинку или объём.
Мы делим карту так:
- Черновик, перевод, разбор документа. DeepSeek V4 Flash. Окно миллион токенов, активных параметров мало, ответ приходит быстрее тяжёлой линии.
- Код, который надо довести до конца в одном репозитории. GLM 5.2 или Kimi K3. Обе лаборатории прямо меряют длинные инженерные прогоны.
- Код покороче и попроще, когда полный флагман избыточен. GLM 4.7 Flash и Kimi K2.6.
- Много языков и открытые веса разного размера. Линия Qwen 3.5 и 3.8 у Alibaba. В чате из этой статьи мы опираемся на пять карточек выше. Qwen здесь как соседняя лаборатория, чтобы карта не схлопнулась в три имени.
- Картинка по описанию. У Z.ai с 14 января 2026 есть GLM-Image. Текстовые GLM 5.2 и Kimi K3 картинку на выходе в своих карточках не обещают.
- Ролик. Отдельный генератор видео в карточках этих четырёх линий мы здесь не подтверждаем. Практический разбор ролика лежит в статье про нейросети для видео.
Как не перепутать имя и лабораторию, разобрано в гайде по выбору модели. Для кода есть отдельный гайд. Историю DeepSeek до четвёртого поколения мы уже писали в обзоре DeepSeek. Здесь только место лаборатории на карте.
Имена в поиске часто склеены. «Китайская нейросеть deep» и «deep seek» ведут в одну компанию, DeepSeek, а не в отдельный продукт. «Китайская модель нейросети» без фамилии ничего не выбирает: у каждой лаборатории сейчас несколько поколений, и свежая карточка важнее старого обзора. Мы держим в тексте только те версии, чью страницу открыли в этот заход. Соседняя модель той же компании, если её карточки не было, в рекомендации не попадает.
Ещё одна путаница приходит из слова «создания». В выдаче рядом стоят текст, картинка, объём и ролик. Лаборатория, которая сильна в длинном коде, не обязана рисовать. Лаборатория, которая выложила генератор картинок, не обязана держать то же окно, что текстовый флагман. Ниже каждая полка подписана отдельно, чтобы запрос из поиска не смешивал полки в одну кнопку.
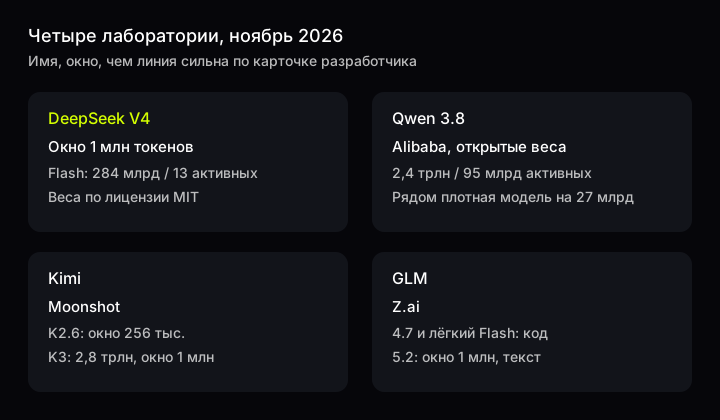
Источник: карточки DeepSeek, Qwen, Kimi и Z.ai, сверено 1 ноября 2026
DeepSeek: миллион токенов и лёгкий Flash
24 апреля 2026 DeepSeek выложила превью четвёртого поколения. В анонсе два размера. Pro: 1,6 триллиона параметров всего, на каждый токен работают 49 миллиардов. Flash: 284 миллиарда всего, активных 13 миллиардов. Окно у обеих 1 миллион токенов. Режим обычного ответа и режим с размышлением. У размышления две силы, high и max. Карточка модели называет те же три положения: без размышления, Think High и Think Max.
Веса, которые лежат в открытом репозитории, идут по лицензии MIT. 17 октября 2026 на Hugging Face появился DeepSeek-V4-Pro-0813. Страница прямо пишет, что это официальный выпуск Pro вместо превью. Для читателя чата важнее другое. Flash остаётся быстрой линией того же поколения, с тем же окном.
Старые имена deepseek-chat и deepseek-reasoner лаборатория отключила после 24 июля 2026, 15:59 UTC. Если где-то в старой инструкции всё ещё стоят эти имена, инструкция про четвёртое поколение уже врёт.
Что проверить на своём тексте. Возьмите договор или длинную статью и попросите:
Выпиши обязательства сторон по срокам. Рядом с каждым пунктом короткая цитата из текста. Если срока в тексте нет, напиши «в тексте нет».
Хороший ответ не дорисовывает дату. Плохой ставит «в течение 30 дней», хотя в файле этого нет. Второй заход, уже с размышлением: попросите найти противоречие между двумя пунктами. Если модель оба пункта пересказывает и противоречие не называет, для сверки документов она в этот раз слабая.
Про DeepSeek до V4, смесь экспертов и январь 2025 года подробнее в отдельной статье. Повторять ту историю здесь незачем.
Qwen: открытая линейка Alibaba
Qwen делает команда Alibaba. К ноябрю 2026 открытая ветка дошла до Qwen 3.8. Как менялись версии от 2.5 до 3.8 и как читать их длинные имена, подробно разобрано в статье про Qwen. Для сравнения с соседями хватит трёх опорных точек.
16 февраля 2026 вышла Qwen 3.5, первый открытый кусок на 397 миллиардов всего и 17 миллиардов активных. Зрение в серии заложено с самого начала обучения, а языков и диалектов лаборатория насчитывает 201. Это больше, чем обещает любая другая линия из этой четвёрки.
12 августа 2026 открыли Qwen3.8-2.4T-A95B, 14 августа рядом положили плотную Qwen3.8-27B. По словам лаборатории, 3.8 впервые выводит в открытый выпуск модель класса Qwen-Max. Глубину рассуждения крутят параметром reasoning_effort. 26 августа появился экспериментальный Qwen3.8-Flash-Next с 6 миллиардами активных параметров на токен: он показывает, куда Alibaba двигает дешёвый прогон.
Чем Qwen отличается от соседей на карте: он единственный выкладывает и маленькие плотные модели, и гигантскую смесь экспертов в одном поколении. Кому нужна модель на своём сервере, тот выбирает размер под железо. Кто работает в чате, тому важнее широта языков.
Практический заход для многоязычного текста:
Переведи абзац на русский. Имена и числа оставь как в источнике. В конце список слов, которые ты счёл терминами и не перевёл.
Смотрите на числа и на имена. Типичная ошибка: модель «улучшает» термин и теряет исходное слово. Вторая ошибка: перевод гладкий, а список терминов пустой, хотя в абзаце была аббревиатура.
Лицензию конкретного файла смотрите на странице весов. В корне репозитория Qwen 3.8 написано, что лицензия лежит рядом с весами, и одной фразой на все размеры её лучше не пересказывать.
Kimi: от K2.6 к K3
Kimi выпускает Moonshot. Вся лестница от K2 до K3.1, Agent Swarm, Slides и Kimi Code описана в статье про Kimi. Здесь только то, что нужно для сравнения.
Kimi K2.6 вышла 20 апреля 2026 и сразу открылась. На входе текст, картинки и видео, есть режим с размышлением и без. Окно в документации платформы указано как 256 тысяч токенов. Это вчетверо короче миллиона у DeepSeek V4 и у K3. Для одного файла часто хватает. Для всего репозитория уже тесно. В этой четвёрке K2.6 единственная прямо обещает разбор видео на входе.
Kimi K3 вышла 16 июля 2026. Лаборатория называет её первой в мире открытой моделью класса 3 триллионов: всего 2,8 триллиона параметров, из 896 экспертов на шаг включаются 16. Окно 1 миллион токенов, своё зрение. Веса обещали выложить к 27 июля 2026. В том же посте Moonshot пишет прямо: по общему уровню K3 всё ещё позади Claude Fable 5 и GPT 5.6 Sol. Обычно карточка звучит бодрее, чем таблица, и такая оговорка от самой лаборатории ценнее любого рейтинга.
K3 в том посте показывают на длинном коде, на разборе документов и на связке «код плюс картинка». Отдельно названы игры, вёрстка и CAD. Это ответ на запрос про трёхмерную китайскую нейросеть, только честный. K3 строит объём кодом и смотрит на кадр. Отдельной кнопки «сделай 3D-файл из ничего» в блоге нет.
Что проверить у Kimi K2.6. Дайте скриншот таблицы и текст вопроса под ним:
По таблице посчитай сумму столбца. Напиши, какие ячейки ты прочитал. Если цифра на картинке неразборчива, так и скажи.
Хороший ответ перечисляет ячейки. Плохой выдаёт круглое число без списка. У Kimi K3 тот же приём на длинной задаче: попросите план из пяти шагов и запретите писать код, пока план не назван. Если код пошёл со второй строки, модель проглотила ограничение.
GLM: код у 4.7 и длинное окно у 5.2
GLM делает Z.ai. На календаре выпусков две точки, которые нужны читателю сейчас.
22 декабря 2025 вышла GLM 4.7. Лаборатория описала её как базу с прибавкой в коде, рассуждении и агентных задачах. В обзоре 4.7 стоят свои цифры. SWE-bench Verified: 73,8%, на 5,8 пункта выше GLM 4.6. SWE-bench Multilingual: 66,7%. Terminal Bench 2.0: 41%. LiveCodeBench V6: 84,9. Рядом в том же обзоре есть GLM 4.7 Flash. Z.ai пишет, что на SWE-bench Verified и на τ²-Bench Flash держит сильный результат среди моделей своего размера, и что вёрстка у него лучше, чем у соседей того же класса. Точное число параметров Flash в этом обзоре не указано, поэтому мы его не ставим.
16 июня 2026 вышла GLM 5.2. В заметке о выпуске: окно 1 миллион токенов без потерь, меньше дрейфа контекста и забытых целей на сложной задаче. Карточка модели уже суше. Вход: текст. Выход: текст. Окно: 1 миллион. Потолок ответа: 128 тысяч токенов. Есть режим размышления, вызов функций и структурированный ответ.
На странице 5.2 лаборатория сравнивает себя с предыдущей 5.1. Terminal-Bench 2.1: 81,0 против 62,0. SWE-bench Pro: 62,1 против 58,4. Там же на Terminal-Bench 2.1 указан Claude Opus 4.8 со счётом 85,0. Разрыв с закрытой моделью на этом тесте небольшой, и это слова самой Z.ai, не наш пересказ чужого рейтинга.
14 января 2026 у той же лаборатории вышел GLM-Image. Это уже генератор картинок: авторегрессионное понимание плюс диффузионный декодер. В заметке сказано, что модель учили на китайских чипах и что текст внутри картинки стал устойчивее. Текстовый GLM 5.2 от этого генератора отделён. Путать их в одном запросе «нарисуй и объясни» не стоит. Сначала текст, потом отдельный заход на картинку.
Проверка для GLM 5.2:
Вот три файла. Опиши, кто кого вызывает. Не предлагай рефакторинг, пока схема не готова. Если файла не хватает, остановись и спроси.
Хороший ответ останавливается на дырке. Плохой достраивает недостающий модуль и делает вид, что он был в репозитории. Для GLM 4.7 Flash хватит короткого куска:
Найди в функции ошибку и поправь только её. Остальной код не переписывай.
Если ответ переписал функцию целиком и сменил имена, лёгкая модель в этот раз не удержала рамку. Повторите с явной фразой «верни diff, не весь файл».
Картинка, объём и ролик
Запросы «китайская нейросеть для создания», «для генерации» и «для 3D» в поиске стоят рядом, а в лабораториях это разные полки.
Создание текста. Любая из пяти карточек. Для длинного документа удобнее окно в миллион: DeepSeek V4 Flash, Kimi K3, GLM 5.2. У Kimi K2.6 окно 256 тысяч. Это всё ещё много для статьи и мало для пачки договоров.
Создание картинки. Из того, что мы открыли у этих лабораторий, отдельный генератор описан у Z.ai: GLM-Image, 14 января 2026. Текстовые карточки GLM 5.2 и DeepSeek V4 картинку на выходе не заявляют. Kimi K2.6 умеет смотреть видео и картинку. Рисовать новый кадр её карточка не обещает.
Объём и 3D. У Kimi K3 в блоге от 16 июля есть связка зрения, кода и CAD. Это путь «опиши деталь, получи сценарий для редактора и код», а не путь «одна кнопка, один файл сетки». Если нужен именно файл для печати, проверяйте, открывается ли результат в вашей программе. Гладкий текст про «модель готова» без файла не считается ответом.
Ролик. В карточках V4, Qwen 3.8, K2.6, K3, GLM 4.7 и GLM 5.2 мы не нашли отдельной модели, которая сдаёт видеоряд как основной продукт. K2.6 принимает видео на вход и может его разобрать. Собрать ролик из текста в этих страницах не обещано. Что умеют видеомодели вообще, в том числе по длине и по кадру, собрано в материале про видео.
Короткий тест на честность генерации:
Опиши кадр: пустая керамическая чашка, скол на ручке, серый стол. Не добавляй надписей. Если не можешь отдать файл картинки, скажи об этом в первой строке.
Модель, которая умеет только текст, должна сказать об этом сразу. Модель, которая рисует, не должна дописывать на чашку слово.
Что спросить и где модель врёт
Один и тот же вопрос четырём лабораториям полезнее, чем четыре разных. Возьмите кусок, который вы сами можете проверить. Чек, расписание, маленькая функция, абзац с датой.
Шаблон, который мы бы оставили в закладке:
Работай только по тексту ниже. Ответ в трёх пунктах. В каждом пункте цитата не длиннее одной строки. Чего в тексте нет, не добавляй.
Дальше ваш фрагмент.
Типичные срывы, которые видно без бенчмарка:
- Цитата чуть длиннее источника, и внутрь вклеено слово, которого не было.
- Модель отвечает на английском на русский вопрос, хотя вы язык задали.
- На просьбу «только план» сразу идёт код.
- Число в ответе красивее, чем в исходной таблице. Округление без пометки.
- На длинном окне модель помнит начало и теряет ограничение из середины. Повторите ограничение последней строкой.
Сравнение имеет смысл на одной задаче. DeepSeek V4 Flash против GLM 4.7 Flash на коротком коде. Kimi K3 против GLM 5.2 на пачке файлов. Kimi K2.6 на картинке таблицы, потому что зрение у неё заявлено прямо. Победителя «вообще» эти пять страниц не дают. Победитель есть у вашего файла.
Если ответ разъехался, не меняйте модель вслепую. Сначала сузьте просьбу. Потом включите размышление, где оно есть: у DeepSeek V4 это Think High или Think Max, у Qwen 3.8 параметр глубины, у GLM 5.2 режим thinking. Потом уже соседняя лаборатория.
Как читать карту, если вы не разработчик
Большая часть людей приходит не за репозиторием. Им нужен ответ на письмо, конспект, перевод инструкции, черновик договора, разбор чужого абзаца. Для этого размера файла хватает любой из пяти карточек. Разница проявляется, когда текст длинный или когда в нём нельзя выдумывать факты.
Возьмите инструкцию к прибору или правила возврата из магазина. Попросите список шагов в том порядке, в каком они написаны у источника. Потом попросите отдельно: чего в тексте нет, но что люди обычно додумывают. Вторая часть важнее первой. Модель, которая честно пишет «этого в правилах нет», полезнее модели, которая добавляет «обычно достаточно трёх дней». Срок, которого не было в бумаге, потом всплывает в споре.
Для учёбы тот же приём. Конспект своими словами полезен. Конспект с выдуманной датой или с чужой формулой вреден. Просите в конце ответ: «какие утверждения я не могу подтвердить цитатой из вашего текста». Если список пустой на сложном абзаце, перечитайте конспект сами. Пустой список часто значит, что модель слишком уверена.
Перевод с китайского или на китайский проверяйте на именах и на числах, даже если язык вы знаете слабо. Имя человека и номер статьи должны совпасть с оригиналом знак в знак. Гладкая русская фраза вокруг них ещё ничего не доказывает. Если модель заменила имя на «автор» или округлила номер, для документов она в этот раз не годится. Повторите запрос с фразой «имена и числа копируй, не пересказывай».
Письмо коллеге можно отдать более лёгкой линии. DeepSeek V4 Flash и GLM 4.7 Flash для короткого черновика уместнее, чем самый большой K3. Тяжёлую модель имеет смысл звать, когда черновик уже есть и надо проверить логику, ссылки и пропущенные оговорки. Иначе вы ждёте дольше там, где хватит быстрой линии.
Отдельный случай: вопрос про медицину, налог или суд. Ни одна карточка из этой карты не заменяет врача, бухгалтера и юриста. Модель может разложить публичный текст по пунктам и показать, где вы сами что-то додумали. Решение по бумаге остаётся за человеком, который отвечает за последствие. Мы это пишем прямо, потому что запросы «китайская нейросеть для создания» иногда маскируют просьбу сочинить официальный документ.
Что общего у четырёх лабораторий и где они расходятся
Общее видно без таблицы рейтингов. Все четыре к ноябрю 2026 говорят про длинную работу, а не только про один удачный ответ. У DeepSeek это миллион токенов и два размера одной архитектуры. У Qwen это открытые веса от маленькой плотной модели до смеси на триллионы и отдельный рычаг глубины рассуждения. У Moonshot это ступени K2, K2.6 и K3 плюс схема параллельных помощников. У Z.ai это скачок от 4.7 к 5.2 и отдельный генератор картинок, который не смешан с текстовым флагманом.
Расходятся они в том, что готовы обещать на выходе. DeepSeek в карточке V4 говорит о тексте и о трёх режимах размышления. Qwen в описании 3.5 прямо ставит зрение в основание серии, а 3.8 добавляет удержание прошлого рассуждения. Kimi K2.6 принимает картинку и видео и при этом держит окно короче, чем K3. K3 добавляет масштаб и связку кода с кадром, включая CAD, и тут же оговаривает отставание от двух закрытых американских моделей. GLM 5.2 в карточке честно ограничен текстом на входе и текстом на выходе, зато окно и потолок ответа названы числами, а не прилагательными. GLM-Image живёт отдельной строкой календаря.
Из этого следует простой порядок, и его хватает на бытовую задачу. Сначала решите, что должно появиться в ответе: абзац, правка кода, разбор картинки или файл изображения. Потом отсеките модели, которые этот выход в карточке не обещают. Потом смотрите окно. Потом уже сравнивайте две оставшиеся на своём фрагменте, одним и тем же текстом просьбы. Если после этого обе ошибаются одинаково, дело в просьбе. Если ошибается одна, оставляйте вторую на этот тип файлов и не устраивайте турнир на каждый чих.
Смешивать в одном абзаце «китайские нейросети» и «любая открытая модель мира» тоже не стоит. Американские, европейские и российские линии в эту карту не входят, их место показано на общей карте нейросетей. Они решают те же бытовые задачи и иногда выигрывают ваш файл. Статья про то, что стоит за поисковой фразой про Китай, а не про чемпионат всех лабораторий сразу. Когда фраза в поиске узкая, ответ тоже должен быть узким. Иначе читатель уходит с списком из двадцати имён и без одного рабочего шага.
Вопросы и ответы
Какие китайские нейросети имеют смысл в ноябре 2026?
Четыре лаборатории закрывают разные полки. DeepSeek V4 для длинного текста и открытых весов по MIT. Qwen 3.8 у Alibaba для открытых моделей разного размера и для 201 языка в поколении 3.5. Kimi у Moonshot: K2.6 с окном 256 тысяч и зрением, K3 на 2,8 триллиона с окном 1 миллион. GLM у Z.ai: 4.7 и лёгкий Flash для кода, 5.2 для длинной инженерной задачи. Пять конкретных имён из этого списка открываются в чате GPThub.
Китайская нейросеть для создания: текст, картинка или 3D?
Для текста берите окно под размер файла. Миллион токенов есть у DeepSeek V4, Kimi K3 и GLM 5.2. Для картинки у Z.ai отдельно описан GLM-Image от 14 января 2026. Для объёма смотрите блог Kimi K3: там CAD и связка кода со зрением, без обещания готового файла сетки одной кнопкой.
Чем китайская модель нейросети с открытыми весами отличается от чата?
Открытые веса можно скачать. У DeepSeek V4 в репозитории лицензия MIT. У Qwen 3.8 файлы лежат на Hugging Face, лицензию читают на странице конкретного размера. У Kimi K3 веса обещали к 27 июля 2026. Чат с той же фамилией удобнее, когда не хочется поднимать свою машину. Качество ответа всё равно проверяют цитатой и своим файлом, а не названием лицензии.
Есть ли китайская нейросеть для генерации видео?
В карточках DeepSeek V4, Qwen 3.8, Kimi K2.6, Kimi K3, GLM 4.7 и GLM 5.2 отдельного генератора ролика мы не увидели. Kimi K2.6 принимает видео на вход. Сборку ролика из текста эти страницы не описывают. Обзор видеомоделей лежит отдельно: нейросети для видео.
Что такое китайская AI-нейросеть, если имя в поиске написано латиницей?
Так ищут ту же четвёрку. DeepSeek, Qwen, Kimi, GLM. Латиница в запросе не добавляет пятой лаборатории. Смотрите дату карточки. K2 сентября 2025 и K3 июля 2026 это разные модели одной компании. GLM 4.7 декабря 2025 и GLM 5.2 июня 2026 тоже.
Какая китайская модель нейросети для длинного кода?
По текстам лабораторий на длинный прогон заточены GLM 5.2 и Kimi K3. У GLM 5.2 окно 1 миллион, потолок ответа 128 тысяч, на Terminal-Bench 2.1 лаборатория ставит себе 81,0. У K3 окно тоже 1 миллион, а длинный код Moonshot называет первым в списке её задач. Короткий патч можно отдать GLM 4.7 Flash или Kimi K2.6 и сравнить, кто меньше переписывает чужой код.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
Ещё по теме
Источники
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.