
Карта нейросетей 2026: кто делает модели и какая нейросеть лучше под задачу
Обозреватель: модели и релизы
Содержание
Осенью 2026 года сильные модели выпускают как минимум десять компаний, и почти у каждой не одна нейросеть, а целая линейка от быстрой до самой тщательной. Поэтому вопрос «какая нейросеть лучше» без задачи ответа не имеет. Собрали карту на 1 ноября 2026: кто делает модели, чем линейки отличаются и что брать для учёбы, текста, кода, картинок и видео.
Почему на вопрос «какая нейросеть лучше» нет одного ответа
Слово «нейросеть» в 2026 году значит слишком много. Чат-бот, который пишет курсовую, генератор картинок и модель, которая сама чинит код по нескольку часов, устроены по-разному и учились на разном. Сравнивать их одной оценкой примерно как выбирать лучший транспорт, не сказав, куда едем.
Вторая причина: сами компании делят модели на ступени. У Anthropic их сейчас четыре, у OpenAI три, у DeepSeek две. Младшая ступень отвечает за секунды и стоит в разы дешевле. Старшая думает дольше и решает задачи, на которых младшая сыплется.
Третья причина в таблицах. Каждая компания показывает тот набор тестов, где она выглядит сильнее. Google пишет про первое место в Vals Index, xAI выбирает CursorBench, Mistral — кибербезопасность. Цифры честные, но подобраны. Независимые замеры есть, и они двигаются каждую неделю.
Отсюда простое правило на весь текст: сначала задача, потом ступень, и только потом компания. Мы так и разложили карту.
Окно, ступень и рассуждение: три слова, которые объясняют разницу
В описаниях моделей постоянно мелькают три понятия. Без них таблицы разработчиков читаются плохо, поэтому коротко.
Окно контекста — сколько текста модель видит за раз: ваш вопрос, всю переписку, приложенные файлы и собственный ответ. Миллион токенов — это несколько толстых книг. Для обычного чата столько не нужно, но для разбора диплома целиком или большого проекта в коде окно решает всё. Если текст не влез, модель начинает забывать начало разговора.
Ступень — место модели в линейке своей компании. Младшая отвечает быстрее и дешевле, старшая медленнее и точнее. У Anthropic это видно прямо по подписям в документации: Fable помечена как медленная, Opus как умеренная, Sonnet как быстрая, Haiku как самая быстрая.
Рассуждение — режим, в котором модель перед ответом пишет себе черновик. Иногда он скрыт, иногда его показывают. На простом вопросе рассуждение только тратит время. На задаче по физике или на поиске ошибки в коде оно часто отделяет верный ответ от уверенной чепухи.
У всех компаний из большой четвёрки окно теперь около миллиона токенов, так что по этому параметру они почти сравнялись. Разница осталась в ступенях и в том, насколько хорошо модель рассуждает. Это и стоит сравнивать в первую очередь.
Как читать цифры из таблиц разработчиков
Каждый анонс модели сопровождает таблица, где новинка стоит рядом с конкурентами. Верить ей можно, но с поправками.
Первая поправка: набор тестов выбирает сам разработчик. xAI сравнивает Grok 4.7 в CursorBench и Terminal-Bench, Google для Gemini 4 Argon приводит Vals Index и ERQA, Mistral для своей модели берёт кибербезопасность. Это разные экзамены, и сводить их в одну колонку нельзя.
Вторая поправка: даты. Модель, которая в июне была лучшей среди открытых, к ноябрю могла опуститься на несколько мест. GLM-5.2 на момент выхода набирала 51 балл в индексе Artificial Analysis и была первой среди открытых моделей. С тех пор вышли Kimi K3, Muse Spark Open и Mistral Large 4.
Третья поправка: проценты в тестах на код почти ничего не говорят о том, как модель напишет вам письмо или перескажет главу учебника. Это другие умения, и их проверяют другими тестами.
Есть и независимые замеры: Artificial Analysis, Vals, LMArena, где люди вслепую выбирают лучший из двух ответов. Им можно доверять больше, но и они меряют своё. Самый надёжный тест по-прежнему ваш собственный: один вопрос, две модели, сравнить глазами.
Как нейросети справляются с русским языком
Для читателя из России это отдельный вопрос, и тут карта выглядит иначе, чем в американских рейтингах.
Все флагманы из большой четвёрки свободно пишут по-русски. Разница видна в мелочах: падежи в длинных фразах, канцелярит, кальки с английского вроде «сделать смысл». Чем старше ступень, тем меньше таких огрехов. Младшие модели иногда переходят на английский посреди ответа, особенно если в вопросе много терминов латиницей.
Китайские модели учились на огромном объёме многоязычных данных, и русский у них тоже на хорошем уровне. Mistral отдельно пишет, что в данных Large 4 больше 160 языков. Российские Alice AI и ГигаЧат лучше знают местные реалии: законы, названия ведомств, школьную программу.
Практический вывод простой. Для текста, который пойдёт людям, берите рабочую или старшую ступень и перечитывайте результат. Для черновика и мозгового штурма хватит быстрой модели любой компании.
Карта: кто делает модели в 2026 году
Если убрать подробности, рынок делится на пять групп. Американские закрытые флагманы, китайские лаборатории с открытыми весами, европейская Mistral, Meta со своей новой линейкой и российские модели. Отдельно стоят модели для картинок и видео.
| Группа | Компании | Главные модели осенью 2026 | Веса открыты |
|---|---|---|---|
| Закрытые флагманы США | OpenAI, Anthropic, Google, xAI | GPT-6, Claude 5.5, Gemini 4 Argon, Grok 4.7 | нет |
| Китайские лаборатории | DeepSeek, Alibaba, Moonshot, Zhipu | DeepSeek V4, Qwen 3.8, Kimi K3, GLM-5.2 | да, у большинства |
| Европа | Mistral | Mistral Large 4 | обещаны |
| Meta | Meta Superintelligence Labs | Muse Spark, Muse Spark Open | у Muse Spark Open |
| Россия | Яндекс, Сбер | Alice AI, ГигаЧат | частично |
| Картинки и видео | Google и другие | Nano Banana 2.1, Veo 3.1 | нет |
«Открытые веса» значит, что файлы модели можно скачать и запустить на своём железе. Для обычного человека это почти ничего не меняет: модель в триллион параметров на ноутбуке не запустишь. Зато открытость сильно двигает рынок. Чужие компании дообучают такие модели, и цены на ответы падают.
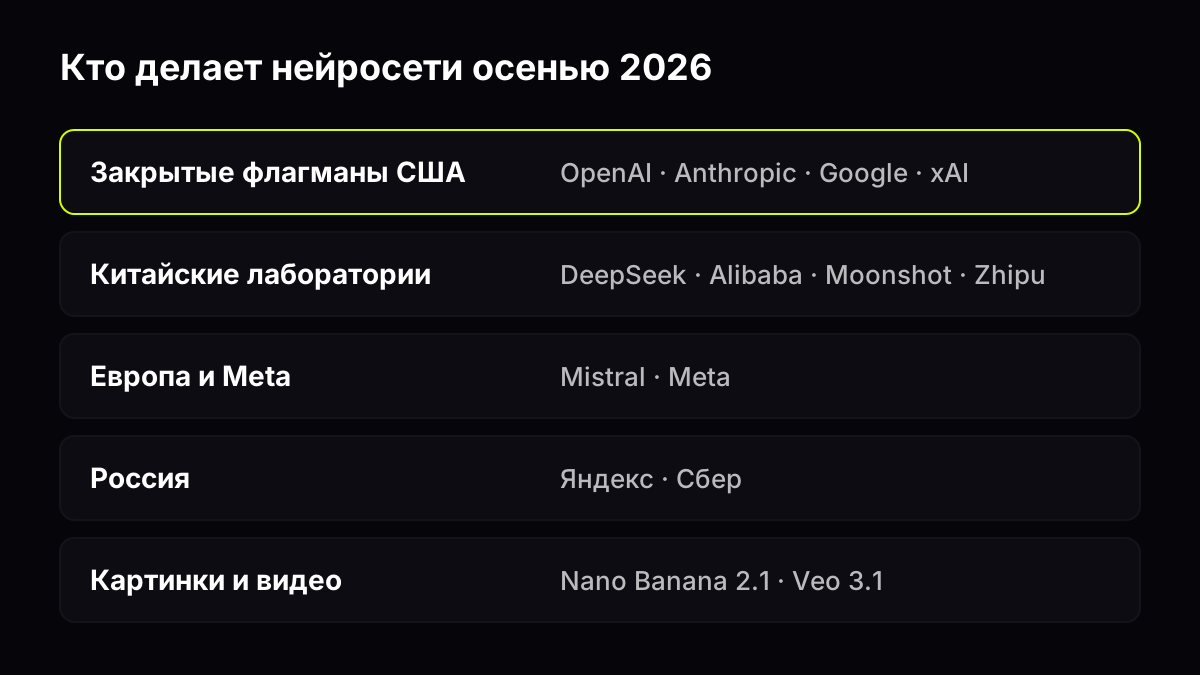
Схема GPThub, по страницам разработчиков на 1 ноября 2026
OpenAI: три ступени GPT-6
OpenAI выпустила GPT-6 Astra 3 сентября 2026. Через три недели, 22 сентября, рядом встали GPT-6 Sol и GPT-6 Luna, а 29 сентября вышла GPT-6.1 Sol. В итоге линейка выглядит так:
- GPT-6 Astra — самая сильная модель компании для самой тяжёлой работы: рассуждения, код, работа с компьютером, исследования, документы.
- GPT-6 Sol и GPT-6.1 Sol — модели под сложный код и задачи, где нейросеть сама выполняет цепочку действий.
- GPT-6 Luna — самая экономная, под простые и массовые задачи.
Окно у всех трёх одинаковое: 1 050 000 токенов. Токен — кусочек слова, в среднем на русском это пара-тройка букв. Ответ ограничен 128 тысячами токенов. На вход все три принимают текст и картинки, отвечают только текстом. У Astra есть шкала тщательности от низкой до максимальной: чем выше, тем дольше модель думает.
Знания у Astra заканчиваются 30 апреля 2026, у Sol — 20 апреля. Про то, что случилось позже, модель без поиска не знает.
Кому что: Luna для быстрых вопросов и черновиков, Sol для кода, Astra для задач, где ошибка дорого стоит. Подробно о флагмане мы писали в разборе GPT-6 Astra, а рабочая карточка GPT-6.1 Sol лежит в каталоге.
Anthropic: Claude от Haiku до Fable
У Anthropic самая длинная лестница. В документации на 1 ноября четыре текущие модели, от медленной к быстрой: Claude Fable 5.1, Claude Opus 5.5, Claude Sonnet 5.5 и Claude Haiku 5.5. В меню сайта компании есть ещё Mythos, это отдельная история с ограниченным доступом.
Opus 5.5 вышла 22 сентября 2026. Anthropic описывает её как модель для долгой работы с кодом и документами и пишет, что на большинстве задач она держит уровень Fable 5.1, а обходится на 40% дешевле предыдущей Opus 5. Sonnet 5.5 — быстрая рабочая модель на каждый день. Haiku 5.5 — самая быстрая.
Общее у всей линейки:
- окно 1 миллион токенов;
- ответ до 128 тысяч токенов;
- на вход текст и картинки, на выход текст;
- знания до июня 2026 года.
Claude обычно выбирают за длинные тексты и код. Модель аккуратно держит структуру большого документа и редко теряет нить в длинной переписке. Картинки Claude не рисует вообще, это чисто текстовая линейка.
О старшей модели есть отдельный разбор Claude Opus 5.5, а предыдущая рабочая версия описана в карточке Claude Sonnet 5. Про всю линейку подробнее в статье что такое Claude.
Google: Gemini 4 Argon, Nano Banana и Veo
Google — единственная компания из большой четвёрки, у которой сильные модели есть во всех трёх видах: текст, картинки и видео.
Gemini 4 Argon открыли широко 13 октября 2026. В посте Google модель названа новым флагманом для «глубокой работы» над сложными задачами: код, финансы, право, кибербезопасность, наука. Окно — 1 миллион токенов на вход и ответ вместе. Google приводит первое место в Vals Index и 87% в тесте ERQA, который проверяет пространственное мышление для роботов. Это цифры самой компании.
28 октября Google анонсировала следующую модель линейки, Gemini 4 Carbon. Она рассчитана на долгую инженерную работу и киберзащиту. Пока её получают специалисты по безопасности и партнёры, широкого доступа ещё нет. Подробно — в разборе Gemini 4 Carbon.
Рядом остаётся быстрая ступень — Gemini 3.8 Flash. Её берут, когда нужен быстрый ответ, а не самая глубокая мысль. Карточка Gemini 3.8 Flash есть в каталоге. Чем приложение отличается от моделей, объясняет статья что такое Gemini.
Для картинок у Google своя модель — Nano Banana 2.1, она вышла 6 октября 2026. Внутри неё Gemini 3.6 Flash, поэтому модель понимает длинное описание и умеет править готовую картинку, а не только рисовать с нуля. Отдельно Google хвалит читаемый текст на постерах и схемах, в том числе на нескольких языках.
Для видео — Veo 3.1. Она делает ролик из текста или из картинки и сама генерирует звук: шумы, фон и реплики. Готовое видео бывает в 1080p и в 4K. Про разницу между генерацией ролика и монтажом мы подробно писали в статье о нейросетях для видео.
xAI: Grok 4.7
Grok 4.7 вышла 21 сентября 2026. xAI называет её самой мощной своей моделью для кода и работы с документами. Под ней новая базовая модель, крупнее, чем у Grok 4.6, и более длинное дообучение на трудных задачах, многие из которых занимают часы.
xAI честно показывает, где модель проигрывает. В тесте CursorBench 4.0 у Grok 4.7 46,3%, у Claude Fable 5.1 — 51,8%. В Terminal-Bench 4.0 разрыв больше: 37,6% против 57,9%. Ставка xAI в другом месте: модель заметно дешевле флагманов конкурентов и быстрее их.
Для обычного человека Grok — это быстрые и бодрые ответы, длинное окно и неплохой код. Рабочая версия Grok 4.5 есть в каталоге, о Grok 4.7 у нас есть отдельный разбор, а с чего начать знакомство, подскажет статья что такое Grok.
Китайские лаборатории: DeepSeek, Qwen, Kimi и GLM
Китайская часть карты устроена иначе. Почти все модели отсюда выходят с открытыми весами, и именно они чаще всего стоят у дешёвых ступеней в чатах по всему миру. Подробный обзор лабораторий — в статье китайские нейросети.
DeepSeek. 24 апреля 2026 компания выложила DeepSeek V4 в двух вариантах. V4-Pro — 1,6 трлн параметров, из которых в каждом ответе работают 49 млрд. V4-Flash — 284 млрд и 13 млрд активных. Окно 1 миллион токенов, у обеих моделей есть режим с рассуждением и без. Про историю компании у нас есть статья что такое DeepSeek, а быстрая модель живёт в карточке DeepSeek V4 Flash.
Alibaba (Qwen). Самая плодовитая лаборатория года: Qwen 3.5, 3.6, 3.7 и 3.8 вышли с февраля по сентябрь. Флагман Qwen 3.8-Max появился в облаке 3 августа 2026: 2,4 трлн параметров, около 95 млрд активных. Большая часть открытых моделей Qwen идёт под свободной лицензией Apache 2.0. Как устроено семейство, рассказано в статье что такое Qwen.
Moonshot (Kimi). Kimi K3 вышла 16 июля 2026. Fortune называет её крупнейшей открытой моделью на тот момент, 2,7 трлн параметров. Moonshot делает упор на долгую работу с большими проектами в коде, подробнее в статье что такое Kimi. Карточка Kimi K3 есть в каталоге.
Zhipu (GLM). GLM-5.2 вышла в июне 2026 с окном в 1 миллион токенов и лицензией MIT, то есть веса можно брать почти без ограничений. Модель учили на длинных задачах, которые идут часами и тысячами шагов. В индексе Artificial Analysis на момент выхода у неё был 51 балл, лучший результат среди открытых моделей. Подробности — в карточке GLM-5.2.
Что объединяет эту группу: модели почти не уступают закрытым флагманам в коде и рассуждениях, но заметно отстают в самых трудных экзаменах вроде Humanity's Last Exam. Для учёбы и повседневного текста этой разницы почти не видно.
Что открытые веса меняют для обычного человека
Напрямую почти ничего. Скачать DeepSeek V4-Pro можно, а запустить нельзя: модели в 1,6 трлн параметров нужна стойка серверов, домашний компьютер её не потянет. Даже V4-Flash с её 284 млрд параметров требует железа, которого у обычного человека нет.
Косвенно меняет многое. Открытую модель могут запустить десятки компаний по всему миру, и они соревнуются ценой. Поэтому быстрые ступени в чатах стали такими дешёвыми, а иногда и бесплатными. Американским лабораториям приходится отвечать: у Anthropic Opus 5.5 обходится на 40% дешевле предыдущей Opus, у xAI вся ставка Grok 4.7 сделана на цену и скорость.
Есть и обратная сторона. Открытая модель не всегда открыта для всех одинаково. У открытой версии Qwen 3.8-Max отдельная лицензия: крупным компаниям для коммерческого использования нужен договор с Alibaba. Flash-Next выходит под третьей лицензией, Qwen Community 1.0. У GLM-5.2 лицензия MIT, у большинства Qwen — Apache 2.0, это самые свободные варианты. Для читателя, который просто задаёт вопросы в чате, лицензия роли не играет. Зато она объясняет, почему одни модели появляются везде, а другие только у своих разработчиков.
Ещё одно следствие открытости — скорость, с которой догоняют лидеров. В январе 2025 года выход DeepSeek R1 обрушил акции Nvidia на 18% за день. Сейчас такие релизы выходят раз в месяц-два, и рынок к ним привык. Разрыв между лучшей открытой моделью и лучшей закрытой измеряется уже несколькими пунктами в тестах.
Европа и Meta: Mistral Large 4 и линейка Muse
Mistral. Французская компания показала Mistral Large 4 6 октября 2026, пока в виде публичного предпросмотра. 1 трлн параметров, 52 млрд активных, модель сразу понимает и текст, и картинки. Обучали её с нуля на 3 800 ускорителях NVIDIA Grace Blackwell в собственных дата-центрах в Европе. В данных больше 160 языков. Веса Mistral обещала выложить позже. Сильная сторона, по таблицам самой компании, — кибербезопасность.
Meta. Llama после четвёртой версии фактически сменилась новой линейкой Muse. Первая модель, Muse Spark, вышла в апреле 2026. 15 октября 2026 Meta выложила Muse Spark Open с открытыми весами: 816 млрд параметров и 42 млрд активных. Для картинок и видео у Meta с июля есть отдельные Muse Image и Muse Video.
Российские модели: Alice AI и ГигаЧат
У Яндекса с октября 2025 года вместо YandexGPT семейство Alice AI. В нём три модели: языковая, модель, которая понимает картинки, и Alice AI Art для генерации изображений. В сентябре 2026 Яндекс открыл две свои модели под лицензией Apache 2.0, одна из них работает в поиске.
У Сбера своя линейка ГигаЧат. Версии и даты в открытых источниках расходятся, поэтому цифры по ней мы здесь не приводим, а возможности сервиса разобраны в статье что такое ГигаЧат. Все отечественные семейства собраны в обзоре русские нейросети.
Плюс российских моделей простой: они хорошо знают местные реалии, законы и названия. Минус тоже понятен: по большим международным тестам они пока ниже флагманов из США и Китая. Для текста на русском разница часто меньше, чем ожидаешь.
Чем отличаются нейросети: текст, картинки и видео
Вопрос «виды нейросетей» обычно про то, что модель выдаёт на выходе. Тут три большие группы:
- Языковые модели. На входе текст, иногда картинки и документы. На выходе текст: ответ, конспект, код, перевод. Сюда относятся GPT, Claude, Gemini, Grok, DeepSeek, Qwen и остальные чат-модели.
- Модели для картинок. На входе описание и, если нужно, исходное фото. На выходе изображение. Nano Banana 2.1, Alice AI Art, Muse Image.
- Модели для видео. На входе текст или картинка, на выходе короткий ролик, иногда сразу со звуком. Veo 3.1, Muse Video.
Путаница случается, когда языковую модель просят нарисовать картинку. Чат может передать запрос модели для картинок, но сам рисовать не умеет: у GPT-6, Claude и Grok на выходе только текст. Если картинка получилась, значит, за кадром отработала вторая модель.
Внутри языковых моделей ещё одна развилка — рассуждение. Модель с рассуждением сначала пишет черновик мысли, потом ответ. Это дольше, зато сложная задача по математике или коду решается заметно чаще. У Claude Opus 5.5 рассуждение включено всегда, у DeepSeek V4 его можно выключить.
Как работать с картинками на практике, разобрано в гайде работа с картинками.
Какую нейросеть выбрать под задачу
Мы не будем называть одну лучшую. Вместо этого — какая ступень и какой тип модели подходит к частым задачам. Все модели из таблицы уже доступны в чате GPThub, переключаться можно прямо в одном разговоре.
| Задача | Что брать | Почему |
|---|---|---|
| Быстрый вопрос, перевод, письмо | быстрая ступень: GPT-6 Luna, Gemini 3.8 Flash, DeepSeek V4 Flash, Claude Haiku 5.5 | ответ за секунды, качества хватает |
| Курсовая, конспект, длинный документ | рабочая ступень: Claude Sonnet 5.5, GPT-6.1 Sol, Gemini 4 Argon | держат структуру и длинное окно |
| Код, большой проект | Claude Opus 5.5, GPT-6.1 Sol, Grok 4.7, GLM-5.2, Kimi K3 | учились на долгих задачах с кодом |
| Самая трудная задача, где ошибка дорогая | GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon | самая высокая тщательность |
| Картинка по описанию, правка фото | Nano Banana 2.1 | рисует и правит, держит текст на картинке |
| Короткий ролик | Veo 3.1 | видео со звуком из текста или картинки |
Пара советов сверху. Начинайте с быстрой модели и поднимайтесь на ступень выше, только если ответ не устроил. Так меньше ждать и меньше тратить. И сравнивайте на своей задаче: один и тот же вопрос в двух моделях за минуту скажет больше, чем любая таблица. Как это делать без лишней возни, мы разобрали в гайде сравнение моделей на практике, а общий порядок выбора — в гайде как выбрать модель.
Для студента схема ещё проще. Конспект и пересказ — быстрая модель. Разбор задачи с решением — модель с рассуждением. Текст работы целиком нейросети не отдавайте: преподаватели такое замечают, а модель может уверенно выдумать источник.
Что изменится в ближайшие месяцы
Тут разделим то, что уже вышло, и то, что обещают.
Уже вышло: всё, что есть в таблицах выше. Последний крупный анонс октября — Gemini 4 Carbon 28-го, но и она пока у узкого круга.
Обещают:
- Qwen 4. Alibaba сказала, что модель в обучении, ещё 22 сентября 2026. На конференции 29 октября на слайде стояли Qwen4-Max, Qwen4-Flash, Qwen4-Plus и Qwen4-27B с пометкой «скоро». Даты от самой Alibaba нет.
- Веса Mistral Large 4. Mistral обещала их выложить. Если это случится, в Европе появится своя открытая модель такого размера.
Что из этого нужно обычному человеку прямо сейчас? Почти ничего. Модели, которые уже вышли, закрывают и учёбу, и тексты, и код. Ждать Qwen 4, чтобы написать конспект или разобрать задачу, смысла нет. Новая версия нужна, если вы упёрлись в потолок текущей: модель путается в длинном проекте, ошибается в одном и том же месте или слишком долго думает.
Скорее всего, к концу года карта сдвинется ещё раз: такие перестановки у лидеров сейчас случаются каждые месяц-два. Поэтому привязываться к одной компании нет смысла. Привязывайтесь к задаче, а модель подберёте заново, когда выйдет следующая версия.
Вопросы и ответы
Какая нейросеть лучше всего в 2026 году?
Одной лучшей нет. Самую трудную работу обычно отдают GPT-6 Astra, Claude Opus 5.5 или Gemini 4 Argon. Для быстрых вопросов хватает младших ступеней: GPT-6 Luna, Gemini 3.8 Flash, DeepSeek V4 Flash. Выбирайте по задаче.
Чем отличаются нейросети друг от друга?
Тем, что выдают на выходе (текст, картинку или видео), размером и ступенью внутри линейки, умением рассуждать перед ответом и тем, на каких задачах их учили. Языковая модель картинку сама не нарисует.
Какая модель нейросети лучше для учёбы?
Для конспектов и пересказа хватает быстрой модели. Для задач с решением лучше модель с рассуждением, например Claude Sonnet 5.5 или GPT-6.1 Sol. Подробнее — в гайде нейросеть для учёбы.
Какие бывают виды нейросетей?
Три главные группы: языковые модели для текста и кода, модели для картинок и модели для видео. Внутри языковых есть модели с рассуждением и без него.
Чем китайские нейросети отличаются от американских?
Китайские DeepSeek, Qwen, Kimi и GLM чаще выходят с открытыми весами и обычно дешевле. В коде и рассуждениях они близки к закрытым флагманам из США, но на самых трудных экзаменах пока отстают.
Связанные модели

GPT-6.1 Sol
GPT-6.1 Sol · картинки · окно ~1M · почти Astra

Claude Sonnet 5
Sonnet 5 · картинки · 1M · агентный код · Про

Gemini 3.8 Flash
Картинки, звук и видео · окно 1M · ответ текстом

DeepSeek V4 Flash
MoE 284B·13B активных · 1M контекст · скорость

Kimi K3
Kimi K3 · 2.8T MoE · 1M · картинки

GLM 5.2
MoE ~744B·40B · 1M контекст · длинный код
Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
Ещё по теме
Источники
- Google: Gemini 4 Carbon, 28 октября 2026
- OpenAI: документация GPT-6 Astra
- OpenAI: документация GPT-6 Sol
- OpenAI: документация GPT-6 Luna
- Anthropic: документация Claude Opus 5.5, 22 сентября 2026
- Google: Gemini 4 Argon, 13 октября 2026
- Google DeepMind: карточка Nano Banana 2.1, 6 октября 2026
- Google DeepMind: Veo
- xAI: Grok 4.7, 21 сентября 2026
- DeepSeek: анонс V4, 24 апреля 2026
- Mistral: Mistral Large 4, 6 октября 2026
- Fortune, 16 июля 2026: Kimi K3
- The Decoder, 17 июня 2026: GLM-5.2
- Wikipedia: Qwen
- Wikipedia: Meta AI
- Wikipedia: Alice AI
Об авторе
Обозреватель: модели и релизы
Пишет о новых моделях ИИ и крупных релизах: что вышло и кому это пригодится.
Сравнить модели в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.