
Машинное обучение и нейросеть: в чём разница

Обозреватель: как устроен ИИ
Содержание
В декабре 1943 года Warren McCulloch и Walter Pitts опубликовали в Bulletin of Mathematical Biophysics статью с длинным названием про «логическое исчисление идей, присущих нервной деятельности». В ней нервную систему описали как сеть простых элементов, которые либо срабатывают, либо молчат, и показали, что из таких элементов можно собрать логические функции. Так появилась математическая нейросеть, задолго до привычных чатов. Через шестнадцать лет Arthur Samuel ввёл термин «машинное обучение» и доказал идею на шашках: он поставил цель научить компьютер играть лучше, чем человек, написавший программу. Когда сегодня спрашивают, что такое машинное обучение, эти две линии обычно смешивают. Нейросеть описывает форму модели. Машинное обучение описывает правило, по которому любая модель, в том числе не нейронная, улучшается на опыте.
Что такое машинное обучение
IBM в обзоре для широкой аудитории формулирует так: машинное обучение — часть искусственного интеллекта, где алгоритмы учатся закономерностям обучающих данных и переносят их на новые данные без жёстко прописанных правил для каждого случая. Wikipedia добавляет акцент на статистические алгоритмы, которые обобщают то, чего не видели в таблице буквально.
Самое удобное рабочее определение даёт Tom Mitchell в учебнике 1997 года. Программа учится на опыте E относительно класса задач T и меры качества P, если с ростом E показатель P на задачах из T улучшается. Для шашек Samuel опыт — партии, задача — выиграть, мера — доля побед. Для фильтра спама опыт — письма с пометками «спам» или «не спам», задача — угадать метку, мера — доля верных ответов на новых письмах.
Три термина, без которых дальше будет путаница. Задача — то, что система должна делать: распознать цифру на фото, предсказать температуру, ответить на вопрос человека. Мера качества — число, по которому видно, стало ли лучше: ошибка, доля верных ответов, выигранные партии. Опыт — всё, из чего программа черпает улучшение: таблица, диалог, симуляция, оценки людей.
Часто машинное обучение описывают как «компьютер учится сам, без программиста». Формулировка красивая и неточная. Программист задаёт архитектуру, функцию ошибки, источник данных и остановку обучения. Машина подстраивает миллионы чисел, но рамку ей всё равно задают люди. Samuel хотел подстроить стратегию игры, не переписывая весь код шашек вручную. В Wikipedia к истокам машинного обучения относят и книгу Donald Hebb 1949 года The Organization of Behavior: идея, что связи между нервными клетками меняют силу от опыта, позже легла в основу многих алгоритмов, хотя биологическая метафора не делает каждый чат копией мозга.
Samuel на ограниченной памяти 1950-х хранил оценку позиции и отсечение слабых веток поиска вместо полного перебора до конца партии. Значит, обучение может улучшать и классическую программу, если мера качества и опыт заданы честно, без гигантской нейросети.
Чем машинное обучение отличается от нейросети
В разговоре «нейросеть» и «машинное обучение» часто ставят знак равенства, потому что ChatGPT и рисующие модели у всех на слуху. Нейросеть описывает форму модели. Машинное обучение описывает способ её получить и улучшать.
Google в глоссарии машинного обучения называет нейросеть моделью хотя бы с одним скрытым слоем. Если скрытых слоёв больше одного, это глубокая нейросеть, отсюда «глубокое обучение». Узлы связаны со следующим слоем, каждый выполняет нелинейное преобразование. Компьютерные сети там же называют искусственными, чтобы не путать с биологическим мозгом.
IBM описывает глубокое обучение как подмножество машинного обучения на больших искусственных нейросетях, которое с 2000–2010-х годов стало главным инструментом во многих задачах ИИ. Классическое машинное обучение спокойно живёт без нейронов: деревья решений, метод ближайших соседей, линейная регрессия. Банк может оценивать риск по таблице признаков без единого слоя «нейронов», и это останется машинным обучением.
Правильная картинка — вложенные множества. Снаружи искусственный интеллект. Внутри машинное обучение. Ещё глубже глубокое обучение на нейросетях. В центре конкретная архитектура: свёрточная сеть для фото, трансформер для текста. Рядом, всё ещё внутри машинного обучения, лежат алгоритмы без нейросетей.
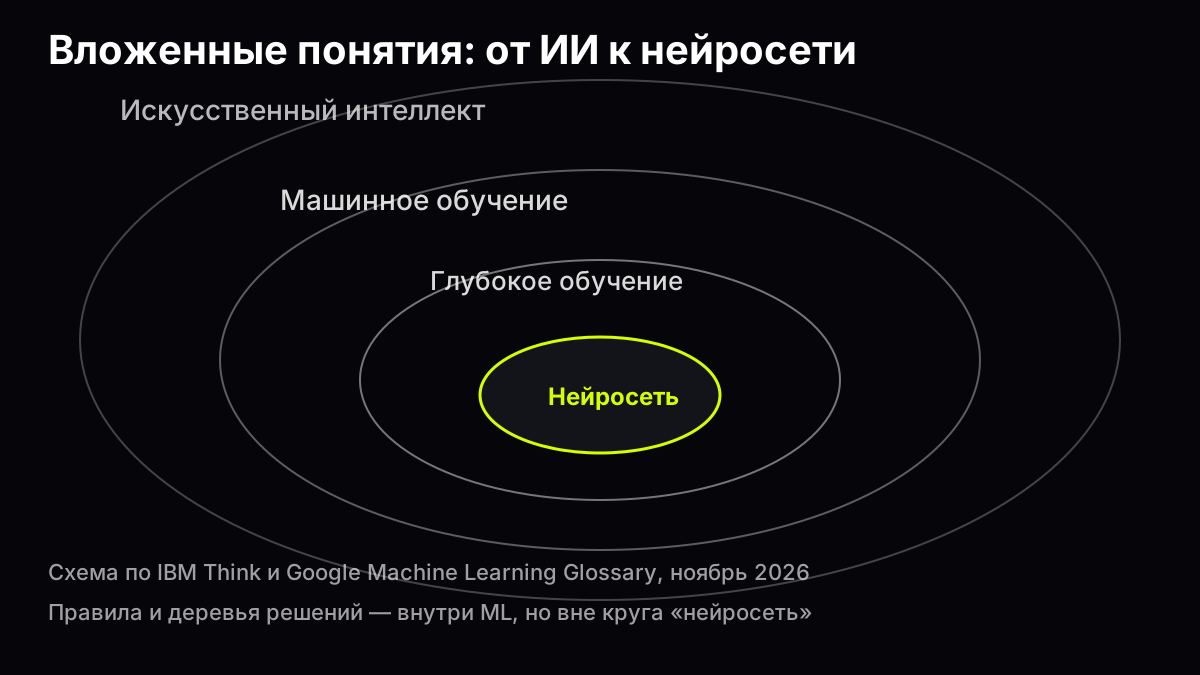
Схема по IBM Think и Google Machine Learning Glossary, иллюстрация GPThub
McCulloch и Pitts показали, что нейросеть может считать логику. Samuel показал, что программа может улучшаться от сыгранных партий, не будучи многослойной сетью в современном смысле. Обе идеи встретились позже: когда памяти и данных стало достаточно, обучение на миллиардах параметров сделало нейросети главным инструментом, хотя и не единственным.
Премия Turing 2018 года досталась Yoshua Bengio, Geoffrey Hinton и Yann LeCun за прорывы, которые сделали глубокие нейросети важнейшей частью вычислений. Награду дали за нейросети, к появлению термина «машинное обучение» она отношения не имеет.
Подробнее про устройство одного узла и слоёв — в материале «Что такое нейросеть». Про текстовые модели, которые пишут ответы абзацами, — в «Что такое LLM».
Что такое данные в машинном обучении
Данные — сырьё, из которого модель извлекает закономерности. При обучении с учителем Google описывает пример как одну строку таблицы: набор признаков и, часто, метка, то есть правильный ответ.
Обучающая выборка — та часть данных, на которой модель настраивает параметры. Google в глоссарии добавляет, что набор обычно делят ещё на проверочную и тестовую части, и один и тот же пример не должен одновременно лежать в обучении и в тесте, иначе оценка качества будет лживой.
Признаки зависят от задачи. Для прогноза дождя в вводном курсе Google по машинному обучению перечисляют широту, долготу, температуру, влажность, облачность, ветер, давление; метка — количество осадков. Для распознавания рукописной цифры признаками будут яркости пикселей, меткой — цифра 0–9. Для чата признаками служат токены текста, меткой на этапе обучения — следующий токен или оценка «хороший / плохой ответ» после дообучения людьми.
Качество набора Google связывает с размером и разнообразием: много строк одного типа не спасут, если в жизни встретится другой тип. Полезно помнить: модель учится на том, что ей показали. Если в обучении не было медицинских протоколов, нельзя ждать надёжного диагноза, даже если интерфейс выглядит убедительно.
Неразмеченные примеры тоже используют, но в других постановках — кластеризация, сжатие, предобучение. Тогда метки нет, и модель ищет структуру сама. Это обучение без учителя в терминах того же глоссария.
Если собрать данные для курсовой, полезно заранее решить, что будет признаком, а что меткой. Конспект лекции как файл — ещё не пример для обучения, пока вы не сформулировали, что модель должна угадать: тему абзаца, дату события, правильный вариант теста. Без этой дисциплины разговор «нейросеть учится на моих файлах» превращается в магию, хотя на деле нужна таблица с правилами разметки.
Что такое модель, алгоритм и задача
Задача — формулировка T из определения Mitchell: классификация, регрессия, генерация текста, игра. Алгоритм машинного обучения — рецепт, как обновлять параметры, когда примеры подаются снова и снова: градиентный спуск, метод ближайших соседей, обратное распространение ошибки в нейросети.
Модель после обучения — сами подобранные числа: веса связей, пороги, коэффициенты. Google в вводном курсе называет модель «сложной коллекцией чисел», которая связывает паттерны признаков с метками. На этапе применения, когда модель уже работает для пользователя, новые примеры прогоняют через эти числа, метки в данных могут отсутствовать.
Различие важно на практике. Алгоритм «дерево решений» и алгоритм «трансформер» решают похожие задачи разными путями. Дерево читается человеком: можно пройти по вопросам «если температура выше 30». Нейросеть из миллиардов весов так не разберёшь, зато она лучше ловит тонкие закономерности в тексте и картинках. IBM отмечает, что глубокое обучение часто берёт сырые данные и само строит признаки, тогда как в классическом машинном обучении инженер вручную выбирает, что подать на вход.
Система машинного обучения в учебниках шире модели. Это сбор данных, обучение, проверка на отложенной выборке, развёртывание, мониторинг, когда мир изменился и модель устарела. Чат в браузере показывает только последний шаг — готовый ответ — и скрывает огромный контур подготовки.
| Понятие | Простыми словами | Где это видно |
|---|---|---|
| Задача | Что нужно получить на выходе | «Объясни термин», «найди спам» |
| Данные | Примеры с признаками и, возможно, метками | Таблица писем с пометками «спам» |
| Алгоритм | Как менять параметры по ошибке | Не виден, работает на сервере разработчика |
| Модель | Числа после обучения | То, что отвечает в чате |
| Мера P | Насколько хорошо получилось | Доля верных ответов, доля побед в игре |
На семинаре часто просят «привести пример машинного обучения». Подойдёт фильтр писем, если вы описали, какие поля письма идут на вход, какая метка на выходе и как программа улучшила долю верных ответов после новых размеченных писем. Подойдёт и рекомендательная лента, если объяснено, что опыт — клики пользователей, задача — угадать следующий просмотр, мера — время в сервисе или доля досмотров. Не подойдёт «чат-бот, потому что умный»: без T, P и E это реклама. Три буквы можно выписать на черновике, так проще проверить, что понятна механика.
Раздел «методы» ниже связывает эти буквы с привычными названиями курсов: обучение с учителем, без учителя, с подкреплением. Если преподаватель спрашивает про «алгоритм», имеет в виду рецепт обновления параметров; если про «модель», имеет в виду числа после нескольких проходов по обучающей выборке.
Обучение с учителем — когда у каждого примера есть правильный ответ, и модель учится повторять его на новых строках. Google сравнивает с учебником, где есть вопросы и ключи. К этому типу относят классификацию и регрессию; IBM пишет, что обучение с учителем питает и классические модели, и многие системы глубокого обучения.
Обучение без учителя: меток нет, модель ищет группы, сжимает описание, строит представления. Задача ближе к «разложи кучу документов по темам», чем к «ответь на экзаменационный билет».
Обучение с подкреплением — агент действует в среде и получает награду или штраф. IBM упоминает вариант, где политику хранят нейросетью. Samuel на шашках был ближе к этой логике, чем к современному чату: среда — доска, награда — победа.
Глубокое обучение — семейство архитектур с многими слоями. Свёрточные сети тянут признаки с картинок, рекуррентные сети и трансформеры работают с последовательностями. Большая языковая модель учится угадывать следующий токен на огромном корпусе текста; подробнее о генеративных задачах — в «Генеративный ИИ».
Метод выбирают под задачу и данные. Если примеров мало, а объяснимость важна, дерево или линейная модель часто подходят лучше гигантской нейросети. Если данных море и нужен свободный текст, без глубокого обучения не обойтись.
Машинное обучение, искусственный интеллект и чат
Искусственный интеллект в широком смысле — любые системы, которые имитируют разумные действия: игра, перевод, диагностика по правилам. Машинное обучение — более узкий, но самый живой сегодня путь: качество растёт с данными и вычислениями.
Чат, который дописывает реферат, снаружи выглядит как «ИИ». Внутри почти всегда цепочка инженерии машинного обучения: предобучение на текстах, дообучение на диалогах, иногда фильтры безопасности как отдельные классификаторы. Классификатор спама и генератор абзацев могут жить в одном продукте, но задачи у них разные, как в разборе генеративных и классифицирующих моделей.
Разбор любой рекламной фразы «умная система» начинается с трёх вопросов: какая задача, откуда опыт, как измеряют успех. Одного слова «нейросеть» для ответа мало: она не сообщит, выиграла ли программа в шашки или ошиблась в прогнозе дождя.
Названия архитектур помнить не обязательно. Хватит трёх проверок. Первая: улучшается ли система от новых примеров без переписывания кода. Вторая: нейросеть ли это; для большого языкового чата ответ почти всегда «да». Третья: можно ли доверять ответу; машинное обучение даёт правдоподобие без гарантии истины.
Когда нужно сравнить модели на одной задаче, полезнее гайд «Как выбрать модель», чем спор о словах. Для формулировок запросов — «Как писать промпты».
Как проверить, что модель поняла задачу
Ниже — запросы, которые можно задать уже обученной модели в чате, и что смотреть в ответе. Модели Gemini 3.8 Flash и DeepSeek V4 Flash уже доступны в чате GPThub; сравнивайте на одной формулировке.
Определения. «Объясни разницу между машинным обучением и нейросетью так, будто я сдаю экзамен: три предложения, без английских терминов». Хороший ответ называет вложенность понятий и не утверждает, что машинное обучение и нейросеть — синонимы. Плохой — только перечисляет названия чат-ботов.
Данные. «Приведи один пример обучающей выборки для задачи „спам или не спам“: перечисли три признака и метку». Проверьте, что признаки измеримы (отправитель, тема, число ссылок), а метка — одна из двух классов. Если модель добавила выдуманный адрес, обсудите качество данных и не копируйте строку в конспект.
Алгоритм и модель. «Что в задаче распознавания цифр меняется во время обучения, а что остаётся фиксированным?» Ожидаются веса и, возможно, архитектура как заданная инженерами; не должно звучать, что меняется «сама задача».
Глубина. «Назови метод машинного обучения без нейросетей и задачу, где он уместен». Допустимы дерево решений, k ближайших соседей, линейная регрессия. Если модель отвечает «только нейросети», попросите уточнить и назвать классические алгоритмы.
Типичная ошибка — принять красивый язык за понимание. Попросите модель применить определение Mitchell: пусть сама назовёт T, P и E для выбранного примера. Если E и P перепутаны местами, определение не усвоено, даже когда текст звучит уверенно.
Ещё один запрос на аккуратность терминов: «Опиши, какие данные нужны, чтобы учить модель отличать кошку от собаки на фото, и что будет меткой». Признаками могут быть яркости пикселей или заранее посчитанные числовые описания картинки. Метка — одно из двух имён класса. Если в ответе «модель сама поймёт без примеров», это противоречит обучению с учителем.
Сравнение двух моделей. Один и тот же вопрос «В чём разница между глубоким обучением и деревом решений для табличных данных из опроса?» отправьте дважды разным моделям. Смотрите на структуру ответа: для табличных данных и малой выборки уместны дерево или линейная модель; для сырого текста или миллионов строк чаще нужна нейросеть.
Для кода на Python с тестами подойдёт гайд «Какая модель для кода». Там напомнят запускать тесты локально и не верить строкам на экране.
Разбор по шагам: фильтр спама
Определение Mitchell легче запомнить на одном сквозном примере. Возьмём почтовый фильтр и пройдём весь путь от данных до проверки.
Сначала задача T: по письму сказать, спам это или нет. Потом опыт E: архив писем, где люди уже нажимали кнопку «это спам». Каждое письмо превращается в строку таблицы. Признаками могут быть адрес отправителя, слова в теме, число ссылок, наличие вложения. Метка — пометка пользователя.
Дальше архив делят на части. На обучающей модель подбирает параметры, на проверочной инженер сравнивает варианты настроек, а тестовую открывают один раз в конце. Мера P — доля верно угаданных писем именно в тестовой части, которую модель не видела.
Если через месяц спамеры поменяли приёмы, доля верных ответов падает. Тогда собирают свежие пометки и обучают модель заново. Это и есть цикл системы машинного обучения: данные, обучение, проверка, запуск, наблюдение и снова данные. Нейросеть здесь не обязательна: для такой таблицы часто хватает линейной модели или дерева решений.
Что путают в учебниках и новостях
Первая путаница связана с заголовком «искусственный интеллект заменит программистов» при новости про машинное обучение. Автоматически улучшается отдельная программа на отдельной мере P; весь рынок труда из одного заголовка не следует. Вторая связана с фразой «нейросеть думает как человек». Система оптимизирует числовую ошибку; философского «смысла» в этой формуле нет.
Третья — «модель обучили на всём интернете» как оправдание любому ответу. Обучение на большом корпусе не даёт гарантии на вашем частном вопросе, особенно если нужна свежая дата или локальный документ. Четвёртая — смешение алгоритма и готового файла весов. Один и тот же алгоритм обратного распространения ошибки описан в учебниках, а веса GPT, Gemini или DeepSeek — разные снимки после месяцев вычислений.
Пятая путаница касается системы машинного обучения внутри сервиса. За одним окном могут жить десятки моделей: классификатор токсичности, генератор текста, модуль ранжирования результатов поиска. Пользователь видит одно поле ввода, но задачи T там несколько, и к каждой привязана своя мера P.
Что читать дальше
После этого текста логично идти по двум дорожкам. Если интересны математика и код, откройте первую главу Mitchell с определением через E, T и P и попробуйте применить его к любой программе, которую вы уже писали. Если интересны чат и генерация, прочитайте «Что такое LLM» и «Генеративный ИИ», где на выходе новый текст вместо одной метки класса.
Если нужно выбрать модель под предмет, загляните в «Как выбрать модель».
В университетском курсе часто дают Python и готовые пакеты для классического машинного обучения без глубоких сетей. Это не устаревшее направление: банковские таблицы, медицинские анкеты с десятками полей, малые выборки — типичная зона деревьев и логистической регрессии. Нейросеть не лучше в принципе, она другая; IBM как раз подчёркивает ручной выбор признаков в классическом подходе.
Наконец, держите в голове дату проверки. Статья написана с источниками, открытыми 1 ноября 2026 года. Если через год архитектура чатов снова сменится, вложенность понятий останется. ИИ шире машинного обучения. Машинное обучение шире глубокого обучения. Нейросеть лишь один инструмент внутри области, без права называться ею целиком.
Для пересказа хватит короткой формулы. Машинное обучение отвечает на вопрос «как программа становится лучше от опыта». Нейросеть отвечает «из каких слоёв и связей собрана одна такая программа». Чат — уже упакованная для вас модель, обученная где-то на сервере разработчика; пользоваться ею можно, не путая интерфейс с определением из учебника Mitchell. Данные — то, без чего опыт E пустой: одна строка таблицы или один диалог с оценкой. Задача — то, по чему судят, удалось ли обучение. Эти пять слов не заменяют лекцию, но спасают от типичной ошибки «нейросеть и машинное обучение — одно и то же».
Вопросы и ответы
Что такое машинное обучение простыми словами?
Это способ сделать программу лучше на задаче за счёт новых примеров или симуляций, без ручного дописывания каждого правила программистом. Хорошее определение упоминает задачу, меру качества и опыт, даже если не цитирует Mitchell дословно.
Что такое модель машинного обучения?
Это результат обучения: набор параметров, через которые прогоняют новые данные. Модель не равна алгоритму обучения и не равна коду сайта, на котором вы нажали «отправить».
Что такое алгоритм машинного обучения?
Это процедура, которая по ошибке на обучающей выборке обновляет параметры. Градиентный спуск и обратное распространение ошибки — примеры; дерево решений растёт по другим правилам, но тоже относится к алгоритмам машинного обучения.
Что такое система машинного обучения?
Это весь контур вокруг модели: сбор и разметка данных, обучение, проверка на отложенной выборке, запуск для пользователей и повторное обучение, когда мир изменился. Чат в браузере показывает только готовый ответ, а подготовка остаётся за кадром. Полезно назвать хотя бы три звена: данные, обучение, проверка.
Что такое основы машинного обучения для первого курса?
Основы начинаются с умения разложить задачу на T, P и E, отличить данные от модели и понимать, зачем нужна тестовая выборка. Список брендов моделей вторичен. Практика в вузе часто идёт через табличные примеры и простые алгоритмы; чат с большой языковой моделью подключают позже, когда термины уже стоят на месте.
Что такое машинное обучение и ИИ?
Искусственный интеллект — зонтик. Машинное обучение — самый распространённый сегодня способ сделать систему адаптивной. Нейросеть — частый инструмент внутри машинного обучения, особенно в чатах и генерации картинок.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Модель для кода
Какую модель GPThub взять для багов, ревью и рефакторинга: Gemini 3.8 Flash, DeepSeek, Nano, Luna, GLM, Kimi или Claude, GPT-6.1 Sol, Grok 4.5.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.