
Генеративный ИИ: чем он отличается от модели, которая только классифицирует

Обозреватель: как устроен ИИ
Содержание
В июне 2014 года Ян Гудфеллоу и его соавторы из Монреальского университета выложили на arXiv статью «Generative Adversarial Nets». Во введении они честно признали, что самые яркие успехи глубокого обучения к тому моменту касались совсем других моделей — тех, что берут богатый вход вроде фотографии или звука и выдают метку класса. Сеть умела сказать «на снимке кошка», но не умела нарисовать кошку. Через восемь лет, 30 ноября 2022 года, OpenAI открыла ChatGPT, и миллионы людей увидели программу, которая отвечает абзацами. Слова «генеративный искусственный интеллект» стали бытовыми. Студент, который ищет этот термин, обычно хочет понять одну вещь: чем такая система отличается от «умного фильтра спама», который тоже называют искусственным интеллектом. Короткий ответ — формой результата. Классификатор выбирает метку из заранее заданного списка, генеративная модель собирает новый объект — текст, картинку, код — по вашему запросу. Длинный ответ интереснее, потому что в реальных сервисах оба типа моделей часто работают вместе, и снаружи этого не видно.
Что такое генеративный искусственный интеллект
Словарь машинного обучения Google даёт два определения рядом. Генеративная модель умеет создавать новые примеры, похожие на обучающую выборку, и оценивать, насколько вероятно, что новый пример взят из того же источника. Классифицирующая (дискриминативная, discriminative) модель предсказывает метку по признакам — и, по словам того же словаря, к этому типу относится большинство моделей обучения с учителем, включая классификацию и регрессию.
IBM в обзоре для широкой аудитории формулирует то же проще: генеративный ИИ создаёт новый контент — текст, изображения, видео, аудио или программный код — в ответ на запрос пользователя. «Новый» здесь понятие инженерное, юристы тут ни при чём. На выходе появляется последовательность символов или пикселей, которую модель только что собрала, а не готовая строка из таблицы классов.
Несколько терминов, без которых дальше будет трудно. Запрос (промпт) — текст, которым вы ставите задачу. Токен — кусок текста, с которым модель работает за один шаг. Окно контекста — сколько токенов модель держит в поле зрения одновременно: ваш вопрос, вставленную цитату и уже написанный ответ. Подробнее про само устройство сети, слои и обучение мы писали в материале «Что такое нейросеть», здесь важна только граница между двумя типами задач.
Привычная ошибка — считать, что любая нейросеть генеративная, раз ChatGPT так устроен. Камера телефона находит лица, почта решает «спам или нет», банк ловит подозрительные операции. Внутри там модели, чья задача — отнести объект к одному из заранее заданных классов. Генеративный ИИ в бытовом смысле начинается там, где вы просите «напиши», «нарисуй», «сожми в три пункта», и система дописывает результат.
Есть и вторая популярная аналогия — «это автодополнение в телефоне, только длиннее». Механизм действительно похож: и то и другое угадывает продолжение. Но клавиатура подсказывает одно слово под ваш стиль переписки, а большая модель обучена на огромном корпусе и может развернуть ответ на страницу, сменить жанр с конспекта на письмо, переписать текст для другой аудитории. Для пользователя это разные инструменты. В одном случае вы экономите три буквы, в другом получаете черновик раздела курсовой, который всё равно придётся проверять.
Чем генеративный ИИ отличается от модели, которая только классифицирует
Удобно начать с экзамена. Классификатор похож на тест: варианты ответа заданы заранее, модель ставит галочку. Генератор похож на эссе: вопрос свободный, готового текста в ключе нет. Аналогия ломается в одном месте, и это место самое важное. Генератор умеет уверенно выдумывать правдоподобные детали, которых нет в источниках. На тесте такая ошибка невозможна — там можно только выбрать не тот вариант.
Прежде всего смотрите на форму ответа. Спам-фильтр внутри считает вероятность, а пользователю показывает метку. Генератор разворачивает мысль в строку, а чаще в экран текста. Если программа ответила одним словом из списка, перед вами классификация. Если дописала абзац с аргументами — генерация, даже когда абзац неверен.
Второй признак — можно ли менять формат просьбой. Генератору можно сказать «ответь одним словом», и он послушается, но внутри всё равно соберёт последовательность токенов. Классификатор по просьбе «напиши стих на пять строк» поэтом не станет: у него нет выхода для свободного текста, только фиксированный набор классов.
| Классификатор | Генеративная модель | |
|---|---|---|
| Вход | Фото, письмо, строка признаков | Запрос, черновик, картинка для правки |
| Выход | Метка, вероятность класса, число | Новый текст, изображение, код |
| Типичная ошибка | Перепутал «кошку» с «собакой» | Уверенно назвал несуществующую дату |
| Проверка | Сравнить с эталонной меткой | Сверить факты с источником |
Отдельный случай — регрессия. В словаре Google она тоже отнесена к дискриминативным моделям: на выходе число, например прогноз температуры на завтра. Числа модель не «сочиняет» в том смысле, в каком сочиняет абзац, она оценивает одну величину. Студенту не нужно зубрить английские ярлыки, достаточно смотреть на форму ответа: новый абзац или картинка — генерация, одна метка или число — классификация или регрессия.
Показательна та самая статья 2014 года. В GAN (генеративно-состязательной сети) одновременно обучаются две модели: генератор G учится выдавать образцы, похожие на данные, а дискриминатор D учится отличать настоящие образцы от подделок. То есть внутри одной системы живут оба типа задач, и они тянут друг друга вверх. Сегодняшние чат-боты устроены иначе, но слово «дискриминатор» в учебниках осталось именно отсюда.
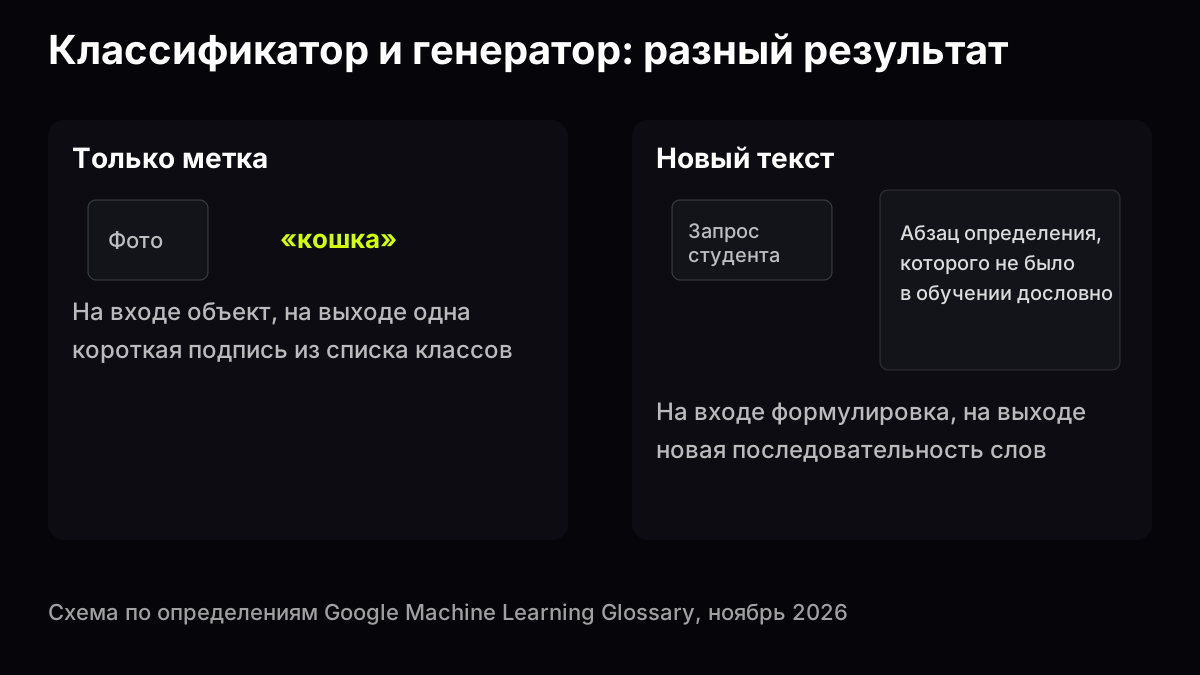
Схема по определениям Google Machine Learning Glossary, иллюстрация GPThub
Откуда взялись два подхода
Для понимания нужно отступить назад. Долгое время глубокое обучение прославляли классификаторы: модель получает пиксели или спектр звука и выдаёт класс. Генеративные модели тогда считались тяжёлыми — вероятности в них приходилось считать приближённо, обучение шло плохо. Авторы GAN предложили обойти эту трудность: пусть генератор учится на оценках соперника, обходя формулу вероятности стороной.
IBM в историческом обзоре называет вехи подряд: вариационные автокодировщики появились в 2013 году, GAN — в 2014-м. Обе идеи сделали сгенерированные картинки заметно правдоподобнее. Для текста переломом стала архитектура трансформер (Transformer). Её описали в 2017 году Ашиш Васвани и соавторы из Google в статье с названием, похожим на лозунг, — «Attention Is All You Need». Они показали, что можно обойтись механизмом внимания без рекуррентных цепочек, и на переводе с английского на немецкий (тест WMT 2014) получили 28,4 балла BLEU — рекорд на тот момент.
Следующий шаг был скорее упаковкой, чем новой математикой. OpenAI представила ChatGPT как модель, которая ведёт диалог, отвечает на уточняющие вопросы, признаёт ошибки и отказывает в неуместных просьбах. В том же анонсе сказано, что ChatGPT дообучена из модели серии GPT-3.5, обучение которой завершилось в начале 2022 года. Пользователь увидел поток текста вместо вероятности класса, и под «генеративным ИИ» закрепился именно такой интерфейс.
Отсюда и путаница в паре «генеративный ИИ — большая языковая модель». Первое понятие шире, второе — его частный случай для текста. Как устроены именно языковые модели, мы подробно разобрали в статье «Что такое LLM». Модель, которая ставит метку «кошка» на фото, может быть огромной и дорогой, но генеративной она не станет, пока на выходе не появится новое изображение или подпись, которую не выбирали из готового списка.
Как устроены генеративные модели искусственного интеллекта
IBM описывает типичный путь в три этапа: обучение базовой модели (foundation model) на огромном массиве данных, настройка под конкретное приложение и цикл «сгенерировал, оценил, поправил». Для текста базовая модель чаще всего — большая языковая модель. Для картинок и видео используют свои семейства, о них ниже.
Обучение IBM описывает как бесконечное упражнение «угадай следующий элемент»: следующее слово в предложении, следующий фрагмент картинки, следующую строку кода. Ошибку измеряют и понемногу уменьшают. В результате получается сеть параметров, которая по запросу собирает новый объект. Следствие для студента простое — генератор не хранит готовых ответов в таблице, он каждый раз собирает ответ заново. Поэтому один и тот же вопрос, заданный дважды, даёт разные формулировки.
Второй этап — настройка. Модели показывают пары «запрос — хороший ответ» для узкой области, например службы поддержки. Для чат-ботов важнее другой приём, обучение с подкреплением по отзывам людей (RLHF). OpenAI в анонсе ChatGPT пишет, что использовала тот же метод, что и для InstructGPT: люди сравнивали варианты ответов, а модель подстраивалась под предпочтения. Классификатором чат от этого не становится. На выходе по-прежнему новый текст, просто он чаще совпадает с ожиданиями человека.
Третий слой — дополнение ответа внешними источниками (в англоязычной документации — retrieval augmented generation, RAG). Перед ответом система находит фрагменты в базе знаний или в поиске и вставляет их в контекст. Похоже на открытую рядом энциклопедию, только листает её программа. Проверять всё равно нужно: фрагмент мог оказаться посторонним, пересказ вокруг него — сглаженным до неправды.
Трансформеры остаются основой почти всех языковых генераторов: через механизм внимания модель решает, какие слова в запросе важнее для следующего шага. В картинках сегодня преобладают диффузионные модели — они начинают с шума и шаг за шагом убирают его, пока не проявится сцена. Как это выглядит на практике и чем отличаются популярные рисующие модели, разобрано в материале «Нейросети для картинок», про движение и смену кадров — в «Нейросетях для видео».
В одном сервисе часто соседствует несколько генераторов. В чате GPThub уже доступны, например, Gemini 3.8 Flash и DeepSeek V4 Flash. Сравнивать их честнее на одном и том же запросе, чем по рекламным описаниям. Устройство одной конкретной линейки подробно описано в разборе «DeepSeek: что это за нейросеть».
Использование генеративного искусственного интеллекта на практике
Ниже — запросы, которые студенты задают чаще всего, и то, что проверять в ответе. Формулировки можно копировать.
Текст. «Перечисли три причины таяния ледников, к каждой дай один проверяемый факт и укажи, где его искать». Генератор выдаст список. Откройте учебник или энциклопедию и найдите каждый факт. Если модель сослалась на «исследование 2019 года» без автора и журнала, пункт удаляют, а не вставляют в реферат.
Картинка. «Схема круговорота воды в природе в стиле школьного учебника, без подписей». Проверьте направление стрелок по лекции и уберите лишние элементы. Подписи надёжнее добавить вручную: рисующие модели до сих пор путают буквы, особенно кириллицу. Как формулировать такие запросы и править результат, рассказано в гайде «Работа с картинками».
Код. «Напиши на Python функцию, которая считает медиану списка, и один тест к ней». Запустите тест у себя. Если он падает, отправьте модели текст ошибки целиком — это помогает быстрее, чем спор о том, кто прав.
Сжатие. «Сожми этот абзац до пяти предложений, термины не меняй». Проверка одна: не исчезла ли мысль, на которой держится определение. Модели охотно выбрасывают оговорки вроде «только при постоянной температуре», а без них определение становится неверным.
Классификатор и генератор в одном задании. Преподаватель даёт новостные заголовки и просит определить тон: нейтральный, эмоциональный или сенсационный. Это по сути задача классификации, и даже генератор здесь работает как классификатор — выбирает одно слово из трёх. Следующий шаг, «перепиши сенсационный заголовок нейтрально и сохрани факты», уже генерация. Если после него поплыли цифры, виновата пропущенная сверка с первоисточником, «режим ИИ» тут ни при чём.
Вопросы к семинару. «Составь пять вопросов для обсуждения по третьей главе, без ответов». Сравните список с тем, что выделял преподаватель, и выбросьте вопросы о деталях, которых в главе не было. Генератор любит добавить красивый, но посторонний сюжет.
Есть и обратный случай: генератор, который притворяется классификатором. Если попросить чат-бота «оцени это эссе по шкале от одного до пяти», он вернёт цифру, но получит её тем же способом, каким пишет текст, — дописав самое правдоподобное продолжение. Повторите запрос, и оценка может сдвинуться на балл. Специально обученный классификатор на том же эссе выдавал бы одну и ту же оценку раз за разом. Поэтому для массовой проверки, где важна воспроизводимость, по-прежнему строят отдельные модели, а генератору оставляют пояснение: почему эссе получило свою оценку и что в нём поправить. Тот же подход работает и в учёбе. Попросите генератор не только поставить оценку, но и перечислить критерии, по которым он её ставил, и сравните их с критериями преподавателя.
Как разобрать один запрос целиком
Возьмём задание по биологии: объяснить разницу между митозом и мейозом. Плохой запрос выглядит так: «Митоз и мейоз». Модель не знает, кому отвечает, сколько писать и в каком виде, поэтому выдаст средний ответ на полстраницы — с половиной лишних деталей и без нужной вам таблицы.
Хороший запрос содержит четыре вещи: роль, аудиторию, формат и ограничения. Например: «Объясни первокурснику разницу между митозом и мейозом. Сначала два предложения общего определения, затем таблица из четырёх строк: число делений, число дочерних клеток, набор хромосом, где происходит. Без исторических справок. Если в чём-то не уверен, так и напиши». Последняя фраза кажется наивной, но заметно снижает число выдуманных деталей, потому что модели разрешили сказать «не знаю».
Что проверять в ответе. Числа в таблице сверяются с учебником за минуту — это первое. Второе — термины: модель может перепутать «гаплоидный» и «диплоидный» в одной строке и правильно написать их в соседней. Третье — лишние сущности. Если в ответе появились фамилии учёных, которых вы не просили, их стоит либо проверить, либо удалить.
Дальше полезен приём «объясни обратно». Закройте ответ модели, своими словами перескажите разницу и попросите генератор найти ошибки в вашем пересказе. Здесь он работает как собеседник, и это самое честное его применение в учёбе. Больше приёмов составления запросов — в гайде «Как писать промпты», а если непонятно, какую модель брать под задачу, поможет «Как выбрать модель».
Типичные ошибки
Ошибки пользователей повторяются удивительно однообразно. Первая — принимать беглость речи за знание: гладкий текст без единой запинки кажется проверенным, хотя модель пишет одинаково уверенно и правду, и вымысел. Вторая — не указывать аудиторию. Ответ «для всех» получается слишком сложным для первокурсника и слишком поверхностным для дипломника. Третья — просить «уникальный реферат». Модель выдаст смесь типовых формулировок, которую преподаватель узнает с первого абзаца.
Ошибки моделей тоже типичны. OpenAI ещё в анонсе ChatGPT перечислила главные: модель может писать правдоподобно звучащие, но неверные ответы, чувствительна к перефразированию вопроса и склонна к многословию. С тех пор генераторы стали заметно точнее, но природа ошибки не изменилась. Модель учили угадывать правдоподобное продолжение, сверяться с базой данных её никто не учил. Добавьте сюда смешение языков в одном абзаце и длинные ответы там, где нужна одна формула.
Отдельная ловушка — мультимодальность. Текстовая модель не обязана уметь рисовать. Рисующая, в свою очередь, не обязана точно цитировать учебник. Если попросить «нарисуй» в окне текстовой модели, часто получаешь описание картинки словами. Перед курсовой с иллюстрациями стоит явно выбрать модель для изображений: универсальной модели на все задачи пока нет.
Короткий список проверки после любого ответа:
- Есть ли в тексте конкретные даты, имена, числа — и можете ли вы найти их в учебнике или на сайте первоисточника.
- Совпадает ли определение с лекцией, пусть и другими словами.
- Нет ли лишней уверенности: «очевидно», «все исследования показали» без ссылки.
- Если в ответе код или формула, воспроизводится ли результат у вас.
Генеративный искусственный интеллект в образовании
7 сентября 2023 года ЮНЕСКО опубликовала первое глобальное руководство по генеративному ИИ в образовании и науке (Guidance for generative AI in education and research). Документ исходит из того, что публичные генеративные инструменты появляются быстрее, чем страны успевают принять правила, и без регулирования первой страдает приватность данных учащихся. ЮНЕСКО предлагает подход, в центре которого человек: проверять инструменты на этичность, учитывать возраст, встраивать генератор в продуманные задания, а не подменять им освоение предмета.
В США свой вариант дал Национальный институт стандартов и технологий (NIST). 26 января 2023 года он выпустил добровольную рамку управления рисками ИИ (AI RMF 1.0), а 26 июля 2024 года добавил к ней отдельный профиль NIST AI 600-1 именно для генеративного ИИ. Само появление отдельного документа показательно: регуляторы видят у генераторов риски, которых нет у классификаторов, например правдоподобную дезинформацию.
Для студента всё это переводится в несколько простых правил. Генератор годится как черновик плана, собеседник, который задаёт уточняющие вопросы, или проверяющий вашего пересказа. Сдавать сгенерированный текст как свою работу нельзя, если правила вуза этого не разрешают, — правила вуза важнее рекламы любого сервиса. Вставлять в чат персональные данные одногруппников или закрытые материалы курса тоже не стоит, пока неясно, где они хранятся. Если преподаватель разрешил генератор только для плана, не расширяйте разрешение сами до «напиши за меня выводы».
Классифицирующие системы в вузе, к слову, никуда не делись: антиплагиат, автоматическая проверка бланков, распознавание лиц на входе в аудиторию. Это другой тип моделей, и сваливать их в одну кучу с чат-ботами под вывеской «нейросети запретили» бессмысленно. На экзамене по-прежнему проверяют ваше понимание. Генератор в учёбе похож на калькулятор для слов: от него больше всего пользы тем, кто и без него умеет считать.
Если в новостях обещают очередную «революцию генеративного ИИ», полезнее всего открыть первичный документ — пост разработчика или описание модели — и посмотреть, что именно изменилось: окно контекста, качество картинки, скорость ответа. Перед каждым запросом достаточно спросить себя, нужна ли вам метка или новый объект. Этот вопрос отделяет одну технологию от другой надёжнее любого заголовка.
Вопросы и ответы
Что делает генеративный искусственный интеллект?
Создаёт новый контент по запросу: текст, изображение, звук, видео, фрагмент программы. Этот список IBM приводит в своём определении. Классификатор же только выбирает метку или число.
Что такое генеративный искусственный интеллект genии?
Отдельного продукта или дисциплины с таким названием в документации крупных разработчиков нет — почти наверняка это опечатка в запросе «генеративный ИИ». Имеется в виду generative AI: системы, которые создают новый контент по запросу. Если поиск привёл на страницу с непонятным брендом, сверьте определение с глоссарием Google или обзором IBM из списка источников.
Что такое генеративный ИИ простыми словами?
Программа, которая после обучения на большом массиве данных умеет дописывать правдоподобное продолжение: ответ на вопрос, картинку по описанию, перевод. Внутри у неё нейросеть, но пользователь видит только готовый результат.
Генеративные модели искусственного интеллекта — чем они отличаются от спам-фильтра?
Спам-фильтр решает одну задачу: «спам или не спам». Генератор пишет новое письмо или пересказ, которого в списке меток не было. В словаре Google это различие сформулировано как генеративная модель против дискриминативной. Научить фильтр разговаривать без смены архитектуры и обучения нельзя.
Как связаны большие языковые модели и генеративный искусственный интеллект?
Большая языковая модель — генеративная базовая модель для текста. IBM относит LLM к базовым моделям, на которых строят приложения. Не всякий генеративный ИИ — языковая модель (есть рисующие и видеомодели), но большинство чат-ботов работает именно на LLM.
Как использовать генеративный искусственный интеллект в учёбе честно?
Как черновик плана, способ перефразировать сложное для себя, проверку «объясни обратно» и генератор вопросов для самопроверки — с обязательной сверкой по конспекту. ЮНЕСКО советует встраивать инструмент в задания, а не подменять им освоение темы.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
Ещё по теме
Источники
- Google Machine Learning Glossary: generative model, discriminative model
- IBM, What is generative AI?
- Goodfellow et al., Generative Adversarial Nets (arXiv:1406.2661)
- Vaswani et al., Attention Is All You Need (arXiv:1706.03762)
- OpenAI, Introducing ChatGPT (30 ноября 2022)
- UNESCO, Guidance for generative AI in education and research
- NIST, AI Risk Management Framework
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.