
"Признаки текста нейросети: почему тексты звучат одинаково"
Обозреватель: как устроен ИИ
Содержание
4 марта 2022 года группа OpenAI выложила на arXiv статью про то, как учить модель следовать просьбе человека. Внутри прямая оговорка: большую модель учили предсказывать следующий токен на интернет-странице, а не выполнять инструкцию. Само по себе увеличение размера намерение пользователя не ловит. Отсюда растёт то, что потом ищут по запросу «признаки текста нейросети»: общий тон полезного ответа, а не общий характер компании. Для студента перед сдачей работы и для редактора перед публикацией это практическая неприятность, потому что гладкий абзац ещё ничего не доказывает, а процент на чужом сайте доказывает ещё меньше.
Почему разные модели пишут похоже?
Привычная аналогия звучит убедительно: у каждой компании свой бренд, значит и почерк должен различаться, как различаются обложки. Аналогия промахивается в главном — название на обложке почти не задаёт синтаксис.
Прежде всего стоит отступить к задаче, с которой модель вообще начинают. В статье OpenAI от 4 марта 2022 года (arXiv:2203.02155, Лонг Оуян и соавторы) цель предобучения названа прямо: предсказывать следующий токен на интернет-странице. Токен — кусок слова, иногда целое короткое слово, иногда хвост. Задача «полезно выполнить просьбу» в эту цель не входит. Авторы так и формулируют: увеличение модели само по себе не учит её лучше следовать намерению пользователя, языковая цель с этим намерением рассогласована. Что такое токен и почему ответ собирается по кусочку, разобрано в материале про токены и окно контекста.
Дальше идёт короткий второй этап: люди сравнивают варианты ответа, модель доучивают так, чтобы чаще выигрывал выбранный. У версии на 175 миллиардов параметров этап подгонки по предпочтениям в цифрах той же статьи стоит 60 петафлопс-суток. Предшествующий шаг контролируемого дообучения оценён отдельно, в 4,9, предобучение GPT-3 — 3 640, так что доля маленькая, а эффект рядом с ней огромный.
Выходы модели на 1,3 миллиарда параметров после этого этапа люди предпочли выходам GPT-3 на 175 миллиардов, хотя параметров было более чем в 100 раз меньше. Ту же 175-миллиардную модель после дообучения предпочли исходной в 85% сравнений, погрешность 3 процентных пункта. Против варианта с несколькими примерами в запросе предпочтение составило 71%, погрешность 4 пункта. Архитектура у сравниваемой пары на 175 миллиардов одна. Разница — человеческие оценки, на которых модель доучили.
Размер характер не купил — его купил отдельный этап «отвечай на просьбу», и именно этот этап потом слышен в ровном тоне.
Здесь легко договорить лишнего, и этого лучше не делать. Статья не пишет, что разметчики поощряли списки, оговорки и мягкие переходы между абзацами. Она пишет другое: люди стабильно выбирают дообученный ответ. Когда модели просили быть уважительной, токсичных ответов стало примерно на 25% меньше, чем у GPT-3. Синтаксический почерк помощника померили позже, на других моделях и на другом корпусе. Как устроены сами стадии, без рекламного пересказа, есть в материале как обучают нейросеть.
Похожесть между лабораториями в марте 2022 года ещё никто не измерял пакетом, её измерили на новостях: 23 августа 2024 года в журнале Artificial Intelligence Review вышла работа Альберто Муньос-Ортиса, Карлоса Гомеса-Родригеса и Давида Вилареса из университета Ла-Коруньи. Они взяли 13 371 английский заголовок из материалов, вышедших с 1 октября 2023 года по 24 января 2024 года, то есть после выпуска всех моделей в выборке. Так снижали риск, что модель просто вспомнит уже виденную заметку. Шесть моделей попросили написать новость: Mistral 7B, Falcon 7B и четыре LLaMA, на 7, 13, 30 и 65 миллиардов параметров.
Это базовые модели 2023 года, не чат-помощники, и всё же фраза из статьи короткая: различия между моделями и людьми больше, чем различия между моделями.
Общий каркас виден уже там, где никто специально не учил систему «быть вежливым помощником». Дообучение под инструкции, как покажет следующая работа, этот каркас от людей ещё отодвигает. Сказать, что с 2022 года все лаборатории мира завели один и тот же отдел разметки, по этим бумагам нельзя. Можно сказать уже доказанное: метод «сначала продолжай текст, потом подгони ответ по выбору людей» описан у OpenAI в марте 2022 года. Замеры 2024–2025 годов показывают, что именно второй этап разводит грамматику с человеческой.
Запрос тоже участвует, и это уже следствие устройства, не отдельный опыт. Просьба «объясни в пяти равных абзацах, без лишних деталей» задаёт форму не хуже шаблона в методичке. Модель продолжит самый вероятный учебниковый каркас, потому что именно его она и училась продолжать. Прогона «мы сравнили сто чатов» в этом тексте нет. Такой прогон было бы честно пометить датой и таблицей, а таблицы нет.
Признаки текста нейросети в готовом абзаце
Запрос обычно значит набор повторяющихся решений на уровне ритма, словаря и синтаксиса. Водяного знака в буквах нет, ниже то, что реально посчитали, и отдельно то, что видно глазами без статистики. Замеры английские, и переносить проценты на русский абзац как готовый норматив нельзя, и этот текст так не делает.
Ритм в новостной работе такой: у людей распределение длин предложений шире, модели сбиваются в полосу примерно 10–30 токенов, длинные фразы у людей встречаются чаще. На графике это разъехавшиеся столбики против кучки. На слух — страница, где нет ни короткой реплики, ни длинного периода с вводной. Замер сделан на английских новостях шести базовых моделей. Русский эссейный абзац в ту выборку не входил.
Словарь уже: стандартизованное отношение разных слов к общему числу у людей 0,491, у ближайшей LLaMA на 65 миллиардов — 0,466. По другой мере разнообразия, в работе она названа MTLD, люди на 96,51, Falcon 7B на 57,37. Прилагательных у людей 7,58% слов, у моделей заметно меньше. Зато больше чисел, символов, вспомогательных глаголов и местоимений вообще, не именно пары «мы» и «вы». Текст выглядит справкой, имена, даты и спорные формулировки из него вымыты.
Синтаксис после дообучения померили точнее, и там уже чат-модели. Алекс Райнхарт и соавторы 21 октября 2024 года выложили работу на arXiv (2410.16107), 21 августа 2025 года вышла вторая версия, затем статья в PNAS, том 122 за 2025 год. На параллельных английских продолжениях сравнили GPT-4o, GPT-4o mini и Llama 3: базовые на 8 и 70 миллиардов и их версии, дообученные отвечать на инструкции.
Причастный оборот настоящего времени — конструкция вроде «опираясь на ловкость, уклоняясь от удара». У дообученных моделей такие обороты встречаются в 2–5 раз чаще, чем у людей. У GPT-4o отдельно в 5,3 раза чаще. Мера разъезда распределений в работе равна 1,38. В их примере боксёр опирается на ловкость и уклоняется от тяжёлых ударов. Номинализация — существительное там, где у человека был бы глагол: «снижение», «сохранение», «повышение» вместо «снизили, сохранили, повысили». Таких существительных в 1,5–2 раза больше, у GPT-4o в 2,1 раза, мера разъезда 1,23.
И одна поправка, без которой портрет врёт. Безличный пассив у GPT-4o примерно вдвое реже, чем у людей. Модель не канцелярит пассивом по всем осям. Она плотнее по причастиям и существительным, и при этом реже прячет деятеля. Базовые Llama 3, без этапа инструкций, по этим частотам ближе к людям, чем их же версии «отвечай на просьбу». Оттенок усиливает не размер, его усиливает этап дообучения.
Эмоции в новостном сравнении уже: у людей сильнее страх и отвращение и меньше радости, злости примерно поровну. Отсюда нельзя выводить, что модель всегда уравновешивает обе стороны спора, такого предложения в работе нет, есть более узкий факт: сильный негатив, кроме злости, в машинных новостях слабее.
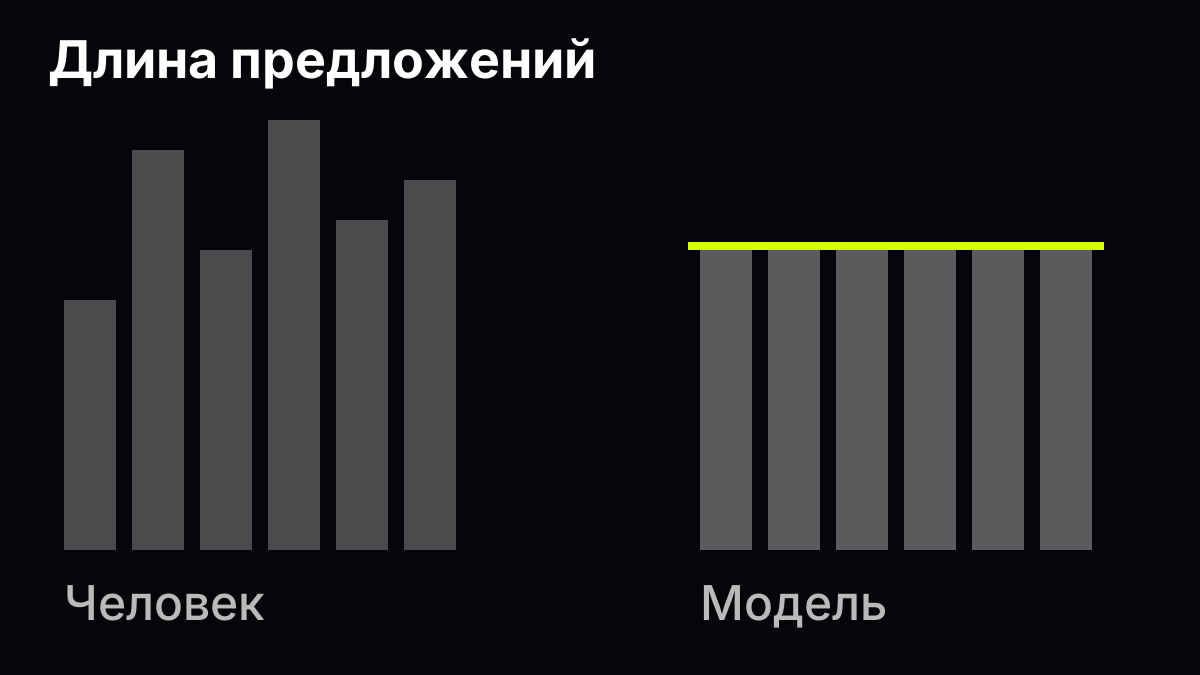
По мотивам сравнения англоязычных новостей, 23 августа 2024. Схема учебная, столбики не сняты с графика статьи
| Примета | Что посчитали | Чего замер не говорит |
|---|---|---|
| Длина фраз | У людей разброс шире, модели чаще в полосе 10–30 токенов | Норму для русского эссе |
| Словарь | Уже, прилагательных меньше, местоимений больше | Список запрещённых слов |
| Причастия | У дообученных моделей в 2–5 раз чаще, чем у людей | Процент для любого чата 2026 года |
| Существительные вместо глаголов | В 1,5–2 раза чаще, у GPT-4o в 2,1 раза | Что пассив тоже чаще: у GPT-4o он реже |
| Негатив в новостях | Страх и отвращение слабее, злость примерно та же | Что модель всегда «за обе стороны» |
Что видно без подсчёта
Дальше уже не частоты из статей, а приметы, по которым абзац стоит перечитать. Они не заменяют замер и не годятся как пункт обвинения.
Симметрия списка: три или пять пунктов, одна грамматическая форма, примерно одна длина. В ответах, которые люди чаще выбирают на этапе дообучения, списки удобны, и модель воспроизводит симметрию охотнее, чем автор с листа. Это наблюдение о форме, и процента «как часто» в цитируемых работах нет, и выдумывать его незачем.
Мостики без спора: фразы вроде «надо учесть» и «приходится признать» стоят через ровные промежутки и не привязаны к возражению. Если вынуть их и тезис не просел, каркас был важнее мысли. Живой текст тоже бывает гладким после корректора. Ровные мостики — повод читать дальше, не повод ставить диагноз.
Широта без якоря: пять дисциплин, три страны и ни одной фамилии, которую можно вбить в поиск. Так бывает и у человека в спешке. У модели это частый режим, когда в запросе нет документа. Проверка якоря — имени, года, ссылки — разобрана в материале почему нейросеть выдумывает. Частоту «модель сдаёт несуществующий адрес» этот текст не обещает: готового процента под такую фразу в открытых работах ниже нет.
Ровная орфография при пустом содержании — повод спросить, откуда абзац, а не повод хвалить грамотность. Человек в черновике спотыкается, модель спотыкается реже, и уликой гладкость не становится: аккуратный автор и корректор дают ту же ровность. Всплеск орфографии без единой проверяемой детали просто дешёвый сигнал, что содержание надо читать отдельно от грамотности.
Откуда берутся предсказуемость и ровный ритм
Два слова из блогов про детекторы стоит понять, иначе процент на сайте выглядит как прибор.
Перплексия — насколько модель удивлена текстом. Если каждое следующее слово для неё ожидаемо, число низкое. Всплесковость — насколько неравномерно по тексту чередуются лёгкие и тяжёлые куски. В английских работах второй показатель называют burstiness. У людей разброс обычно выше, у модели при жёстком выборе самого вероятного слова ритм выравнивается. Оба числа зависят от того, какая модель удивляется. Чужой порог к вашему абзацу не прикладывается сам собой.
Диплом KTH, 2025 год, Исак Нобель и Карл Линдберг, математическая статистика, первая ступень. Гипотеза их работы: текст, который породила та же модель, для неё предсказуемее человеческого. В узком опыте так и вышло. Энциклопедические статьи, человеческие и сгенерированные, оценивала та же открытая модель, которая их писала: DeepSeek-R1 на 14 миллиардов параметров. На отложенной части показатель разделения составил 0,994 из 1. При пороге 0,5 модель поймала 96% машинных текстов и ошиблась на 4% человеческих. Граница 50% лежала около перплексии 3,36.
Цифры красивые, но авторы сами вычитают из них лоск. Модель оценивала собственный почерк, и зазор от этого раздувается. Энциклопедический стиль к тому же однообразен, разделять его легко. Почти любой отрывок с перплексией ниже этой границы в их узком опыте уезжает в класс «машина», за пределами опыта граница другая.
На более пёстром наборе — человеческие рассказы и ответы модели из другого корпуса — показатель разделения упал до 0,981, всё ещё высоко, порог сдвинулся к перплексии около 13,85, поимка составила 94% при 5% ложных на людях. Перенос порога — нет: модель, настроенная на пёстром наборе, на энциклопедических статьях слишком чувствительна: при вероятности 0,8 ложных срабатываний на человеческом тексте больше 50%. В обратную сторону модель, настроенная на энциклопедии, на пёстром наборе почти не узнаёт машинный текст, потому что ждала более низкую перплексию. Вывод в их формулировке жёстче популярного «граница размылась». Перплексия хорошо узнаёт почерк той модели, на которой её настроили, и сама по себе не годится как универсальная проба авторства.
Вторая работа уже про нулевую температуру выборки. Катерина Антипова и Глиб Горбань (Kateryna Antipova, Hlib Horban), Черноморский национальный университет имени Петра Могилы в Николаеве. Конференция 20–21 ноября 2025 года в Киеве, сборник CEUR вышел 7 февраля 2026 года, в опыте 500 аннотаций с arXiv, две модели, Phi-3-mini и IDEFICS-9B, обе с температурой 0, без случайного выбора слова. Перплексию считали не они, а маленькая GPT-2 на 124 миллиона параметров. Это чужое удивление, не удивление автора текста.
Пересказ чужой аннотации дал среднюю перплексию 46,49 и 44,56 против 47,99 у людей. Почти та же предсказуемость, хотя у авторегрессионной модели разброс широкий, около 24. Всплесковость у неё при этом упала: 2,2 против 5,82 у людей. Генерация аннотации с нуля предсказуемость уронила сильнее, до 24,72 и 17,49 против 47,99. Всплесковость упала до 2,25 и 1,79. Детектор на этих текстах авторы не гоняли, вывод по таблице честный: одной перплексии мало, пересказ при нулевой температуре по ней прячется в человеческий диапазон. Генерация с нуля выглядит ровнее, но и её не ловит порог, настроенный только на одно число.
Объём маленький, модели не те, что стоят в обычном чате, аннотации короткие, и как иллюстрация механизма замер годится, а для учебного текста норматив из него не выйдет. Авторы сами пишут, что при нулевой температуре стиль модели выступает резче, а при более высокой температуре выборки картинка может съехать. Этот второй замер они не ставили.
4 марта 2025 года Брэдли Эми, технический директор компании Pangram, которая сама делает детектор, написал, почему перплексия и всплесковость ломаются, и аргумент узкий: текст, который модель видела много раз, для неё не сюрприз, даже если писал человек. В его примере начало Декларации независимости для модели почти плоско: строка затёрта повторениями. Статьи Википедии попадают в ту же ловушку. Однопоказательный детектор принимает знакомое за машинное. Это позиция вендора, не независимый замер, и цифры точности их собственного продукта сюда не переносятся, хотя для читателя полезен сам механизм: аккуратный, много раз виденный стиль получает низкую перплексию без всякой нейросети в авторах.
Почему процент на сайте ещё не приговор
Коммерческие сервисы показывают долю нейросети в процентах. Как устроен классификатор, почти никто не публикует. Из открытых работ следует более скучное.
Райнхарт и соавторы прямо пишут, что цель работы — не построить ещё один детектор. Их стилистический классификатор всё же ошибся: 9,8% человеческих текстов пометил как машинные, 4,2% машинных принял за человеческие. На аннотациях другой модели точность просела, а классификатор, обученный на базовой Llama, на чужих текстах свалился к случайному угадыванию. Классификатор, собранный под один корпус, на соседний не переезжает.
У Нобеля и Линдберга тот же сюжет с другой стороны. Внутри каждого набора разделение высокое, порог между наборами не живёт. Высокая площадь под кривой не спасает, если вся шкала съехала. Человеческий текст, написанный по жёсткому шаблону, тоже получает низкую перплексию. Учебниковый конспект кафедры и машинный пересказ учебника для такой метрики родственники.
У Антиповой и Горбаня в обзоре литературы перевод туда и обратно числится среди обходов детектора. Свой замер они на переводе не ставили. Процента «сколько русских эссе ломается от переводчика» у них нет, и повторять чужую цифру без их таблицы нельзя. Редактура даёт похожую ловушку уже из поста Pangram и из диплома KTH. Корректор выровнял ритм, убрал повторы, подтянул термины. Текст стал ближе к тому, что модель считает ожидаемым. Процент на сайте от этого растёт, про авторство он молчит.
Смешанное авторство процент тоже не разбирает. Человек набросал тезис, модель раздула абзацы. Цифра на сайте не говорит, какая фраза чья. Это предел любого одного числа, не результат отдельного опыта. Для дисциплинарного шага такой предел слишком широк. Устный вопрос по узкому месту абзаца проверяет автора. Процент проверяет стиль, да и то на том жанре, на котором порог учили.
Для редактора надёжнее имена, даты и источники, которые открываются. Для автора, который честно берёт модель в помощники, надёжнее оставить деталь, которую он сам открыл, чем гоняться за списком запрещённых слов. Списки устаревают быстрее, чем выходит следующая версия разметки. Замера «эти двадцать слов выдают модель» в работах выше нет.
Что меняется от модели к модели
Похожесть тождеством не стала: в новостной работе зазор между моделями был меньше зазора между любой из них и людьми, но он был. Райнхарт с соавторами показывает две вещи сразу. Дообученные под инструкции версии расходятся с людьми сильнее базовых. И модели различимы между собой лучше случайного угадывания: классификатор на семь классов попадал примерно в 66% случаев при случайных 14%. Путать он склонен соседей по размеру, не всех со всеми.
Практический вывод скромный: смена модели меняет и ошибки в фактах, и синтаксис, но почерк «ответа на просьбу» переносится туда, где есть тот же этап дообучения. Это вывод из устройства, которое OpenAI описала 4 марта 2022 года, и из замеров 2024–2025 годов на GPT-4o и Llama 3. Отдельного сравнения всех нынешних чатов на русском в этих работах нет. Ставить знак равенства между брендами по чужому английскому корпусу не стоит.
Отличить тексты проще, когда в них есть жанр, которого в среднем правильном ответе мало. Полемика, региональный оборот, цитата с шероховатостью, ссылка на страницу, которую можно открыть. Что такое большая языковая модель как класс, без этого синтаксического сюжета, собрано в материале что такое большая языковая модель.
Тот же вопрос можно задать двум моделям и сравнить каркас, не слова. Gemini 3.8 Flash и Claude Sonnet 5 уже доступны в чате GPThub, карточки на 2 ноября 2026 года открываются: Gemini 3.8 Flash и Claude Sonnet 5. Как выбрать, с какой начать, есть в гайде как выбрать модель. Совпадение лестницы абзацев у двух ответов говорит о запросе. Расхождение говорит, что смотреть надо и на факты, тон тут вторичен.
Когда похожий каркас ничего не доказывает
Юридически и по-человечески важно не склеивать два случая. В первом человек сдал чужой каркас как свой и не открыл ни одного источника. Во втором он писал сам, но годами читал ровные учебники, а потом прошёл через корректора или шаблон методички. Второй текст может набрать те же приметы, что и первый. Замеры перплексии как раз про это: знакомый и шаблонный человеческий текст для модели тоже не сюрприз.
Преподавателю полезнее пара вопросов по слабому месту абзаца, чем охота за процентом. Автору черновика помогает обратное: след реальной работы. Черновик с зачёркнутым предложением, спор с источником, ссылка на страницу, которую можно открыть сегодня. Такой текст сложнее подделать вторым запросом, потому что модель не знает, что именно человек читал накануне. Это практический предел, не юридическая консультация и не обещание, что детектор замолчит.
Как читать черновик без детектора
Проверка становится наглядной, когда рядом лежит абзац, собранный вручную по тем приметам, которые насчитали в работах: это учебный муляж, ответом модели он не служит, цитатой из статьи тоже. Цифры в контрастном примере ниже выдуманы нарочно, чтобы было видно форму, не факт.
«Снижение нагрузки, сохранение интереса и повышение качества подготовки остаются центральными направлениями обсуждения. Рассматривая текущую ситуацию, можно выделить несколько связанных аспектов, включая доступность материалов, устойчивость внимания и последовательность требований. Опираясь на общие тенденции, приходится признать, что баланс интересов участников требует аккуратного и взвешенного подхода.»
Три предложения близкой длины, и в них ни фамилии, ни года, ни документа. Цепочка существительных в первой фразе — та самая номинализация, которую Райнхарт насчитал в 1,5–2 раза чаще у дообученных моделей, чем у людей. «Рассматривая» и «опираясь» — причастия, которых у таких моделей в английском корпусе в 2–5 раз больше. «Приходится признать» и «баланс интересов» снимают спор, не начиная его. Сожмите абзац в одно предложение, и фактов не останется. Это и есть вода в тексте: связки есть, проверяемого содержания нет. Запрос «вода в тексте нейросети» обычно указывает именно сюда, не на список грубых слов.
Контрастный муляж, с теми же оговорками. «После замены датчика на линии 12 брак за неделю упал: в журнале смены запись от 3 марта, страница 14.» Здесь есть номер, дата и документ. Проверить их нельзя, потому что журнал выдуман, и в этом весь урок: форма уже другая, на месте пустоты встаёт якорь, за который можно зацепиться. В настоящем тексте якорь должен открываться вне чата. Если не открывается, это сюжет про выдумку, не про стиль.
Дальше приём, который не требует сайта. Возьмите сомнительный абзац и выпишите якоря: имена, годы, числа, названия документов, и три из них проверьте вне чата. Если якорь не открывается, стиль тут ни при чём, ломается факт. Если якорей нет вовсе, гладкость только маскирует пустоту. Сравните каркас с ответом на тот же вопрос у другой модели. Совпали вводные и лестница абзацев — смотрите на запрос. Он мог заказать эту лестницу сам.
Запрос, который тянет тот же каркас, выглядит безобидно. «Объясни тему в пяти равных абзацах, без лишних деталей, для широкого читателя.» Пять равных абзацев заказывают симметрию. «Без лишних деталей» вычищает имена и даты, то есть как раз то, чем человеческий текст в новостном замере отличался от машинного. «Для широкого читателя» толкает к среднему регистру, который этап инструкций и так поощряет. Разбор того, как формулировка меняет ответ, живёт в гайде как писать запросы и в материале что такое запрос. Готовый текст «скопируй и вставь» сюда не кладётся. Это разбор, почему форма просьбы видна в форме ответа.
Если после правки в абзаце появились номер документа, дата проверки и одна деталь, которой в среднем корпусе нет, каркас ломается сильнее, чем от замены одного прилагательного на другое. Замена слов гонку не выигрывает: разработчики меняют разметку, штампы съезжают, а фамилия в проверяемой ссылке остаётся. Запрос «текст прогнать на признаки нейросети» обычно значит именно этот осмотр, без чужого сайта и без процента в углу экрана.
Если в новости детектор доказал авторство одним процентом, сначала откройте, на каком тексте учили порог и переносится ли он в ваш жанр. Работы выше как раз про это. Порог, который не переезжает, приговором не становится.
Вопросы и ответы
Какие признаки текста нейросети можно выделить без детектора?
Ритм предложений, плотность имён и дат, причастия и цепочки существительных, источник, который открывается. Это приметы из английских замеров 2024–2025 годов плюс чтение якорей. Не судебное доказательство и не замена разговора по существу абзаца.
Какие признаки характерны для текста, сгенерированного ИИ, в русскоязычном эссе?
Замеры, на которые опирается этот текст, сделаны на английских новостях и продолжениях. Механизм тот же: предсказание следующего куска и отдельный этап «отвечай на просьбу». Частоты «в 2–5 раз» на русский эссе не переносятся, такой таблицы нет. Смотреть всё равно есть на что: пустые обобщения, ровные абзацы, ссылка, которая не открывается.
Что такое вода в тексте нейросети?
Длинный пересказ без имён, дат и цитат, который сжимается в одно предложение без потери фактов. В учебном муляже выше так и вышло. Вода — про содержание, не про список запрещённых слов.
Как прогнать текст на признаки нейросети, если детектора под рукой нет?
Выпишите якоря и проверьте три из них вне чата. Сравните каркас с ответом на тот же вопрос у другой модели. Посмотрите, останется ли смысл, если вынуть вводные мостики. Процент с чужого сайта в эту процедуру не входит.
Почему тексты разных чатов всё равно похожи?
Общая первая задача — продолжать текст. Общий по типу второй этап — дообучение по выбору людей. У OpenAI он описан 4 марта 2022 года и меняет ответ сильнее, чем лишние параметры. Бренд меняет запреты и длину, каркас вежливого пересказа от этого не отменяется. Прямого сравнения всех нынешних чатов в цитируемых работах нет.
Как преподавателю проверить подозрение, не обвиняя напрасно?
Попросите устно объяснить узкое место абзаца, открыть источник или дописать фрагмент на новую деталь. Гладкость стиля, как видно из замеров перплексии, бывает и у аккуратного человеческого текста. Один процент детектора для дисциплинарного шага не годится.
Связанные модели


Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- OpenAI, Training language models to follow instructions with human feedback
- Muñoz-Ortiz, Gómez-Rodríguez, Vilares. Contrasting Linguistic Patterns in Human and LLM-Generated News Text
- Reinhart et al. Do LLMs write like humans?
- Nobel, Lindberg. AI or Human? Detecting Machine-Generated Text Through Perplexity
- Antipova, Horban. A Metric-Driven Evaluation of Rephrased and Generated Texts
- Emi. Why Perplexity and Burstiness Fail to Detect AI
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.